

基于Python与SPSS的多元线性回归模型实现与验证

本文详细演示了如何使用Python和SPSS进行多元线性回归分析。通过电厂数据案例,分别采用梯度下降法和sklearn库中的最小二乘法求解回归参数,并对比SPSS结果。文章涵盖数据预处理、损失函数构建、参数迭代优化及模型验证全过程,展示不同方法在参数精度与收敛速度上的一致性。
数据加载与预处理
原始数据在这里
1.观察数据
首先,使用Pandas库加载数据并进行初步观察。
import numpy
import pandas as pd
import matplotlib.pyplot as plt
%matplotlib inline

data = pd.read_csv('Folds5x2_pp.csv')
data.head()
数据呈现如下格式:
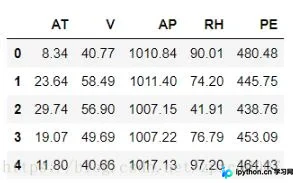
该数据集源自一个循环发电厂,包含5个字段:AT(温度)、V(压力)、AP(湿度)、RH(压强)以及PE(输出电力)。具体物理含义在此不作深入探讨。
目标是建立PE与特征变量之间的线性关系。其中PE为样本输出,AT、V、AP、RH为4个特征变量。机器学习的核心在于求解线性回归模型:PE=θ0+θ1∗AT+θ2∗V+θ3∗AP+θ4∗RH。需要学习的参数为θ0,θ1,θ2,θ3,θ4这5个系数。
接下来对数据进行归一化处理:
data = (data - data.mean())/data.std()
由于回归线的截距θ0不受样本特征影响,我们引入X0=1,使回归模型调整为:
PE=θ0*X0+θ1∗AT+θ2∗V+θ3∗AP+θ4∗RH
将方程向量化表示为:
PE = hθ(x) = θx (注意θ需转置)
线性回归模型构建
2.线性回归
在线性回归中,首要任务是建立代价函数(cost function)。当代价函数的值达到最小时,对应的θ值即为所求的最优参数。
线性回归的Cost function定义如下:
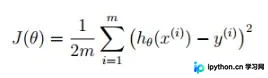
因此,可以在Python中编写函数来计算损失方程:
def CostFunction(X,y,theta):
  inner = np.power((X*theta.T)-y,2)
  return np.sum(inner)/(2*len(X))
随后,设定初始θ值为[0,0,0,0,0],计算得到初始J(θ)值为0.49994774247491858,相关代码如下:
col = data.shape[1]
X = data.iloc[:,0:col-1]
y = data.iloc[:,col-1:col]
X = np.matrix(X.values)
y = np.matrix(y.values)
theta = np.matrix(np.array([0,0,0,0,0]))
temp = np.matrix(np.zeros(theta.shape))
CostFunction(X,y,theta)
接下来有两种求解方法可选:1.梯度下降法(gradient descent)和 2.最小二乘法(normal equation)。本文采用梯度下降法进行求解。
梯度下降法通过计算J对θ的偏导数,并设置学习步长,通过迭代使J(θ)逐步下降,从而求得局部最优解。
计算公式如下:
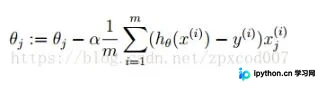
j:特征编号
m:样本编号
在Python中实现迭代计算θ和J(θ)的逻辑如下:
def gradientDescent(X,y,theta,alpha,iters):
  temp = np.matrix(np.zeros(theta.shape))
  parameters = int(theta.ravel().shape[1])
  cost = np.zeros(iters)
  for i in range(iters):
    error = (X*theta.T)-y

    for j in range(parameters):
      term = np.multiply(error,X[:,j])
      temp[0,j] = theta[0,j] - (alpha/len(X))*np.sum(term)

    theta = temp
    cost[i] = CostFunction(X,y,theta)

  return theta,cost
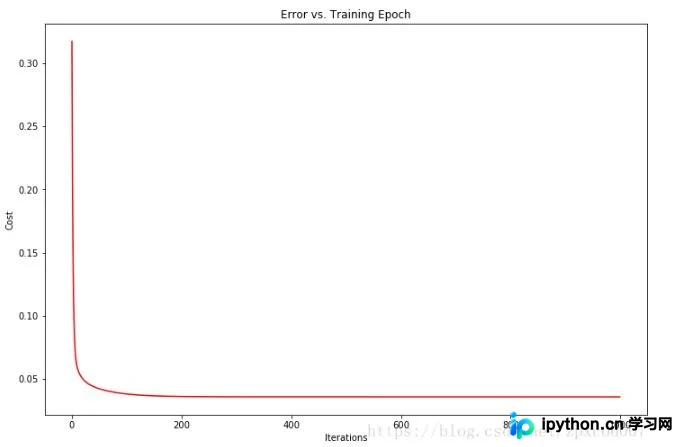
此处设置初始学习率α为0.1,经过1000次迭代后,θ0,θ1,θ2,θ3,θ4的值分别为:
-5.22080706e-14,-8.63485491e-01,-1.74182863e-01,2.16058120e-02,-1.35205248e-01
此时 J(θ)的值为0.0379648。
通过可视化J(θ)随迭代次数的变化曲线,可以发现J(θ)收敛速度非常快。
绘制预测值与损失值的散点图,点距离直线越近,说明损失越小:
predicted = X*g.T
predicted = predicted.flatten().A[0]
y_f= y.flatten().A[0]
fig, ax = plt.subplots()
ax.scatter(y_f,predicted)
ax.plot([y.min(), y.max()], [y.min(), y.max()], 'k--', lw=4)
ax.set_xlabel('Measured')
ax.set_ylabel('Predicted')
plt.show()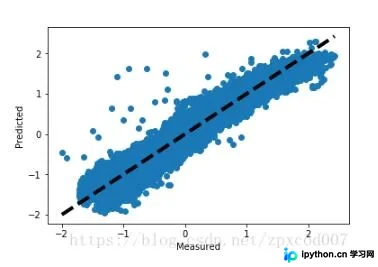
sklearn与SPSS验证
3.sckit-learn
鉴于J(θ)收敛速度极快,为进一步验证,使用sckit-learn和SPSS进行对比测试。
首先查看sckit-learn,在sklearn库中,线性回归默认使用最小二乘法,使用方式非常简洁。
代码如下:
from sklearn import linear_model
model = linear_model.LinearRegression()
model.fit(X, y)
打印输出的θ值与梯度下降法结果高度一致,θ0,θ1,θ2,θ3,θ4的值分别为:
0,-0.86350078,-0.17417154,0.02160293,-0.13521023
4.SPSS
接着观察SPSS的分析结果
同样先将数据标准化后进行线
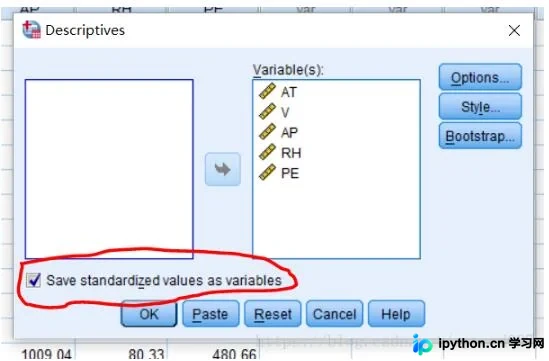
然后进行线性回归分析得到结果:
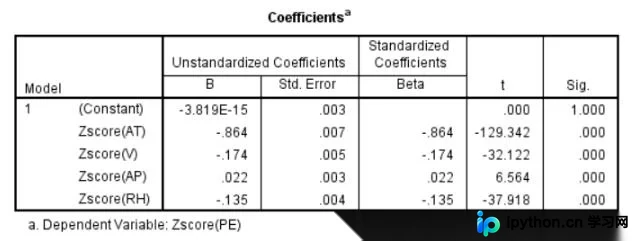
可以看出,SPSS的结果与前两种方法基本吻合。
以上这篇关于多元线性回归分析——Python&SPSS就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









