

Python数据预处理:共线性检测与处理实战

本文详解Python中数据共线性的成因、检测方法(如VIF、相关系数)及处理方案。通过岭回归、逐步回归和主成分回归等算法实战,展示如何利用sklearn库解决多重共线性问题,提升模型稳定性与预测精度。
共线性概念与成因解析
共线性概念解析
共线性是指模型中自变量之间存在高度的线性相关性。这一问题会显著降低回归模型的稳定性和预测准确性,同时,冗余的高相关维度也会增加不必要的计算开销,拖慢处理速度。
共线性成因分析
变量间产生共线性的主要原因包括以下几个方面:
首先,数据样本量不足可能导致共线性呈现偶然性,这反映了数据匮乏对建模的负面影响,而共线性仅是其中一种表现。
其次,多个变量可能随时间呈现相同或相反的变化趋势。例如,春节期间网络销售量与销售额往往同时出现相对于正常时期的下降趋势。
再次,变量间可能存在时间推移上的关联,整体趋势一致但反应时间点不同。例如,广告费用投入后,品牌曝光经过一段时间传播才转化为销售额,导致两者在时间序列上存在滞后但趋势一致的关系。
最后,变量间可能存在直接的线性关系。例如,若y代表访客数,x代表展示广告费用,二者可能遵循y=2*x + b的线性关系。
共线性检测方法详解
共线性检测方法
常用的共线性检验方法包括以下几种:
容忍度(Tolerance):容忍度是将某个自变量作为因变量,对其他自变量进行回归建模后得到的残差比例,其值等于1减去决定系数。容忍度越小,表明该自变量与其他自变量间越可能存在共线性。
方差膨胀因子(VIF):VIF是容忍度的倒数。VIF值越大,共线性问题越显著。通常以10为判断阈值:当VIF<10时,认为不存在多重共线性;当10≤VIF<100时,存在较强的多重共线性;当VIF≥100时,存在严重多重共线性。
特征值(Eigenvalue):该方法通过对自变量进行主成分分析,若多个维度的特征值等于0,则提示可能存在较严重的共线性。
相关系数:若变量间的相关系数R>0.8,则可能存在较强的相关性,需进一步关注共线性问题。
共线性处理策略与Python实战
共线性处理策略
针对共线性问题,可采取以下处理措施:
增大样本量:在可行前提下,增加样本量是优先考虑的方法,它可以消除因数据量不足导致的偶然性共线性现象。
岭回归法(Ridge Regression):这是一种改良的最小二乘估计法。通过牺牲最小二乘法的无偏性,以损失部分信息和降低精度为代价,换取更实际且可靠性更强的回归系数。因此,岭回归在处理存在较强共线性的回归应用中较为常用。
逐步回归法(Stepwise Regression):该方法每次引入一个自变量进行统计检验,随后逐步引入其他变量,并对所有变量的回归系数进行检验。若因新变量引入导致原变量不再显著,则将其剔除,从而逐步得到最优回归方程。
主成分回归(Principal Components Regression):通过主成分分析,将原始参与建模的变量转换为少数几个主成分,每个主成分是原变量的线性组合。基于主成分进行回归分析,可在不丢失重要数据特征的前提下避开共线性问题。
人工筛选:结合领域专家经验,对自变量进行删减。这种方法对操作者的业务能力和经验要求较高。
Python代码实现示例
import numpy as np
import pandas as pd
from sklearn.linear_model import Ridge
from sklearn.decomposition import PCA
from sklearn.linear_model import LinearRegression

# 导入数据
df = pd.read_csv('https://raw.githubusercontent.com/ffzs/dataset/master/boston/train.csv')

# 切分自变量
X = df.iloc[:, 1:-1].values

# 切分预测变量
y = df.iloc[:, [-1]].values

# 使用岭回归处理
import matplotlib.pyplot as plt
plt.figure(figsize=(8,6))
n_alphas = 20
alphas = np.logspace(-1,4,num=n_alphas)
coefs = []
for a in alphas:
  ridge = Ridge(alpha=a, fit_intercept=False)
  ridge.fit(X, y)
  coefs.append(ridge.coef_[0])
ax = plt.gca()
ax.plot(alphas, coefs)
ax.set_xscale('log')
handles, labels = ax.get_legend_handles_labels()
plt.legend(labels=df.columns[1:-1])
plt.xlabel('alpha')
plt.ylabel('weights')
plt.axis('tight')
plt.show()
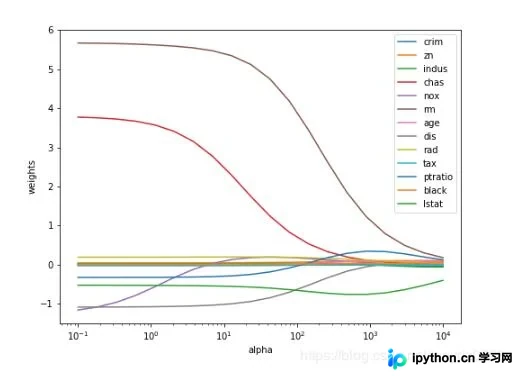
从可视化结果可见,只有nox变量系数有轻微波动。
# 主成分回归进行回归分析
pca_model = PCA()
data_pca = pca_model.fit_transform(X)

# 得到所有主成分方差
ratio_cumsum = np.cumsum(pca_model.explained_variance_ratio_)
# 获取方差占比超过0.8的索引值
rule_index = np.where(ratio_cumsum > 0.9)
# 获取最小的索引值
min_index = rule_index[0][0]
# 根据最小索引值提取主成分
data_pca_result = data_pca[:, :min_index+1]
# 建立回归模型
model_liner = LinearRegression()
# 训练模型
model_liner.fit(data_pca_result, y)
print(model_liner.coef_)
#[[-0.02430516 -0.01404814]]
以上关于Python数据预处理中数据共线性处理的详解内容分享完毕,希望能为大家提供参考,欢迎支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









