Python lxml库Xpath语法实战指南
本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
2026-10-16
13

本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
本文解决PyCharm中from lxml import etree报错问题。主要原因为未安装lxml库。通过访问第三方网站下载对应Python版本和系统架构的whl文件,并在命令行使用pip install命令手动安装,最后重启IDE即可消除标红。
本文总结了在Python中清洗小说数据时去除HTML标签的三种常用方法。通过对比正则表达式、BeautifulSoup解析器以及lxml库的实际代码示例,展示了如何从混杂HTML的字符串中提取纯文本。此外,还介绍了利用正则表达式移除HTML标签属性的技巧,帮助开发者快速实现数据清洗。
本文通过两个Python爬虫实例详解XPath技术的应用。案例一演示如何从图片列表页提取内页链接,进而获取百度网盘地址与提取码,涉及函数传参、循环控制及异常跳过逻辑。案例二针对豆瓣读书评论,解析为何直接获取节点无效,并指出使用/text()提取文本内容的正确方法。文章涵盖requests与lxml库的基础用法及常见错误排查。
本文详解PyCharm中etree与lxml模块标红问题的两种常见原因及解决方法。首先解决解释器路径不匹配导致的红线,其次通过指定版本下载whl文件并pip安装修复库引用错误,帮助开发者快速恢复代码正常提示。
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
本文详细介绍Python中lxml库的etree模块,涵盖从安装到高级解析的全流程。内容包含创建与操作子节点、管理属性、设置文本、处理XML与HTML解析以及使用XPath定位元素,帮助开发者高效进行标签解析。
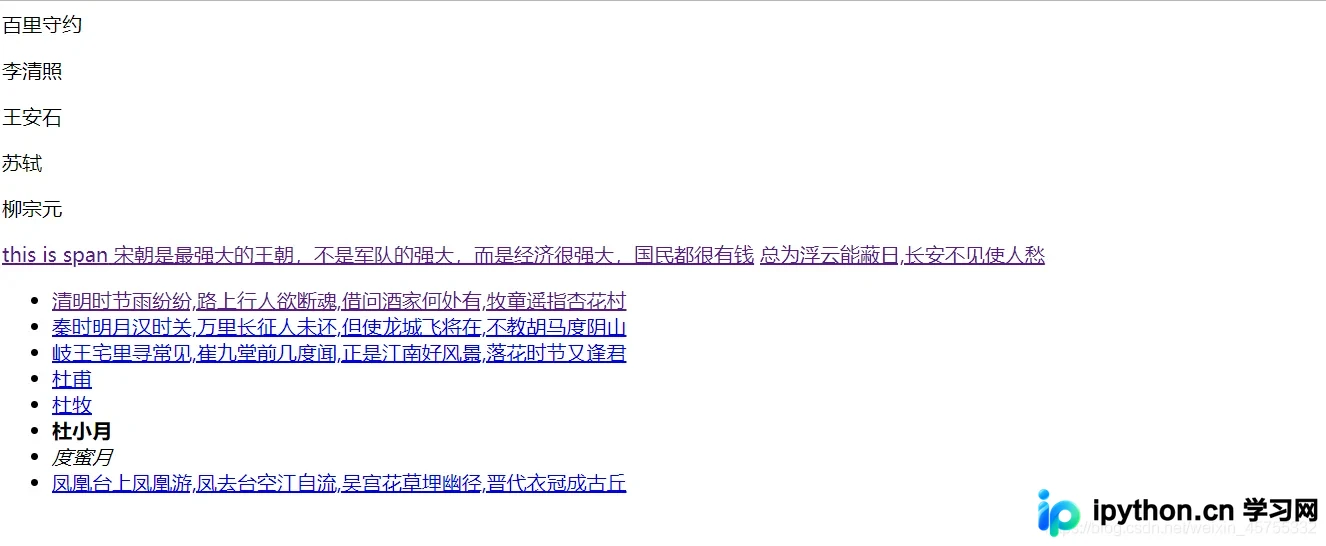
本文深入解析Python爬虫中XPath的核心用法。从lxml库的安装与etree对象实例化入手,详细讲解子节点、属性、索引及文本提取等XPath表达式语法。通过本地HTML测试与58同城二手房信息抓取实战,演示如何定位节点并提取关键数据,帮助开发者掌握高效的数据抓取技巧。
本文介绍如何使用Python编写一个简单的爬虫程序,从特定图片网站批量下载图片。通过Requests发起HTTP请求获取页面源码,利用Lxml结合XPath定位封面链接及高清图片地址,最后将图片保存至本地文件夹。文章包含完整代码示例及优化建议。
本文详细介绍如何使用Python爬取CSDN全站综合热榜的100个文章标题,并通过Jieba库进行分词与词频统计。教程涵盖使用Selenium模拟浏览器滚动加载动态页面、提取HTML源码、利用Lxml解析标题以及统计高频关键词的完整流程,旨在帮助开发者掌握动态网页抓取与数据处理技巧。
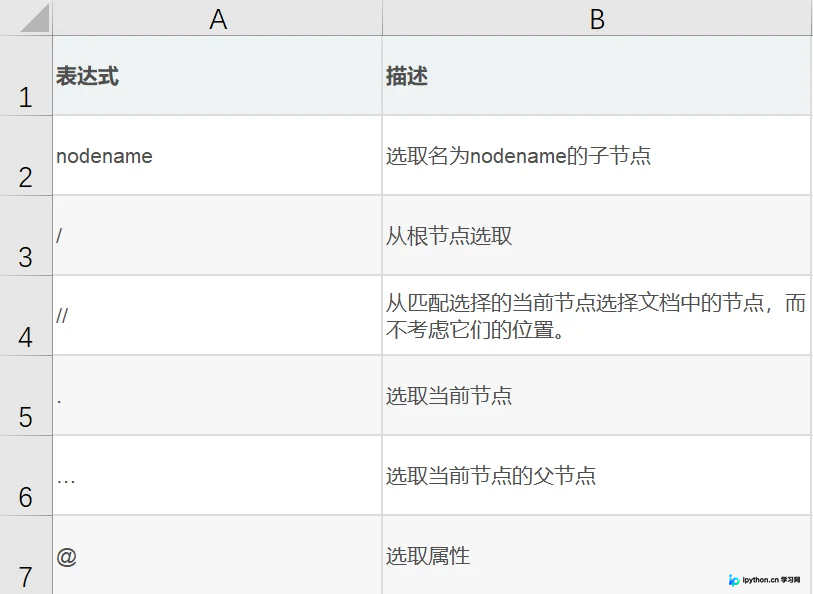
本文详细介绍Python中利用lxml库和XPath技术提取网页数据的方法。内容涵盖XPath基础路径表达式、常用功能函数如contains和text的使用,以及通过requests获取HTML后解析的具体代码示例,帮助开发者高效处理网页元素。
本文分享使用Python获取百度实时热搜的完整代码实现。通过requests库发起请求,结合lxml进行HTML解析,提取热搜标题及排名数据,并演示如何将结果整理为排序后的字典格式,供开发者参考学习。