

Python中使用XPath解析网页元素的完整指南

发布时间:2026-10-14| 4人浏览过
本文详细介绍Python中利用lxml库和XPath技术提取网页数据的方法。内容涵盖XPath基础路径表达式、常用功能函数如contains和text的使用,以及通过requests获取HTML后解析的具体代码示例,帮助开发者高效处理网页元素。
本文旨在探讨如何在Python环境中利用XPath技术高效获取网页中的目标信息。
一、XPath的基本使用原理
XPath全称为XML Path Language,它通过路径表达式来定位XML或HTML文档中的节点及节点集合。选取节点的核心逻辑是沿着指定的路径(path)或执行一系列步骤(steps)来完成。
二、常用路径表达式解析
| 表达式 | 描述 |
|---|---|
| / | 从根节点选取(取子节点) |
| // | 选择的当前节点选择文档中的节点 |
| . | 选取当前节点。 |
| … | 选取当前节点的父节点。 |
| @ | 选取属性 |
| * | 表示任意内容(通配符) |
| | | 运算符可以选取多个路径 |
三、常用功能函数介绍
| 函数 | 用法 | 解释 |
|---|---|---|
| startswith() | xpath(‘//div[starts-with(@id,”ma”)]‘) | #选取id值以ma开头的div节点 |
| contains() | xpath(‘//div[contains(@id,”ma”)]‘) | #选取id值包含ma的div节点 |
| and() | xpath(‘//div[contains(@id,”ma”) and contains(@id,”in”)]‘) | #选取id值包含ma的div节点 |
| text() | _.xpath('./div/div[4]/a/em/text()') | #选取em标签下文本内容 |
注意事项:
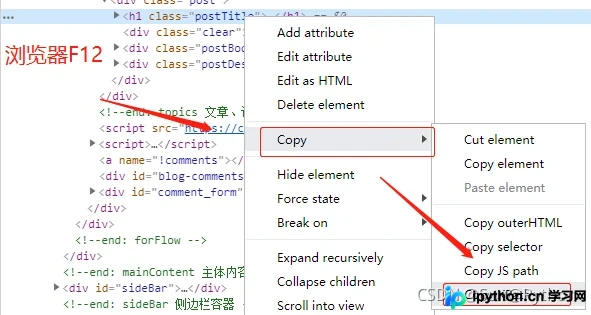
1. 在HTML结构中,若同一层级存在多个相同标签(如多个div),其索引顺序从1开始计算,而非从0开始。\n2. 开发者可以利用浏览器的开发者工具快速查看和验证节点信息,辅助编写XPath表达式。
四、实战代码示例
#!/usr/bin/python3
# -*- coding: utf-8 -*-
# @Time    : 2021/9/7 9:35
# @Author  : Sun
# @Email   : 8009@163.com
# @File    : sun_test.py
# @Software: PyCharm


import requests
from lxml import etree


def get_web_content():
    try:
        url = "htpps://***keyword=%E6%97%A0%E9%92%A2%E5%9C%88&wq=%E6%97%A0%E"
  "9%92%A2%E5%9C%88&ev=1_68131%5E&pvid=afbf41410b164c1b91d"
        "abdf18ae8ab5c&page=5&s=116&click=0 "
        header = {
            "user-agent": "Mozilla/5.0 (Windows NT 10.0; WOW64)"
            "AppleWebKit/537.36 (KHTML, like Gecko) "
                          "Chrome/75.0.3770.100 Safari/537.36 "}
        response = requests.request(method="Get", url=url, headers=header)
        result = response.text
        return result
    except TimeoutError as e:
        return None


def parsing():
    result = get_web_content()
    if result is not None:
        html = etree.HTML(result)
        # 先获取一个大的节点,包含了想要获取的所有信息
        ii = html.xpath('//*[@id="J_goodsList"]/ul/li')

        for _ in ii:
        # 采用循环,依次从大节点中获取小的节点内容
            # ''.join() 将列表中的内容拼接成一个字符串
            infoResult = {
            	# @href 表示:获取属性为href的内容
                'href': "https:" + _.xpath('./div/div[1]/a/@href')[0],
                'title': ''.join(
                        _.xpath('./div/div[2]/div/ul/li/a/@title')),
                # text()表示获取节点i里面的文本信息
                'price': _.xpath('./div/div[3]/strong/i/text()')[0],
                'info': ''.join(
                        _.xpath('./div/div[4]/a/em/text()')).strip(),
                'province': _.xpath('./div/div[9]/@data-province')[0]}
            print(infoResult)
    else:
        raise Exception("Failed to get page information, please check!")

    return None


if __name__ == '__main__':
    parsing()
运行结果截图如下:

以上就是关于Python使用XPath获取页面元素的详细介绍。如需了解更多相关技术内容,欢迎查阅本站历史文章或继续浏览后续教程,感谢大家的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









