

Python XPath爬虫实战:从基础解析到完整脚本构建

本文通过两个Python爬虫实例详解XPath技术的应用。案例一演示如何从图片列表页提取内页链接,进而获取百度网盘地址与提取码,涉及函数传参、循环控制及异常跳过逻辑。案例二针对豆瓣读书评论,解析为何直接获取节点无效,并指出使用/text()提取文本内容的正确方法。文章涵盖requests与lxml库的基础用法及常见错误排查。
案例一:百度网盘链接与提取码抓取流程
案例一:
目标网站以封面形式展示套图,用户需依次点击套图、广告盘链接,最终跳转至百度网盘页面。
本过程利用爬虫技术实现,核心目标是收集百度网盘地址及提取码,采用XPath解析技术进行数据抓取。
首先分析图片列表页,页面按更新时间展示套图封面。查看HTML结构可知,每个“li”标签对应一组套图,其“href”属性即为套图内页地址(即广告盘链接页)。因此,第一步需获取列表页中所有内页地址。
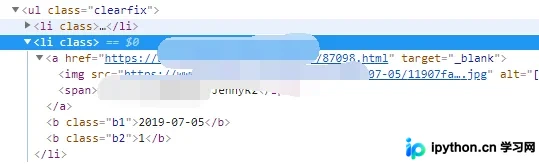
代码如下:
import requests 倒入requests库
from lxml import etree 倒入lxml 库(没有这个库,pip install lxml安装)
url = "https://www.xxxx.com/gc/" 请求地址
response = requests.get(url= url) 返回结果
wb_data = response.text 文本展示返回结果
html = etree.HTML(wb_data) 将页面转换成文档树
b = html.xpath('//ul[@class = "clearfix"]//@href') 这一步的意思是class“clearfix”下所有属性为“href”赋值给“b”,因为我们的目标内容都展示在class“clearfix”下,且在href属性后面
print(b) 打印b,这里的b是一个数组
print(b[0]) 打印b的第一项数据
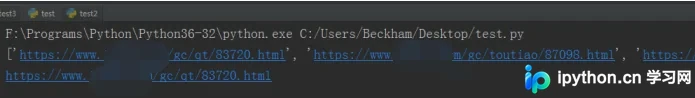
执行结果:成功返回所有内页地址列表。
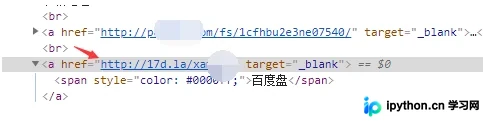
接着打开内页(即广告盘链接页),目标是获取网盘地址。如图所示,当前页面显示的并非最终百度网盘页,需点击特定链接后方可查看。此步骤仅需抓取该跳转链接的地址。
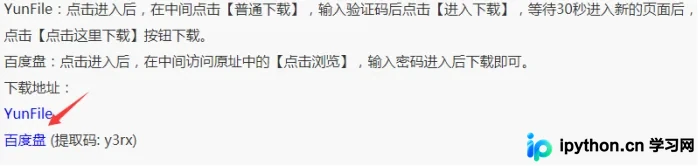
代码如下:
url = "https://www.xxxx.com/gc/toutiao/87098.html"
response = requests.get(url= url)
wb_data = response.text # 将页面转换成文档树
html = etree.HTML(wb_data)
b = html.xpath('//div[@class = "pictext"]//@href')
c=b[1]  #需要注意的地方,class = "pictext"下有两个href,我们只需要第一个href的值,所以返回值再赋值给c且取第二项数据
print(c)
执行结果:成功返回所有内页地址。
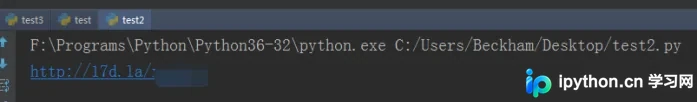
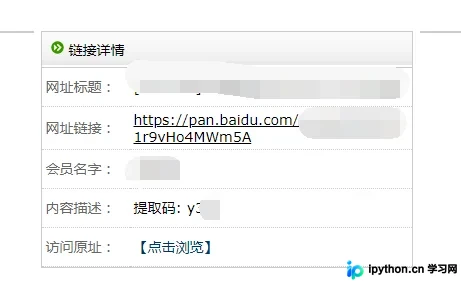
获取到跳转链接后,需打开该地址以抓取真实的百度网盘页面。由于网盘链接和提取码分别位于不同的HTML元素中,最终需返回两组独立数据。
代码如下:
url = "http://xxx.la/xam9I6"
response = requests.get(url= url)
wb_data = response.text
# 将页面转换成文档树
html = etree.HTML(wb_data)
b = html.xpath('//tr/td/text()')
c=b[6]#提取码
d = html.xpath('//tr//@href')#百度地址
print(c)
print(d)
注意,此处HTML的XPath写法与前例略有不同。由于目标元素的父级节点没有class属性,只能采用模糊匹配方式取值。
以提取码为例,其HTML结构如截图所示,路径为//tr/td/。其中单斜杠“/”代表父节点下的直接子节点,双斜杠“//”代表父节点后的任意层级子孙节点。提取码位于tr的子节点中,但该结构下存在多组数据,最终输出为一个数组b(见上方代码中的b)。因此,需定位提取码在数组中的序列位置,并将其赋值给变量c(见上方代码中的c),从而获得真实的百度网盘地址。
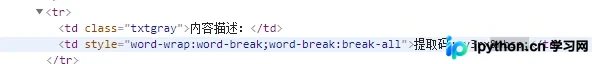
网盘地址因包含href属性,相对容易爬取,只需注意XPath路径中斜杠的数量即可。

将上述步骤整合为一个完整脚本,涉及函数定义、函数间传参以及循环控制。完整代码如下:
# -*-coding:utf8-*-
# encoding:utf-8

import requests
from lxml import etree

firstlink = "https://www.xxx.com/gc/qt/83720.html"
AA=["https://www.xxx.com/gc/",
 "https://www.xxx.com/gc/index_2.html",
 "https://www.xxx.com/gc/index_3.html",
 "https://www.xxx.com/gq/",
 "https://www.xxx.com/gq/index_2.html",
 "https://www.xxx.com/gq/index_3.html",
 "https://www.xxx.com/gq/index_4.html"]

#第1步,获取第一页面所有的地址
def stepa (AA):
 lit=[]
 for url in AA:
  response = requests.get(url=url)
  wb_data = response.text
  # 将页面转换成文档树
  html = etree.HTML(wb_data)
  a = html.xpath('//ul[@class = "clearfix"]//@href')
  lit.append(a)
 return(lit)
alllink = stepa(AA)

#第2步,获取的地址,循环读取打开,从而获取百度网盘信息
def stepb(alllink,firstlink):
 for list in alllink:
  for url in list:
   if url in firstlink:
    continue
   elif "www" in url:
    url2 = url
   else:
    url2 ="https://www.xxx.com" +url
   response = requests.get(url=url2)
   wb_data = response.text # 将页面转换成文档树
   html = etree.HTML(wb_data)
   b = html.xpath('//div[@class = "pictext"]//@href')
   c = b[1]
   #print(c)
   #获取到广告页地址
   url3 = c
   response = requests.get(url=url3)
   wb_data = response.text
   # 将页面转换成文档树
   html = etree.HTML(wb_data)
   d = html.xpath('//tr/td/text()')
   #print(d)
   e=d[6]#获取提取码
   f = html.xpath('//tr//@href')#获取地址
   test = e[-5:]#提取码值只保留提取码(4位)
   test2 = f[-1]#链接只保留链接内容,去掉前后['']
   test3=test2+test#把链接和提取码拼接成一条数据
   print(test3)
   with open('C:/Users/Beckham/Desktop/python/1.txt', 'a',encoding='utf-8') as w:
    w.write('\n'+test3)
    w.close()
stepb(alllink,firstlink)

#第3步:提示爬取完成
def over():
 print("ok")
over()
需要注意的地方:
1、return的用法:若需将函数生成的值传递给后续函数使用,必须返回该值。例如在def stepa中定义的变量a为爬取的套图封面地址(通过打开该地址进行下一步操作),需使用return(a)返回a的值,否则执行后将无数据返回。
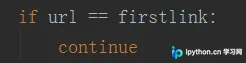
2、Continue的应用:由于第一个套图地址打开后的内容不包含目标元素,直接解析会报错,因此在读取套图地址时需跳过第一个地址。通过添加if判断,当第一个地址等于事先定义的非正常地址时,使用continue跳过该次循环。

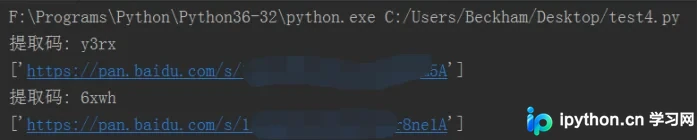
打印结果:
案例二:豆瓣读书评论文本提取技巧
案例二:
爬取豆瓣读书的评论数据。
分析HTML结构,评论数据存储于标记为红色的元素位置。观察结构发现,其他评论均存储在li节点的相同层级下。
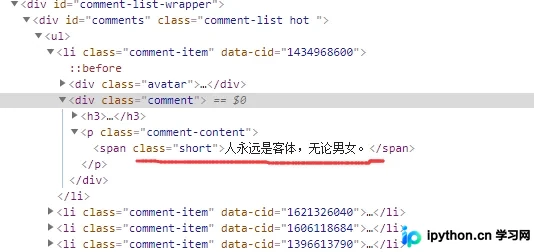
因此,XPath的解析对象设定为//*[@id="comments"]//div[2]/p/span。
前文实例已讲解“//”代表从当前节点选取子孙节点,此处可直接跳过li节点,直接选择li后的div[2]/p/span内容。
代码如下:
# -*-coding:utf8-*-
# encoding:utf-8

import requests
from lxml import etree

firstlink = "https://book.douban.com/subject/30172069/comments/hot?p=6"

def stepa (firstlink):
 response = requests.get(url=firstlink)
 wb_data = response.text
 html = etree.HTML(wb_data)
 a = html.xpath('//*[@id="comments"]//div[2]/p/span')
 print(a)
stepa (firstlink)
运行代码,打印结果如下图所示,未能得到预期的评论内容。
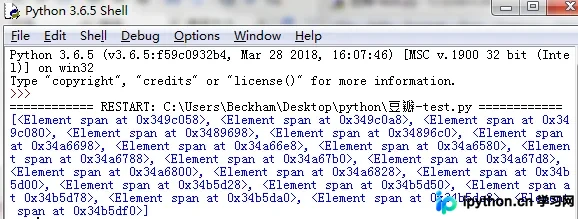
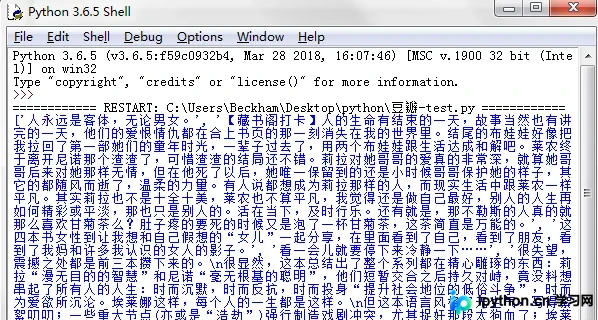
经排查发现,若要获取具体内容,必须以文本形式输出。即XPath的解析对象应调整为//*[@id="comments"]//div[2]/p/span/text()。
修改后的代码
# -*-coding:utf8-*-
# encoding:utf-8

import requests
from lxml import etree

firstlink = "https://book.douban.com/subject/30172069/comments/hot?p=6"

def stepa (firstlink):
 response = requests.get(url=firstlink)
 wb_data = response.text
 html = etree.HTML(wb_data)
 a = html.xpath('//*[@id="comments"]//div[2]/p/span/text()')
 print(a)
stepa (firstlink)
再次执行,成功获取评论内容。
参考地址:https://cuiqingcai.com/5545.html
总结
以上所述是小编给大家介绍的python 中xpath爬虫实例详解,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持! 如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









