

Python爬虫实战:批量下载图片网站的封面与高清图

发布时间:2026-10-15| 5人浏览过
本文介绍如何使用Python编写一个简单的爬虫程序,从特定图片网站批量下载图片。通过Requests发起HTTP请求获取页面源码,利用Lxml结合XPath定位封面链接及高清图片地址,最后将图片保存至本地文件夹。文章包含完整代码示例及优化建议。
前言
近期,一位朋友希望收集某网站上的大量女性人物照片,委托我协助完成批量下载任务。经过半天的编写与运行,最终成功将所有图片下载完毕。
引入库
import time
import requests
from lxml import etree这三个库是为了让我们在请求别人网站的时候,让程序休息一会,避免别人的网站会拦截或者崩溃和将得到的页面源代码进行解析。网页分析

首先,利用浏览器的开发者工具对目标网页进行结构分析,定位并提取每个图片封面对应的链接地址。
href = tree.xpath('//*[@id="features"]/div/div[1]/div/div[1]/a/@href')获取封面链接后,这并非最终目标。我们需要进一步访问这些封面链接指向的详情页,以获取实际的高清图片地址。
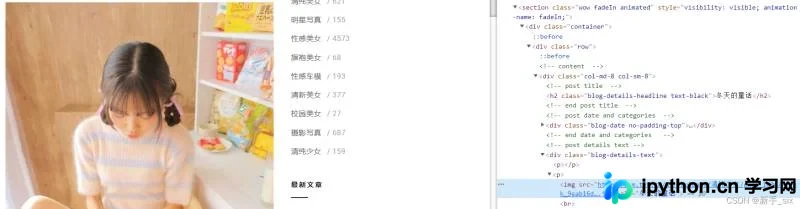
进入详情页后,可以发现每张图片均被包裹在<p>标签内。通过编写循环逻辑,遍历页面源码即可提取出每张图片的具体URL地址。
 for url_img in href:
            img_url = requests.get(url_img,headers=head)
            # print(img_url.text)
            time.sleep(1)
            t = etree.HTML(img_url.text)
            url_list = t.xpath("/html/body/section/div/div/div[1]/div[2]/p[2]/img/@src")
后续步骤相对简单,只需将获取到的图片二进制数据写入本地文件,即可完成保存,从而得到所需的图片资源。
 with open(f"./img/{name}",mode="wb") as f:
        f.write(download_img.content)
        print("正在下载:" +name)
        time.sleep(1)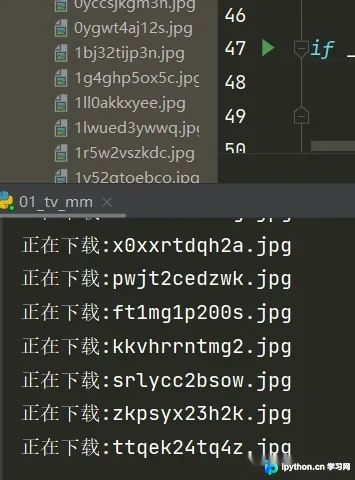
总结
上述同步下载方式效率较低,建议后续引入多线程或异步协程机制,以显著提升下载速度。
当前代码可能存在优化空间,欢迎有经验的开发者提出更简洁的写法建议,在此表示感谢。
完整代码
import time
import requests
from lxml import etree

def get_page_url():
    for i in range(1, 4): # 循环3页
        url = f"https://mm.tvv.tw/category/xinggan/{i}/"

        # 请求页面得到源代码
        res = requests.get(url,headers=head)
        # 对源代码进行解析
        tree = etree.HTML(res.text)
        # 得到每个图片的封面url(href)
        href = tree.xpath('//*[@id="features"]/div/div[1]/div/div[1]/a/@href')
        # print("-------------------------------------------------------")
        time.sleep(3)
        for url_img in href:
            img_url = requests.get(url_img,headers=head)
            # print(img_url.text)
            time.sleep(1)
            t = etree.HTML(img_url.text)
            url_list = t.xpath("/html/body/section/div/div/div[1]/div[2]/p[2]/img/@src")
            # print(url_list)
            time.sleep(1)
            for url_src in url_list:
                get_img(url_src)

def get_img(url):
    name = url.rsplit("/",1)[1]
    time.sleep(2)
    download_img = requests.get(url,headers=head)
    with open(f"./img/{name}",mode="wb") as f:
        f.write(download_img.content)
        print("正在下载:" +name)
        time.sleep(1)
    f.close()


if __name__ == '__main__':
    head = {"user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/97.0.4692.71 Safari/537.36"}
get_page_url()到此这篇关于python爬取一组小姐姐图片实例的文章就介绍到这了,更多相关python爬取图片内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









