

Python抓取百度热搜榜完整实现代码
本文分享使用Python获取百度实时热搜的完整代码实现。通过requests库发起请求,结合lxml进行HTML解析,提取热搜标题及排名数据,并演示如何将结果整理为排序后的字典格式,供开发者参考学习。
2026-10-14
6

本文分享使用Python获取百度实时热搜的完整代码实现。通过requests库发起请求,结合lxml进行HTML解析,提取热搜标题及排名数据,并演示如何将结果整理为排序后的字典格式,供开发者参考学习。
本文介绍如何在Python中处理带有命名空间的XML文档。通过封装XMLNamespaces类简化ElementTree的查询操作,避免繁琐的全URI匹配。同时对比了iterparse的高级用法,并建议在需要DTD验证或复杂XPath时优先使用lxml库,以提升解析效率与功能支持。
本文介绍如何使用Python结合lxml库进行网页HTML分析与数据抓取。通过urllib和urllib2构建HTTP请求,利用lxml解析HTML并操作表单字段,实现自动提交GET/POST请求。代码示例展示了如何模拟浏览器行为、处理Cookie及提交表单数据,适用于基础网页自动化场景。
本文系统总结Python网络爬虫中常用的四种数据提取工具:正则表达式、BeautifulSoup、Lxml及CSS选择器。通过对比分析各模块的安装方式、解析原理、代码构造难度及运行性能,指出Lxml因C语言底层实现而在速度与健壮性上占优,而BeautifulSoup适合轻量级场景。文章提供各选择器的典型用法示例,帮助开发者根据实际需求选择最合适的数据抓取方案。
本文通过一个实际案例,演示如何使用Python自动下载网站图片。从基础的单线程脚本入手,逐步优化至多进程和多线程版本,对比不同并发策略在I/O密集型任务中的性能差异,帮助开发者掌握提升爬虫效率的关键技术。
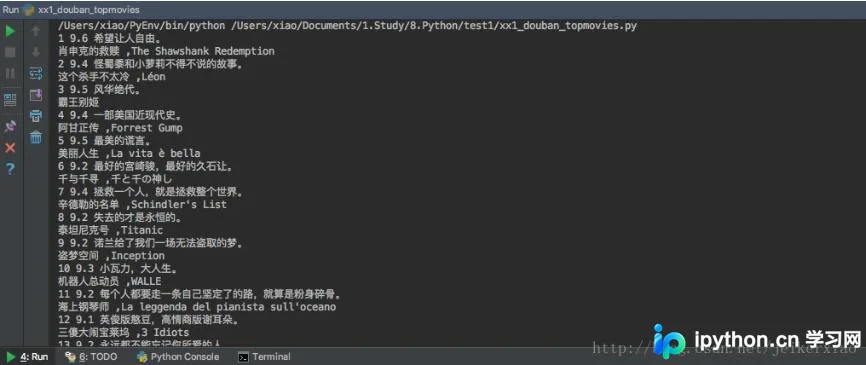
本文通过豆瓣电影Top250及新浪新闻两个实例,详细演示了Python3中requests库发送HTTP请求与lxml库etree模块进行XPath解析的完整流程。内容涵盖会话保持、编码处理、节点定位及数据清洗,帮助开发者掌握基础的网页抓取与解析技术。
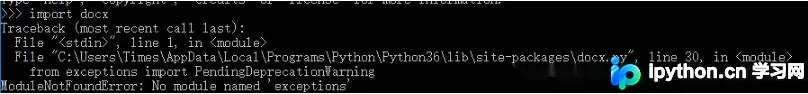
本文介绍解决Python中import docx时遇到的DLL load failed错误。通过排查发现该问题由lxml版本冲突引起,建议将lxml降级至3.7.3版本。若后续出现No module named 'exceptions'错误,可通过安装python-docx包解决。
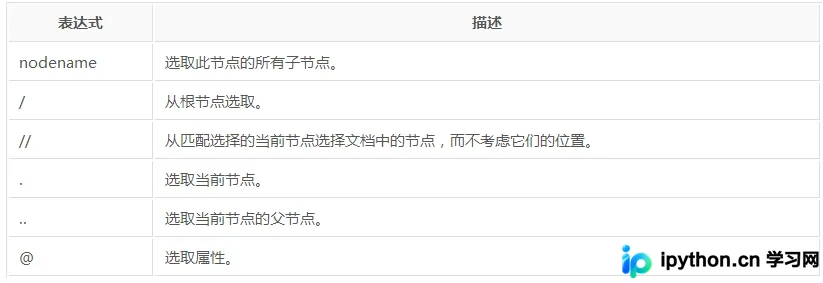
本文详细介绍Python中lxml库解析HTML文件的方法。涵盖DOM节点创建与属性获取、XPath绝对与相对路径筛选、文本提取及Scrapy爬虫实战示例。重点强调UTF-8解码必要性及常见解析错误处理,帮助开发者高效处理网页数据。
本文详解使用Python提取Bilibili视频弹幕的完整流程。核心在于通过手机User-Agent请求视频页面,利用正则表达式从响应JavaScript中提取弹幕接口所需的cid参数,拼接生成以.xml结尾的弹幕URL。随后发起二次请求获取XML数据,借助lxml库解析并提取文本内容,最终保存至本地文件。

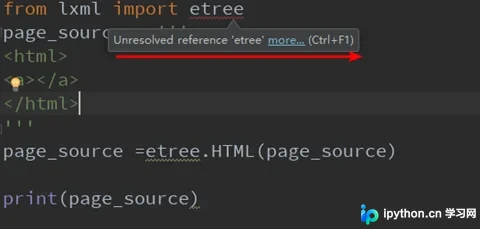
本文解析Python中使用lxml库时etree导入报红但不影响运行的原因。指出这是IDE对C扩展模块的误报,并提供通过html模块调用etree的替代写法,确保代码提示正常且功能不受影响。
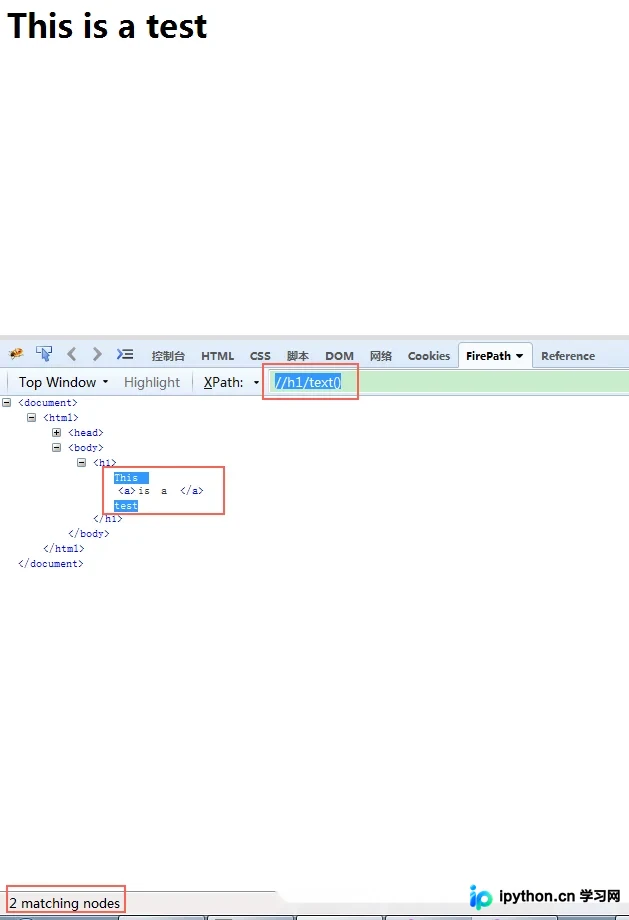
本文介绍Python中lxml库的etree模块在HTML解析中的应用。重点讲解etree.HTML()将字符串转为_Element对象,以及利用xpath()提取文本。针对嵌套标签导致的文本分割问题,对比了//h1/text()与//h1//text()的区别,并演示了etree.tostring()结合method='text'参数高效获取完整文本的方法。
本文介绍在Python 2.7.12环境下,利用lxml 3.8.0库通过XPath表达式提取HTML页面中注释节点的具体方法。通过etree.HTML解析字符串,定位特定元素下的node()节点,可获取并验证lxml.etree._Comment类型的注释内容,适用于需要解析页面隐藏信息的场景。