

Python实现Markdown转HTML简易转换器:从正则处理到本地预览
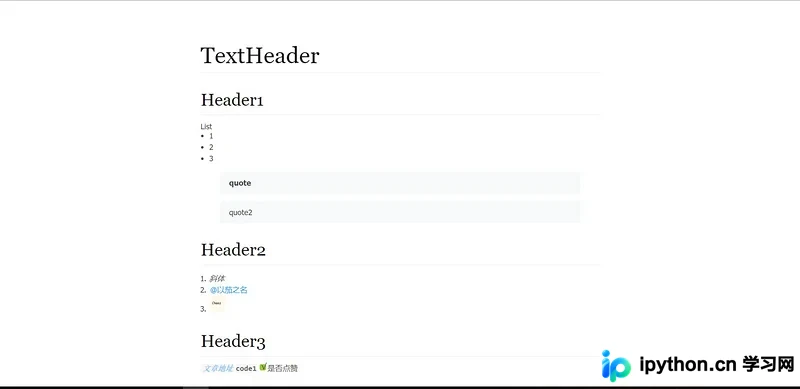
本文介绍如何使用Python编写一个简易的Markdown转HTML转换器。通过正则表达式处理行内代码、加粗、斜体、链接及图片,并逐行解析列表、引用等块级语法。代码包含自定义CSS样式以优化复选框和表格显示,最终利用webbrowser模块在本地Chrome浏览器中打开生成的HTML文件,实现Markdown内容的快速预览。
2026-10-13
6

本文介绍如何使用Python编写一个简易的Markdown转HTML转换器。通过正则表达式处理行内代码、加粗、斜体、链接及图片,并逐行解析列表、引用等块级语法。代码包含自定义CSS样式以优化复选框和表格显示,最终利用webbrowser模块在本地Chrome浏览器中打开生成的HTML文件,实现Markdown内容的快速预览。
本文介绍Django中利用母板页面实现代码复用的核心机制。通过{% block %}定义占位符,子页使用{% extends %}继承母板并填充具体HTML内容。文章提供base.html基础模板及两个具体继承页面的代码示例,展示如何统一导航样式并差异化显示主体内容,帮助开发者构建结构清晰的Web应用界面。
本文介绍如何利用Python内置的difflib库中的HtmlDiff类,快速比较两个文本文件的内容差异。通过读取指定文件内容,生成包含高亮差异的HTML格式报告,并自动保存至本地目录。代码包含完整的参数校验、文件读写及异常处理逻辑,适用于日常开发中的文件版本对比场景。
本文介绍如何使用Python3通过SMTP协议发送HTML格式邮件。主要步骤包括开启邮箱SMTP服务并获取授权码,利用smtplib和email模块构建邮件对象。文中提供了基于Python 3.6.3和PyCharm 2017.3的完整代码示例,涵盖读取本地HTML文件、设置邮件头及发送逻辑,并提示了邮件可能被归入垃圾邮件的情况。
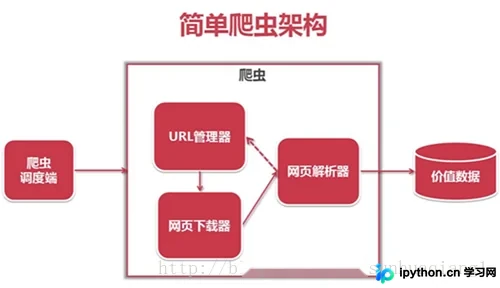
本文深入解析Python爬虫的核心架构,详细阐述URL管理器、HTML下载器及HTML解析器的功能与实现。通过完整代码示例,展示如何构建爬虫调度程序,实现网页数据的抓取、解析与输出。适合希望掌握Python爬虫基础原理与实战开发的开发者参考。
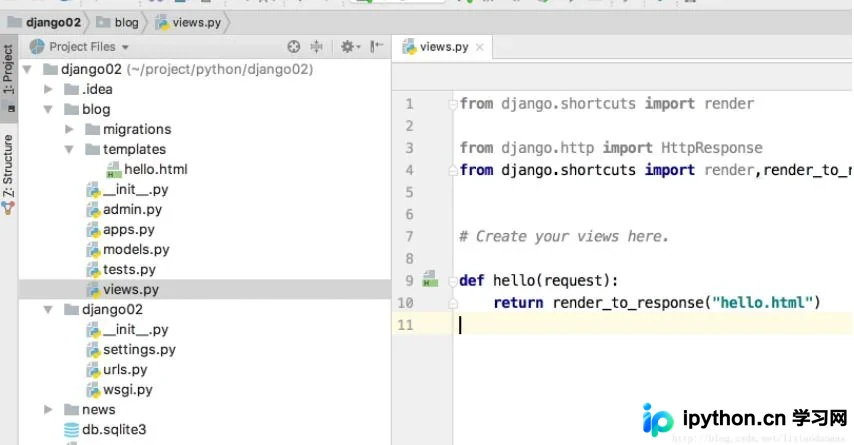
本文介绍在Django框架中如何加载本地HTML文件,并通过视图函数向模板传递数据。通过定义Python对象和字典,利用render_to_response将标题、用户信息及列表内容传递给HTML模板,实现动态数据展示。
本文介绍在Django框架中直接输出HTML字符串的两种解决方案。针对单个变量,推荐使用safe过滤器关闭自动转义;针对模板片段,可使用autoescape标签控制转义范围。文章同时解析Django默认进行HTML转义以防范XSS攻击的安全机制,帮助开发者在功能需求与安全性之间取得平衡。
本文深入解析Python中smtplib库的多种邮件发送场景。涵盖纯文本、HTML格式、内嵌图片、附件携带、群发以及包含所有元素的复杂邮件构造。重点演示基于SSL/TLS的安全加密传输实现,提供完整可运行的代码示例,帮助开发者掌握Python自动化邮件处理的核心技能。
本文介绍如何利用Python的smtplib模块实现自动化邮件发送功能,适用于自动化测试报告的分发场景。通过示例代码演示了纯文本和HTML两种格式邮件的构建与发送方法,包括服务器配置、登录认证及内容封装步骤,帮助开发者快速集成邮件通知功能。

本文介绍如何使用Python的urllib库下载网页源码并保存为本地HTML文件。通过示例代码展示如何获取指定URL的网页内容,并将其以二进制模式写入本地文件。该方法适用于提取纯文本内容,但需注意本地保存的文件不包含外部引用的图片等资源。
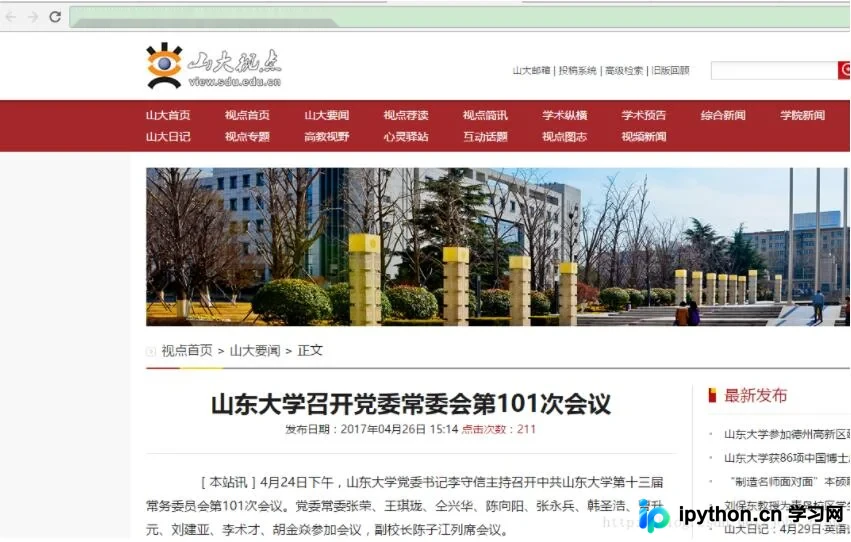
本文介绍如何使用Python的Beautiful库读取本地HTML文件,并通过CSS选择器提取特定网页元素。文章提供了两种代码实现方式,对比了select方法的等效写法以及获取文本的多种途径,最后附带示例HTML结构,帮助开发者快速掌握本地网页数据的解析技巧。
本文介绍如何使用Python的lxml模块提取HTML页面中所有叶子节点的XPath路径。针对原始解析结果包含非叶子节点的问题,提出基于路径包含关系的过滤算法:若当前路径被下一路径包含则跳过,否则视为叶子节点。通过实际代码演示了从原始XPath列表到纯净叶子节点XPath列表的转换过程,并提供了相关XML处理工具推荐。