Python Selenium获取HTML元素文本并验证详解
本文介绍如何利用Python Selenium库定位HTML页面中的特定div元素,提取其文本内容,并与预设的期望字符串进行比对验证。通过XPath定位元素并获取text属性,实现自动化测试中的结果校验逻辑,适用于Web应用的功能性测试场景。
2026-10-13
6

本文介绍如何利用Python Selenium库定位HTML页面中的特定div元素,提取其文本内容,并与预设的期望字符串进行比对验证。通过XPath定位元素并获取text属性,实现自动化测试中的结果校验逻辑,适用于Web应用的功能性测试场景。
本文介绍了一种在Python中利用XPath获取Div或A标签内部HTML内容的方法。由于原生XPath不直接支持获取innerhtml,通过编写辅助函数提取标签内的HTML标记和文本,实现了类似InnerHtml的功能,并提供完整代码示例供参考。
本文介绍了使用Python进行文本处理的三个核心步骤:去除HTML标签、提取指定长度的单词以及统计词频。通过DocProcess类封装strip_html、separate_words和get_words_frequency方法,实现从原始文本到词频字典的完整处理流程。代码展示了正则表达式在单词分割中的应用及字典计数逻辑,适用于基础文本分析场景。
本文详细介绍Python中BeautifulSoup库的安装方法及基础使用。通过PyCharm自动安装bs4库,并演示如何将HTML源码转换为BeautifulSoup对象。文章解析了HTML标签的层级结构,讲解如何提取title等节点信息,并对比多种属性访问方式,帮助初学者快速掌握网页数据抓取的核心技巧。
本文介绍在Python3中如何利用urllib请求网页数据,并结合BeautifulSoup库解析HTML内容。通过具体代码示例,演示如何获取标题、类名、ID等属性值,以及使用select方法按标签、类名或ID进行精准查找,为网页数据抓取提供实用参考。
本文介绍在Python Flask框架中,如何将包含中文字符的List数据正确输出到HTML模板的JavaScript中。通过json.dumps设置ensure_ascii=False避免Unicode编码,并在Jinja2模板中使用safe过滤器处理变量,确保中文数据在JS中正常解析与显示。
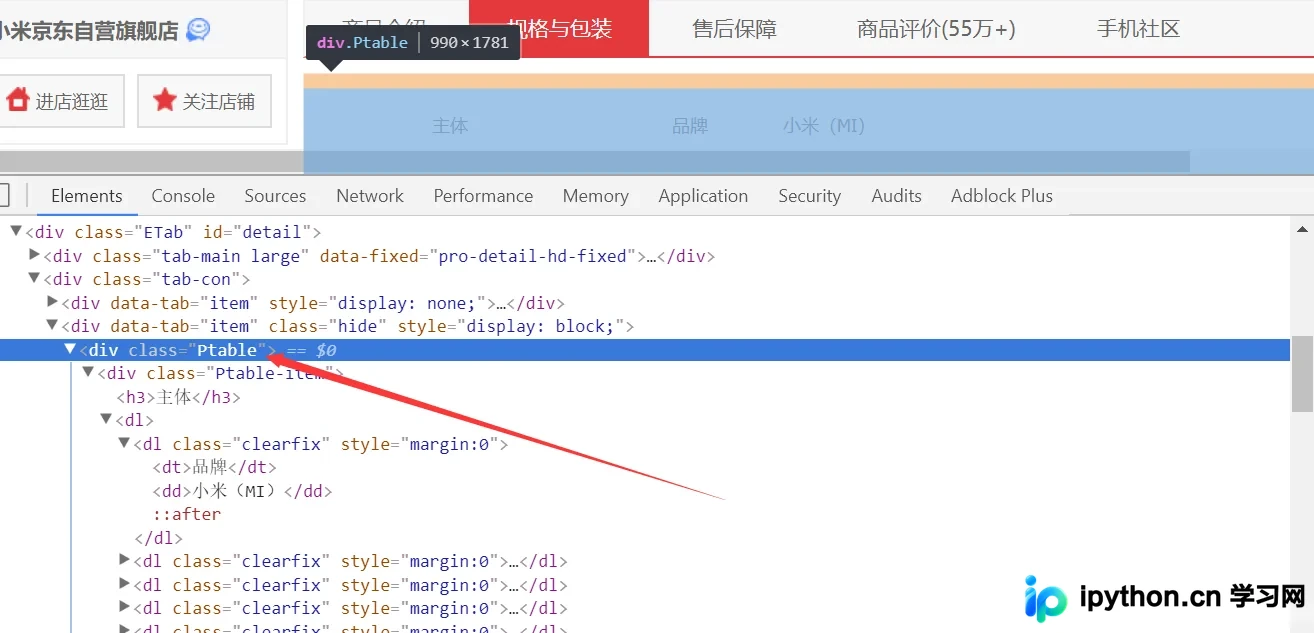
本文演示如何使用Python的requests库获取京东商品页面源码,并结合BeautifulSoup解析HTML结构。通过定位特定class的div容器,提取dl、dt和dd标签中的键值对数据,最终使用pandas构建DataFrame存储商品参数信息。
本文介绍一种通过Python将Excel文件转换为图片的方法。核心思路是将Excel数据先转换为HTML格式,再利用imgkit库将HTML渲染为图片。代码展示了如何使用pandas处理多Sheet并生成HTML,以及如何调用imgkit完成最终的图片转换,适用于需要批量导出Excel报表为图片的场景。
本文介绍如何使用Python的pandas库将Excel文件转换为HTML格式。通过读取Excel文件并调用to_html()方法,可以生成包含表格数据的HTML代码。示例代码展示了完整的转换过程,包括文件读取、解析及写入HTML文件的操作,适用于需要快速将表格数据嵌入网页的场景。
本文介绍了一种使用Python正则表达式过滤HTML标签并替换字符实体的方法。通过定义特定的正则规则,依次移除CDATA、脚本、样式及HTML注释,将换行标签转换为实际换行,并清理多余空格。同时,代码包含处理常用HTML字符实体的逻辑,确保文本内容的纯净与可读性,适用于需要清洗HTML源码的场景。
本文详细介绍Python中BeautifulSoup库的基础使用方法。内容涵盖库的安装命令、HTML文档的引入方式,以及利用find、select等API提取标题、属性、文本及特定标签的实操技巧,帮助开发者快速掌握HTML数据解析核心技能。
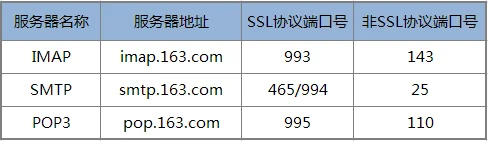
本文详解Python基于SMTP协议发送电子邮件的完整实现。涵盖纯文本、HTML格式、带附件及嵌入图片邮件的构造方法。通过smtplib与email模块配合,结合网易163邮箱实例,提供客户端授权密码配置、消息体构建及sendmail调用的具体代码示例,帮助开发者掌握Python邮件自动化发送技能。