

Django框架防御XSS跨站脚本攻击的实用方案
本文深入解析Django框架中XSS跨站脚本攻击的成因及防御策略。重点剖析{{comment|safe}}过滤器在富文本场景下的潜在风险,并详细介绍如何利用django.utils.html模块中的escape、strip_tags及remove_tags函数,对用户输入进行服务端转义处理,从而有效阻断脚本注入,保障Web应用安全。
2026-10-13
6

本文深入解析Django框架中XSS跨站脚本攻击的成因及防御策略。重点剖析{{comment|safe}}过滤器在富文本场景下的潜在风险,并详细介绍如何利用django.utils.html模块中的escape、strip_tags及remove_tags函数,对用户输入进行服务端转义处理,从而有效阻断脚本注入,保障Web应用安全。
本文演示如何使用Python的urllib库获取基金网站网页内容,并利用BeautifulSoup库解析HTML结构。通过具体代码示例,展示如何读取网页源码、处理编码问题,并提取基金编码、名称及净值等关键信息,供Python开发者参考学习。
本文深入解析Django模板语言(DTL)的核心用法,涵盖变量渲染、常用标签与过滤器的具体实现。重点讲解模板继承机制以优化代码结构,并阐明render函数默认HTML转义原理及safe过滤器的应用,帮助开发者掌握Django前端模板的最佳实践。
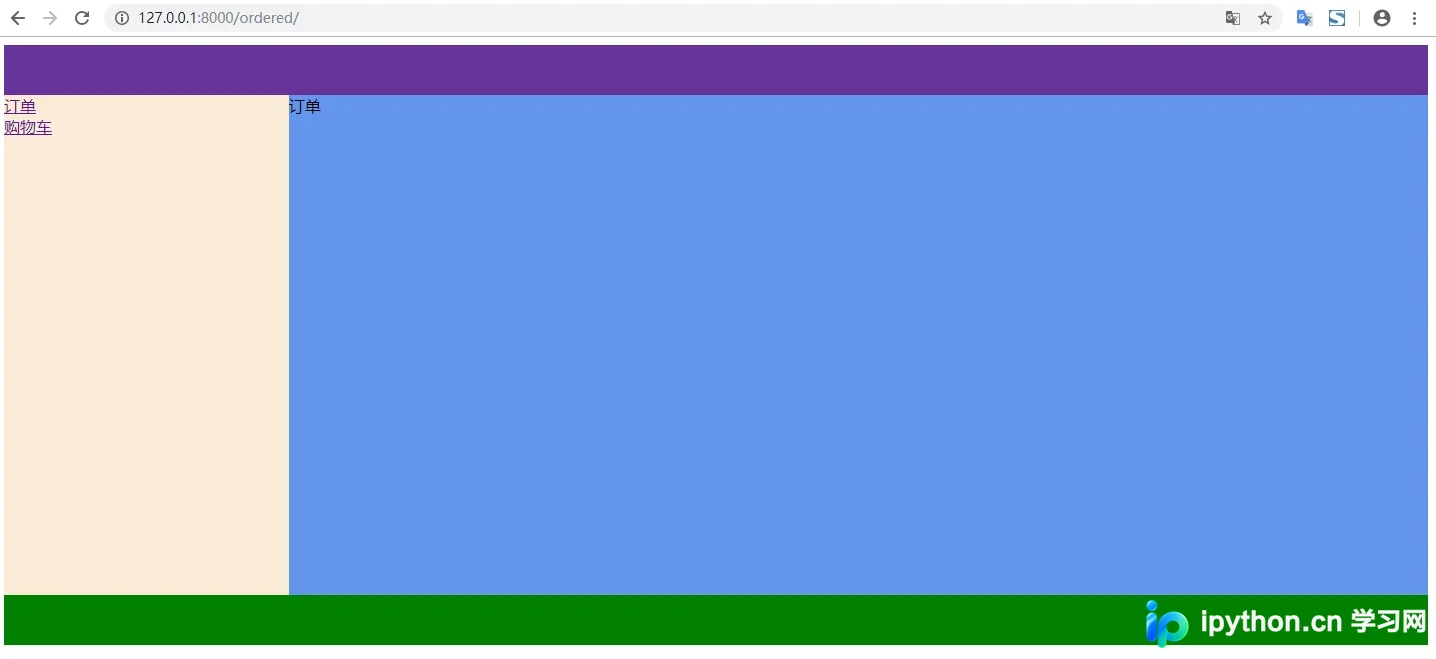
本文详细解析Django中模板继承extend标签的使用。通过修改views.py和urls.py配置路由,创建包含CSS样式的base.html基础模板,并在ordered.html等子页面中利用{% extends %}和{% block %}标签实现页面复用与布局统一,提供完整的代码示例与效果说明。
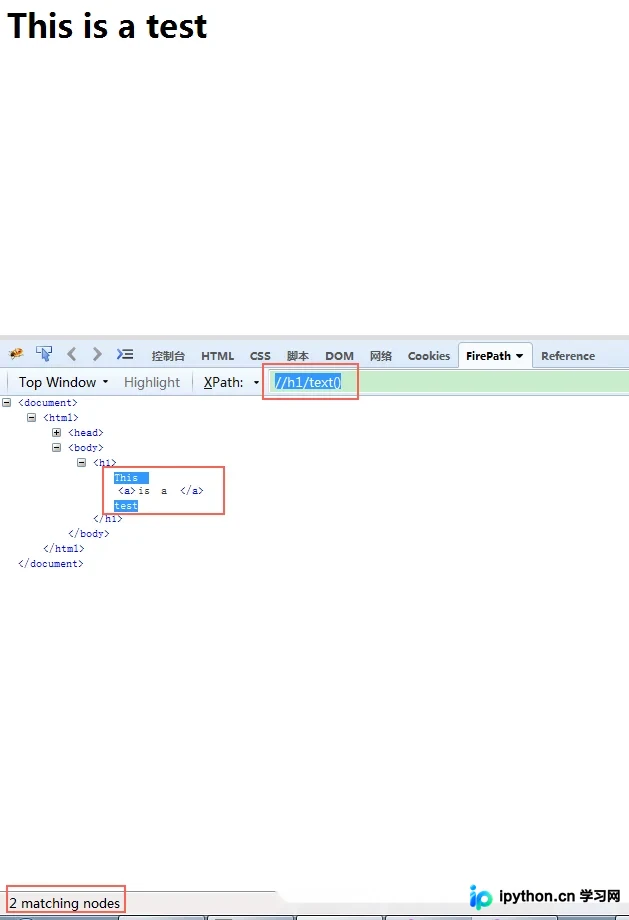
本文介绍Python中lxml库的etree模块在HTML解析中的应用。重点讲解etree.HTML()将字符串转为_Element对象,以及利用xpath()提取文本。针对嵌套标签导致的文本分割问题,对比了//h1/text()与//h1//text()的区别,并演示了etree.tostring()结合method='text'参数高效获取完整文本的方法。
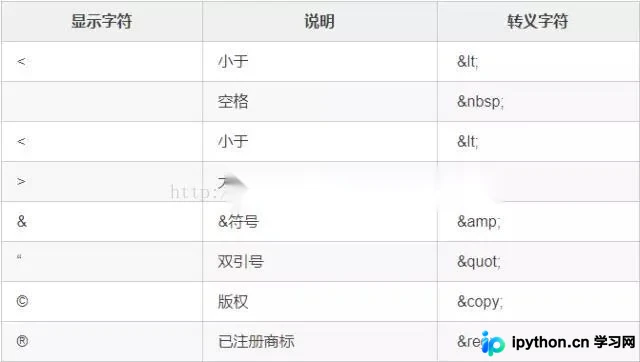
本文详解Python中处理HTML转义字符反转义的几种方法。重点介绍Python 3.4+推荐的html.unescape函数,以及Python 2和3中HTMLParser模块的使用差异。同时提供xml.sax.saxutils.unescape的替代方案,帮助开发者在不同Python版本中正确解析HTML实体。
本文深入解析Python内置HTMLParser模块的工作原理,详细列举handle_starttag等核心回调函数。通过一个完整的贴吧图片抓取实例,演示如何继承HTMLParser并重写方法以提取GIF和JPG链接,实现自动下载功能,为Python爬虫开发提供实用参考。
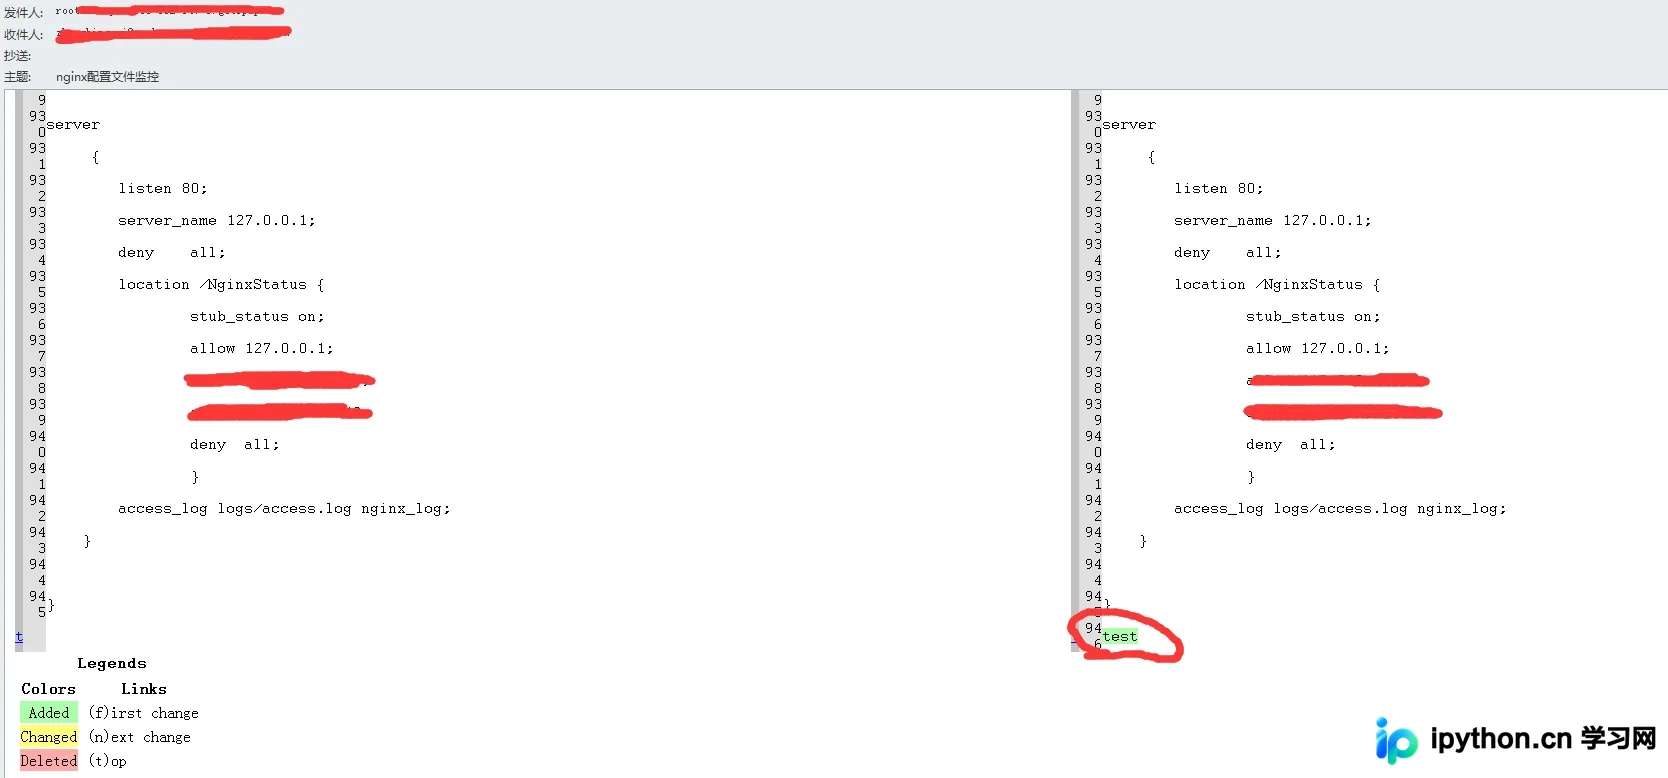
本文介绍使用Python脚本监控多台Nginx服务器配置文件差异的方法。通过对比文件大小及内容,利用difflib生成HTML差异报告,并通过SMT自动发送报警邮件。结合Crontab定时任务,可有效防止因配置不一致导致的访问故障,提升运维效率。
本文介绍如何使用Python结合Selenium和unittest框架,批量查找并执行指定目录下的所有测试用例。通过遍历文件生成测试套件,并利用HTMLTestRunner库将执行结果输出为详细的HTML格式报告,便于查看自动化测试的覆盖情况与执行状态。
本文介绍在Python 2.7.12环境下,利用lxml 3.8.0库通过XPath表达式提取HTML页面中注释节点的具体方法。通过etree.HTML解析字符串,定位特定元素下的node()节点,可获取并验证lxml.etree._Comment类型的注释内容,适用于需要解析页面隐藏信息的场景。
本文介绍如何使用Python的lxml库解析HTML字符串,并通过XPath语法提取元素属性、文本内容及特定节点。通过示例演示了从字符串解析HTML、遍历元素列表、提取文本以及定位特定属性节点的具体实现步骤。
本文介绍如何利用Python Selenium库定位HTML页面中的特定div元素,提取其文本内容,并与预设的期望字符串进行比对验证。通过XPath定位元素并获取text属性,实现自动化测试中的结果校验逻辑,适用于Web应用的功能性测试场景。