CentOS 中如何设置 Python 数据库连接:以 MySQL 为例
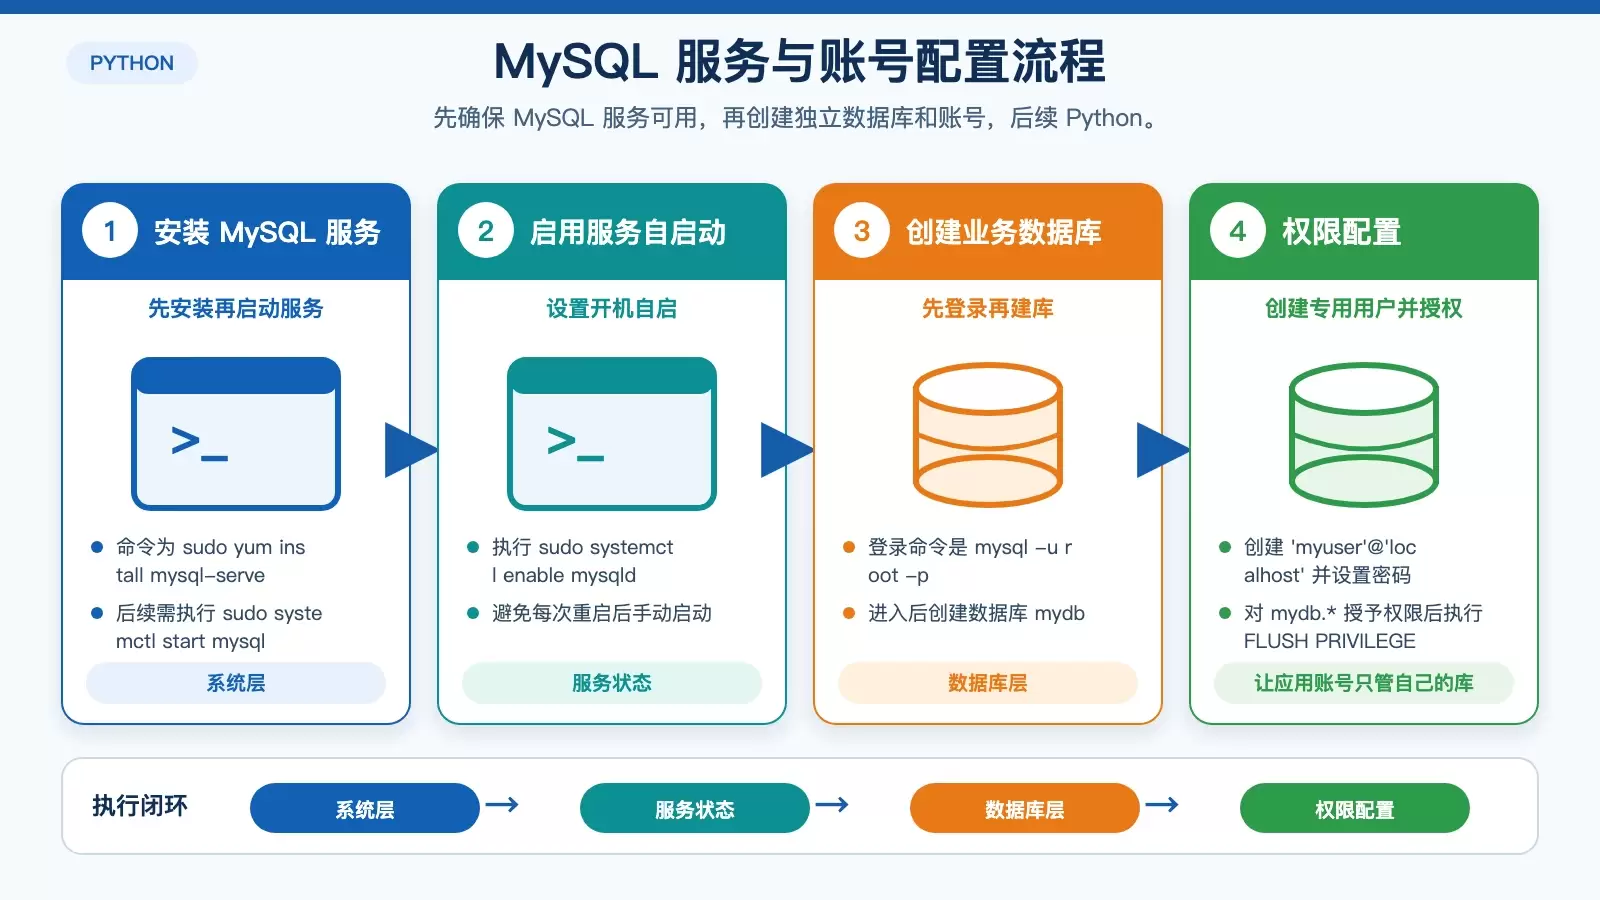
这篇文章用 MySQL 为例,梳理了在 CentOS 中让 Python 成功连上数据库的基础流程:安装服务、创建专用库和用户、安装驱动、编写测试脚本并排查常见报错。适合本地开发或测试环境快速搭建。 在 CentOS 上配置 Python 连接数据库,真正容易卡住的往往不是代码本身,而是服务状态、账号权限和连接参数没有对齐。
2026-08-22
71

这篇文章用 MySQL 为例,梳理了在 CentOS 中让 Python 成功连上数据库的基础流程:安装服务、创建专用库和用户、安装驱动、编写测试脚本并排查常见报错。适合本地开发或测试环境快速搭建。 在 CentOS 上配置 Python 连接数据库,真正容易卡住的往往不是代码本身,而是服务状态、账号权限和连接参数没有对齐。
这篇文章把 `dotnet ef` 的核心命令按实际开发场景重新梳理:先说明安装与执行前提,再拆解迁移、数据库更新、逆向工程和排错要点。无论你是 Code First 还是 Database First,都能据此快速判断该用哪条命令、哪些参数必须带。
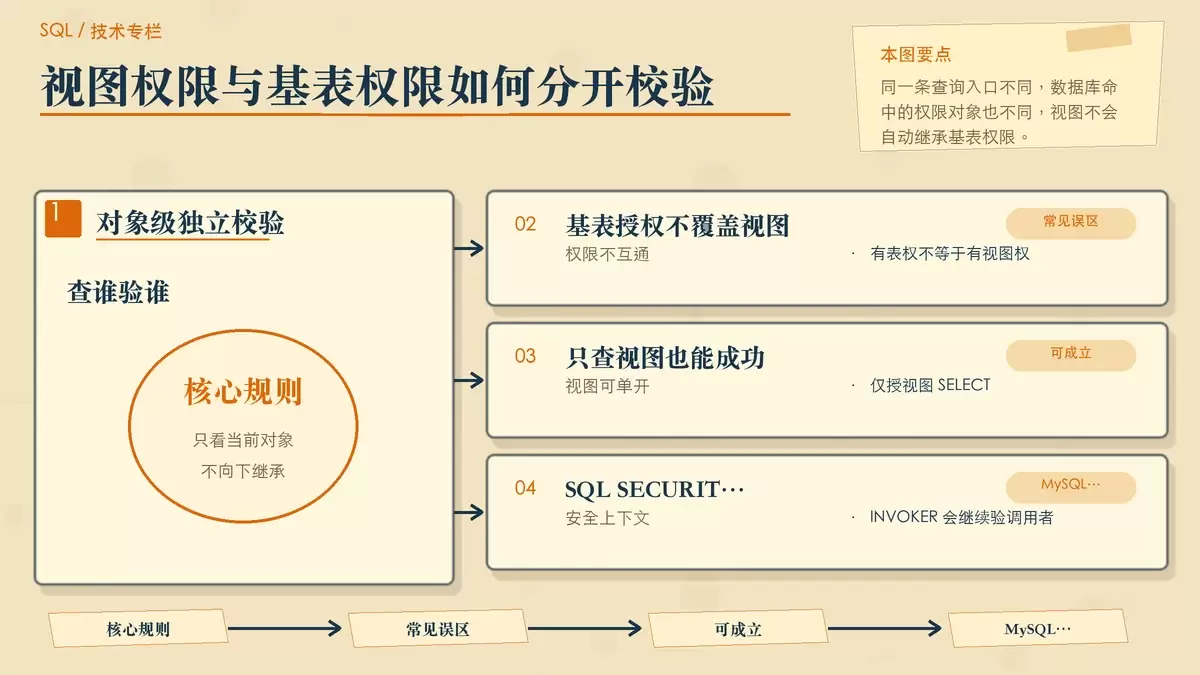
用户能查 SQL 视图却查不了原表,并不是权限漏配,而是数据库把“视图”和“基表”当成两类独立对象分别校验。本文结合 MySQL、SQL Server 与 PostgreSQL 的典型报错,说明权限为何不会自动继承,以及在 MySQL 中如何真正实现“只开放视图、不开放原表”。
Redis 的高性能并不只是“单线程快”,关键在于它用 I/O 多路复用把大量连接集中交给一个事件循环处理。本文按工作机制、系统调用差异、Redis 的 Reactor 实现和示例代码四部分拆开讲,帮助你判断 Redis 为什么能高并发,以及性能边界在哪里。
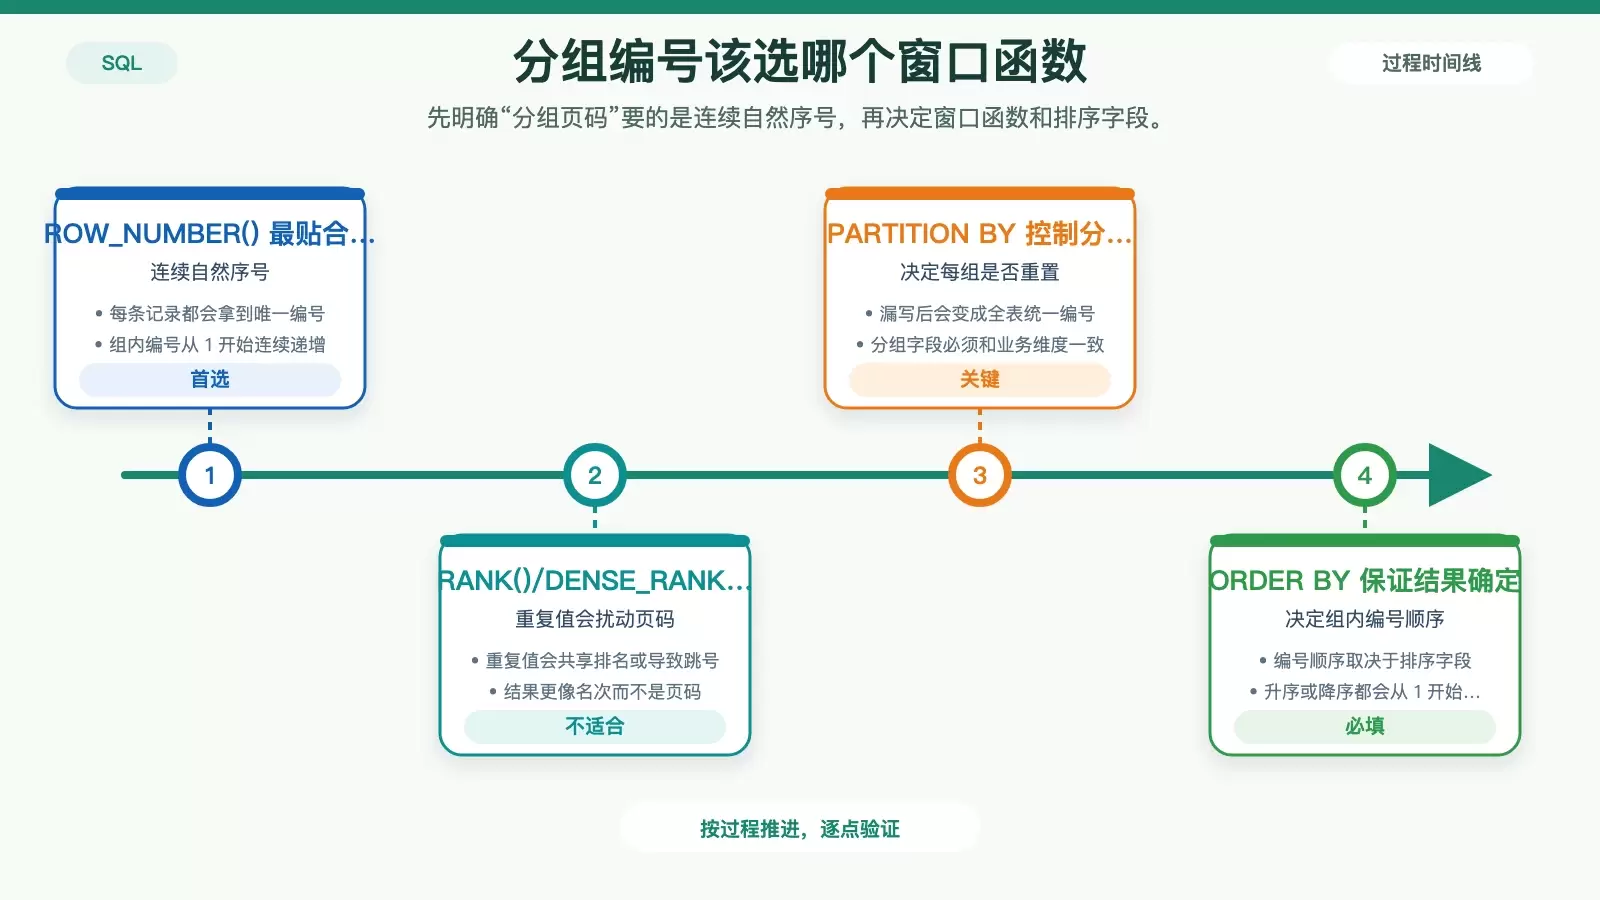
用 SQL 生成“按组分页”的页码,关键不是选哪个排名函数,而是先用 `ROW_NUMBER()` 在组内生成连续行号,再把行号换算成页码。本文整理了常见误区、跨数据库差异,以及什么时候该用窗口函数、什么时候该直接用 `OFFSET`/`LIMIT`。
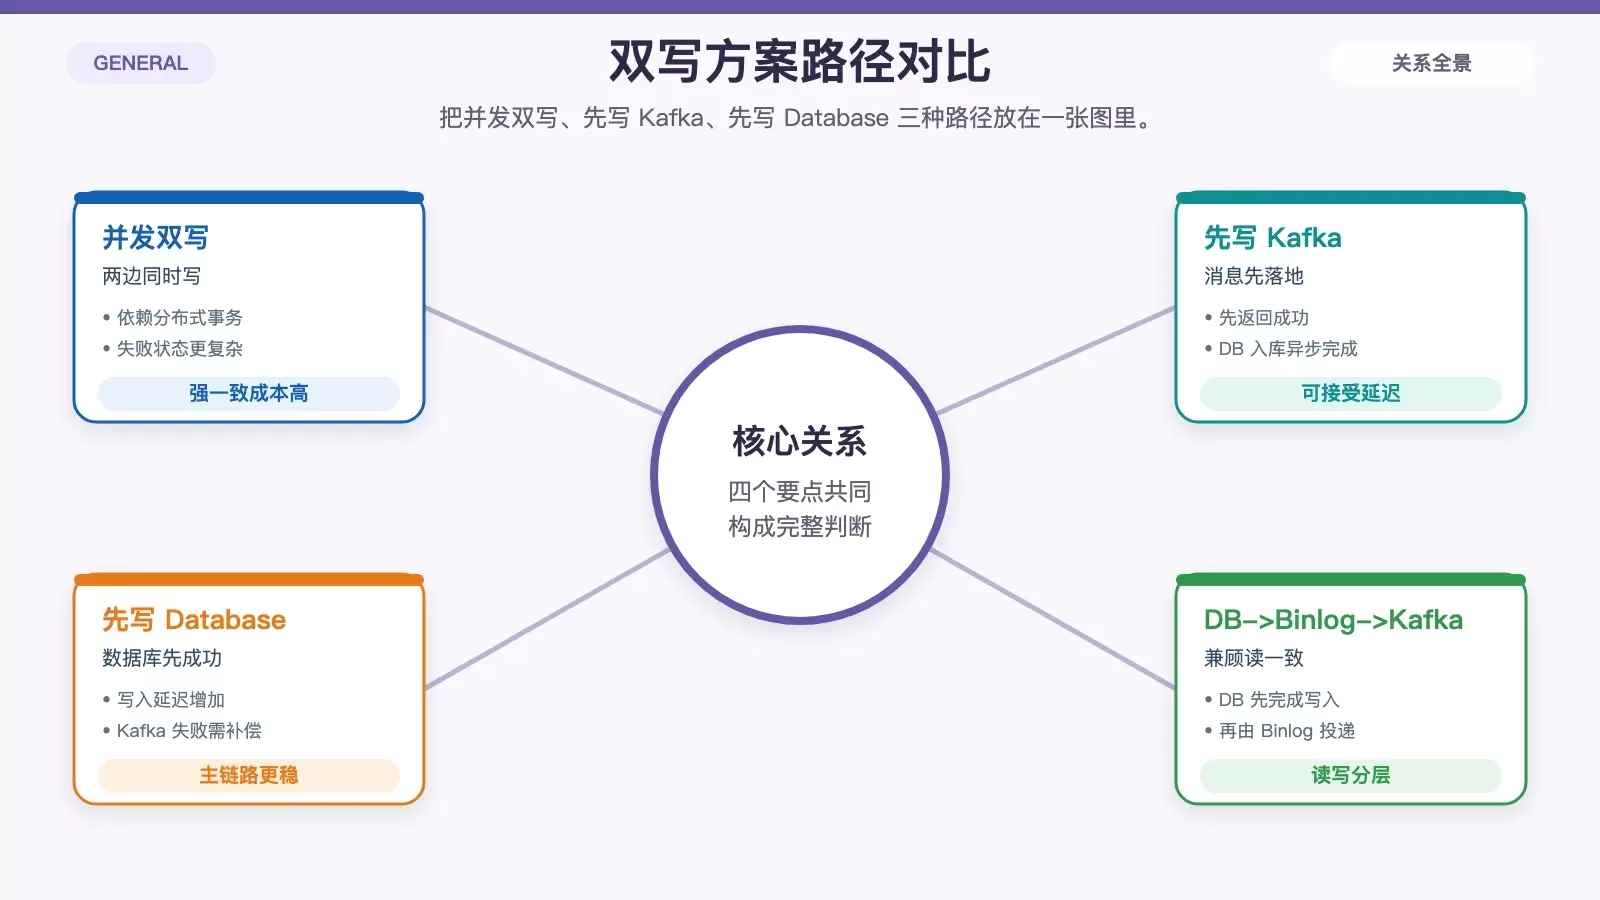
双写问题的核心难点不在“写两次”,而在两个独立系统之间如何拿到可接受的一致性。本文把并发双写、先写消息、先写数据库三种方案拆开说明,再结合 Lindorm 数据订阅,解释为什么在既要数据库强一致读、又要下游异步分发时,DB->Binlog->Kafka 是更实用的选择。
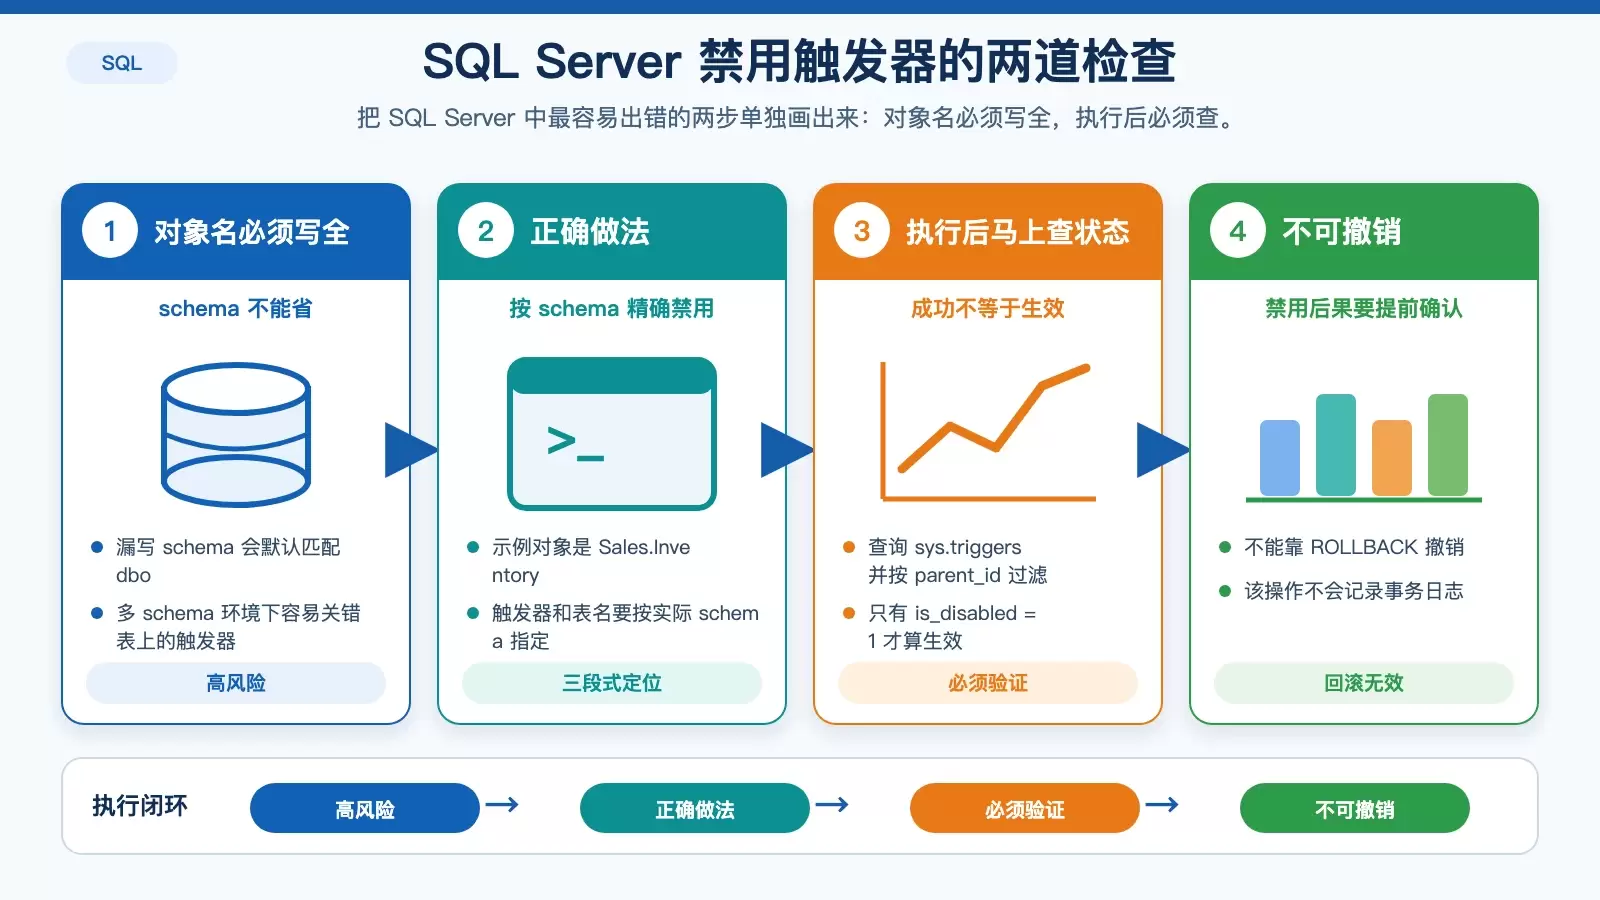
临时关闭触发器做数据修复,风险往往不在语法本身,而在误关对象、会话范围和修复后的验证。本文按 SQL Server、MySQL、PostgreSQL 三类场景梳理可执行写法、限制条件与恢复检查点,帮助你判断哪些做法能在生产环境真正落地。
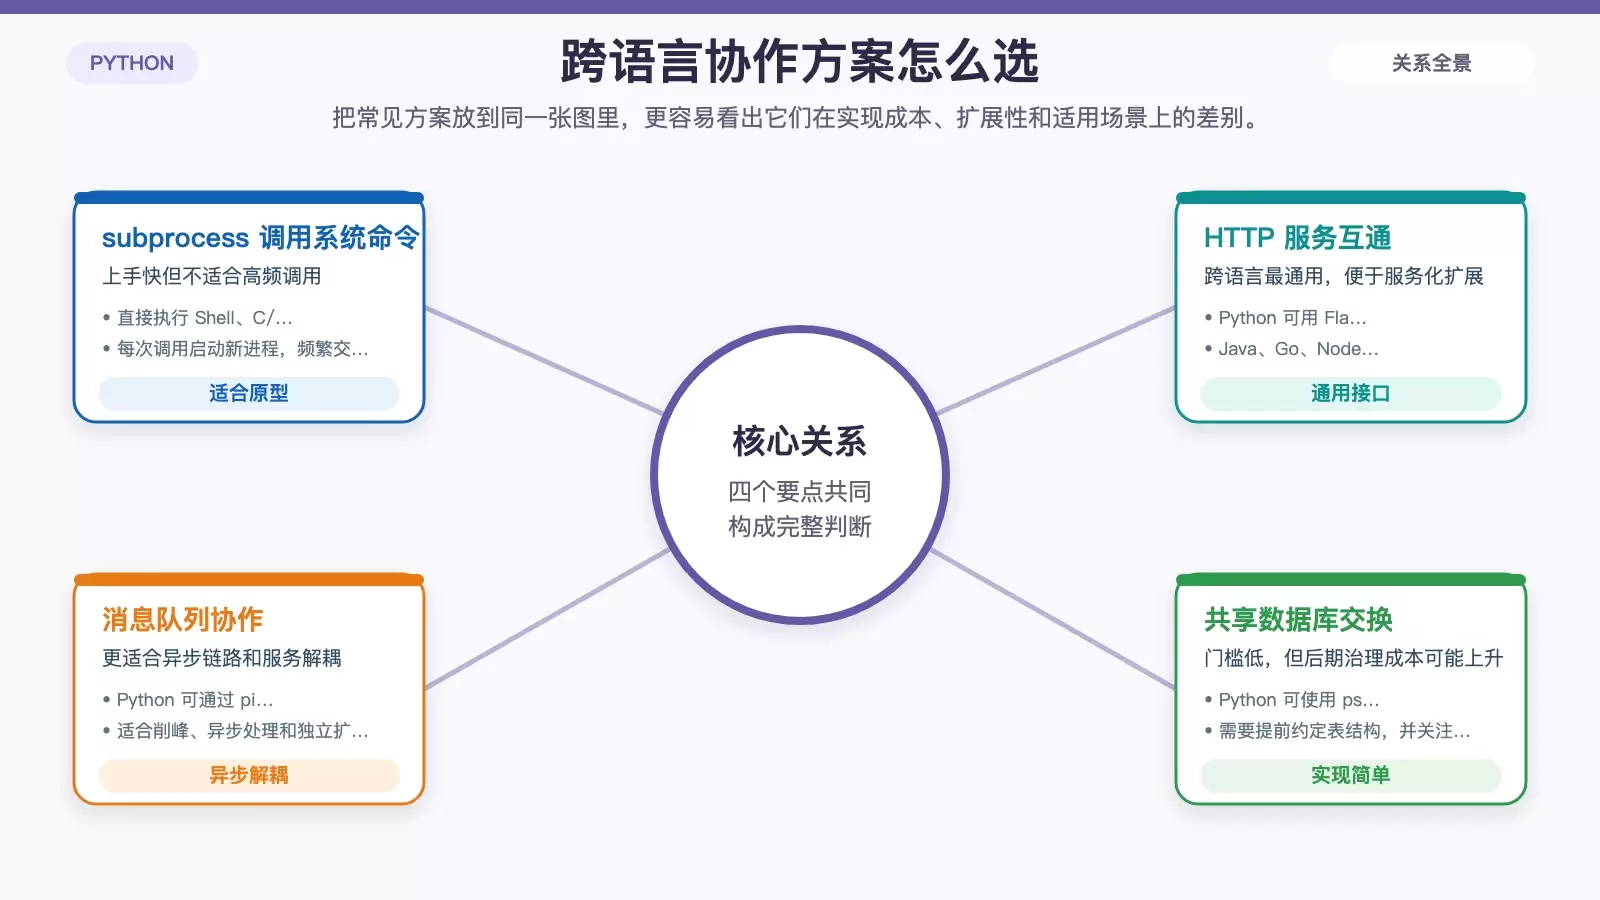
在 Ubuntu 环境里,Python 与其他语言协作并不只有一种做法。本文按调用方式、性能取舍和系统复杂度,梳理 subprocess、REST API、消息队列、共享数据库、Socket 以及 JNI 等常见方案,帮助你快速判断哪种更适合当前项目。
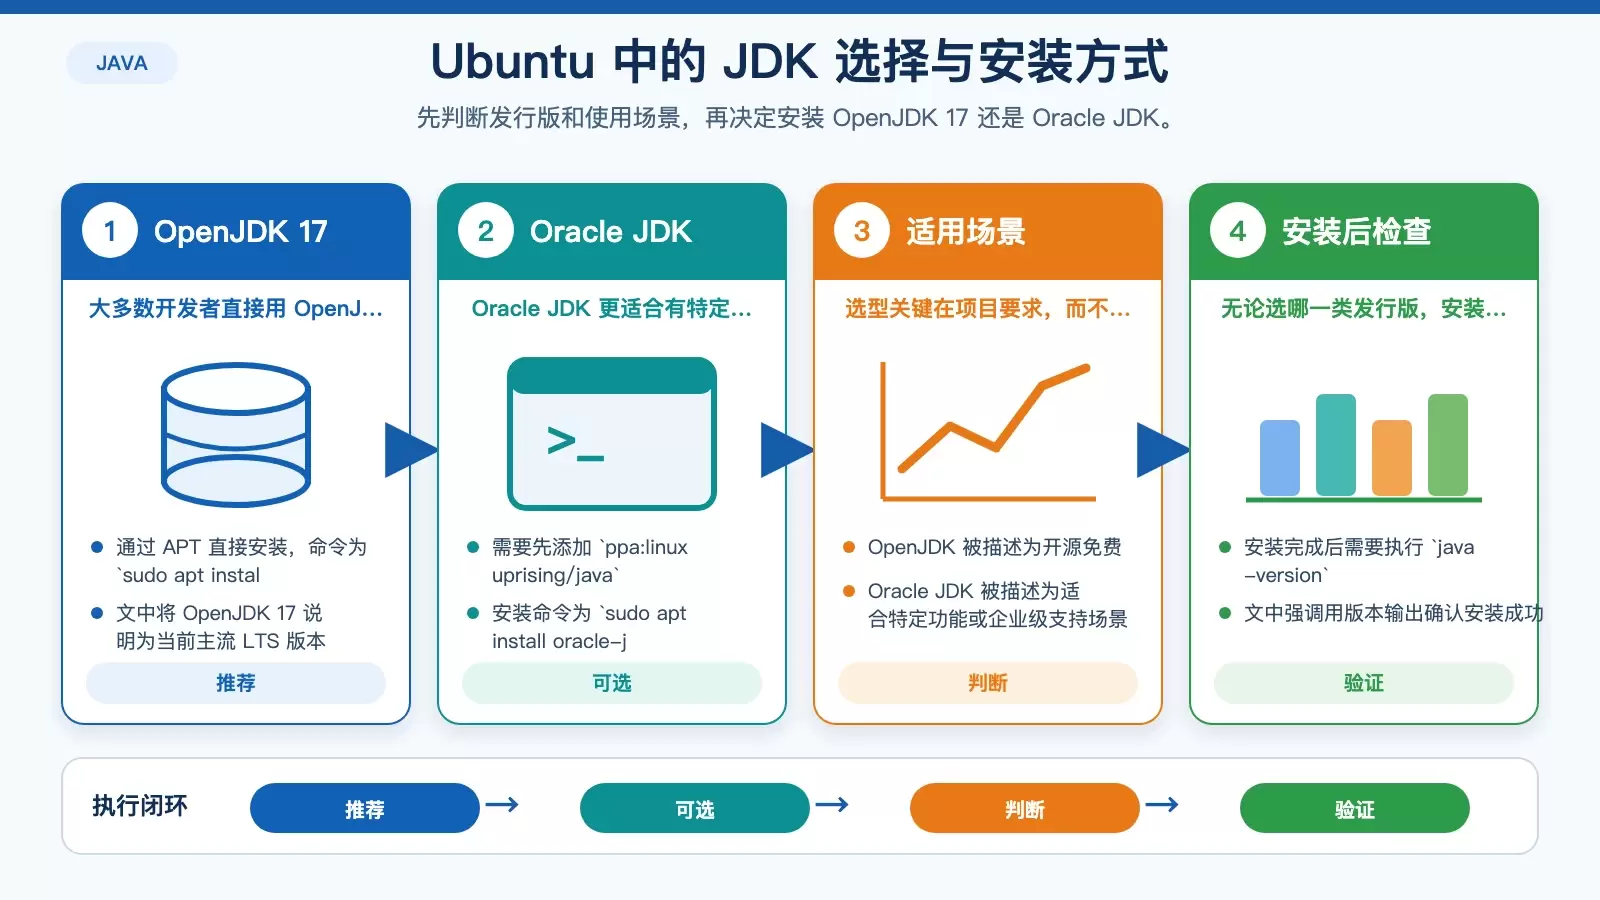
这篇文章把 Ubuntu 上配置 Java 环境的流程重新梳理为可直接执行的步骤:先更新软件源,再根据场景选择 OpenJDK 17 或 Oracle JDK,随后正确设置 JAVA_HOME 并验证 `java`、`javac` 是否可用。文中也补充了多版本切换、Maven/Gradle、IDE 与 HelloWorld 测试,方便一次把开发环境搭完整。
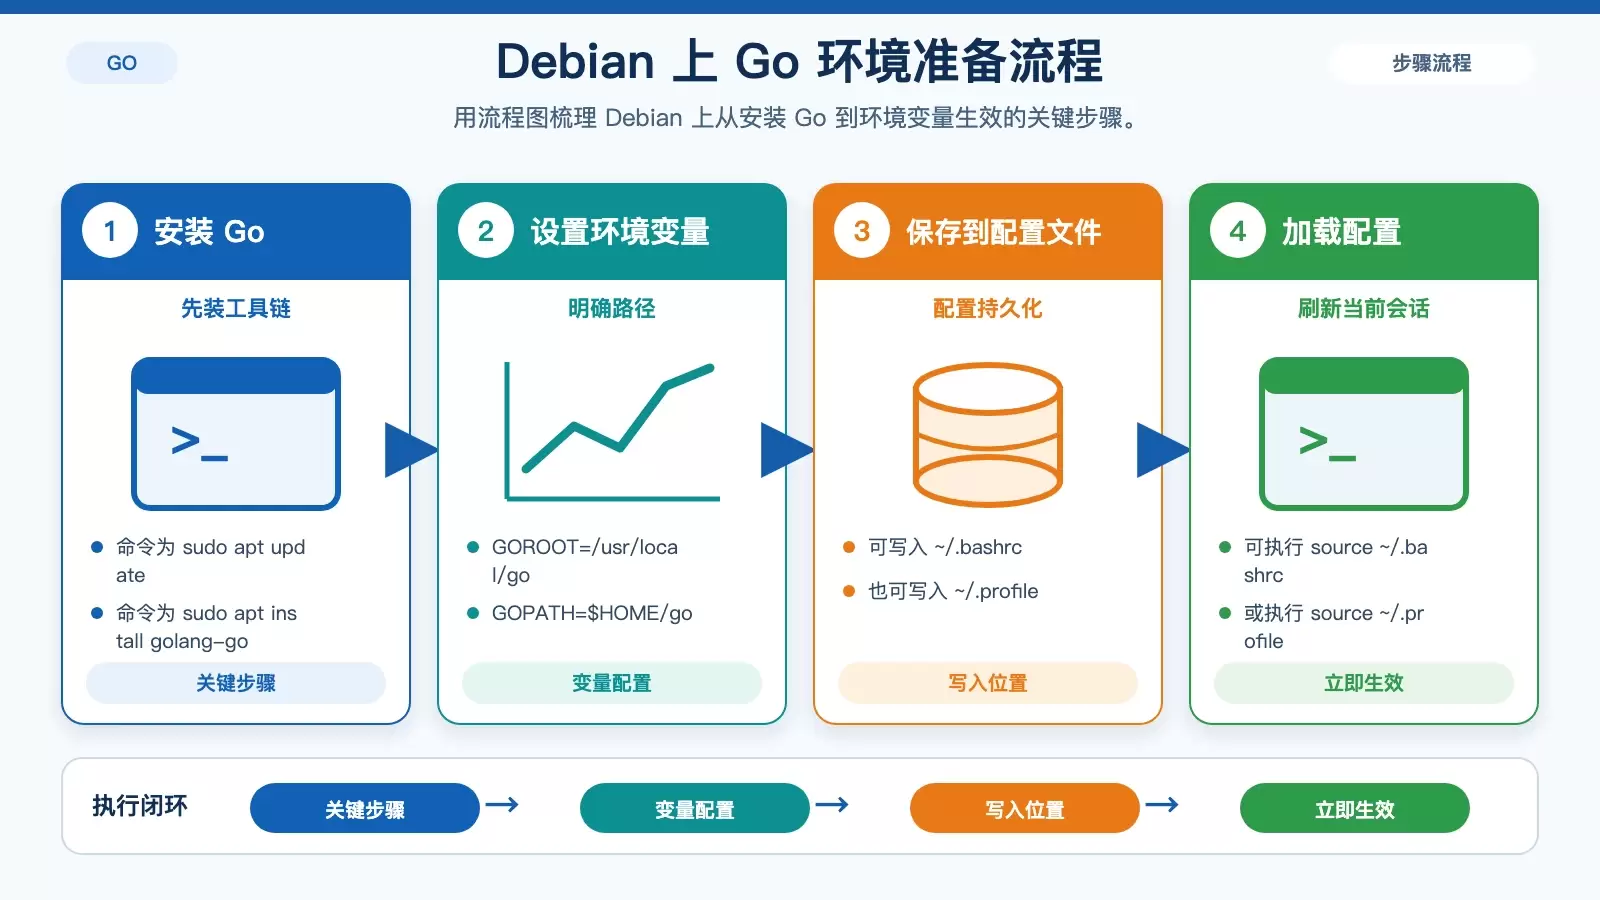
本文用 Debian 环境为例,梳理 Go 连接数据库的基本流程:安装 Go、配置环境变量、按数据库类型安装驱动、编写 `database/sql` 示例并运行验证。文中保留了 MySQL、PostgreSQL、SQLite 的驱动命令和一段可直接参考的查询代码,适合快速搭建本地实验环境。
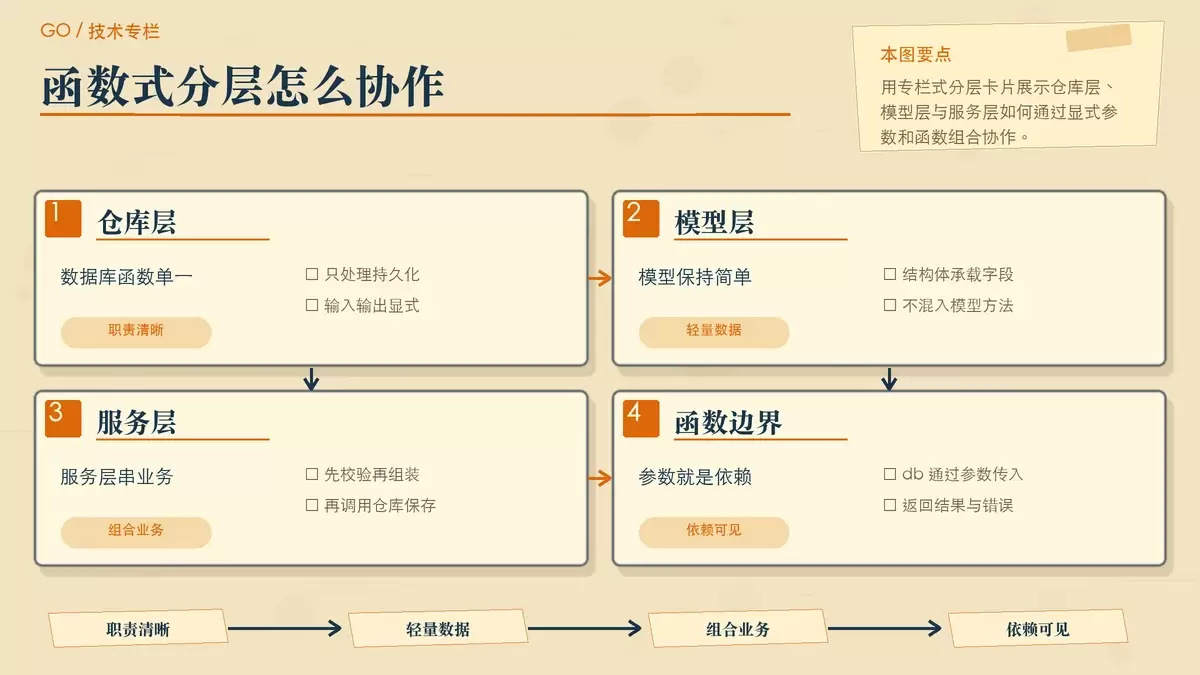
这篇文章以 Gin 与 GORM 组合为例,拆解 Go Web 项目里“函数式写法”到底适合落到哪些层:仓库层、服务层、控制层和中间件都能受益,但数据库连接、配置管理与测试替身问题也会暴露出边界。读完可以快速判断,函数式思想在 Go Web 架构中该用到什么程度。
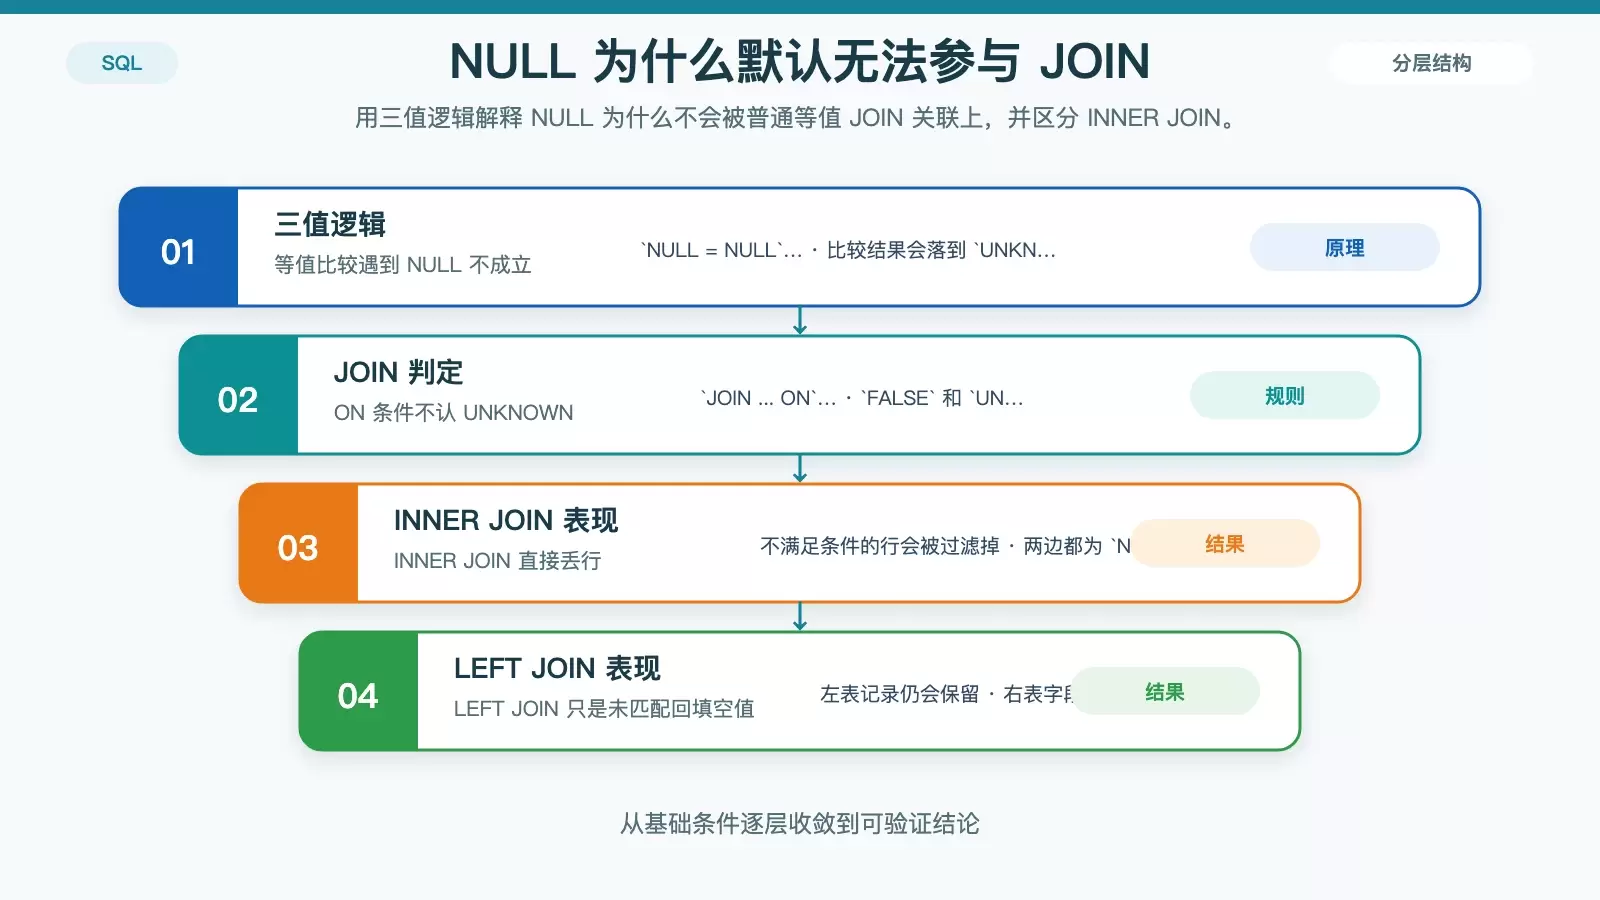
SQL JOIN 默认不会把两边都是 NULL 的记录关联起来,因为 `NULL = NULL` 的结果是 `UNKNOWN`,而 JOIN 条件只接受 `TRUE`。本文从 SQL 三值逻辑讲清原因,再给出通用写法、数据库专用语法和应避免的替代方案。 在写 SQL JOIN 时,最容易让人误判的一类问题,就是两边字段明明都为 NULL ,结果却没有关联成功。