Spring Boot 整合 Redis Stack:用 Redisson 实现 JSON 存储与搜索
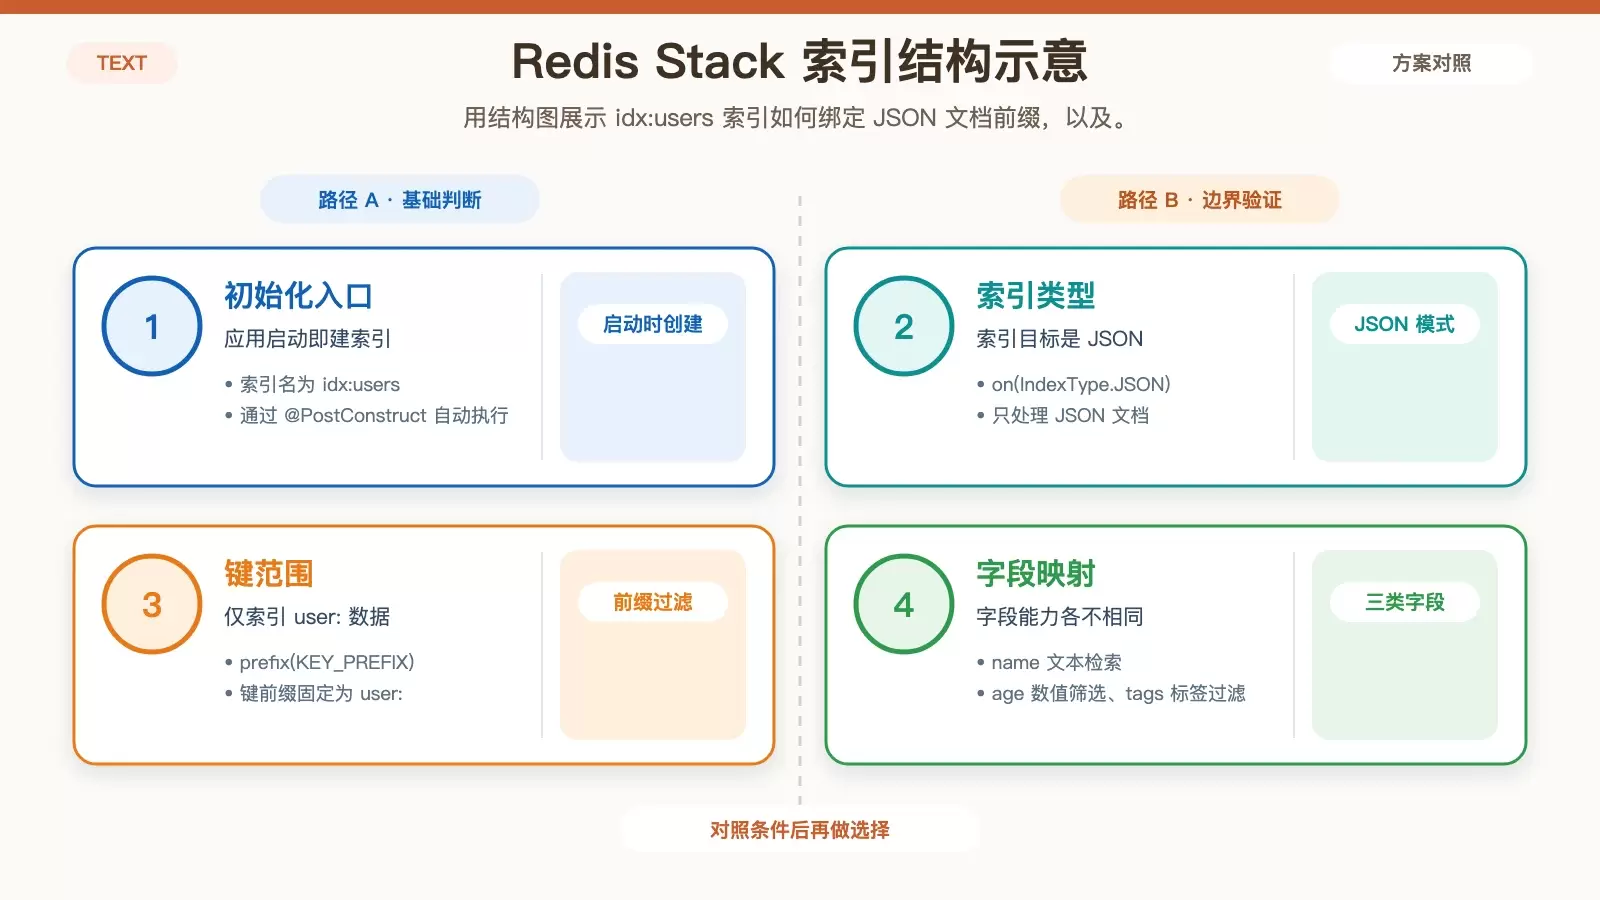
这篇示例把 Spring Boot 接入 Redis Stack 的流程拆成依赖、配置、索引初始化、JSON 读写和搜索验证五个环节。重点不在“能不能跑通”,而在 Redisson 如何把 RedisJSON 与搜索 API 串起来,以及查询语法、索引字段和接口测试之间的对应关系。
2026-08-24
22

这篇示例把 Spring Boot 接入 Redis Stack 的流程拆成依赖、配置、索引初始化、JSON 读写和搜索验证五个环节。重点不在“能不能跑通”,而在 Redisson 如何把 RedisJSON 与搜索 API 串起来,以及查询语法、索引字段和接口测试之间的对应关系。
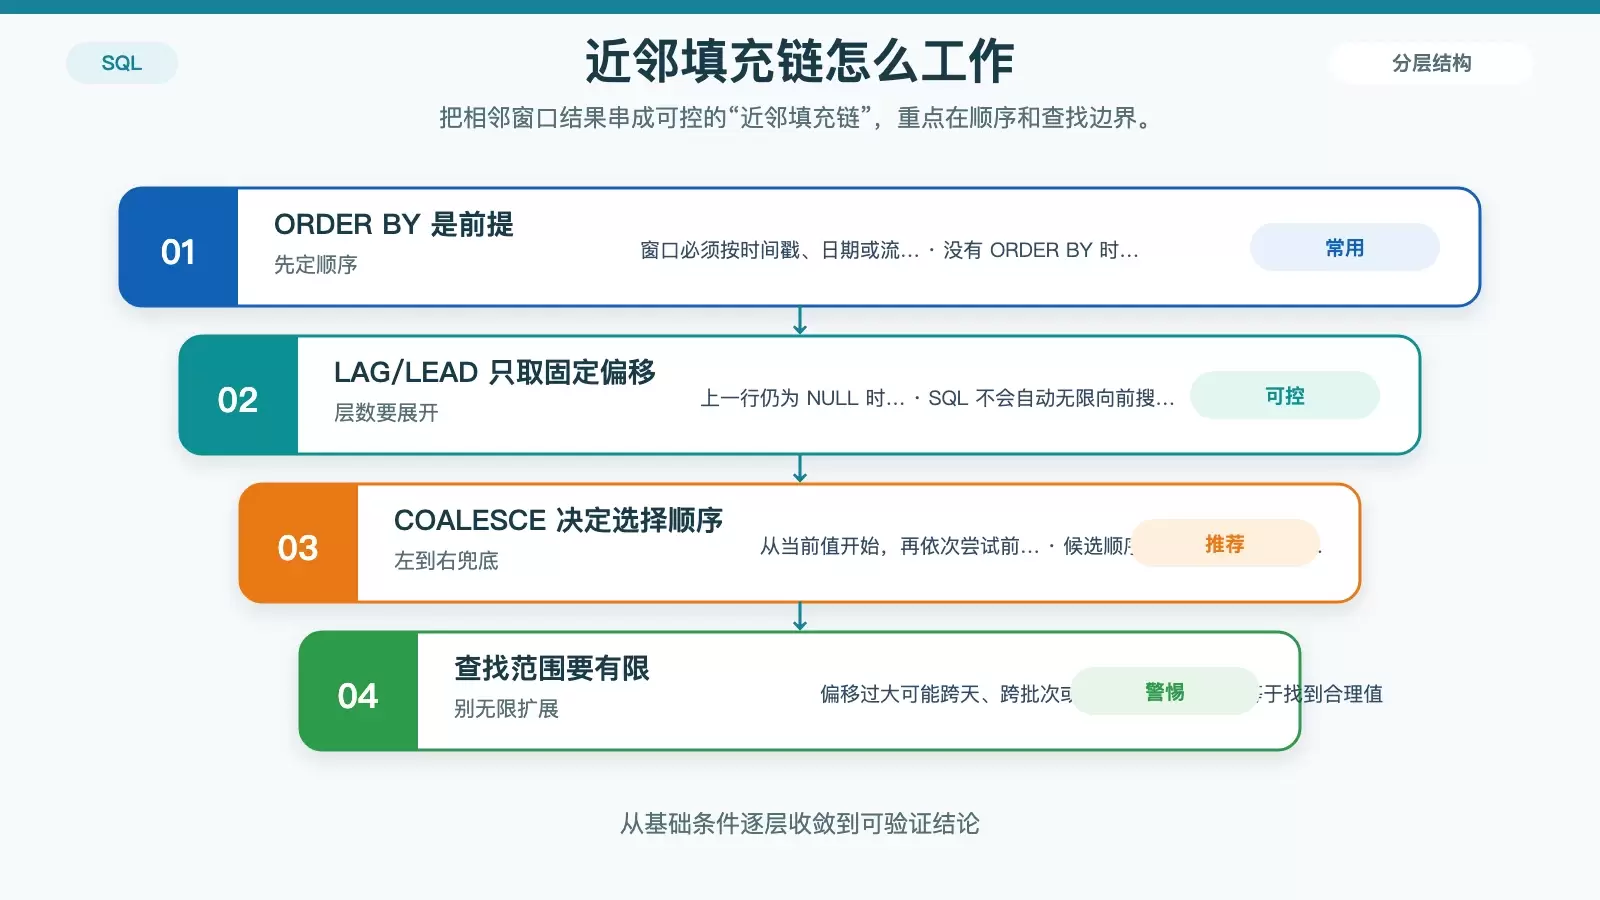
SQL 里填充缺失值,重点不是“补上就行”,而是按有序数据和业务语义选对方式。常见做法包括用 LAG()/LEAD() 取相邻有效值、用 COALESCE() 组合近邻候选,以及在支持 IGNORE NULLS 的数据库里用 FIRST_VALUE() 做前向填充。 在 SQL 里处理缺失值,最容易犯的错不是不会写函数,而是把“补出一个值”和“补对一个值”混为一谈。
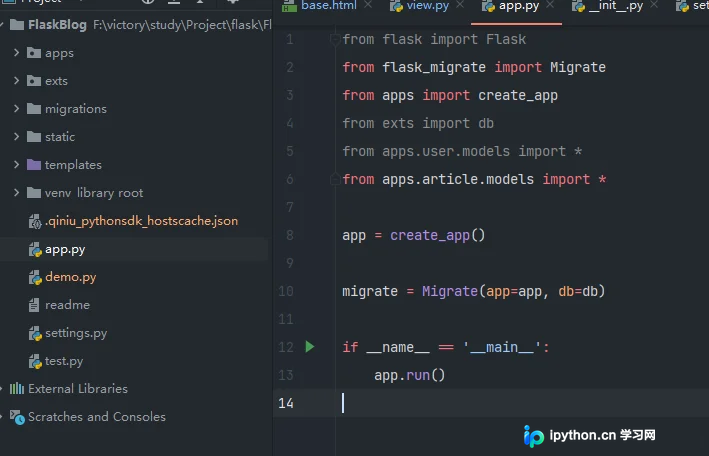
本文详细讲解 Python Flask 框架中数据模型(M)的配置方法。内容涵盖从安装 pymysql、flask-sqlalchemy 到 flask-migrate 库,通过 ORM 映射建立数据库连接。文章演示了如何定义模型类、配置数据库 URI,并利用 Flask-Migrate 命令初始化、迁移及升级数据库表结构,最后结合注册功能示例展示 MTV 模式的完整整合流程。
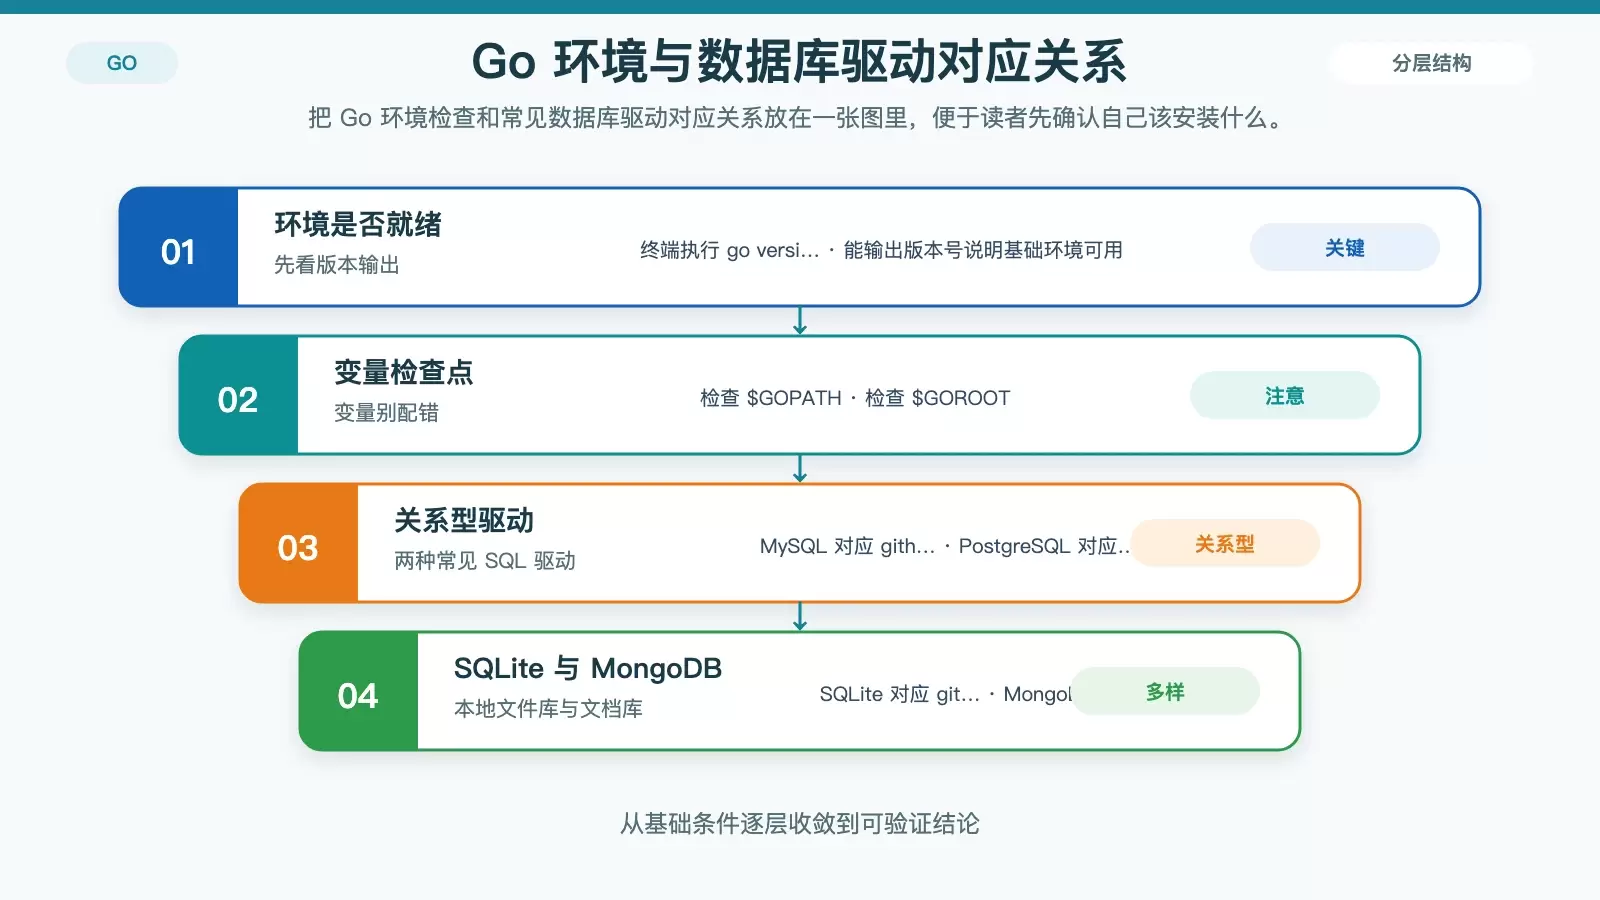
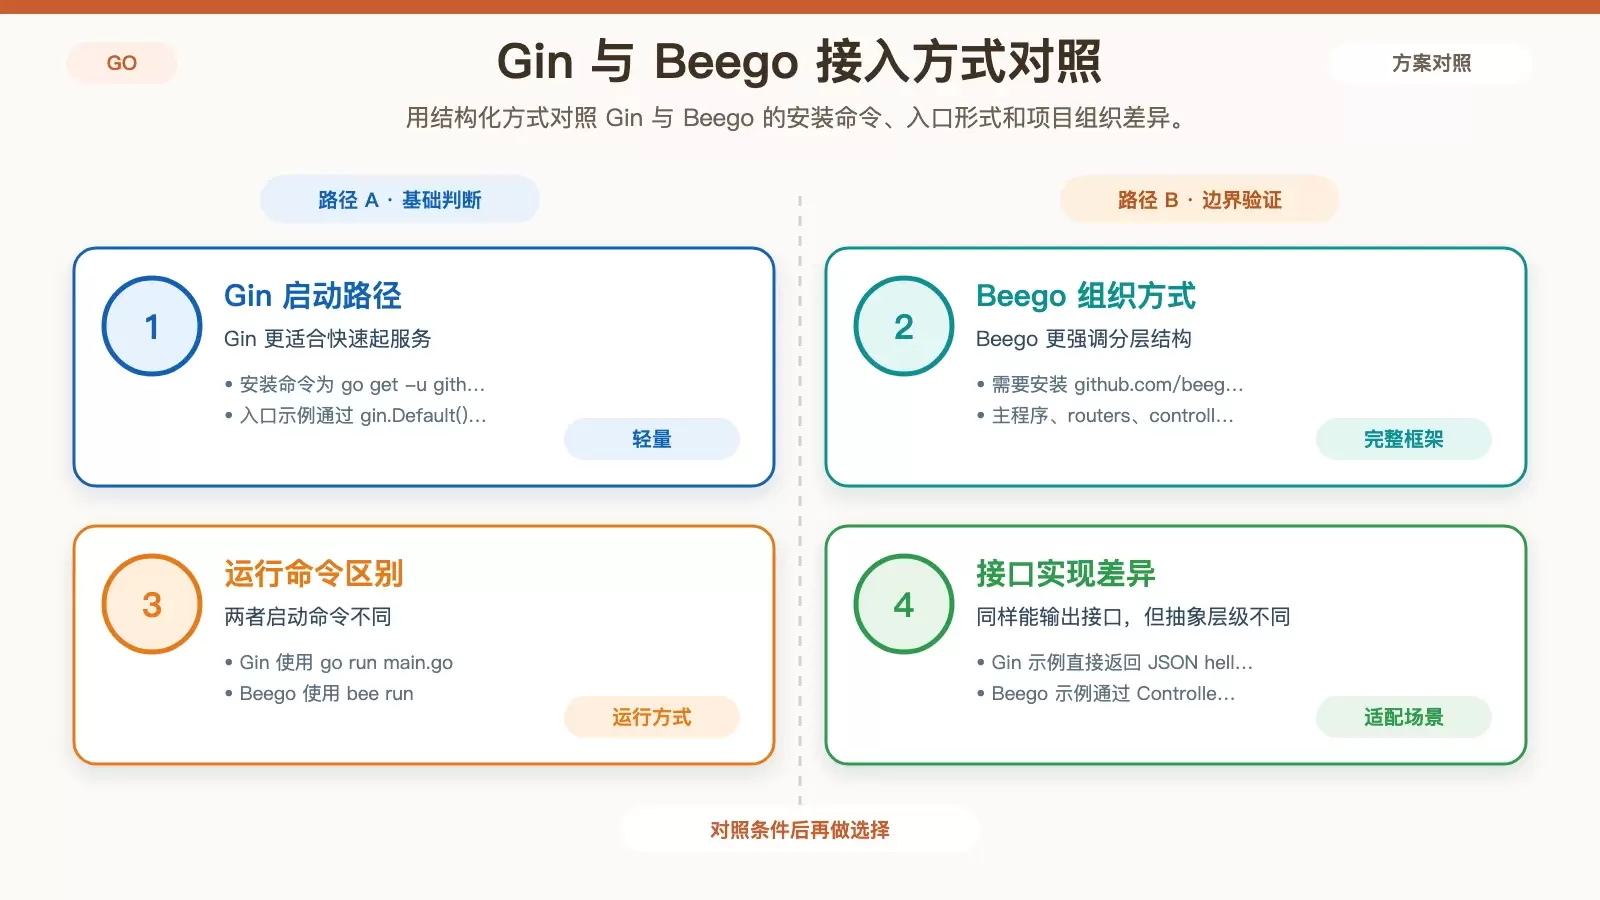
这篇文章从 Debian 上搭建 Go 开发环境开始,依次梳理环境变量配置、Gin 与 Beego 接入、PostgreSQL 与 MySQL 连接,以及 RabbitMQ 消息收发示例。适合想把 Go 服务端常见配套一次跑通的读者快速对照实践。 在 Debian 上搭一套可用的 Go 技术栈,难点通常不在某一条命令,而在于环境、Web 框架、数据库和消息队列要怎么顺下来接通。
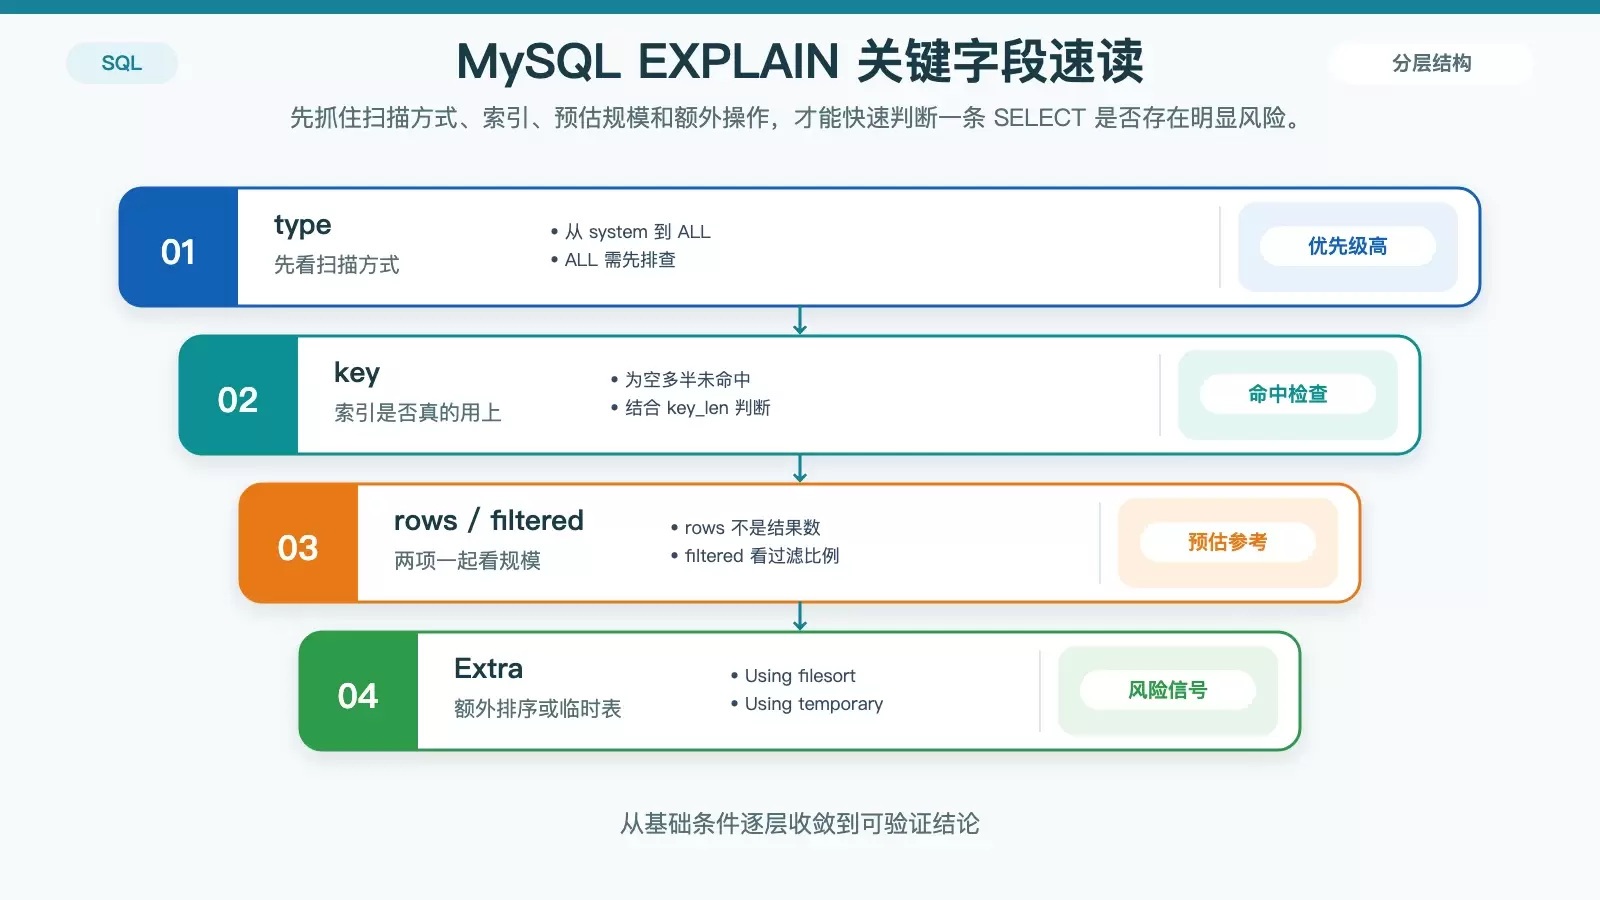
看 MySQL 的 EXPLAIN,真正有判断价值的字段并不多,核心是 type、key、rows、filtered 和 Extra。本文按“先看什么、为什么要用 JSON、哪些结论必须二次验证、跨数据库怎么避免误判”四个问题展开,帮助你把执行计划从“会看”变成“能据此定位问题”。
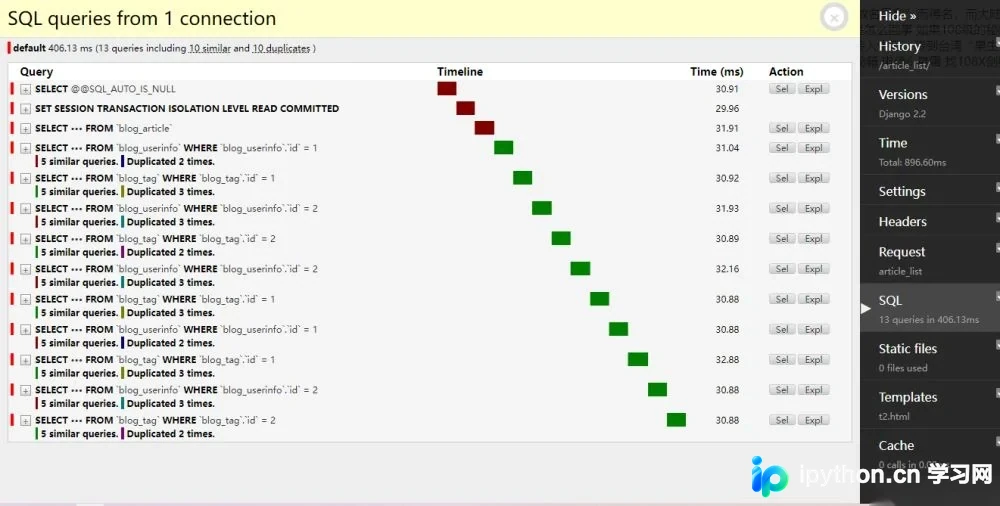
本文详解Django中select_related与prefetch_related的用法与区别。通过django-debug-toolbar展示原生查询导致的N+1问题,对比分析两者在单表关联与多表关联中的性能差异。文章提供完整代码示例,说明如何利用双下划线指定字段及Prefetch对象添加过滤条件,帮助开发者有效减少数据库查询次数,提升应用性能。
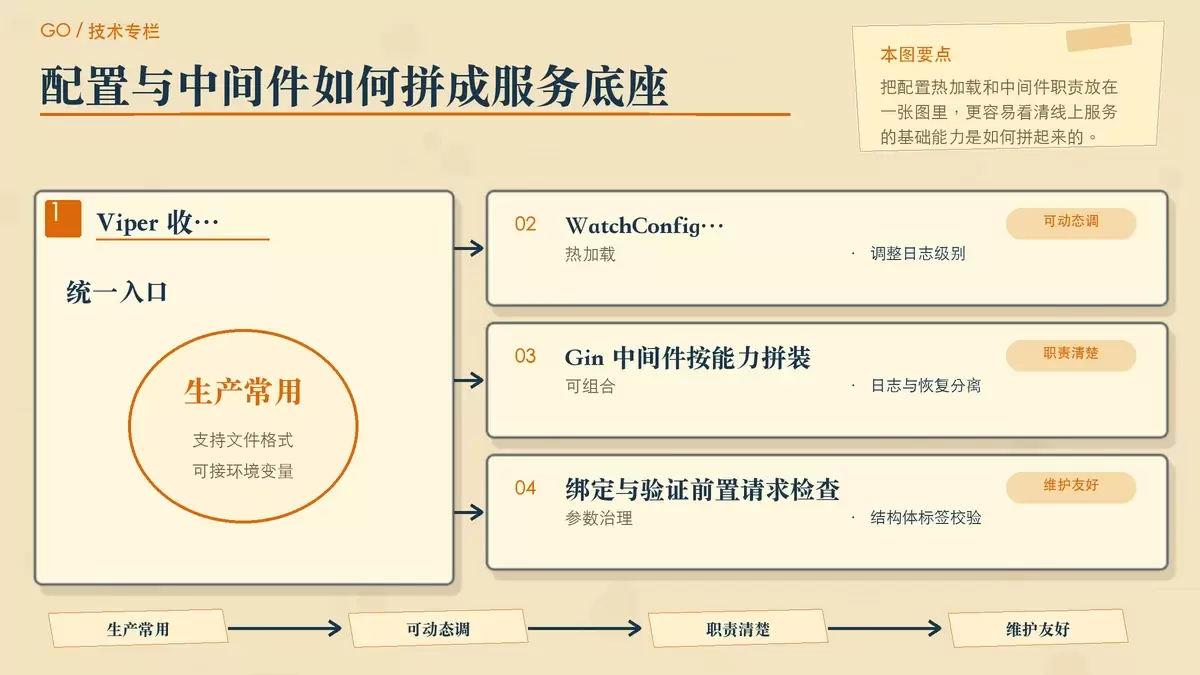
这篇文章把一套常见的 Go 后端技术栈按“项目里到底要解决什么问题”重新拆开,覆盖配置、CLI、Web、数据库、测试、日志和代码质量七个环节。每一部分都保留原文提到的工具特性、替代方案与关键代码,方便你按项目规模、部署方式和团队习惯判断该怎么组合。
从“攻击者如何进入”到“系统如何防住、如何验证防御是否有效”,用通俗且可操作的方式梳理网络安全核心知识。内容覆盖钓鱼与账号攻击、漏洞与注入、恶意软件及拒绝服务等常见威胁,并结合纵深防御、最小权限、补丁管理、输入验证、日志监控等机制,帮助读者建立完整的安全防护思路。
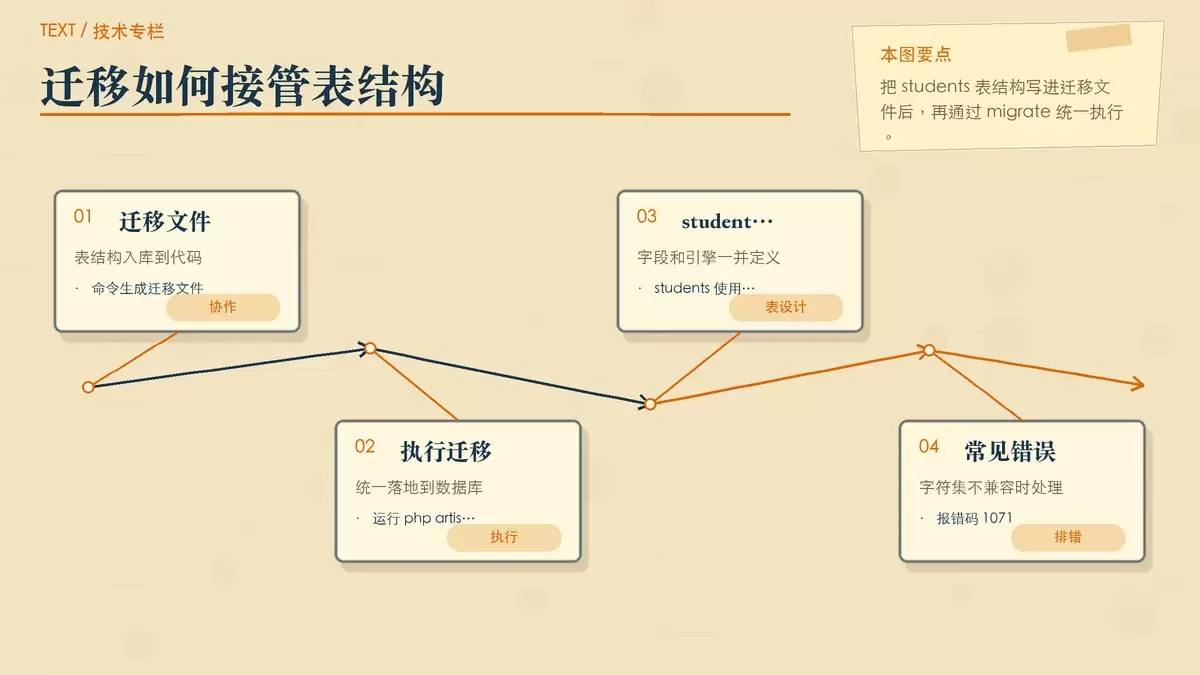
这篇文章用 Laravel 5.5 为例,梳理数据库迁移和数据填充的完整用法:从创建 students 表、执行迁移,到借助 Seeder、Factory 和 Faker 批量生成 10000 条中文测试数据。文中也保留了常见报错与处理办法,方便在团队协作和部署场景里直接落地。
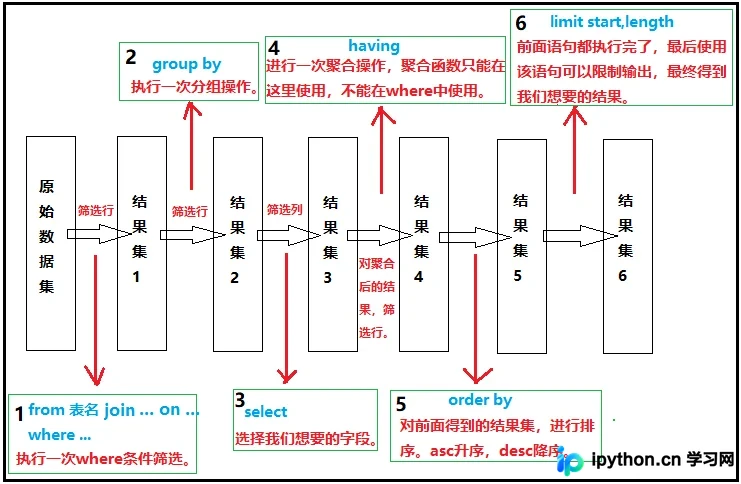
本文详细解析MySQL SQL查询语句的书写顺序与底层执行顺序。通过对比 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY 和 LIMIT 关键字,阐明两者为何不同及其背后的逻辑。同时重点探讨 HAVING 与 SELECT 的执行先后争议及优化建议,帮助开发者写出更高效的SQL代码。
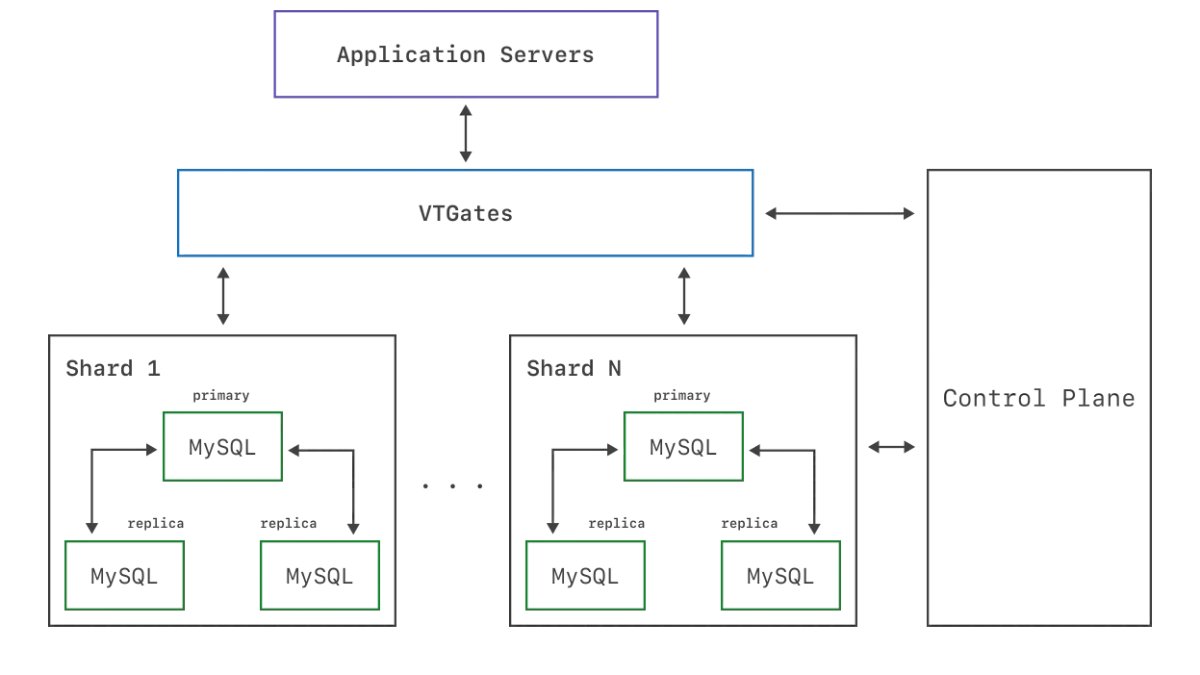
从分库分表的核心概念出发,对比 ShardingSphere 与 Vitess 的架构、分片路由、部署接入、扩容迁移与适用场景,帮助读者完成技术选型并规避常见坑。
这篇文章把“在 Debian 上用 Go 连数据库”拆成可直接落地的四步:确认 Go 环境、安装匹配驱动、套用连接代码、运行并验证结果。文中保留 MySQL、PostgreSQL、SQLite 和 MongoDB 的安装命令与示例,适合拿来快速完成第一条数据库连接。