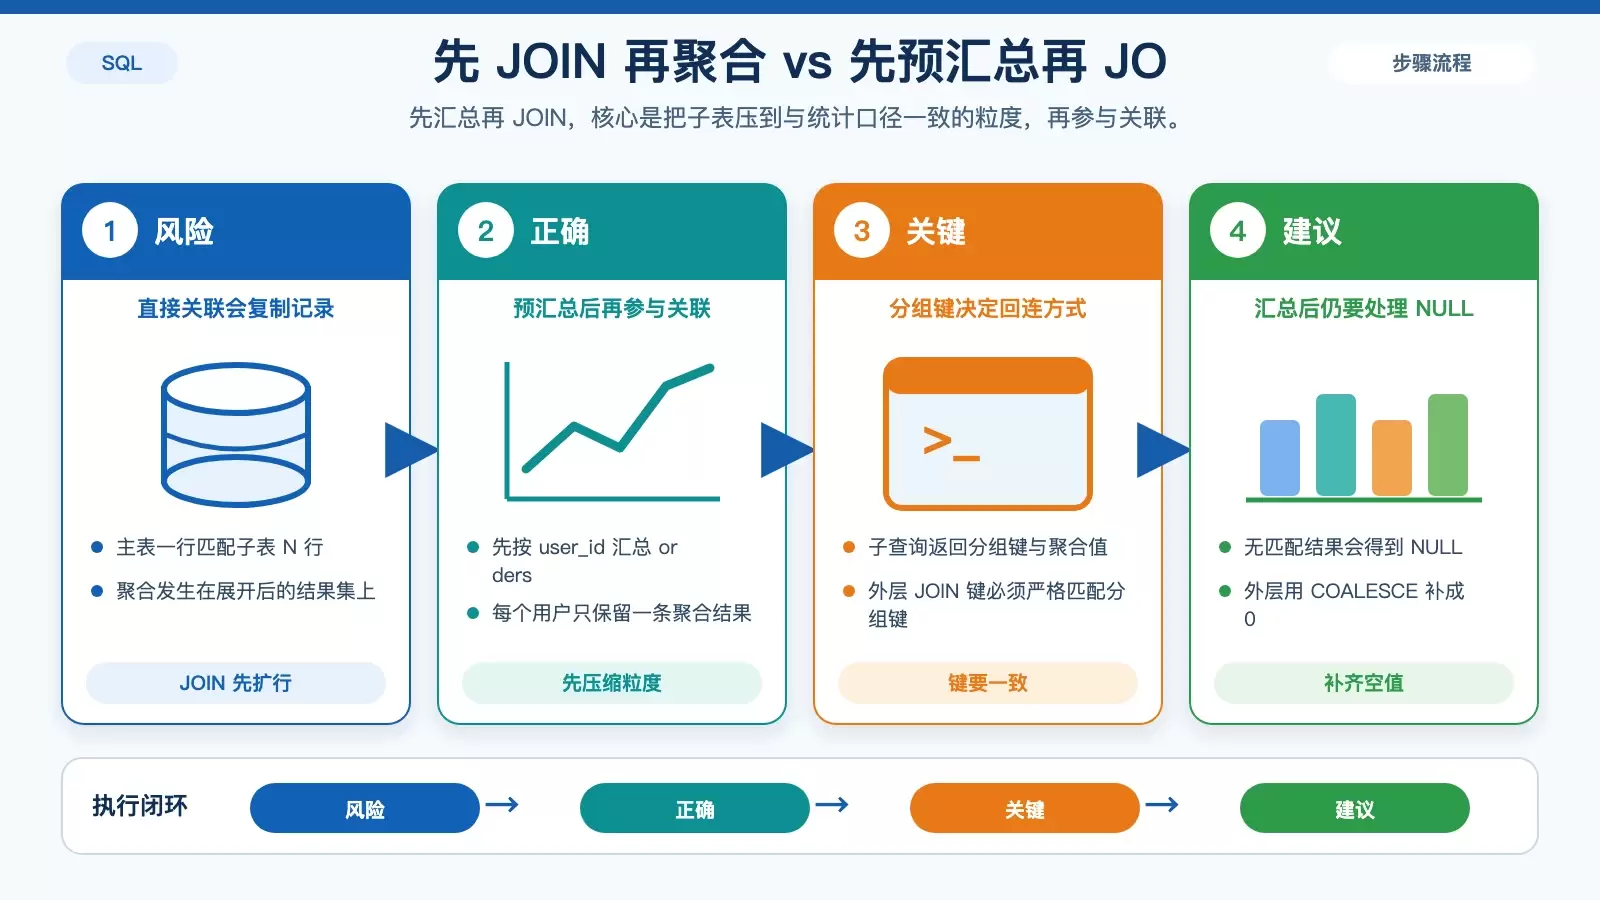
SQL 聚合前为什么要先对子表预汇总
`LEFT JOIN` 后直接做 `SUM`、`COUNT`,结果经常被放大,根源不在数据库,而在 JOIN 先扩行、聚合后执行的逻辑。本文用订单统计场景说明为什么要先对子表 `GROUP BY` 预汇总,再讲清过滤条件、`COALESCE`、`DISTINCT` 误区,以及 CTE 与子查询的选择方法。
2026-08-24
203

`LEFT JOIN` 后直接做 `SUM`、`COUNT`,结果经常被放大,根源不在数据库,而在 JOIN 先扩行、聚合后执行的逻辑。本文用订单统计场景说明为什么要先对子表 `GROUP BY` 预汇总,再讲清过滤条件、`COALESCE`、`DISTINCT` 误区,以及 CTE 与子查询的选择方法。
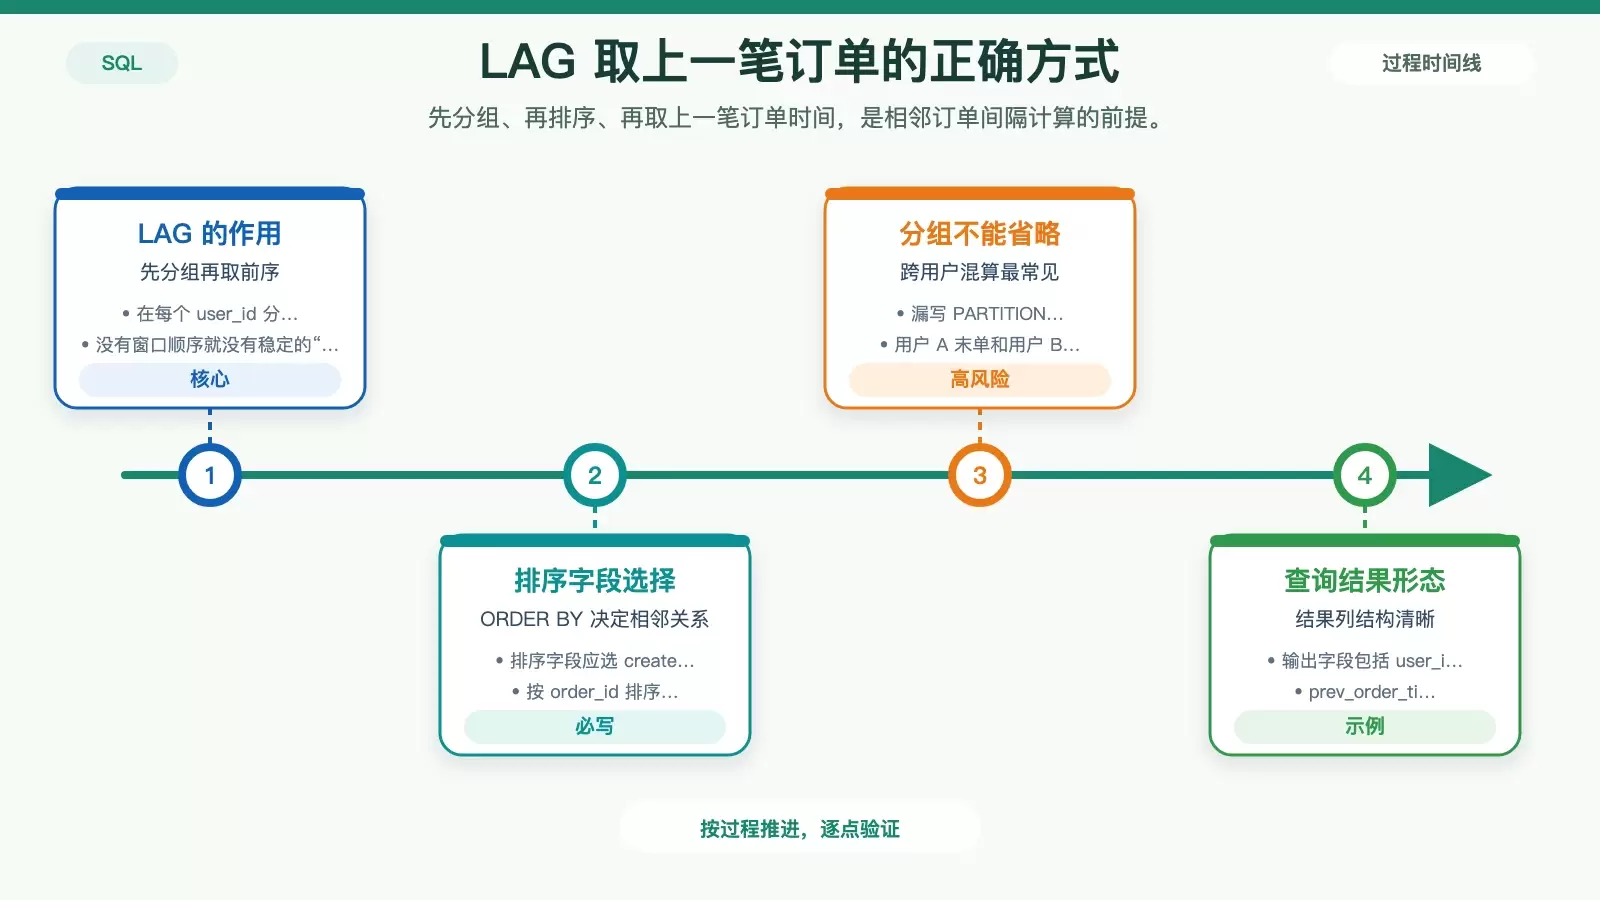
在 SQL 里计算相邻订单时间差,关键不只是 `LAG()`,还包括按正确时间字段排序、按用户分组,以及针对不同数据库选择合适的时间差函数。本文用 MySQL、PostgreSQL、SQL Server 的写法对照说明,并补上空值处理和索引检查的实际要点。
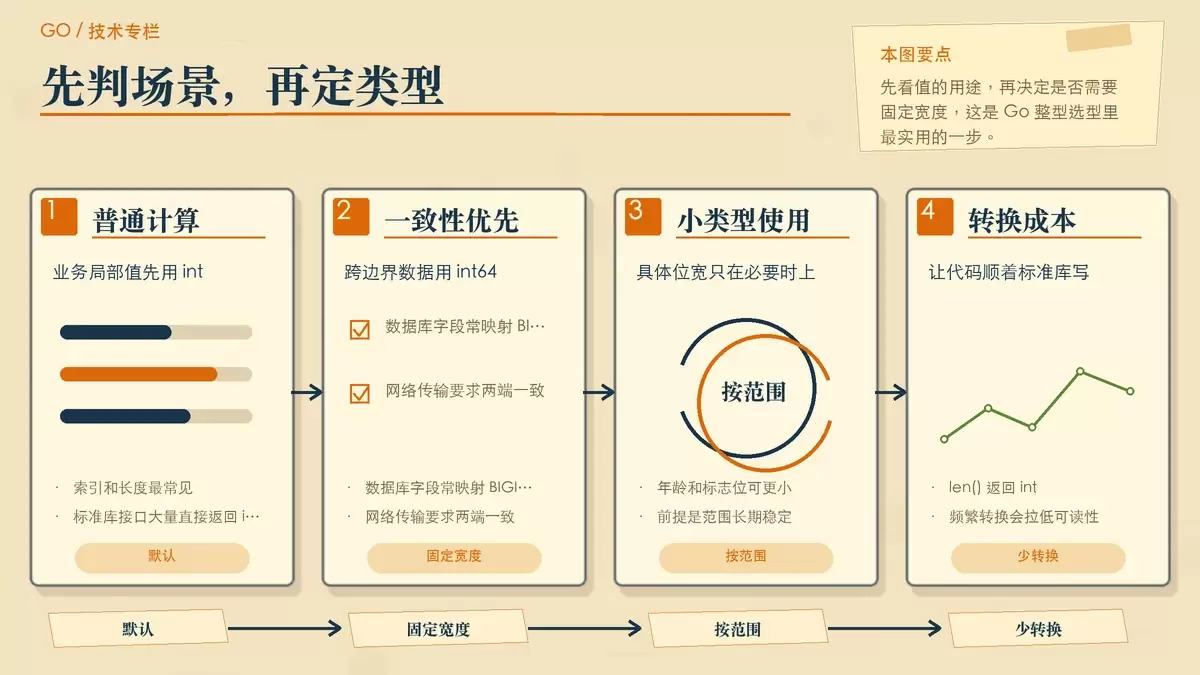
Go 里整型很多,但真正高频纠结的往往是 int 和 int64。本文把平台差异、标准库习惯、跨平台数据一致性以及常见溢出与 JSON 精度问题拆开说明,帮助你在业务代码、数据库字段和高数据量场景里做出更稳妥的选择。
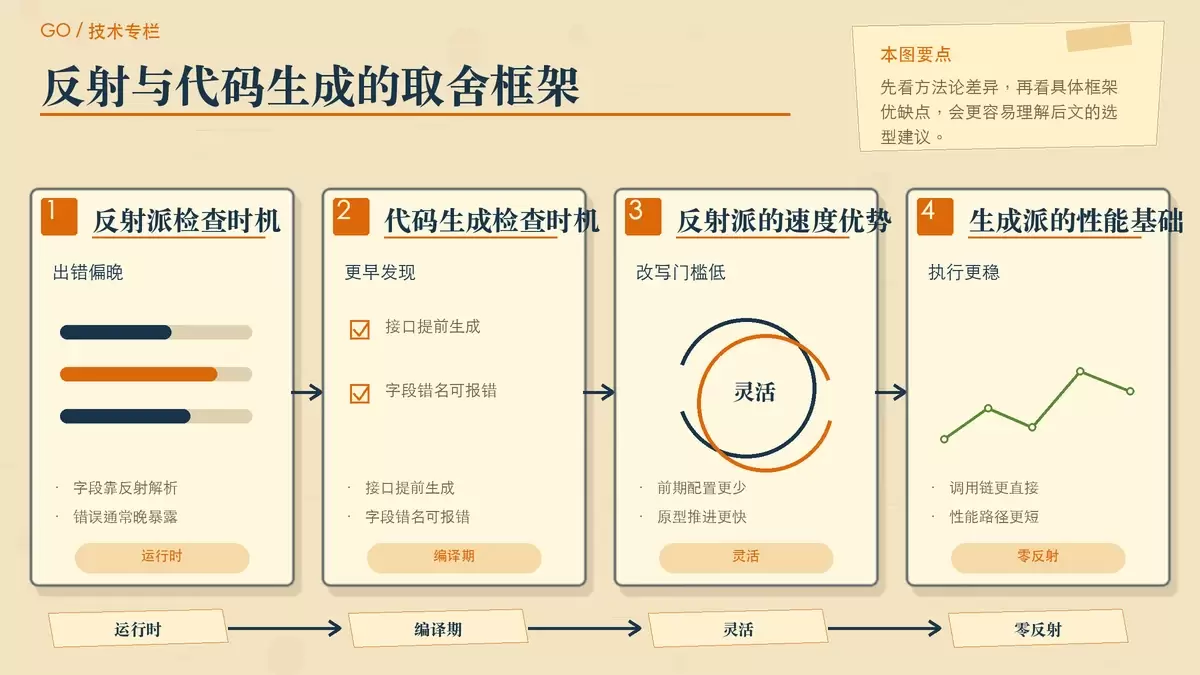
Go 数据库框架的争论,核心已经不只是 API 好不好用,而是运行时反射与编译期代码生成两条路线的取舍。把 GORM、Ent、SQLC 放到同一业务场景里比较后,可以更清楚地判断:你到底更需要上线速度、重构安全,还是对 SQL 与性能的绝对掌控。
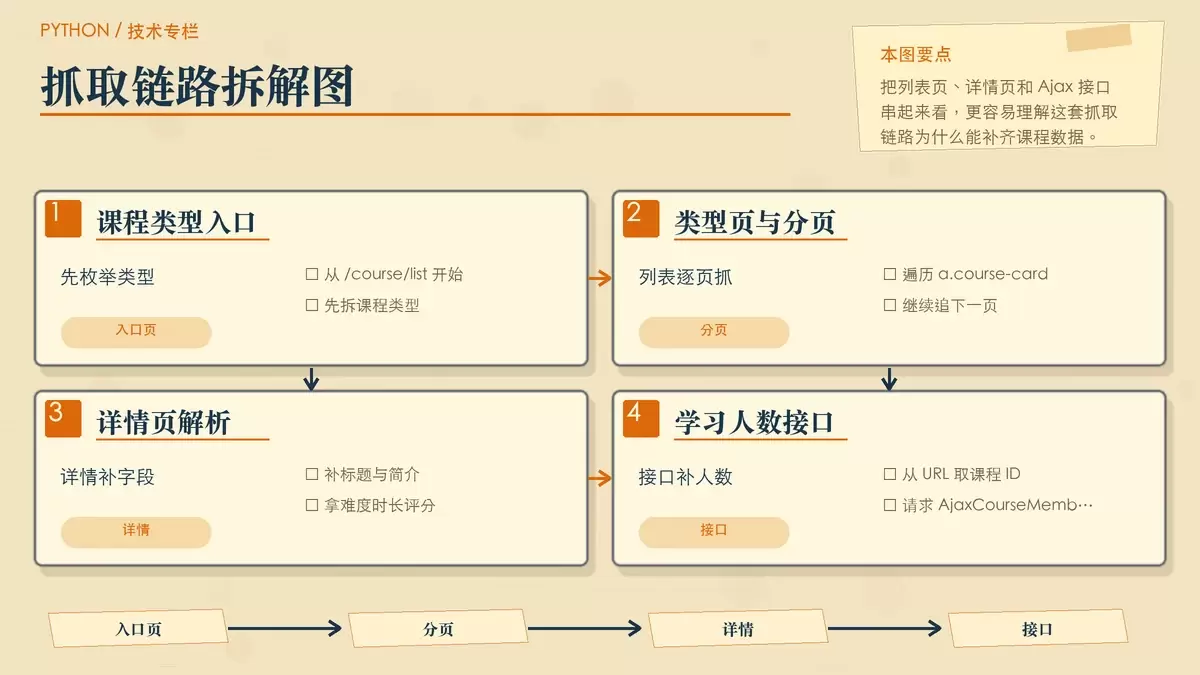
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
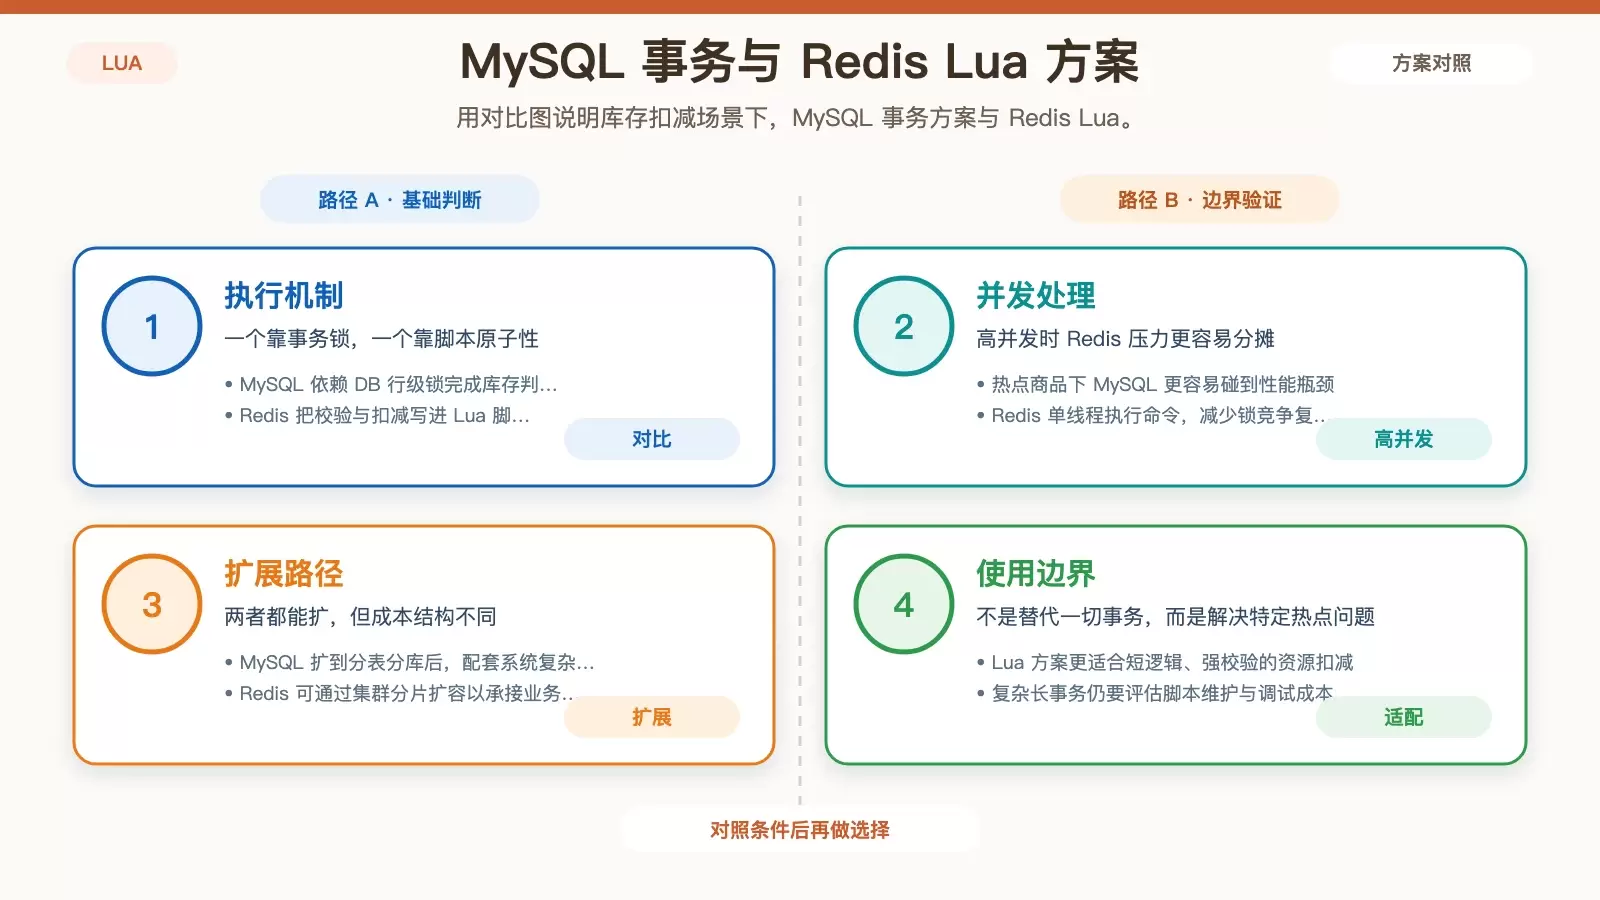
文章围绕“Redis 事务不能像 MySQL 一样回滚”这一痛点,拆解 Lua 脚本如何把库存校验、扣减、防重和结果返回收敛为一次原子执行。文中保留了初始化、脚本加载与执行代码,并说明 Redis 集群下多 Key 同分片等落地细节。
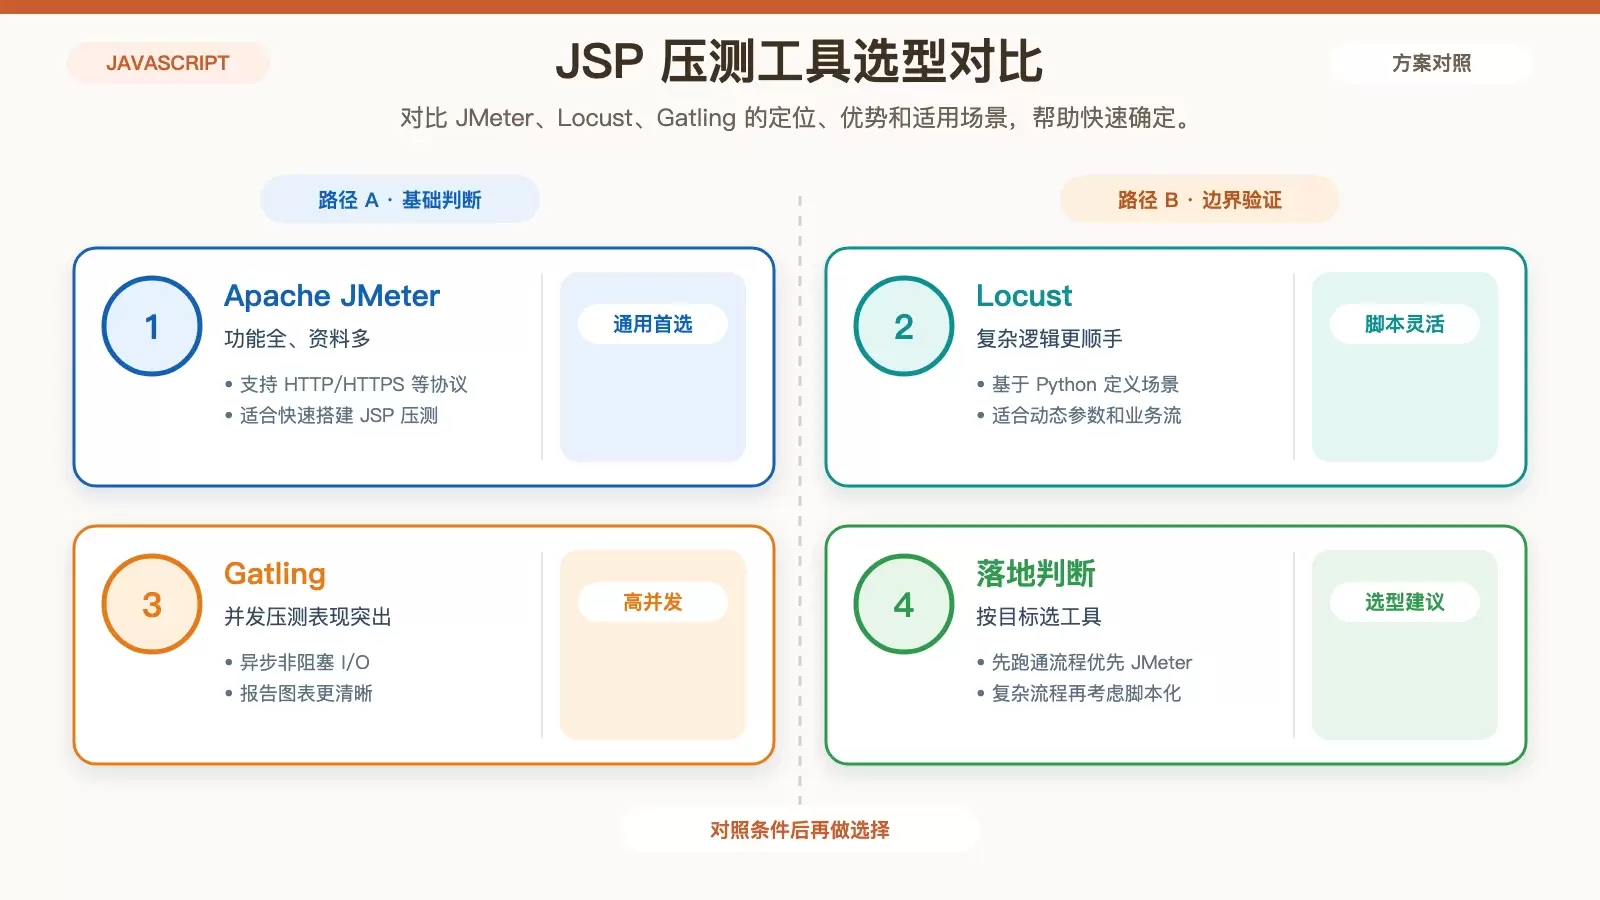
这篇文章围绕 Ubuntu 环境下的 JSP 应用性能测试展开,先梳理 JMeter、Locust、Gatling 的适用场景,再用 Apache JMeter 给出可直接落地的安装、建压与结果分析流程,最后补上 JSP、Tomcat、数据库和基础设施层的优化方向,方便你把测试结果转成实际改进动作。
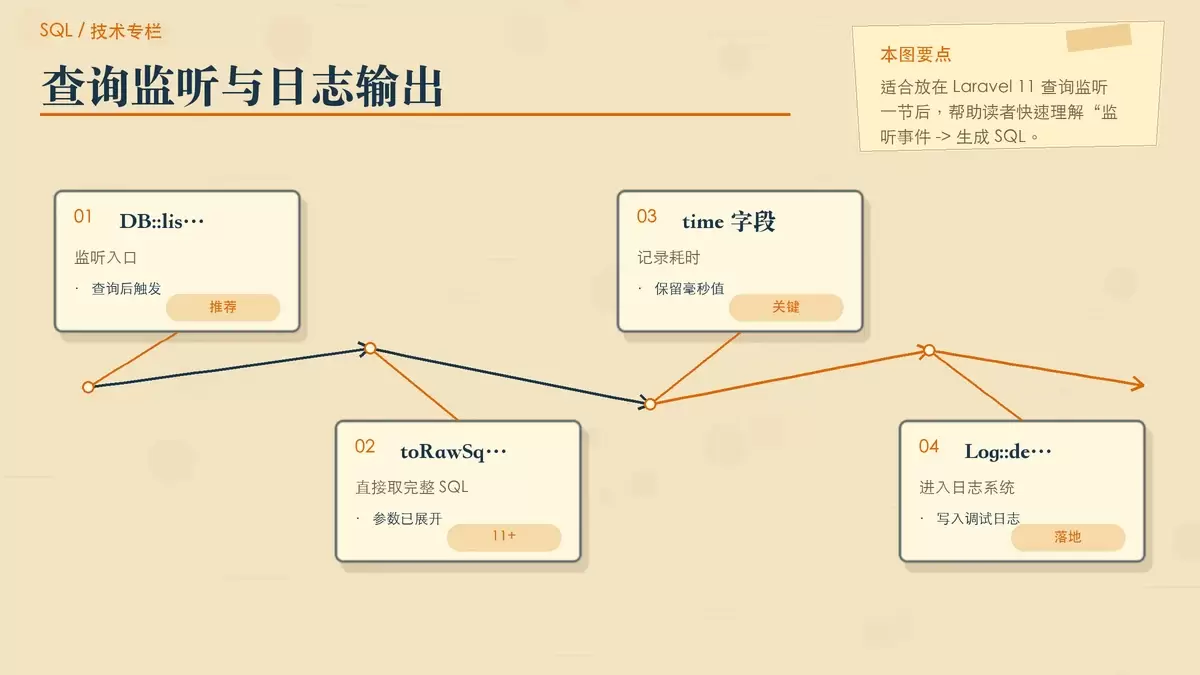
在 Laravel 排查数据库问题时,把 SQL 与耗时写入日志是最直接的办法。本文基于 Laravel 11 与 Laravel 10 的差异,整理了查询监听、完整 SQL 拼接输出,以及慢查询耗时监视的具体写法,便于你快速接入并判断该用哪种方案。
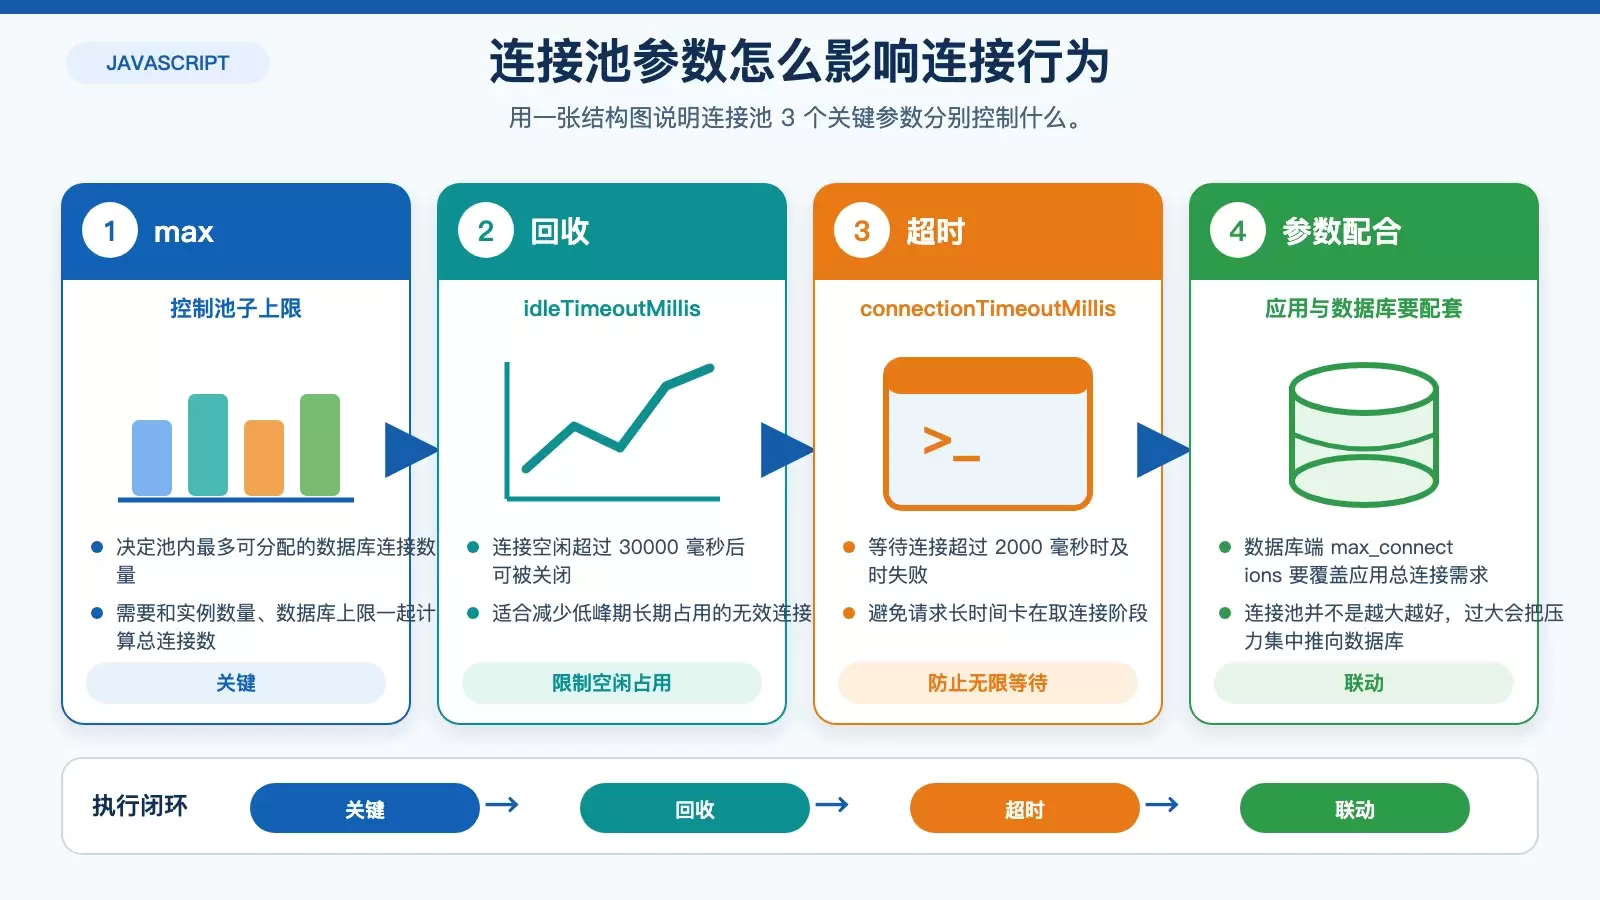
Node.js 应用跑在 Linux 上后,数据库连接往往最先成为性能瓶颈。要把这块优化稳住,不能只盯连接池,而要同时看应用异步模型、PostgreSQL 参数、监控手段、读写分离和缓存策略,最后再用定期维护把效果维持住。
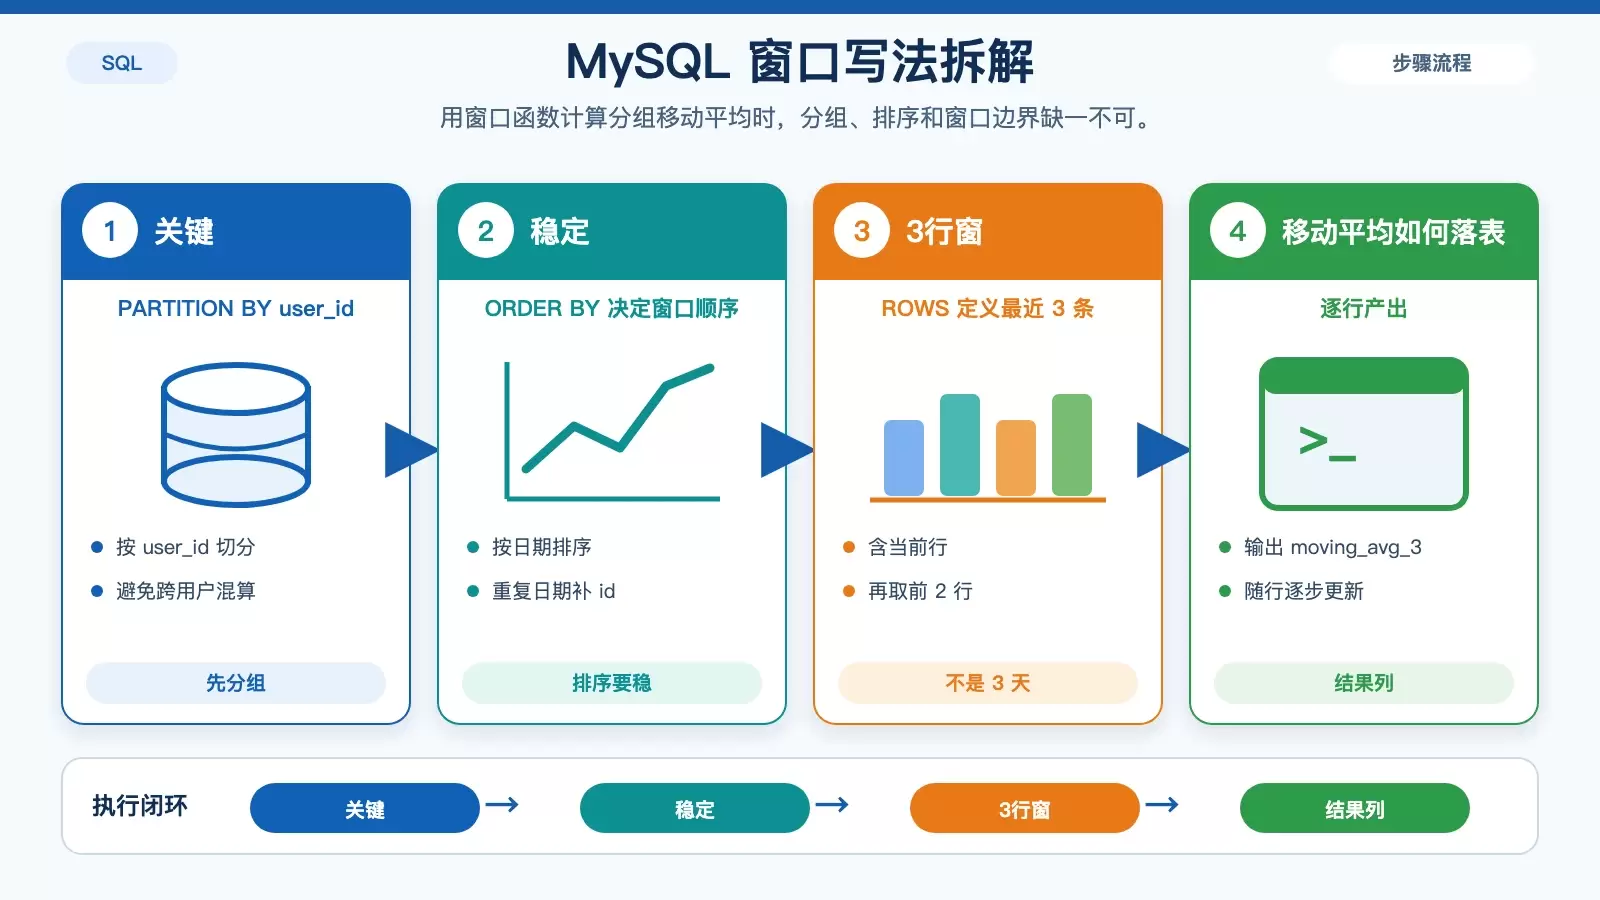
分组移动平均在 SQL 里不难,真正容易出错的是窗口怎么定义、分组是否隔离,以及数据库版本对 `ROWS`、`RANGE` 的支持差异。本文按 MySQL、PostgreSQL、SQL Server 与 SQLite 分别梳理可用写法,并补上边界行与 `NULL` 处理时最常见的误区。
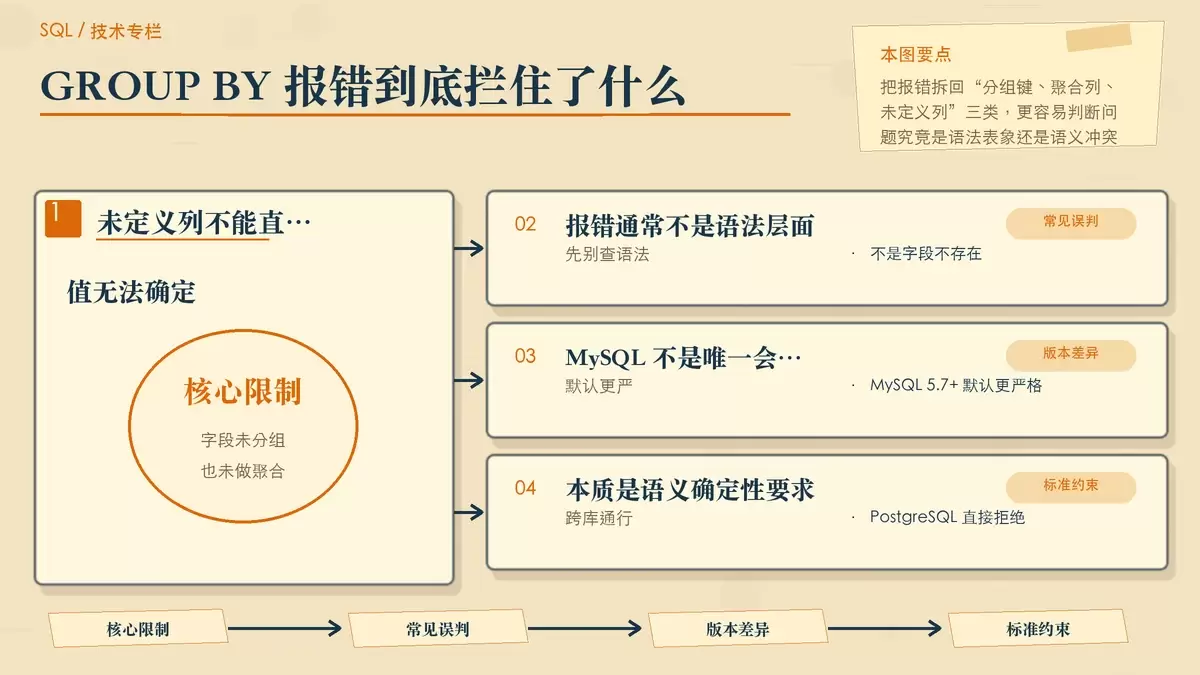
`GROUP BY` 语法看起来没问题却报错,通常不是拼写失误,而是数据库在拦截“结果不确定”的查询。本文从报错含义、常见误判、分组键设计、`ORDER BY` 别名可见性,到 `ANY_VALUE()` 的适用边界,梳理出更稳妥的排查与改写方式。
复杂视图之所以不能像表一样直接更新,核心不在语法,而在数据库是否愿意替你拆解 DML。SQL Server 允许借助 INSTEAD OF 触发器接管写入,但所有分发表、字段映射和校验都要手写;MySQL 则直接禁止在视图上创建触发器。