


做数据修复时,很多人第一反应是“先把触发器关掉再改数据”,但真正容易出问题的地方,通常不是命令怎么写,而是关错对象、以为已经生效、或者修完后没验证副作用有没有恢复。下面按 SQL Server、MySQL 和 PostgreSQL 三种常见场景拆开说明,保留可直接执行的语句,并把每一步为什么要这么做讲清楚。
SQL Server:禁用前先确认对象名,禁用后立刻核验
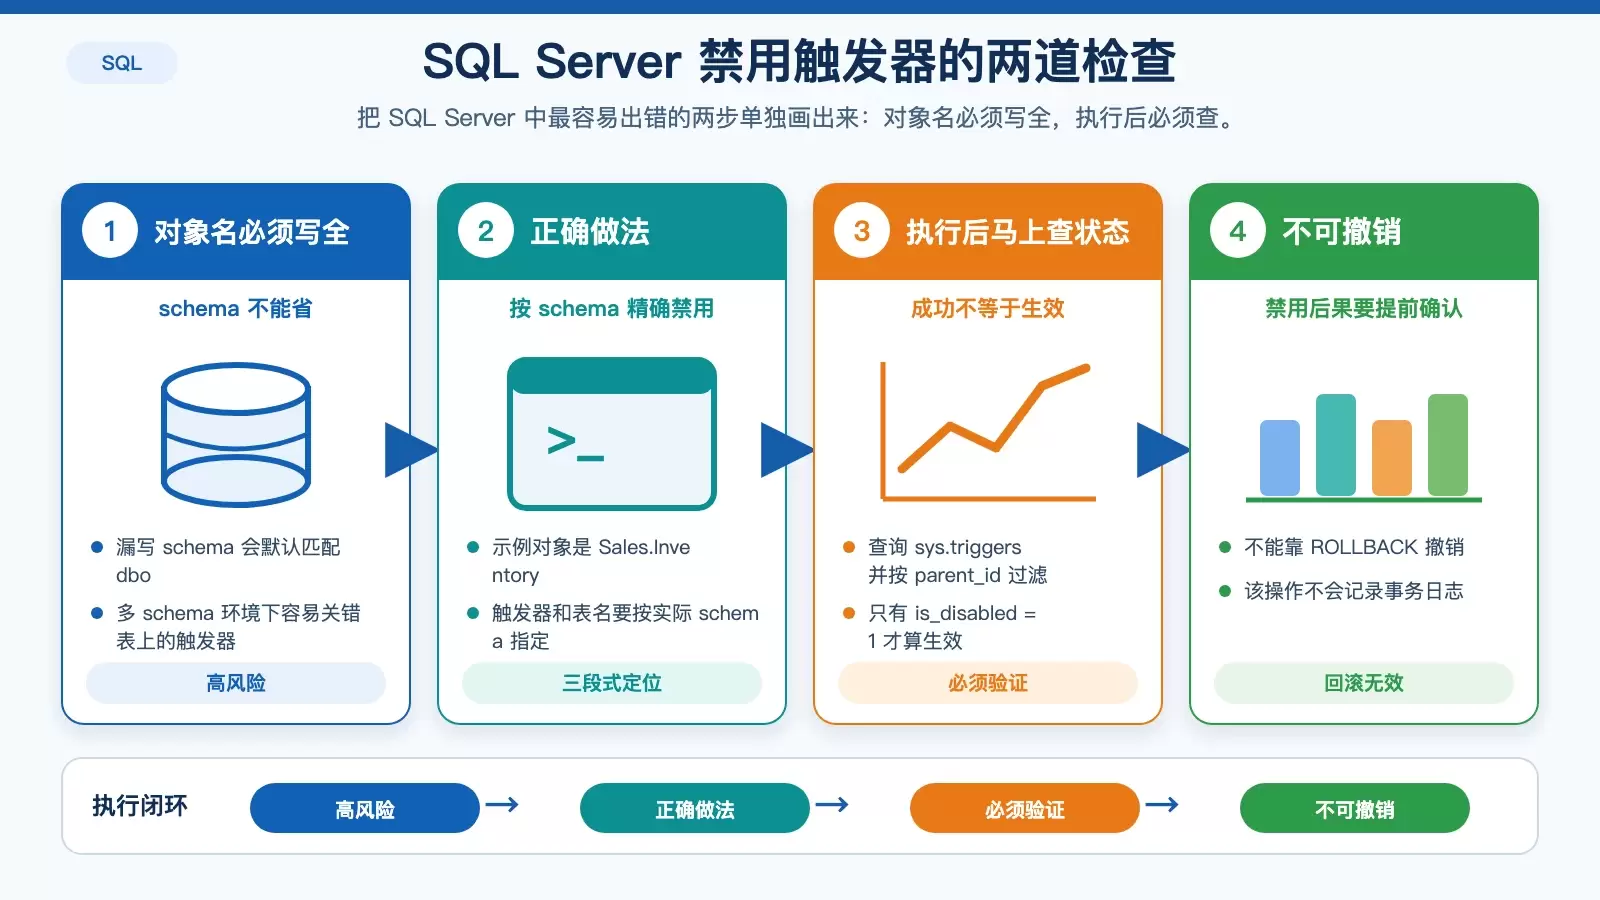
在 SQL Server 中,禁用触发器时必须明确写出 schema.table 和 trigger_name 的对应关系。多 schema 环境里,漏写 schema 往往不是“小问题”,而是直接把操作打到默认的 dbo 上。
三段式名称为什么不能省
直接执行下面这种写法,在多 schema 环境下很容易误操作:
DISABLE TRIGGER trg_log ON Orders原因是它会默认匹配 dbo.Orders,而你实际想处理的可能是 Sales.Orders。命令执行成功,并不代表你关掉了正确的触发器。
正确写法必须带 schema:
DISABLE TRIGGER Sales.trg_update_stock ON Sales.Inventory如果触发器名或表名里带空格、连字符等特殊字符,还要使用方括号:
DISABLE TRIGGER [trg order audit] ON [order header]命令成功后,为什么还要查一次状态
禁用完成后,应该马上查询系统视图确认状态,而不是只看客户端返回“执行成功”。
SELECT name, is_disabled FROM sys.triggers WHERE parent_id = OBJECT_ID('Sales.Inventory')只有看到 is_disabled = 1,才算真正完成禁用。
这里还有两个容易被忽略的限制:
- 禁用操作不可回滚,也不会记录事务日志,不能靠
ROLLBACK撤销。 - 视图上的
INSTEAD OF触发器也适用同样语法,但如果 ORM 直接绕过视图写基表,禁用视图触发器并不能解决问题。
MySQL:生产环境别依赖临时禁用,可靠路径是删后重建
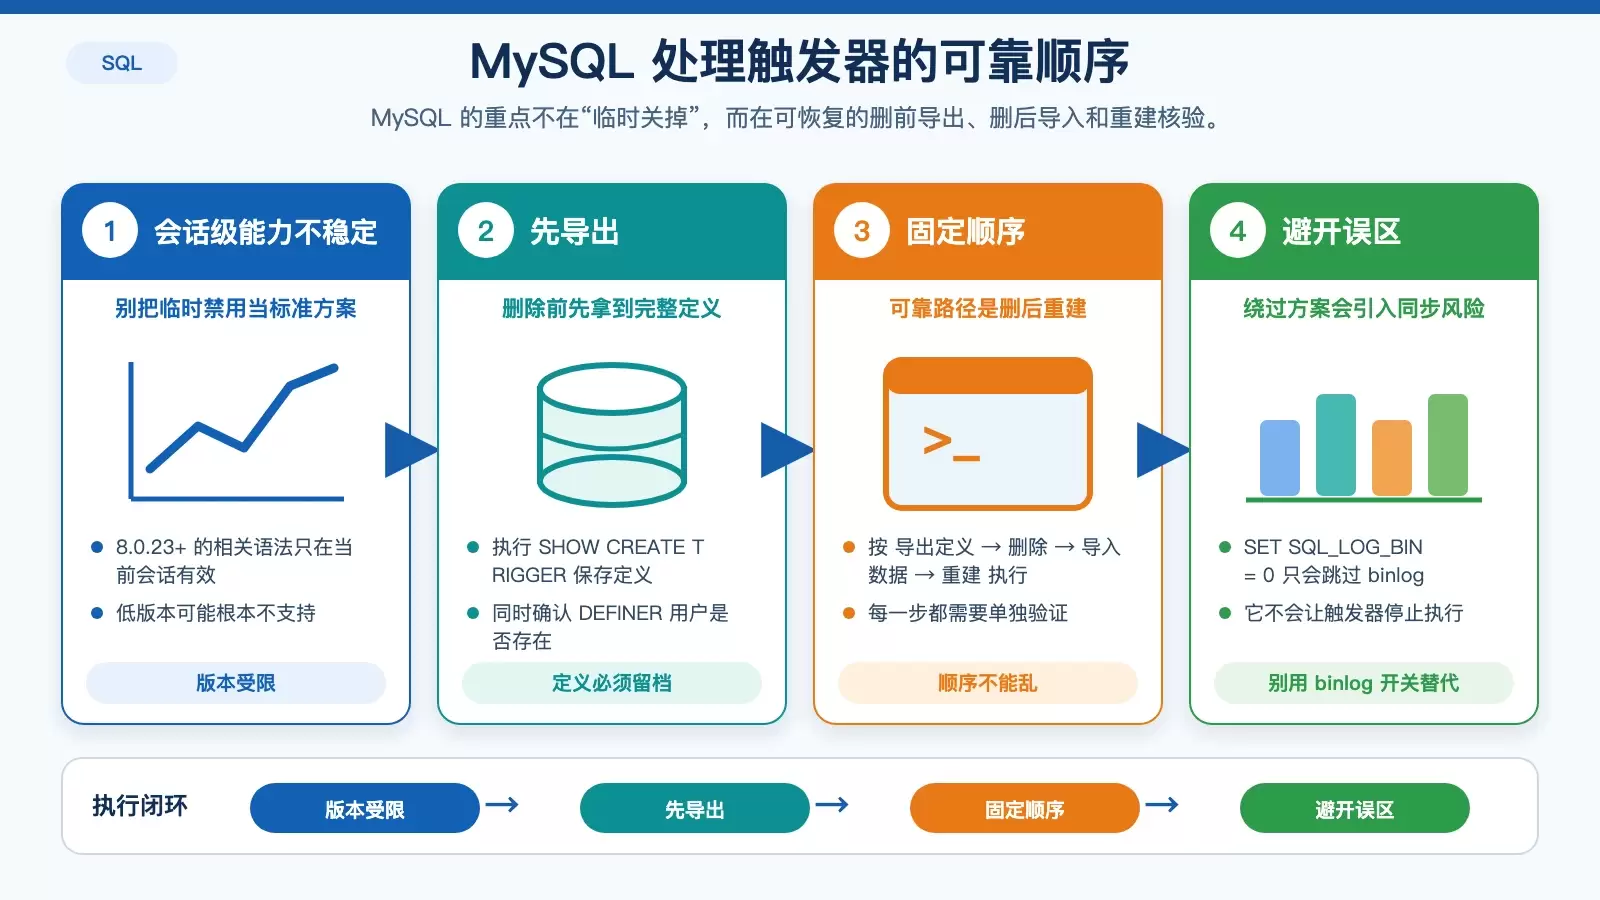
MySQL 的麻烦在于,“临时禁用触发器”这件事并不像 SQL Server 那样稳定、统一。即便是 MySQL 8.0.23+,相关能力也有明显限制,不能简单当成生产方案。
为什么说 MySQL 没有真正可靠的 DISABLE TRIGGER
MySQL 8.0.23+ 虽支持下面的语法:
ALTER TABLE table_name DISABLE TRIGGER trigger_name但这个语句只在当前会话有效,而且不同客户端对它的支持并不完全一致;更低版本则根本不识别。也就是说,生产环境如果把它当成标准操作,行为很难预测。
因此,更稳妥的流程是:
导出定义 → 删除触发器 → 导入数据 → 重建触发器
这四步顺序不能打乱,而且每一步都要验证。
删前、删后、重建时分别要看什么
删除之前,先导出并保存当前定义:
SHOW CREATE TRIGGER trigger_name这里要特别确认 DEFINER 用户是否存在,否则后续重建可能直接失败。
删除触发器可用:
DROP TRIGGER IF EXISTS trigger_name导入完成后重建时,要确保 SQL_MODE 与原环境一致,尤其是 STRICT_TRANS_TABLES。否则即使 SQL 能执行成功,触发逻辑的行为也可能和原来不同。
另外,不要尝试用下面这种方式“绕过去”:
SET SQL_LOG_BIN = 0它只会跳过 binlog,导致主从同步出问题,并不会让触发器停止执行。
触发器停用期间,数据修复必须配合停写和校验
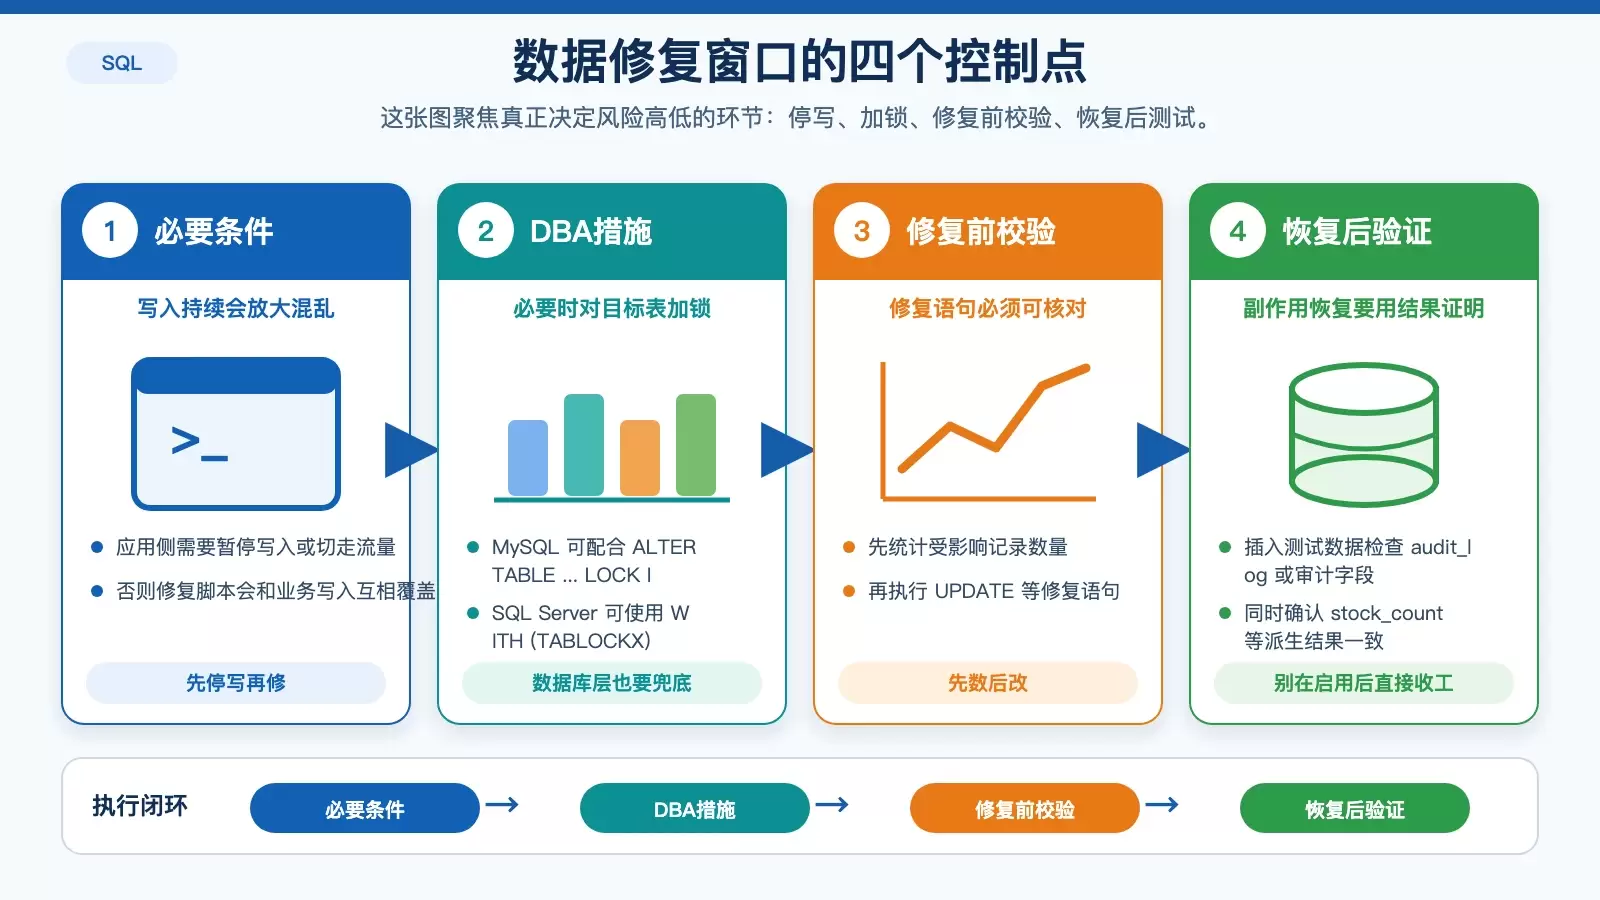
触发器停用后,最危险的不是修复语句本身,而是业务写入还在继续。此时 DML 仍然会正常执行,但所有依赖触发器完成的副作用,例如审计字段更新、日志写入、关联表同步,都会直接丢失。
为什么一定要停写入或加锁
如果修复脚本和业务写入同时发生,双方可能互相覆盖,最后既修不干净,也无法追溯到底是哪一步改坏了数据。
修复前至少要做到一项:
- 通知应用侧暂停写入,或者临时切走流量。
- 由 DBA 在数据库层面对目标表加锁,例如 MySQL 使用
ALTER TABLE ... LOCK IN SHARE MODE,SQL Server 使用WITH (TABLOCKX)。
修复语句和恢复动作都要带验证
修复脚本本身不能只写 UPDATE,最好先做可核对的范围确认。比如修复缺失的 updated_at:
SELECT COUNT(*) FROM t WHERE updated_at IS NULL AND status = 'active'UPDATE t SET updated_at = NOW() WHERE ...修复完成后,也不要立刻认为任务结束。先插入一条测试数据,再检查日志表或审计字段是否按预期更新,确认触发器逻辑仍然适配当前字段类型和约束。
真正麻烦的通常就在这里:没人去核对 audit_log 里有没有那条测试记录,也没人确认 stock_count 是否和修复后的订单量一致。少做一步验证,数据一致性风险就只是从触发器转移到了人工操作上。
PostgreSQL:禁用操作必须和导入放进同一事务
PostgreSQL 也支持 ALTER TABLE ... DISABLE TRIGGER ...,但这里最容易误判的点在于:它是否对后续导入真正生效,取决于你是不是把整个过程放在同一个事务会话里。
为什么自动提交模式下看似禁用,导入时却还会触发
如果处于默认自动提交模式,执行完禁用命令后事务就结束了。等你再去执行 COPY 或 INSERT 时,已经是新的执行上下文,触发器会照常运行。
因此需要显式开启事务:
BEGIN;
ALTER TABLE orders DISABLE TRIGGER trg_audit;
COPY orders FROM '/tmp/data.csv';
COMMIT;
只有把禁用和导入放进同一个事务里,这个操作才有实际意义。
名称确认和恢复启用都不能省
PostgreSQL 中触发器名大小写敏感,执行前最好先查真实名称:
d+ orders或者:
SELECT tgname FROM pg_trigger WHERE tgrelid = 'orders'::regclass导入完成后,记得重新 ENABLE TRIGGER。不要指望“断开连接”或“重启连接”自动恢复;如果漏掉这一步,后续业务写入会持续丢失原本依赖触发器实现的逻辑。
结论:真正要管住的是恢复路径和结果核对
临时停用触发器从来不只是一个语法问题。SQL Server 要防止 schema 误匹配,MySQL 要接受“删后重建”才是稳妥路径,PostgreSQL 则必须把禁用和导入绑定到同一事务。无论用哪种数据库,真正决定风险高低的,始终是三件事:有没有停写、有没有核对禁用是否生效、修复后有没有用测试数据验证副作用已经恢复。









