


在 Go Web 开发里,很多团队都会接触到“函数式编程”这个话题:它强调不可变性、纯函数和函数组合,看上去能让代码更清晰,也更容易维护。但一旦真正落到 Gin、GORM 这类常见技术栈上,问题很快就变成:哪些层适合函数式写法,哪些地方又很难做到真正纯粹。
这篇文章就围绕一个完整的 Go Web 项目展开,把目录结构、仓库层、服务层、控制层、中间件和入口配置逐层拆开。读完之后,你不仅能看懂这套设计怎么组织,也能更清楚地判断它在可组合性、并发安全和测试成本之间的真实取舍。
项目结构怎么分层,才能让函数式写法落地
如果要在 Go Web 项目里实践函数式风格,第一步不是先写高阶函数,而是先把职责边界分清。原文给出的目录结构如下:
godemo/
├── internal/
│   ├── repository/
│   │   ├── user_repository.go
│   │   └── db.go
│   └── model/
│       └── user.go
├── pkg/
│   └── user/
│       └── user_service.go
├── app/
│   ├── middleware/
│   │   ├── auth_middleware.go
│   │   └── logger_middleware.go
│   ├── controller/
│   │   ├── router.go
│   │   └── user_controller.go
├── config/
│   └── config.go
└── cmd/
    └── server/
        └── main.go
这套划分的核心,不是形式上的“分目录”,而是把不同层的输入和输出控制住:
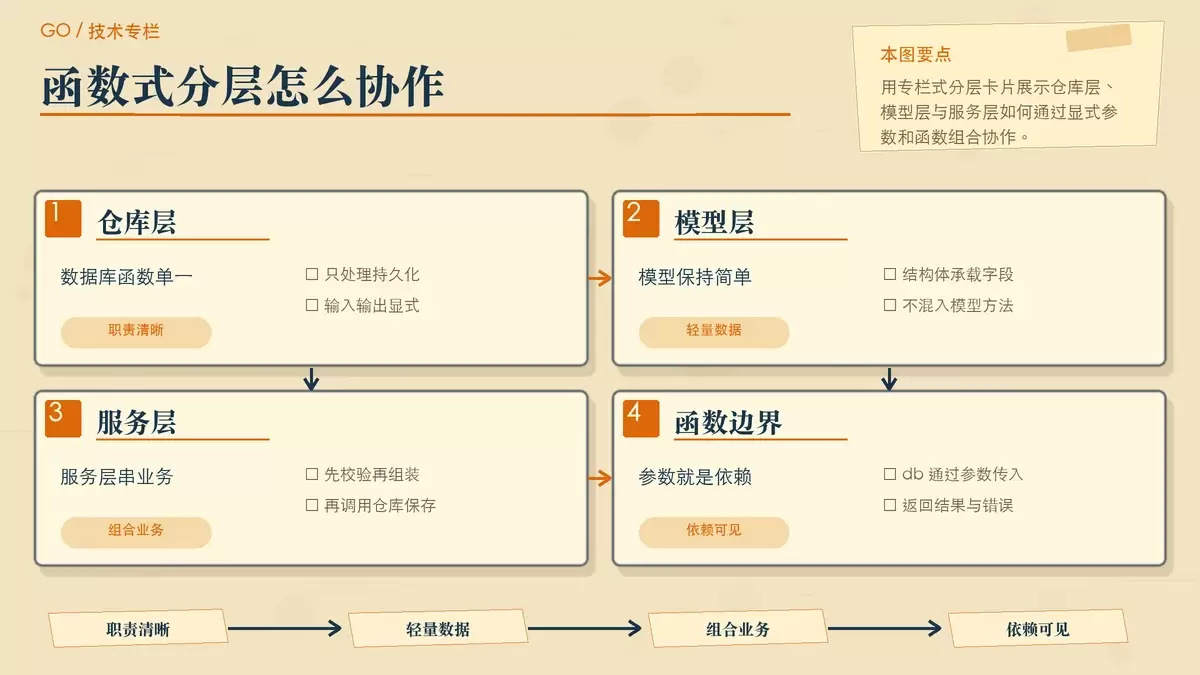
internal/repository负责数据持久化,只处理数据库读写。internal/model放数据结构本身,不把业务逻辑塞进模型方法。pkg/user承担业务逻辑,把多个基础操作组合成完整流程。app/controller面向 HTTP,请求解析、响应输出和路由都放在这里。app/middleware负责横切逻辑,比如日志和认证。config与cmd/server分别解决配置初始化和应用启动。
从函数式角度看,这种结构最大的好处是:每一层都尽量通过参数收依赖,通过返回值交结果,而不是把状态散落到对象方法里。这样做未必能让项目变成“纯函数式”,但至少能让数据流和控制流更容易追踪。
仓库层和服务层,怎样用纯函数与函数组合组织业务
仓库层:数据库操作尽量做成显式输入、显式输出
仓库层的目标很明确,就是把数据库访问封装成单一职责函数。文中的示例如下:
// internal/repository/user_repository.go
package repository

// 纯函数,通过参数接收db实例
func CreateUser(db *gorm.DB, user *model.User) error {
    // 插入用户数据到数据库
    // 返回错误信息(如果有)
}

func GetUserByID(db *gorm.DB, id uint) (*model.User, error) {
    // 根据ID查询用户
    // 返回用户指针或错误
}

// 更多数据库操作函数...
这里最重要的点,不是“函数没有挂在结构体上”,而是 db *gorm.DB、user *model.User、id uint 都通过参数显式传入。调用方一眼就能知道,这个函数依赖什么、会产出什么。
文章同时保留了一个数据库访问入口:
// internal/repository/db.go
package repository

import "godemo/config"

// 获取全局DB实例
func GetDB() *gorm.DB {
    return config.GetDB()
}
这也说明一个现实问题:在 Go Web 项目中,很多“函数式实现”其实是局部成立的。数据库连接本身仍然常常由全局配置持有,只是在业务函数里尽量通过参数传递,减少隐藏依赖。严格来说,它并不是彻底纯粹的函数式模型,但已经能明显改善代码可读性。
模型层:结构体只承载数据,不混入方法状态
配合仓库层,模型定义也保持轻量:
// internal/model/user.go
package model

type User struct {
    ID        uint   `gorm:"primaryKey"`
    Name      string `gorm:"size:100"`
    Email     string `gorm:"uniqueIndex"`
    // 更多字段定义...
}
这种写法把 User 当作数据载体,而不是一个带行为的对象。它的优势在于,数据转换、校验、持久化都不会被模型方法分散掉,服务层更容易做函数组合。
服务层:把复杂流程拆成可拼接的业务函数
真正体现函数式思路的,通常是服务层。因为业务逻辑往往不是单个数据库操作,而是一串步骤的组合:校验参数、构建模型、调用仓库层、返回结果。文中的示例是:
// pkg/user/user_service.go
package user

// 创建用户业务逻辑函数
func CreateUser(name, email string) (*model.User, error) {
    // 参数验证逻辑
    // 创建用户模型
    // 调用仓库层函数保存数据
    // 返回结果
}
这种设计适合把一个大流程拆成多个小函数,每个函数只处理一件事。即使文章没有继续展开,你也能看出它的目标:让“业务逻辑”成为一条明确的处理链,而不是散落在控制器、模型方法和中间件里。
对 Go 项目来说,这样的好处很直接:
- 参数和返回值都可见,排查问题时更容易顺着链路往下看。
- 业务逻辑和 HTTP 层解绑,后续换成 RPC 或消息消费时复用空间更大。
- 尽量减少内部可变状态,代码行为会更稳定,也更适合并发场景。
Gin 控制层与中间件,函数式风格具体怎么写
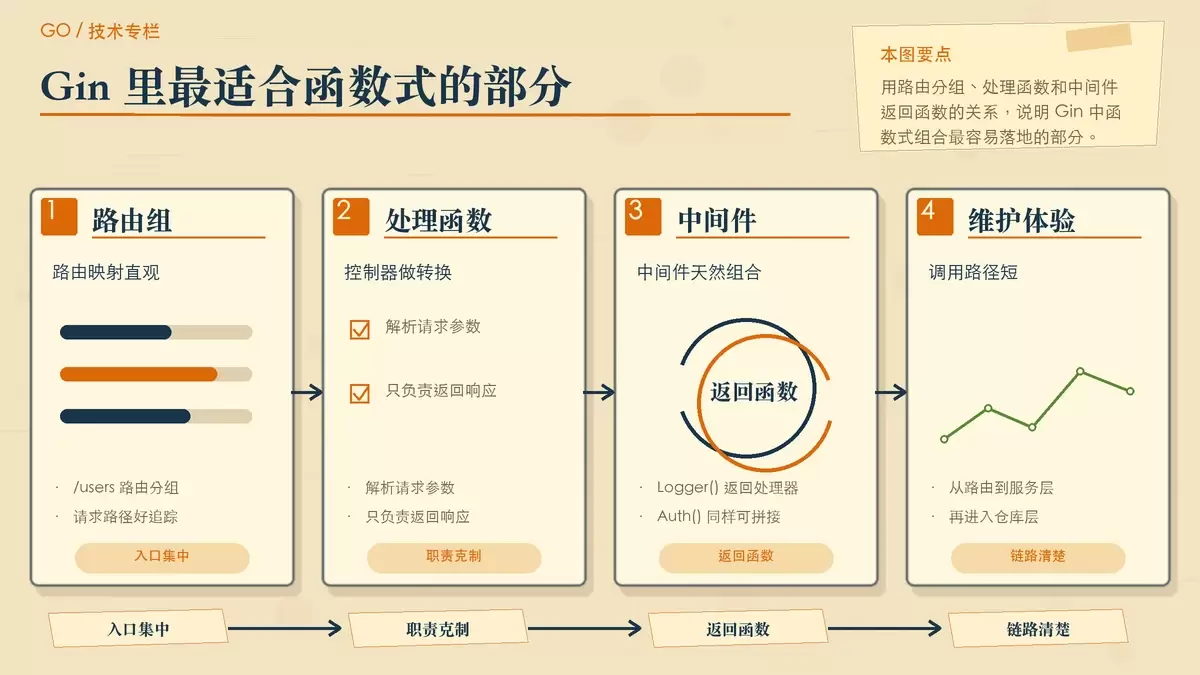
路由层:把请求入口收束成清晰的函数映射
控制层面向 HTTP,请求入口通常先从路由定义开始。原文使用 Gin 组织路由:
// app/controller/router.go
package controller

func SetupRouter() *gin.Engine {
    router := gin.Default()

    // 添加中间件
    router.Use(middleware.Logger())
    router.Use(middleware.Auth())

    // 定义用户相关路由
    userGroup := router.Group("/users")
    {
        userGroup.POST("", CreateUserHandler)      // 创建用户
        userGroup.GET("/:id", GetUserHandler)      // 获取用户
        // 更多路由定义...
    }

    return router
}
这里的函数式特征主要体现在两点。第一,中间件是函数调用结果,返回值直接交给 router.Use;第二,路由和处理函数是一一映射关系,HTTP 入口足够扁平,不需要再跨多个对象查找行为定义。
对维护者来说,这种组织方式很友好:从 /users 路由可以直接定位到处理函数,再进入服务层和仓库层,调用链比较短。
处理函数:控制器只做协议转换,不吞掉业务逻辑
请求处理函数的职责也保持克制:
// app/controller/user_controller.go
package controller

func CreateUserHandler(c *gin.Context) {
    // 解析请求参数
    // 调用服务层函数处理业务逻辑
    // 根据结果返回相应HTTP响应
}

func GetUserHandler(c *gin.Context) {
    // 从URL参数中提取用户ID
    // 调用服务层函数获取用户信息
    // 返回用户数据或错误信息
}
如果按照函数式思路继续推进,控制器最好只承担三件事:读请求、调服务、写响应。也就是说,它是协议适配层,而不是业务逻辑容器。这样一来,业务流程不会被 HTTP 上下文绑定死,逻辑复用和测试都会轻松一些。
中间件:用返回函数的方式增强可组合性
在 Gin 里,中间件天然适合函数式表达,因为它本身就是“返回处理函数的函数”。文章里的日志中间件如下:
// app/middleware/logger_middleware.go
package middleware

func Logger() gin.HandlerFunc {
    return func(c *gin.Context) {
        // 记录请求开始时间
        // 调用c.Next()处理请求
        // 记录请求处理完成时间和状态
    }
}
认证中间件也采用同样结构:
// app/middleware/auth_middleware.go
package middleware

func Auth() gin.HandlerFunc {
    return func(c *gin.Context) {
        // 从请求头中提取token
        // 验证token有效性
        // 如果验证失败,返回401状态码
        // 如果验证成功,将用户信息存入上下文并继续处理
    }
}
这类设计的价值在于,中间件可以像积木一样组合。日志、认证、限流、追踪都能按顺序挂到路由树上,而且每个中间件只关注自己的输入和输出。对于需要频繁调整 Web 基础能力的项目,这种可组合性通常比“面向对象封装得很深”的写法更实用。
配置与入口层的现实边界:函数式并不等于没有全局状态
文章没有把项目包装成一个完全无状态的理想模型,而是保留了 Go Web 开发里常见的配置初始化方式:
// config/config.go
package config

var DB *gorm.DB

func InitDB() error {
    // 初始化数据库连接
    // 返回错误信息(如果有)
}

func GetDB() *gorm.DB {
    // 返回全局DB实例
}
应用入口也只负责把这些组件串起来:
// cmd/server/main.go
package main

func main() {
    // 初始化数据库连接
    // 设置路由
    // 启动HTTP服务器
}
这部分很值得单独拿出来看,因为它反映了函数式思想在 Go 中的常见落点:你可以让业务函数尽量纯粹,但很难让整个 Web 程序彻底没有全局状态。数据库连接池、配置对象、日志实例、HTTP 服务启动,这些通常都需要统一初始化和集中管理。
因此,更务实的理解是:函数式编程在这里更像一种约束代码组织的思路,而不是要求所有模块都满足数学意义上的纯函数。只要关键业务路径足够显式、依赖足够透明,这套方法就已经产生价值。
这种 Go 函数式 Web 架构,适合什么场景又会卡在哪
能带来的收益
文章总结的优势,核心可以归纳为五点。
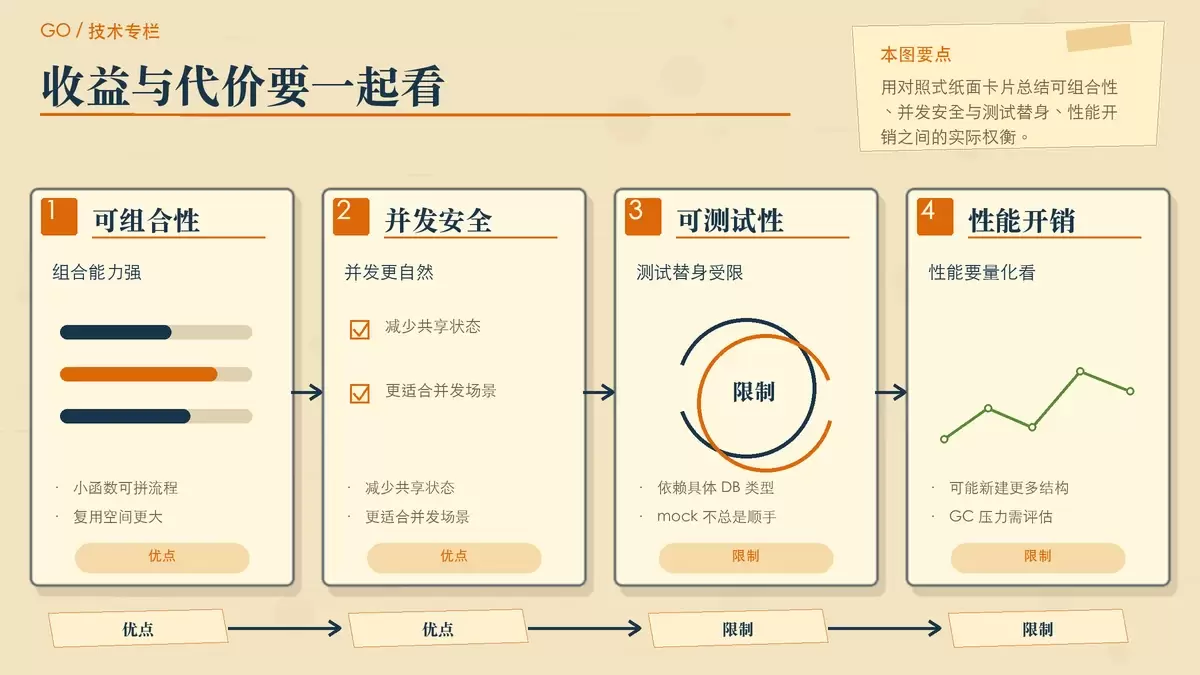
第一是可组合性更强。高阶函数和函数组合让小函数可以不断拼装成更完整的业务流程,代码复用空间更大。
第二是流程更清晰。不可变性和减少副作用的目标,会逼着开发者把输入输出写明白,数据流因此更容易追踪。
第三是并发安全更自然。纯函数减少共享状态,在 Go 这种并发使用频繁的语言里,确实能降低一部分协程协作复杂度。
第四是数据处理更直观。尤其在参数转换、结果组装、规则流水线这类场景里,函数式写法往往比堆叠对象状态更简洁。
第五是认知负担更低。一个函数只做一件事,团队成员理解成本会下降,新增逻辑时也更容易找到落点。
真正的限制也不能回避
这篇文章同样指出了两个很现实的问题。
首先是可测试性挑战。虽然“通过参数传依赖”听起来有利于测试,但当仓库层直接依赖 *gorm.DB 这类具体类型时,测试替身并不总是容易插入。相比通过接口注入 mock 的面向对象写法,这种模式在隔离数据库依赖时可能更麻烦。
其次是性能开销。函数式编程强调不可变性和组合,意味着部分场景下会更频繁地创建新数据结构,带来额外的内存分配和垃圾回收压力。对性能敏感链路来说,这一点需要谨慎评估,而不能只看代码是否“优雅”。
换句话说,这套架构更适合业务逻辑清晰、团队重视可维护性、并发需求较多的服务型项目;但在极端性能敏感、强依赖复杂 mock 测试体系的场景下,完全函数式化未必是最优选。
结论:Go Web 项目更适合“函数式思维”,而不是“纯函数式执念”
把 Gin、GORM 和函数式编程放在一起看,结论其实不复杂:函数式思想确实能帮助 Go Web 项目获得更清晰的分层、更直接的依赖传递和更强的组合能力,尤其适合服务层和中间件设计。
但文章给出的示例也说明,配置管理、数据库连接和应用启动这些基础设施层,往往仍然会保留全局状态或集中初始化。与其追求“所有代码都必须纯函数”,不如把重点放在真正影响维护成本的地方:让业务逻辑更短、更清楚、依赖更透明。
对实际项目来说,更可取的做法通常不是彻底抛弃其他风格,而是在 Go 原本简洁的工程组织上,引入函数式编程中最有价值的部分。这样既不会为了形式牺牲工程效率,也能把代码质量往前推一步。









