SQL 插入小数后精度丢失怎么办
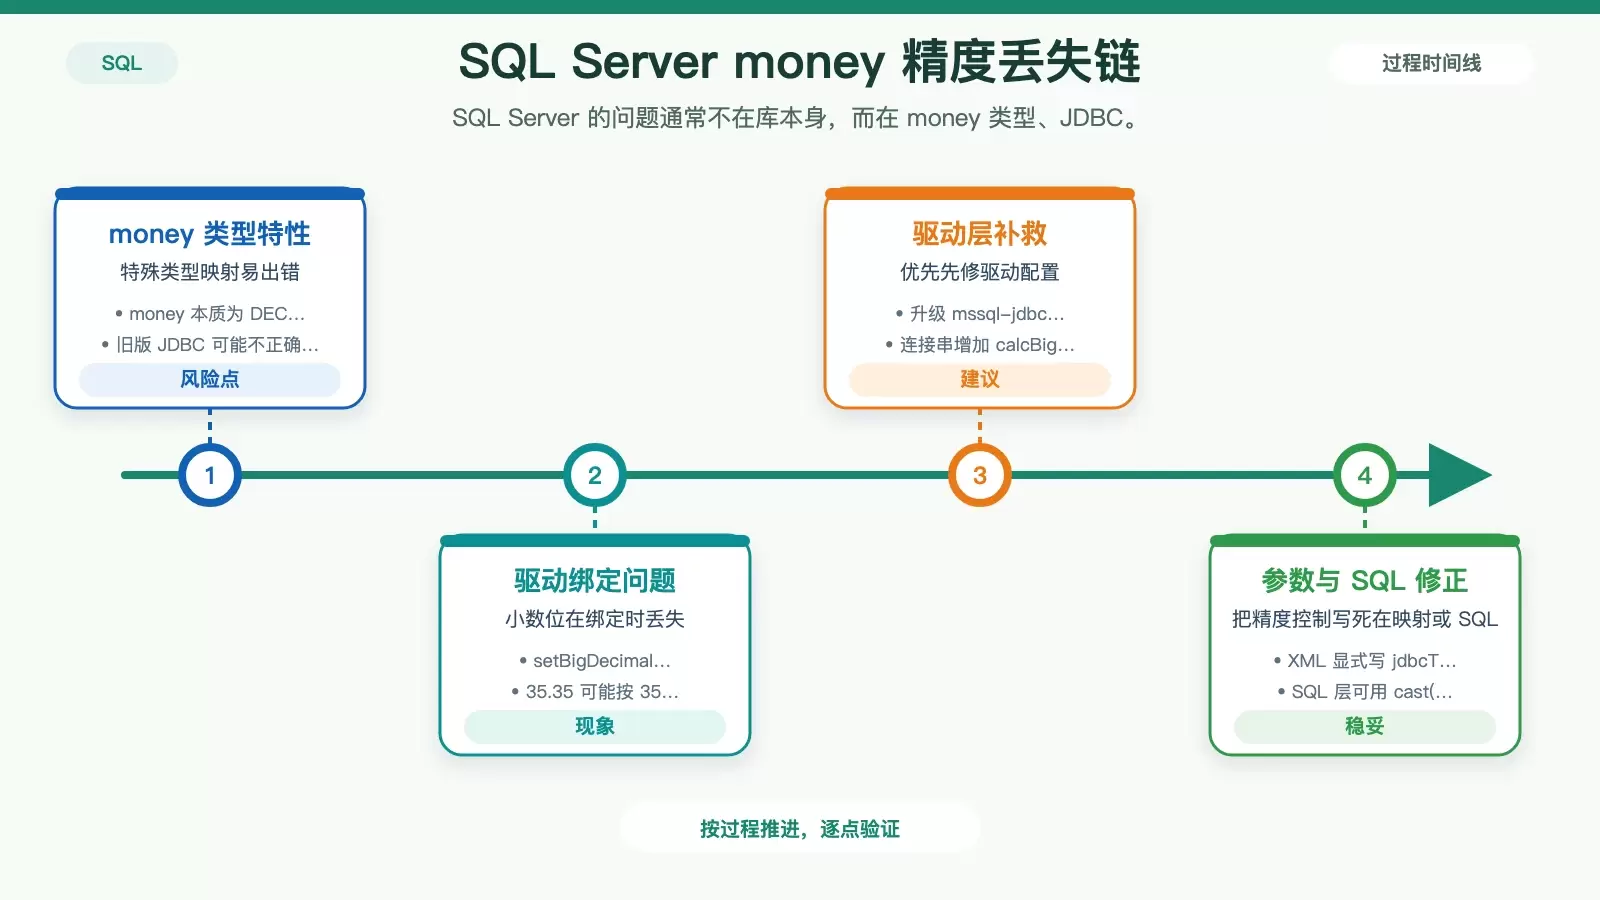
SQL 插入小数后“变整数”或计算结果飘移,通常不是数据损坏,而是字段类型、驱动传参、批量绑定或浮点运算在中间环节丢了 scale。本文按 SQL Server、MySQL、MyBatis 以及 PostgreSQL/Oracle 四类常见场景拆解原因,并给出可直接落地的修正方式。
2026-08-23
34

SQL 插入小数后“变整数”或计算结果飘移,通常不是数据损坏,而是字段类型、驱动传参、批量绑定或浮点运算在中间环节丢了 scale。本文按 SQL Server、MySQL、MyBatis 以及 PostgreSQL/Oracle 四类常见场景拆解原因,并给出可直接落地的修正方式。
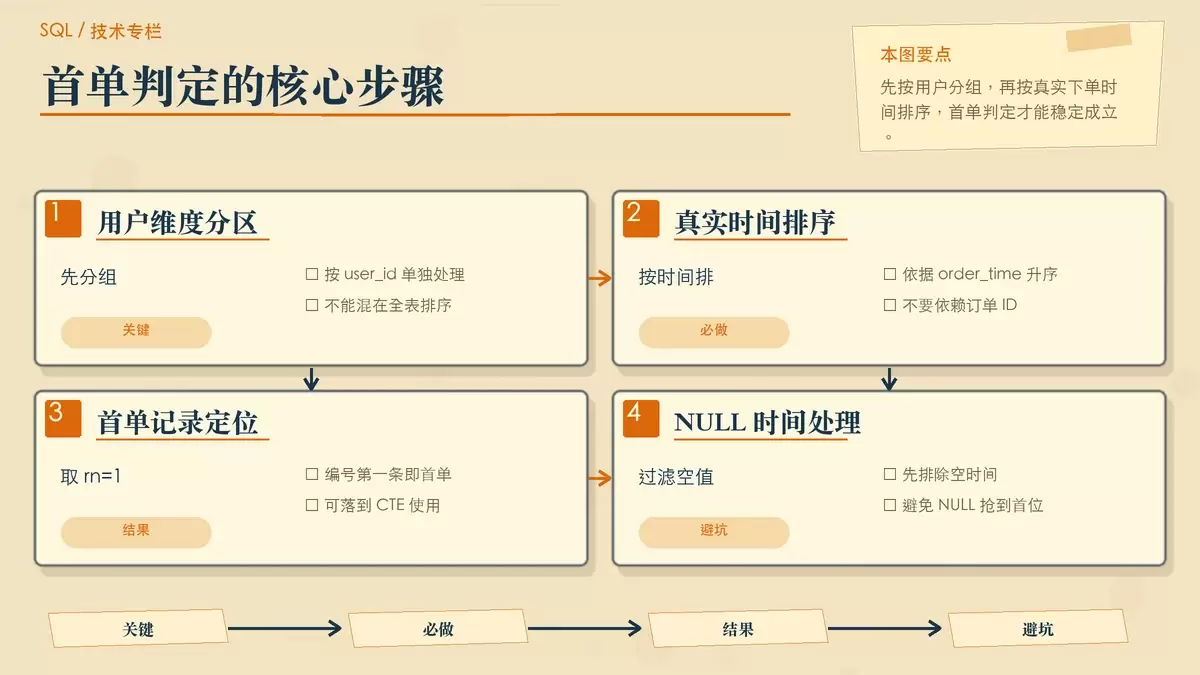
查询“首次购买后的复购记录”,关键不在于先写哪种 SQL,而在于先把“首次购买”的业务口径定清楚。本文用窗口函数为主线,拆解如何用 `ROW_NUMBER()` 锁定每个用户首单、再筛出后续订单,并说明 MySQL、PostgreSQL、SQL Server 的写法差异与常见误区。
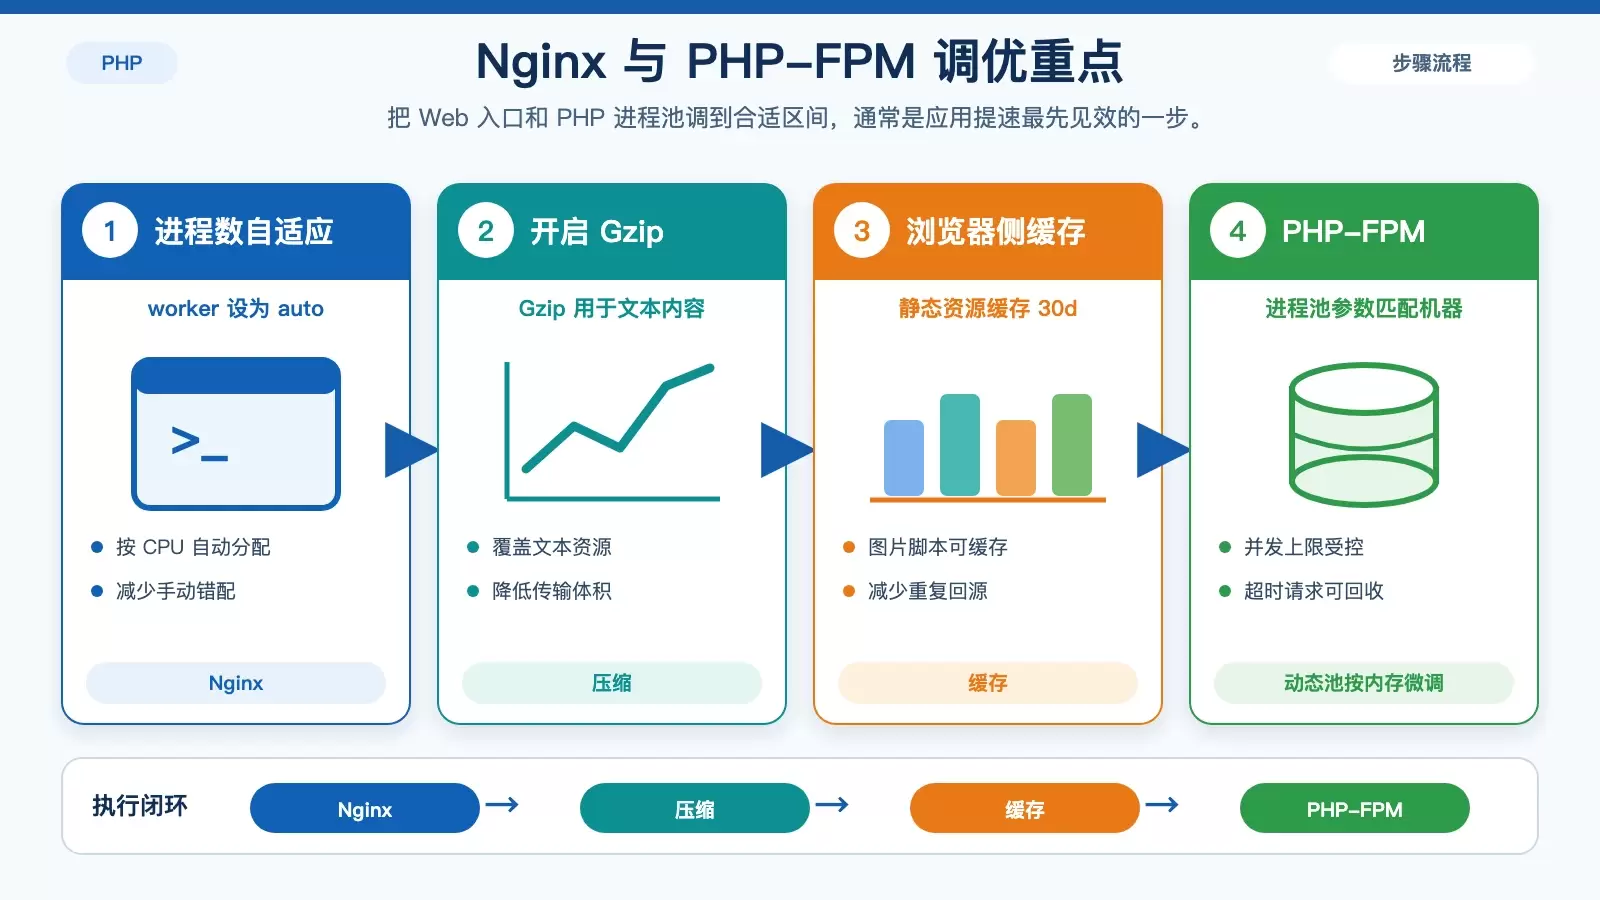
在 CentOS 上优化 ThinkPHP 响应时间,关键不在单点调参,而在于把 Web 服务器、PHP-FPM、代码访问路径、数据库和缓存放到同一条链路里看。本文按可落地的排查顺序整理常见优化手段,并说明哪些参数需要结合并发、内存和日志数据来判断。
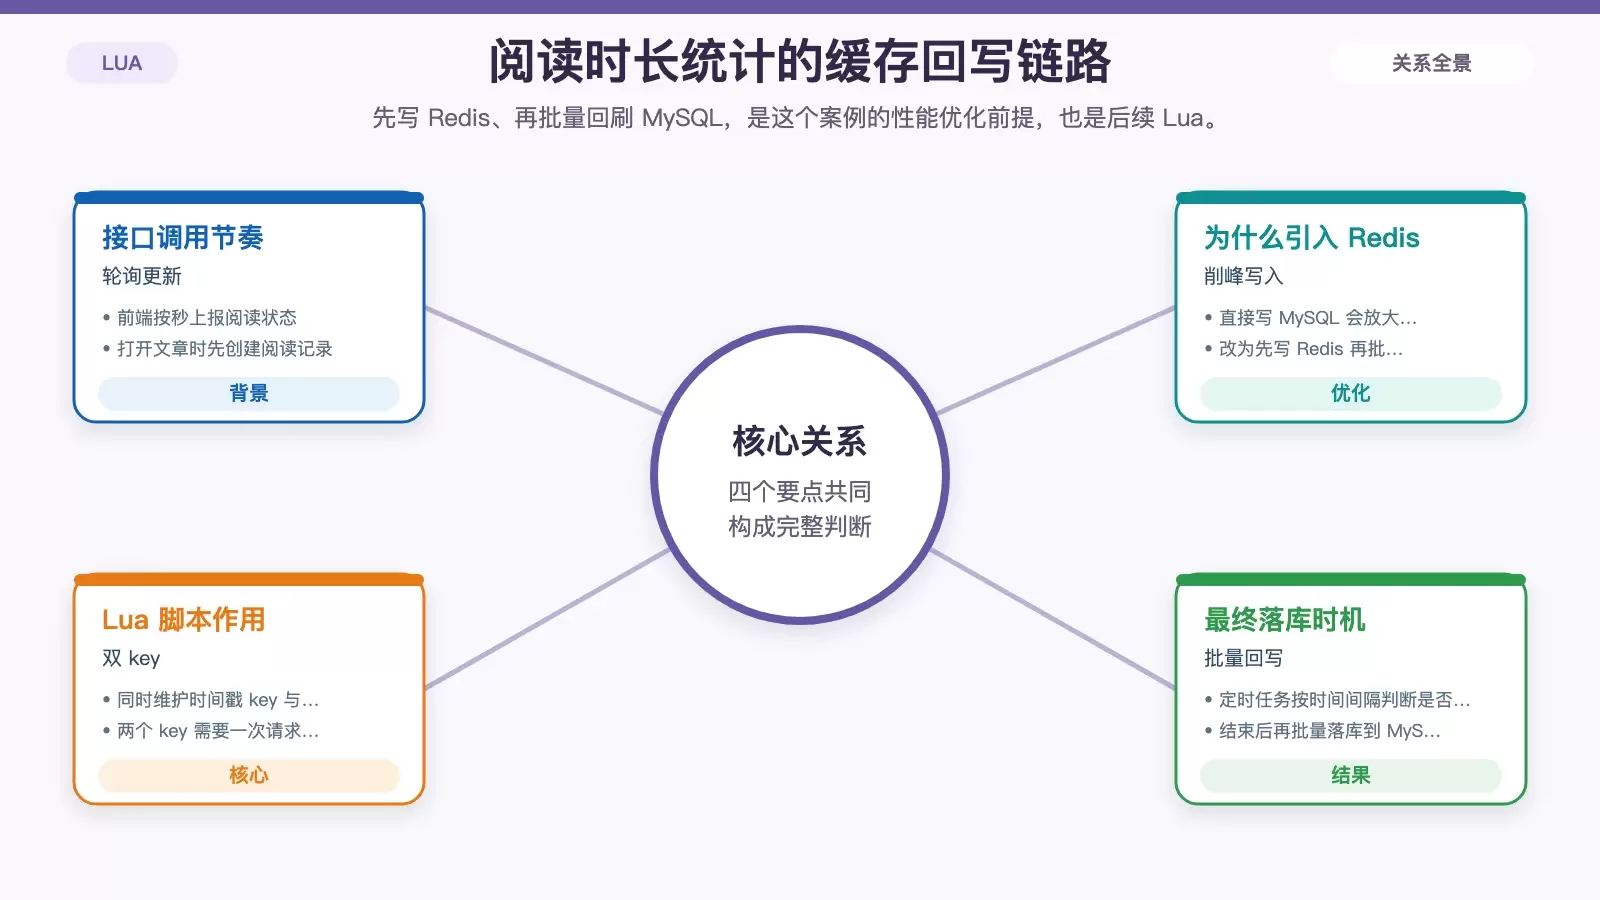
这篇文章围绕一个 Redis Lua 脚本踩坑案例展开:同样是更新阅读时长,从固定自增 1 秒改成按参数累加后,脚本却报出“对布尔值做算术运算”的错误。问题根源不在 Spring,而在 Redis Lua 的返回值类型转换规则,尤其是 `GET` 取不到值时会映射成 Lua 的 `false`。
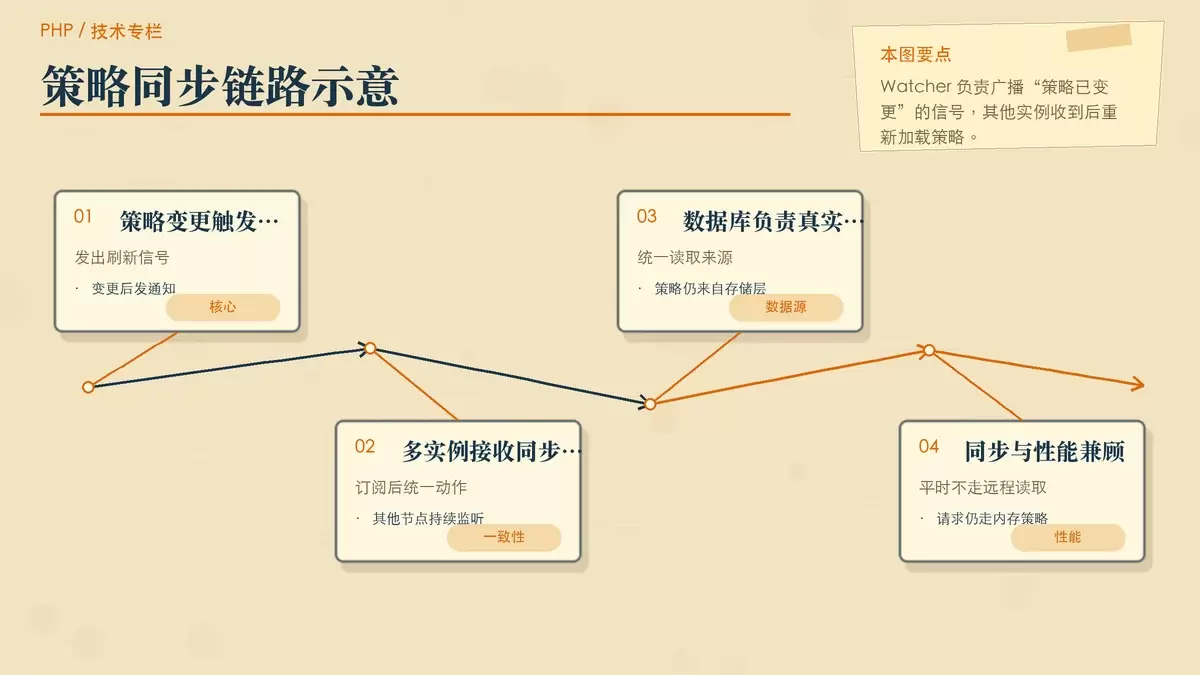
在常驻内存的 PHP 服务里,PHP-Casbin 的策略通常会缓存在进程内,性能很好,但也带来分布式场景下的同步问题。本文结合 PHP 8.4、Swoole 与 Redis Watcher,说明 Watcher 如何在多进程、多实例之间触发策略刷新,以及这套方案适合什么场景。
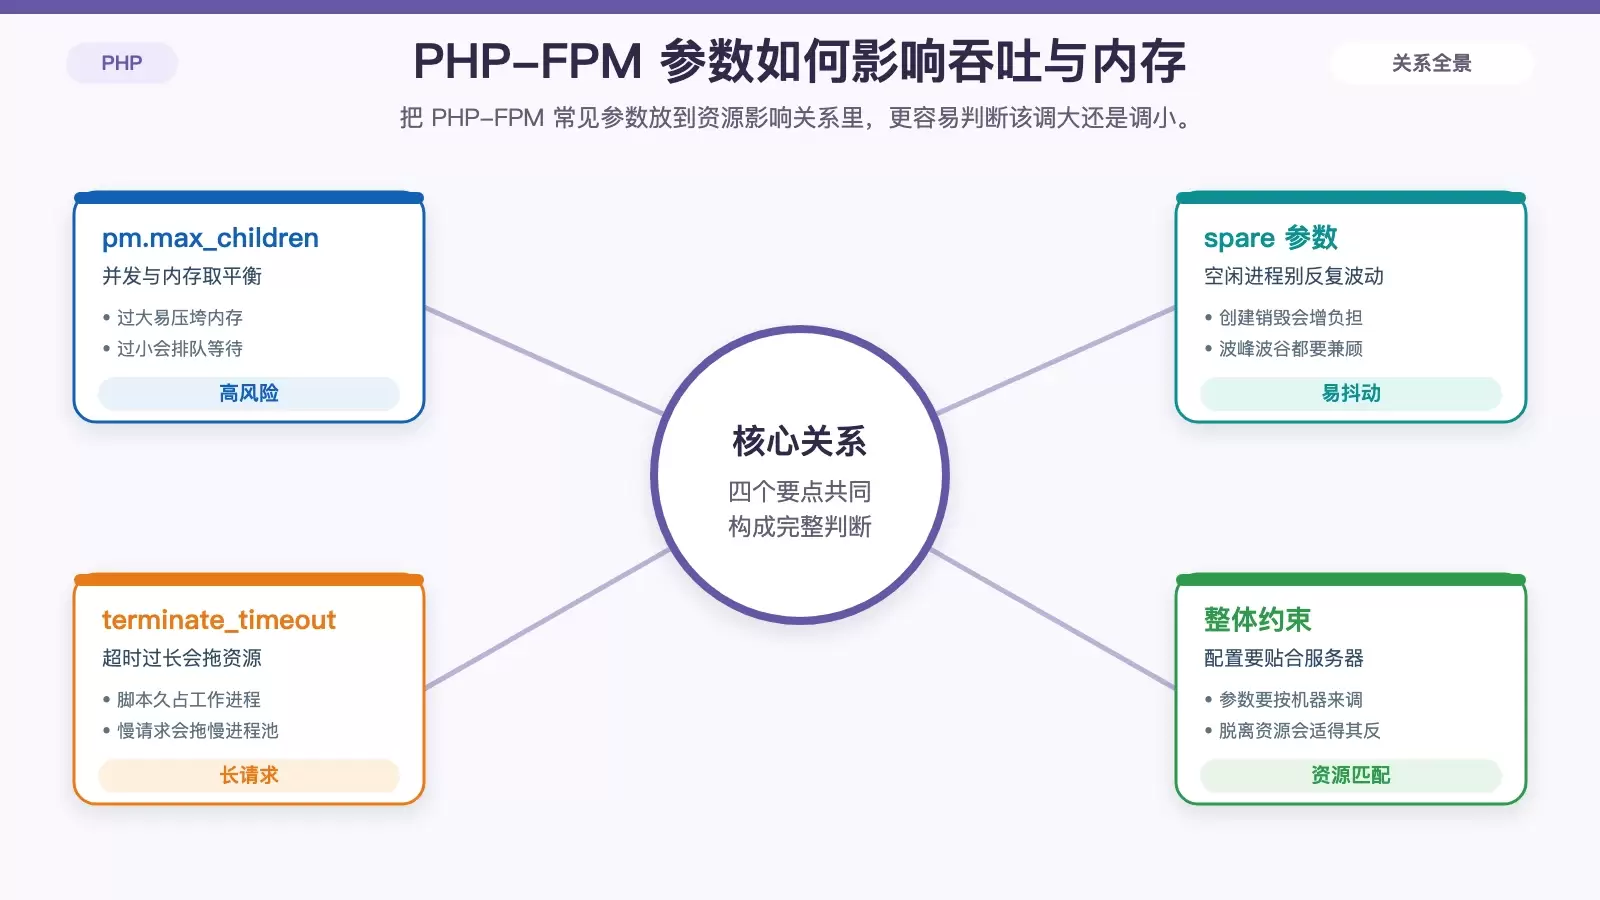
Ubuntu 上的 PHP 性能问题,通常不是单点故障,而是代码、数据库、PHP-FPM、缓存与系统资源共同叠加的结果。判断瓶颈时,重点要看 CPU 是否耗在脚本执行、数据库等待、进程调度还是 I/O 上,这样才能知道该先改代码、调参数,还是补缓存。
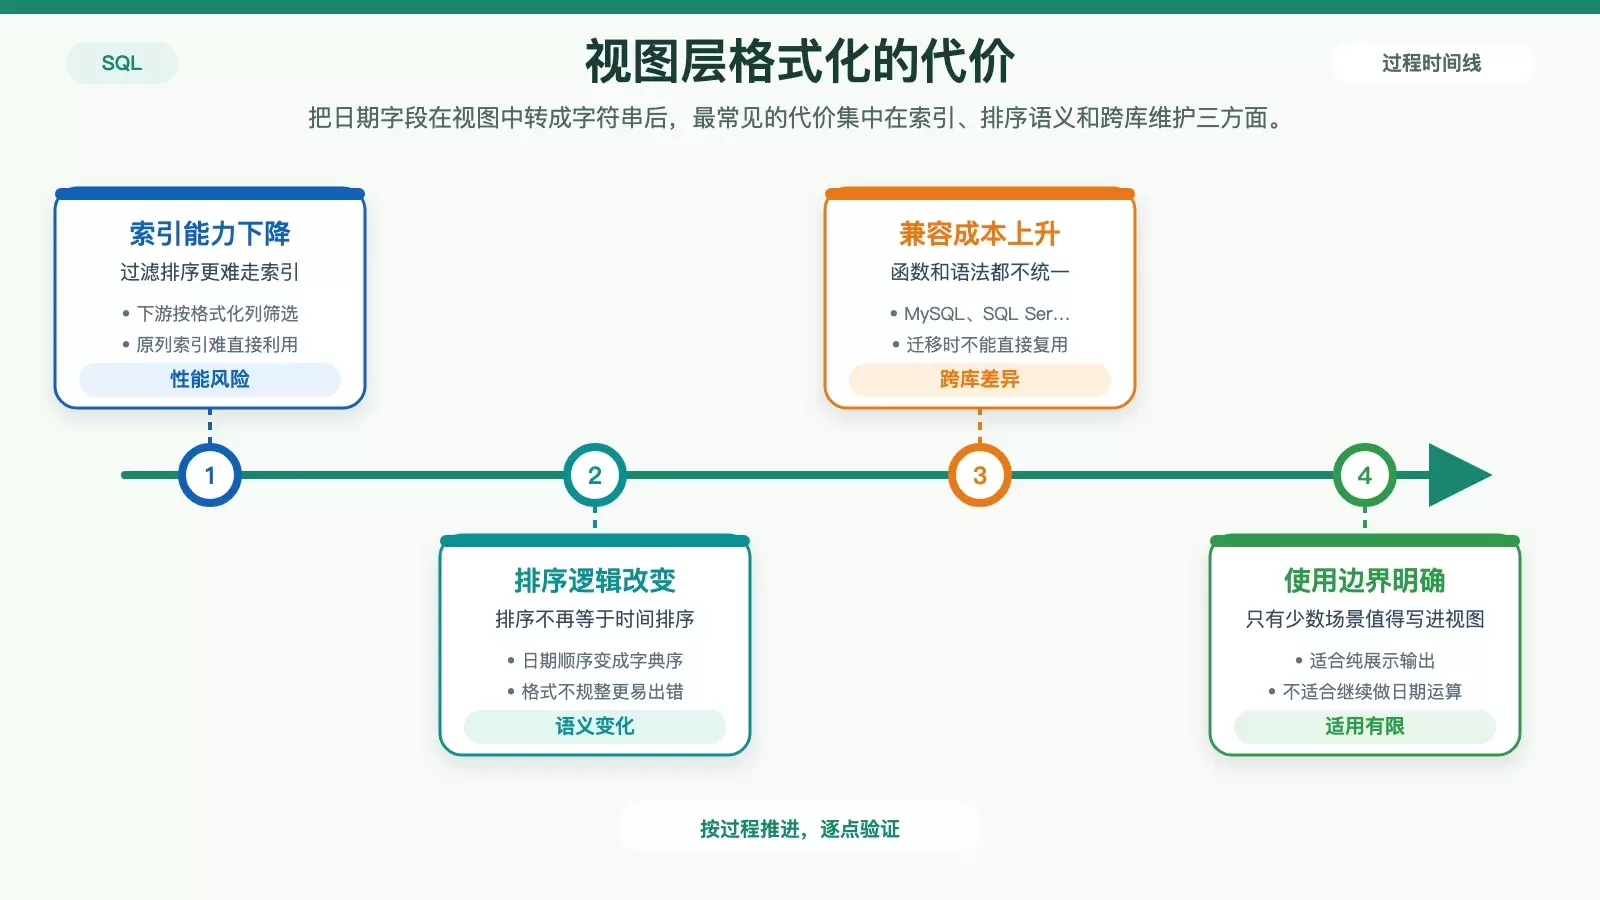
在 SQL 视图里直接格式化日期时间字段,技术上可行,但多数场景并不划算。因为一旦把日期转成字符串,索引利用、排序语义和跨数据库兼容性都会受影响。只有下游明确只接收字符串、且不再做日期计算时,才适合把格式化逻辑固定在视图中。
本文详细讲解如何使用Python的SQLAlchemy框架进行对象关系映射(ORM)以操作MySQL数据库。内容涵盖安装配置、连接创建、模型声明及表结构同步,解决少写SQL即可实现高效数据库交互的需求,适合希望快速掌握Python数据库操作的开发者。
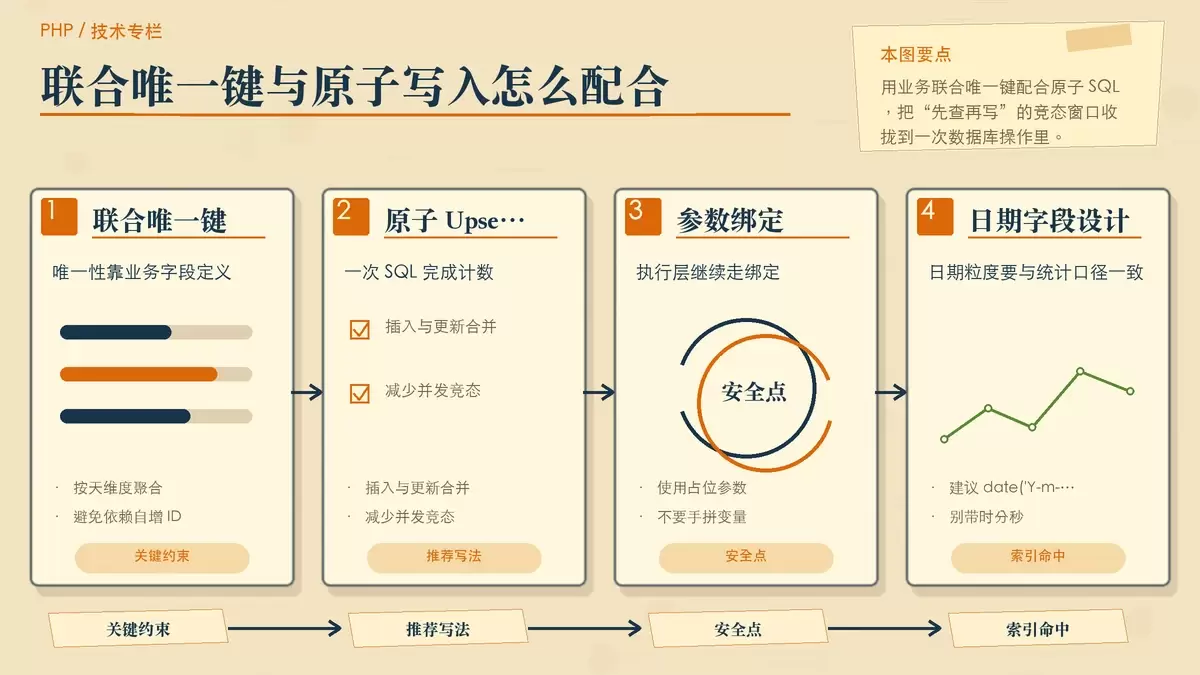
ThinkPHP 做请求统计时,最常见的问题不是语法,而是并发下的幂等和计数准确性。本文围绕唯一键冲突、`ON DUPLICATE KEY UPDATE` 的正确写法,以及 Redis 预聚合是否值得引入,梳理一套更适合线上场景的处理思路。
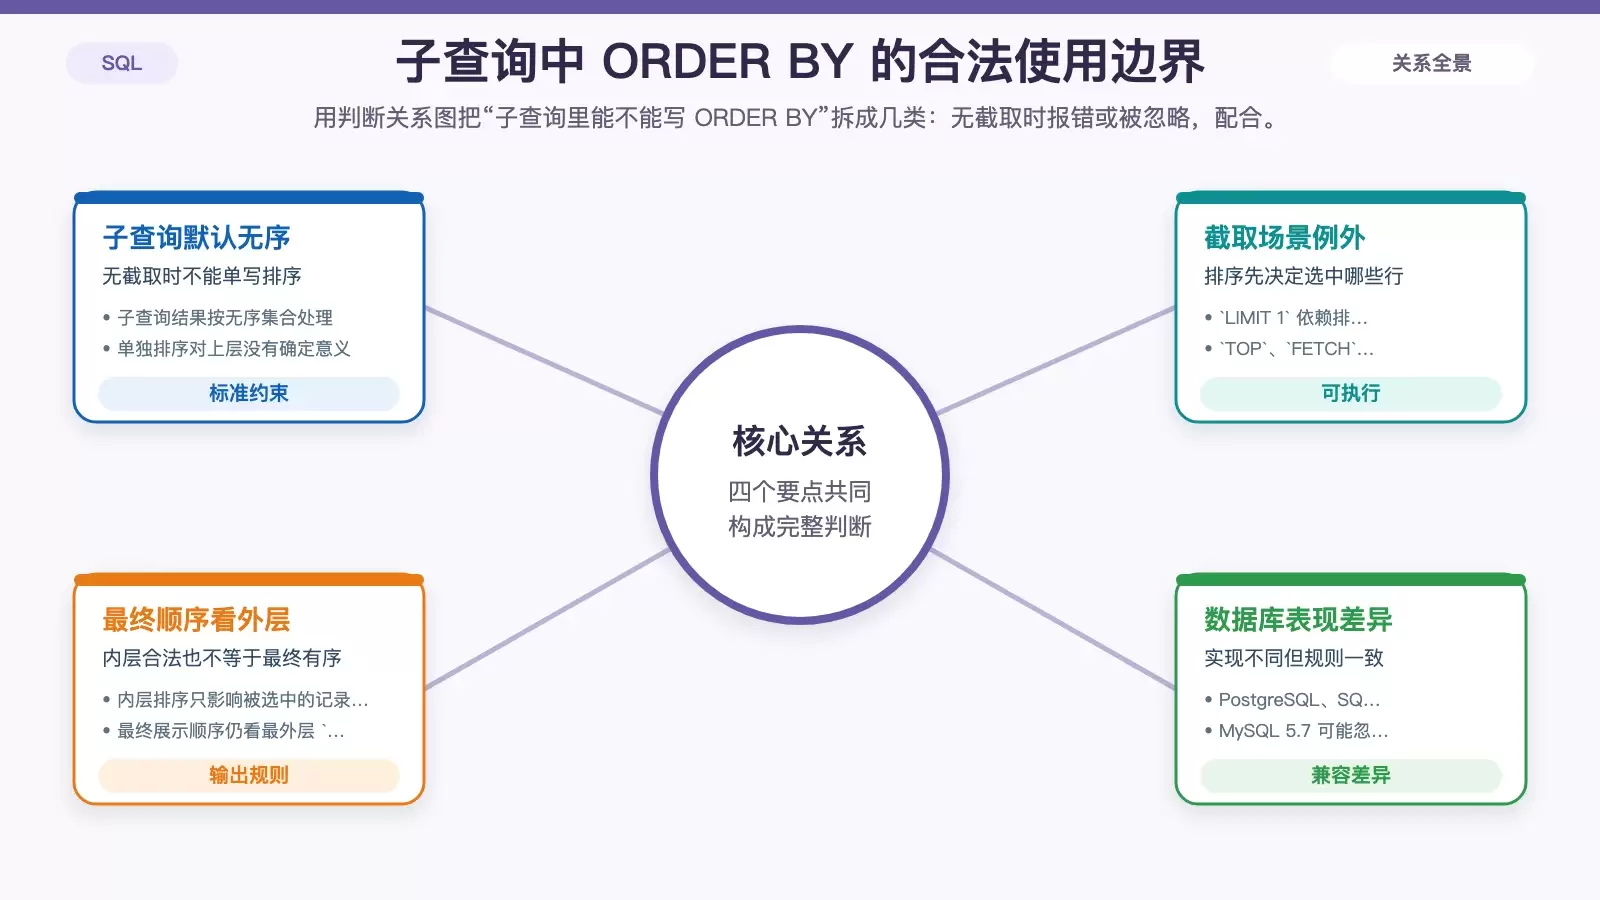
SQL 子查询里写 `ORDER BY` 经常引发报错或被数据库直接忽略,根源不在产品差异,而在 SQL 标准把子查询视为无序中间结果。本文梳理哪些场景允许内层排序、哪些必须放到外层,以及聚合与窗口函数中最常见的误区。
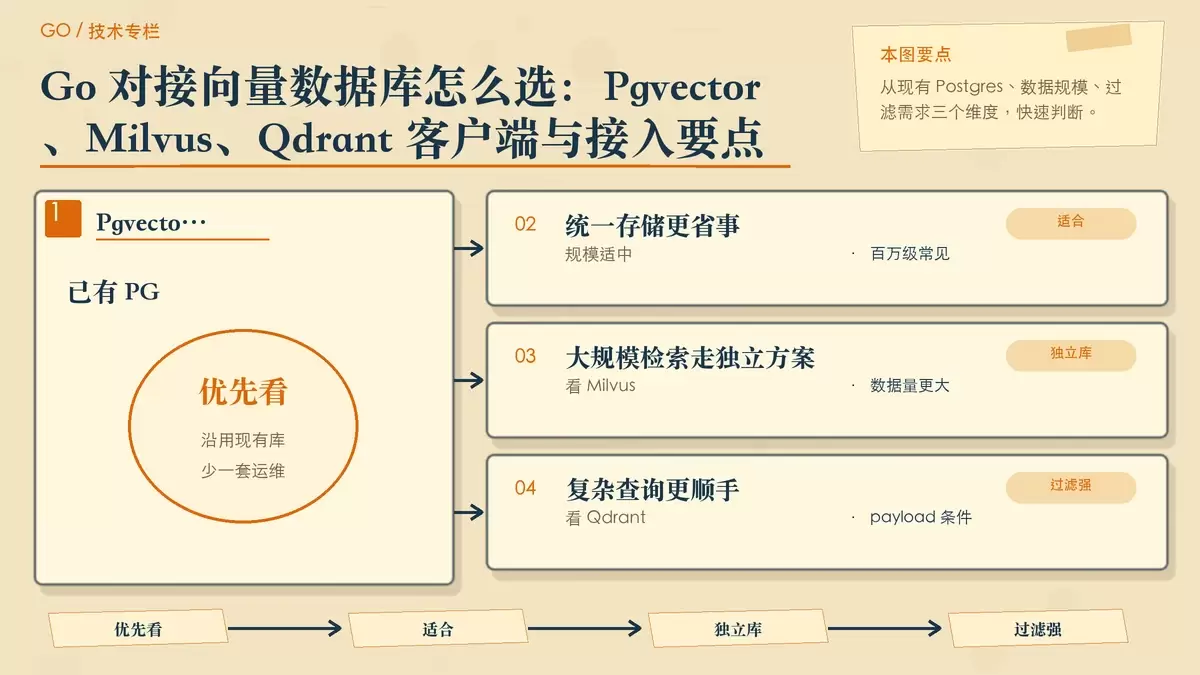
在 Go 项目里接入向量检索,常见路线通常落在 Pgvector、Milvus 和 Qdrant 三种方案。它们分别对应“沿用 Postgres”“独立扩展大规模向量库”“更重视过滤与多向量能力”三类需求,客户端使用方式和接入成本也差异明显。
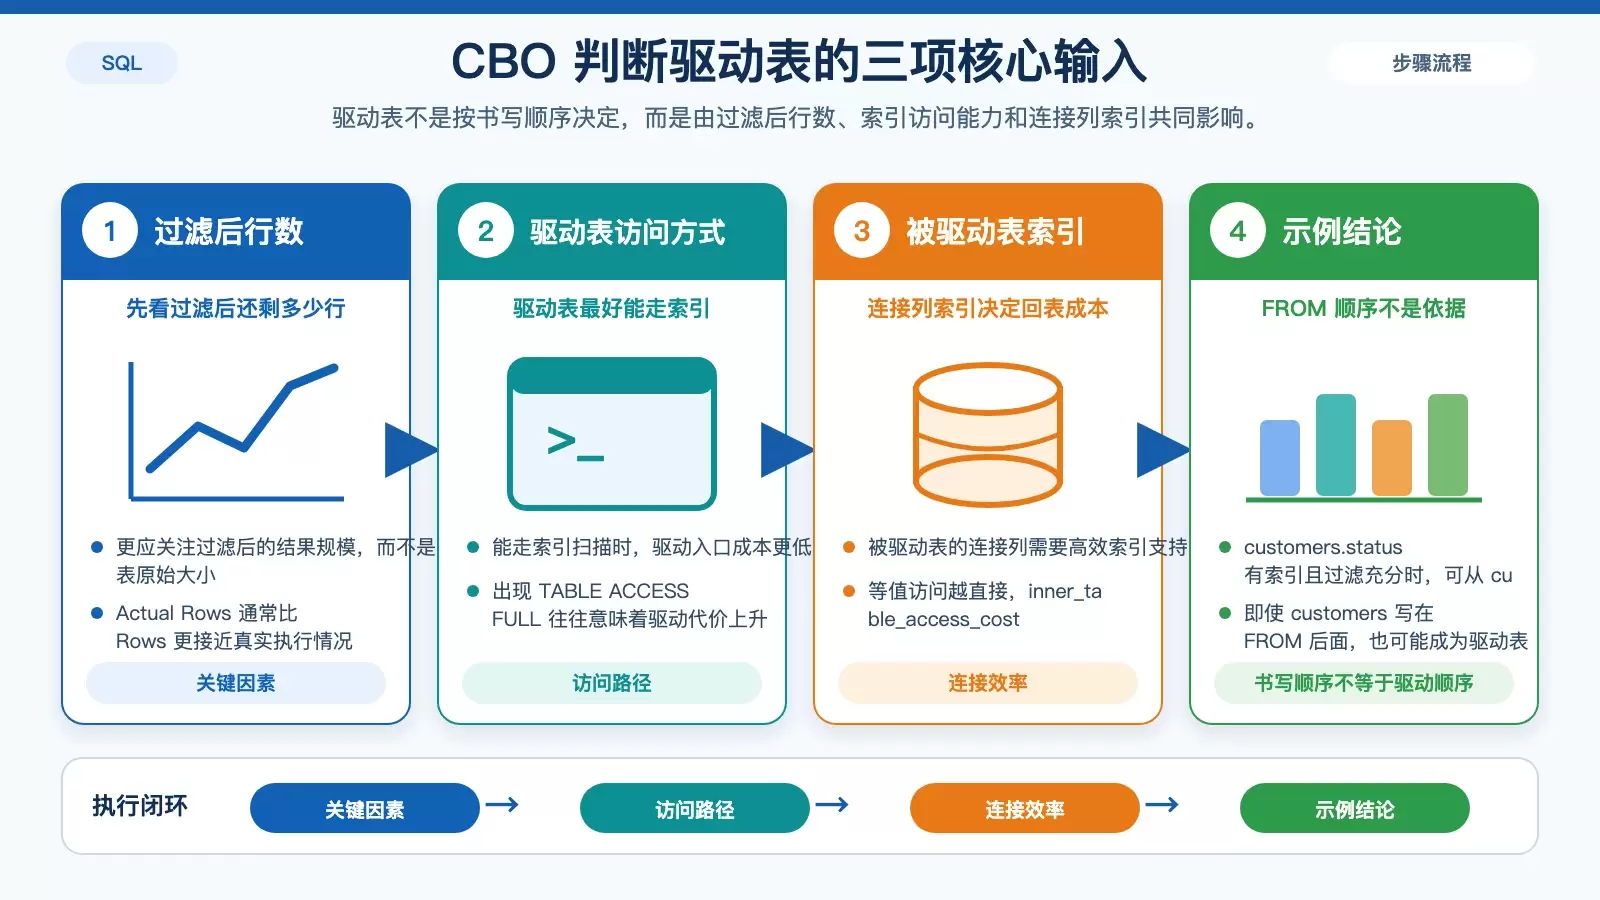
Oracle 19c 里的 SQL JOIN 驱动表并不是按 FROM 顺序决定,而是 CBO 根据统计信息、索引和过滤后行数计算成本后自动推导。本文从驱动表判断逻辑、LEADING 与 ORDERED 的差异、LEFT JOIN 的限制,以及执行计划验证方法四个方面,梳理实际调优时真正能动手的关键点。