


很多业务都会遇到同一个问题:一条数据既要写进数据库,又要同步到 Kafka、缓存或其他下游系统,流程看似简单,真正困难的是一旦中间某一步失败,两个系统的数据就可能对不上。本文从常见的三种双写路径入手,分别说明它们适合什么场景、会带来什么代价,再落到 Lindorm 数据订阅的能力上,帮助你判断什么时候该用 DB->Binlog->Kafka 这一类方案。
双写问题到底难在哪里
所谓双写问题(Dual Write Problem),是指一次业务更新需要同时修改两个独立系统,例如 Database 和 Kafka,或者 Database 和缓存。在这种场景下,应用并不只是“多发一次请求”这么简单,而是要处理成功顺序、失败补偿、读取时效和下游消费之间的一致性问题。
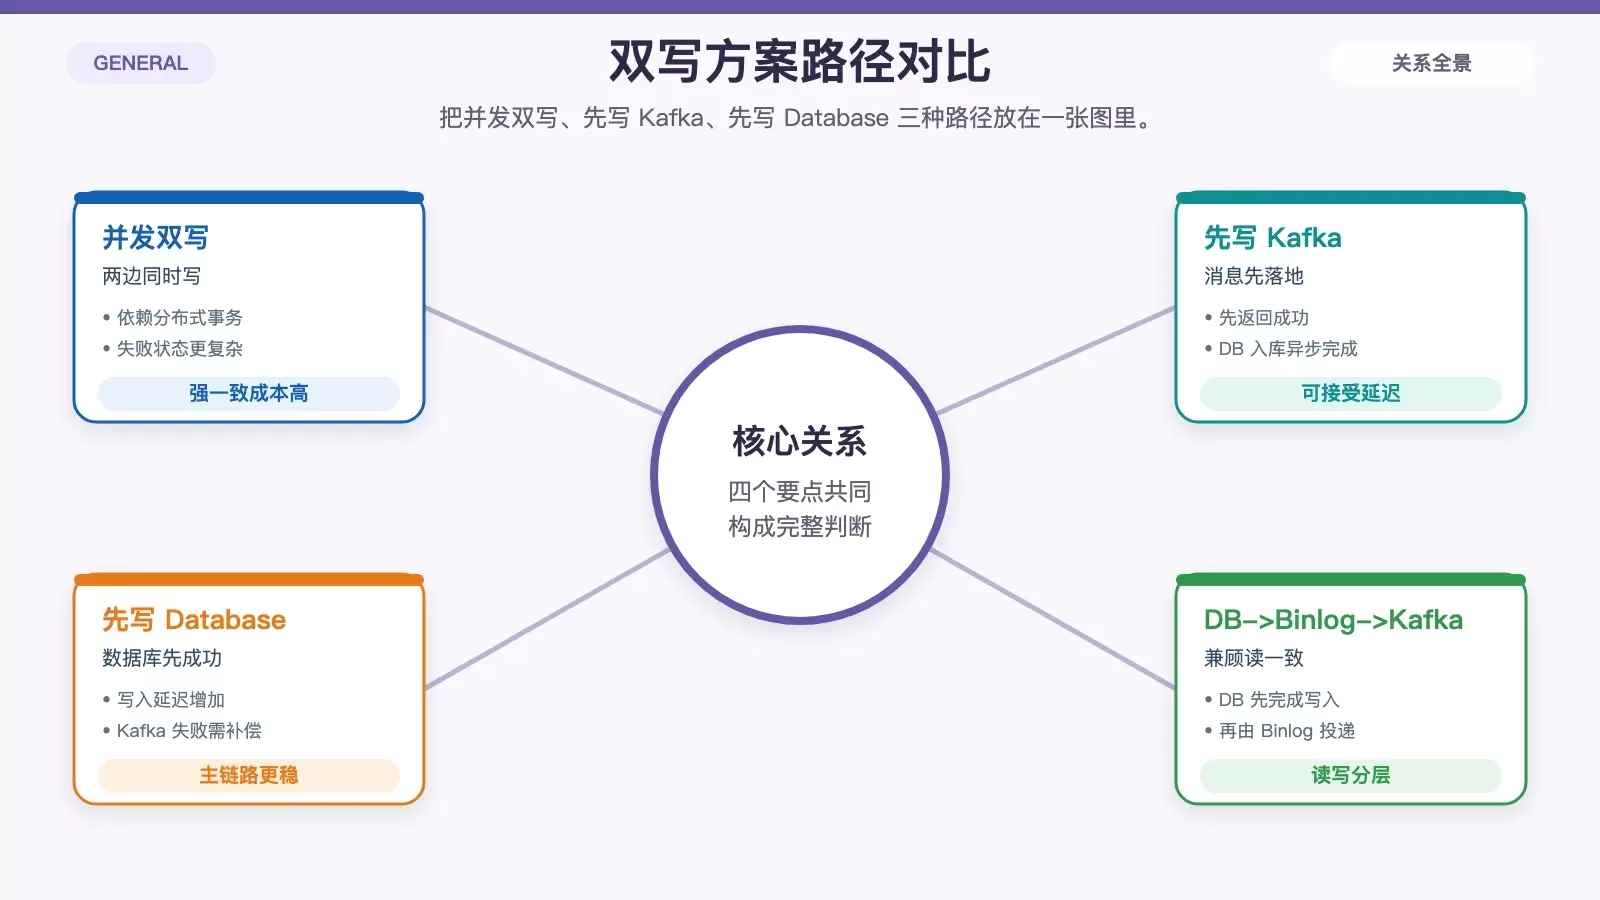
以 Database 和 Kafka 为例,常见做法通常有三种:
- 并发写 Database 和 Kafka
- 先写 Kafka,再写 Database
- 先写 Database,再写 Kafka
三种方式都能工作,但代价完全不同,关键在于你的业务究竟更在意强一致、最终一致,还是两者并存。
三种常见双写方案,各自的问题是什么
并发写 Database 和 Kafka
如果应用同时把数据写到 Database 和 Kafka,看上去延迟可能较低,但前提是系统要有能力处理两个独立写入之间的原子性。否则,一边成功、一边失败时,不一致情况会非常复杂,甚至 Database 和 Kafka 都可能没有一份完整数据。
因此,这种方式通常需要分布式事务来支撑强一致。如果没有分布式事务,问题就不会停留在“重试一下”这么简单,而会变成系统级的数据修复问题。
先写 Kafka,再写 Database
第二种做法是先写 Kafka,成功后先向客户端返回成功,再由下游订阅 Kafka 消息,把数据异步写入 Database,从而实现最终一致性。
这种方式的优点是天然适合消息驱动架构,但缺点也很直接:Database 的数据落地会有延迟,不适合要求强一致读取的业务。
文中的两个典型例子就很说明问题:
- 账单已经写入成功,但客户短时间内还查不到;
- 实时归因场景里,Flink 实时消费 Kafka,遇到交易事件后去反查 DB 做归因,但关键数据此时可能尚未入库。
也就是说,这种方案适合“整体都能接受最终一致”的系统,而不适合对数据库即时可读有明确要求的链路。
先写 Database,再写 Kafka
第三种方式是串行写入:先写 Database,再写 Kafka,全部成功后再返回客户端成功。这比并发双写更容易理解,也更符合很多业务“先落库再分发”的直觉。
但它的问题同样明显:
- 整体写入延迟会增加,因为客户端需要等待两次写入完成;
- 如果 Database 成功、Kafka 失败,补偿逻辑会变得棘手。
这也是很多团队最后会引入 Binlog(或者 WAL)思路的原因:先把数据可靠写入 Database,客户端在数据库写成功后即可拿到成功结果;随后再订阅 binlog,并把变更投递到 Kafka,让下游继续消费。
于是流程就变成了:DB->Binlog->Kafka。
这条路径的价值在于,它把“主链路写入成功”和“下游异步分发”拆开处理:一方面保证 Database 上的强一致读,另一方面通过后续投递实现最终一致性。
怎么按业务场景做决策
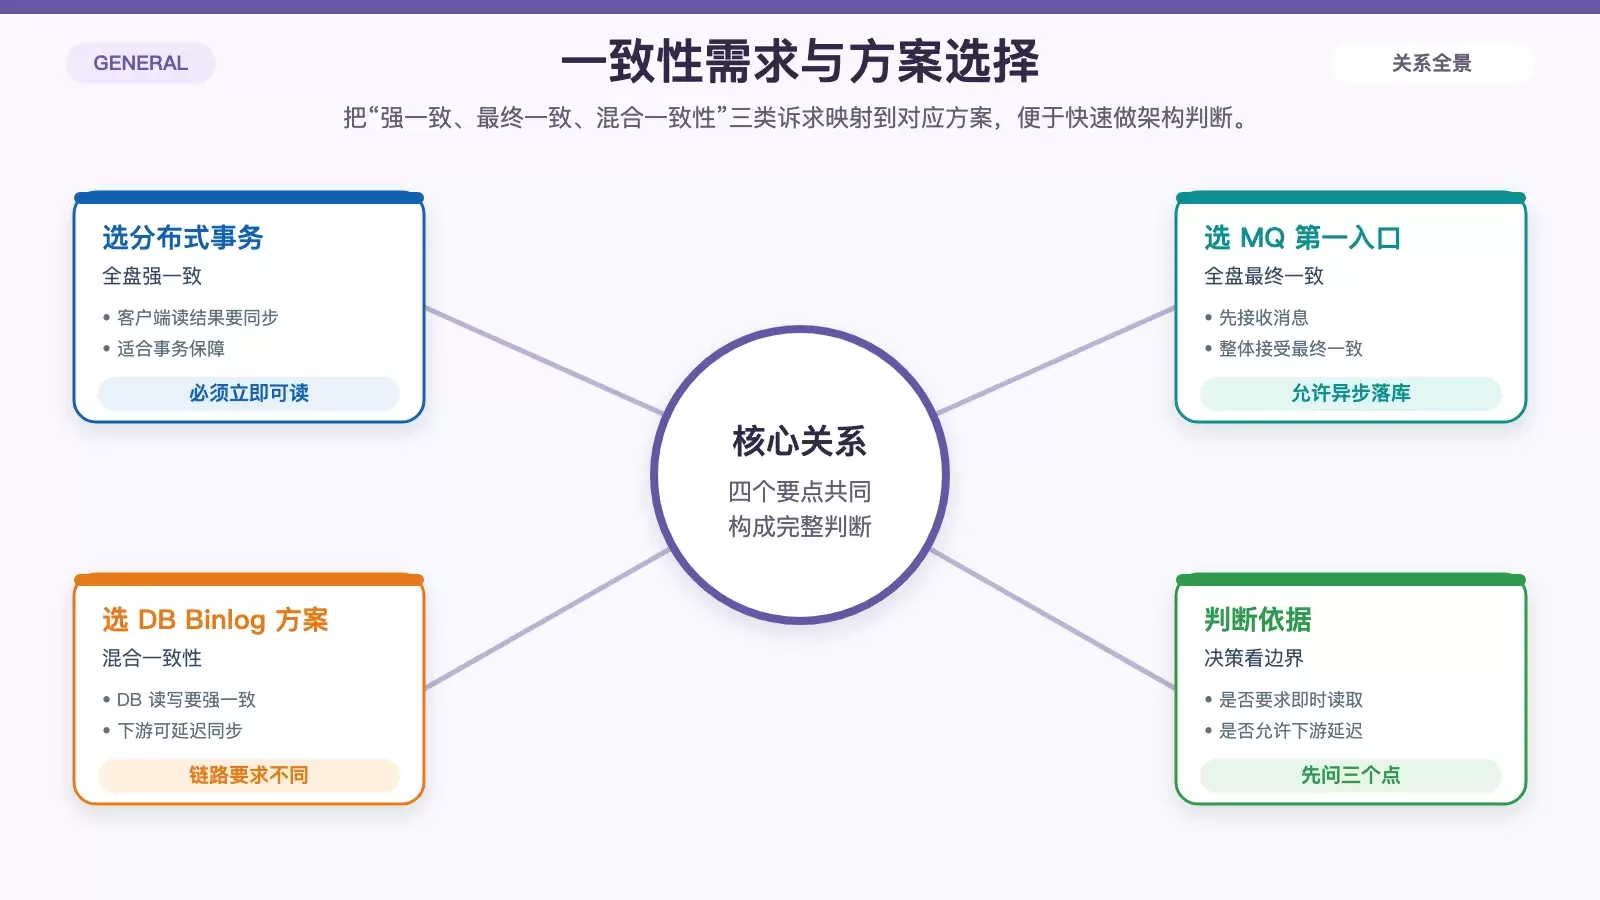
双写方案没有绝对标准答案,更合理的判断方式,是先确认业务到底需要哪一种一致性体验。
- 如果业务要求全盘强一致体验,应选择分布式事务。
- 如果业务整体倾向最终一致体验,可以选择以 MQ 为第一入口,让消息先行。
- 如果业务同时存在不同层级的一致性需求,更适合先保证 Database 的强一致读写,再通过 DB binlog 满足下游最终一致。
这三类判断标准,本质上对应的是三个问题:客户端是否必须立即读到结果、下游是否允许延迟、系统是否愿意承担分布式事务的复杂度。只要这三个问题明确,方案通常不会选错。
Lindorm 数据订阅能解决什么问题
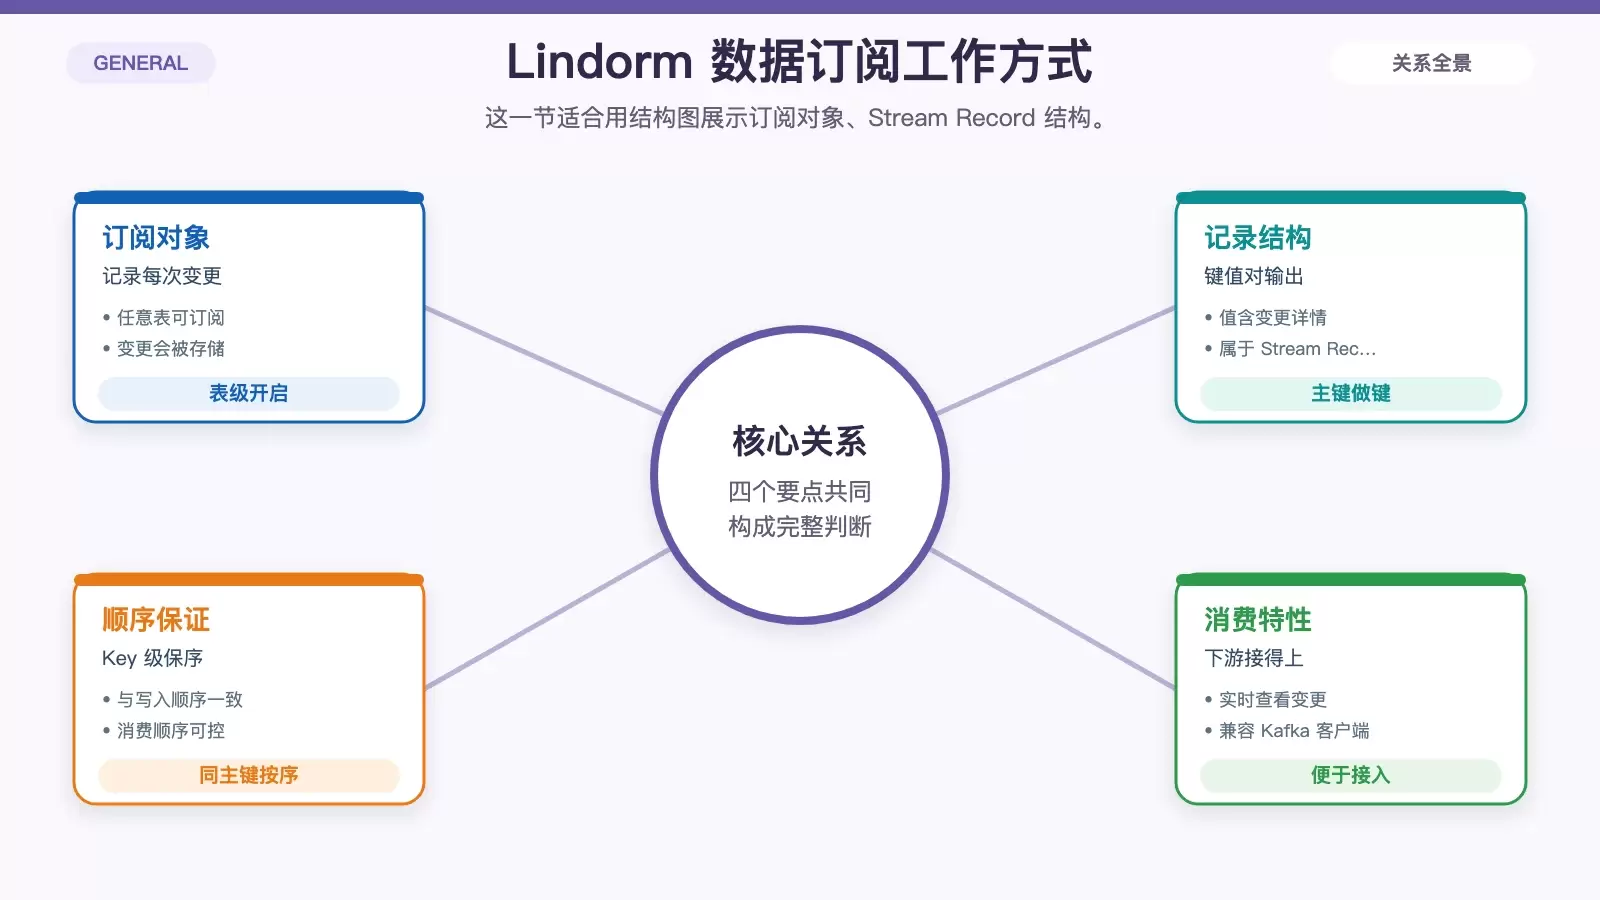
Lindorm 数据订阅可以看作是对 DB->Binlog->Kafka 方案的进一步产品化能力补充。它面向云原生多模数据库 Lindorm,支持对任意一张表的每条数据变更进行订阅,让客户端可以实时、有序地查看变更记录。
当你为某张表开通数据订阅功能后,这张表后续的变更操作都会被存储下来。为了保证消费顺序与写入顺序一致,Lindorm 数据订阅提供了主键级别保序能力,也就是同一主键上的更新,会按更新顺序存储和消费。
每次对 Lindorm 表执行增删改操作时,数据订阅都会生成一个 Stream Record 键值对:
- 键是这一行数据的主键;
- 值包含此次操作的详细信息,例如操作前的值、操作后的值、时间戳、操作类型。
这意味着,下游系统拿到的不只是“发生了一次变更”,而是一份足够完整的变更事件记录,便于继续做同步、分发、审计或流式处理。
Lindorm 数据订阅的几个关键特点
从原文给出的信息看,Lindorm 数据订阅至少有三项很实用的特点:
- 实时订阅:表数据发生变更后,可以被实时消费,适合事件驱动链路。
- 100% 兼容 Kafka 客户端:已有 Kafka 生态和消费方式可以较平滑接入,减少迁移成本。
- Key 级别保序:同一主键的更新按顺序存储和消费,更适合依赖顺序语义的业务。
如果你的业务正好处在“数据库必须先写成功、下游又要持续订阅变更”的场景里,那么 Lindorm 数据订阅提供的就不是单纯的消息通道,而是一套更贴近数据库变更传播的机制。
换句话说,它更适合那些不愿在主链路里直接承担双写复杂度,但又需要把数据库变更稳定送往下游消费体系的系统。









