


很多人第一次接触 Redis 时,都会把它的高性能简单归因于“单线程”。但真正决定它能否在高并发下稳住吞吐的,是背后的 I/O 多路复用和事件驱动模型。本文从“它到底怎么同时盯住那么多连接”讲起,再落到 Redis 的 Reactor 结构和 ae.c 中的 epoll 示例代码,帮助你把概念、流程和实现对应起来。
为什么 Redis 能用单线程扛住大量连接
Redis 的高性能,很大程度上来自 I/O 多路复用。它不是为每个连接都创建一个线程,而是在单个线程里同时监听多个套接字;一旦某个套接字已经准备好读取或写入,Redis 就立刻处理对应事件。
这种做法的关键价值在于:把“等待网络数据到来”的成本交给操作系统,把真正的业务处理集中在少量活跃连接上。这样既减少了线程资源消耗,也避免了频繁上下文切换带来的额外开销。
I/O 多路复用到底是怎么工作的
I/O 多路复用允许单个线程监视多个文件描述符或套接字。当某个连接进入可读、可写或异常状态时,操作系统通知应用程序,应用程序再执行对应的读取、写入或错误处理逻辑。
在 Redis 这样的网络服务里,它的工作方式可以拆成 5 个步骤:
- 监听多个通道:服务器把多个客户端连接作为被监听对象,这些通道通常就是
socket。 - 监控状态变化:系统持续关注这些连接是否可读、可写,或者是否出现异常。
- 事件通知:当某个连接满足应用程序设定的条件时,操作系统把事件交回来。
- 事件处理:应用程序根据事件类型调用处理函数,例如读取客户端请求、写回响应数据。
- 非阻塞操作:这些连接通常会设置成非阻塞模式;如果数据暂时不可读或不可写,调用会立即返回,而不是卡住线程。
这也是它和传统“一连接一线程”模型的根本区别:线程不再被单个连接拖住,而是始终围绕“谁准备好了就先处理谁”来运转。
select、poll、epoll、kqueue 有什么区别
Redis 并不是自己发明了一套监听机制,它依赖的是操作系统提供的 I/O 多路复用能力。常见实现主要有 select、poll、epoll 和 kqueue。
select
select是最早期的 I/O 多路复用技术之一。- 它可以监视一组文件描述符,判断它们是否处于可读、可写或异常状态。
- 它的典型限制在于使用固定大小的位集合来跟踪文件描述符,因此可监视数量存在上限。
poll
poll和select的思路相近。- 区别在于它不受最大文件描述符数量上限的直接限制。
poll使用动态分配的数组来跟踪文件描述符,而不是固定大小的位集合。
epoll
epoll是 Linux 提供的高效事件通知机制。- 它不需要每次调用时都重复传递整组文件描述符,而是在初始化时创建一个
epoll实例,再通过接口增删监听对象。 - 由于使用内核数据结构跟踪状态变化,
epoll在大量文件描述符场景下通常更高效。
kqueue
kqueue是 BSD 系统上的高效事件机制,常见于 macOS 和 FreeBSD。- 它支持注册并处理多种类型的事件,不仅包括文件描述符事件,也包括定时器事件等。
如果只看 Redis 的常见部署环境,Linux 上最常提到的是 epoll;但从设计上说,Redis 的事件框架本身会根据平台能力选择合适的底层实现。
一个事件循环会经历哪些步骤
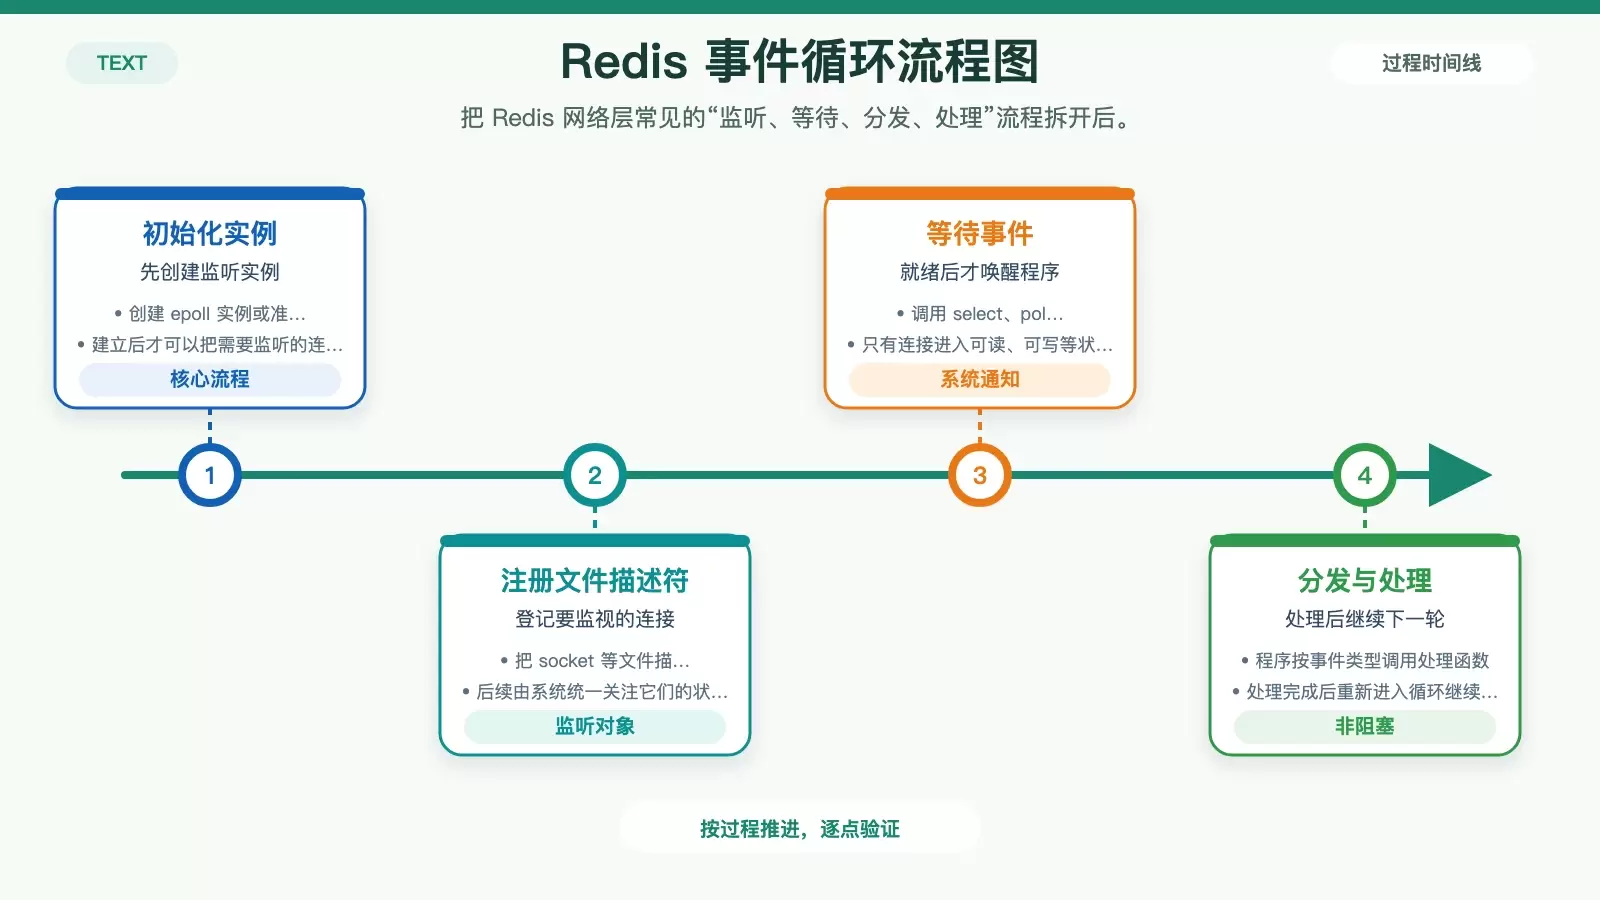
从程序运行角度看,I/O 多路复用一般会围绕一个持续循环展开,Redis 也不例外。这个循环通常包含以下阶段:
- 初始化:创建一个 I/O 多路复用实例,例如建立一个
epoll实例,或者准备一次select调用所需的数据结构。 - 注册文件描述符:把需要监听的文件描述符添加进去。
- 等待事件:调用
select、poll、epoll_wait或kevent,等待事件发生。 - 处理事件:事件返回后,程序按类型调用对应处理函数。
- 继续循环:处理完成后回到等待阶段,持续监听新的网络事件。
对高性能网络服务器来说,核心并不只是“能等到事件”,而是“能用尽量低的额外成本管理大量空闲连接,只把 CPU 花在真正活跃的连接上”。
Redis 的 Reactor 模式是怎么落地的
Redis 的高性能网络事件处理器,本质上就是一个基于 Reactor 模式的事件驱动系统。它通过非阻塞 I/O 多路复用,同时监控多个套接字,并在套接字准备好执行读取或写入时调用相应的处理器。
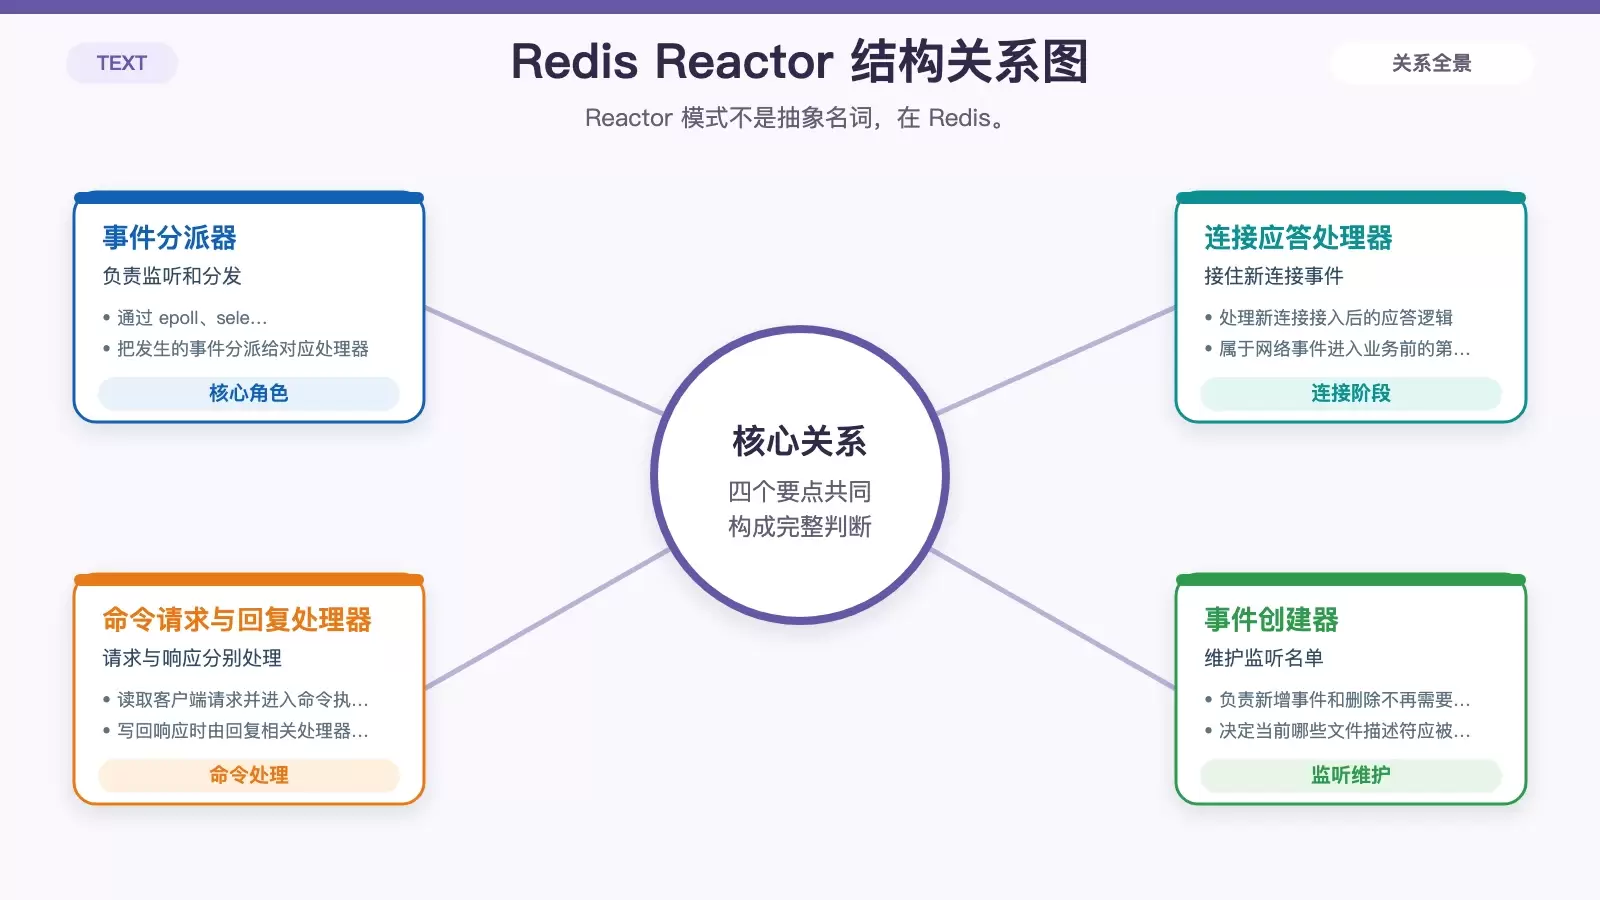
Reactor 的三个核心角色
- 事件分派器(Reactor):负责监听和分发事件。在 Redis 中,这一层通过
epoll、select、kqueue等机制监控多个套接字,再把发生的事件分派给对应处理器。 - 事件处理器:负责真正执行逻辑,例如读取客户端请求、发送命令响应。文中提到的处理器包括连接应答处理器、命令请求处理器和命令回复处理器。
- 事件创建器:负责新增事件、删除事件,维护当前哪些文件描述符需要被监听。
这种结构的好处是职责清晰:分派器负责“发现谁有事”,处理器负责“具体怎么做”,事件创建器负责“监听名单怎么维护”。
从 ae.c 示例看 epoll 版 Reactor 流程
在 Redis 中,Reactor 模式的实现代码主要位于 ae.c。下面这段简化示例展示了使用 epoll 实现 Reactor 的基本工作流程:
int epfd = epoll_create1(0);
if (epfd == -1) {
    perror("epoll_create1");
    exit(EXIT_FAILURE);
}
struct epoll_event event, events[MAX_EVENTS];
// 设置事件
event.events = EPOLLIN | EPOLLET;
event.data.fd = STDIN_FILENO;
if (epoll_ctl(epfd, EPOLL_CTL_ADD, STDIN_FILENO, &event) == -1) {
    perror("epoll_ctl");
    exit(EXIT_FAILURE);
}
// 事件循环
while (1) {
    int nfds = epoll_wait(epfd, events, MAX_EVENTS, -1);
    if (nfds == -1) {
        perror("epoll_wait");
        exit(EXIT_FAILURE);
    }
    for (int n = 0; n < nfds; ++n) {
        if (events[n].events & EPOLLIN) {
            handle_read(events[n].data.fd);
        }
    }
}
close(epfd);
return 0;
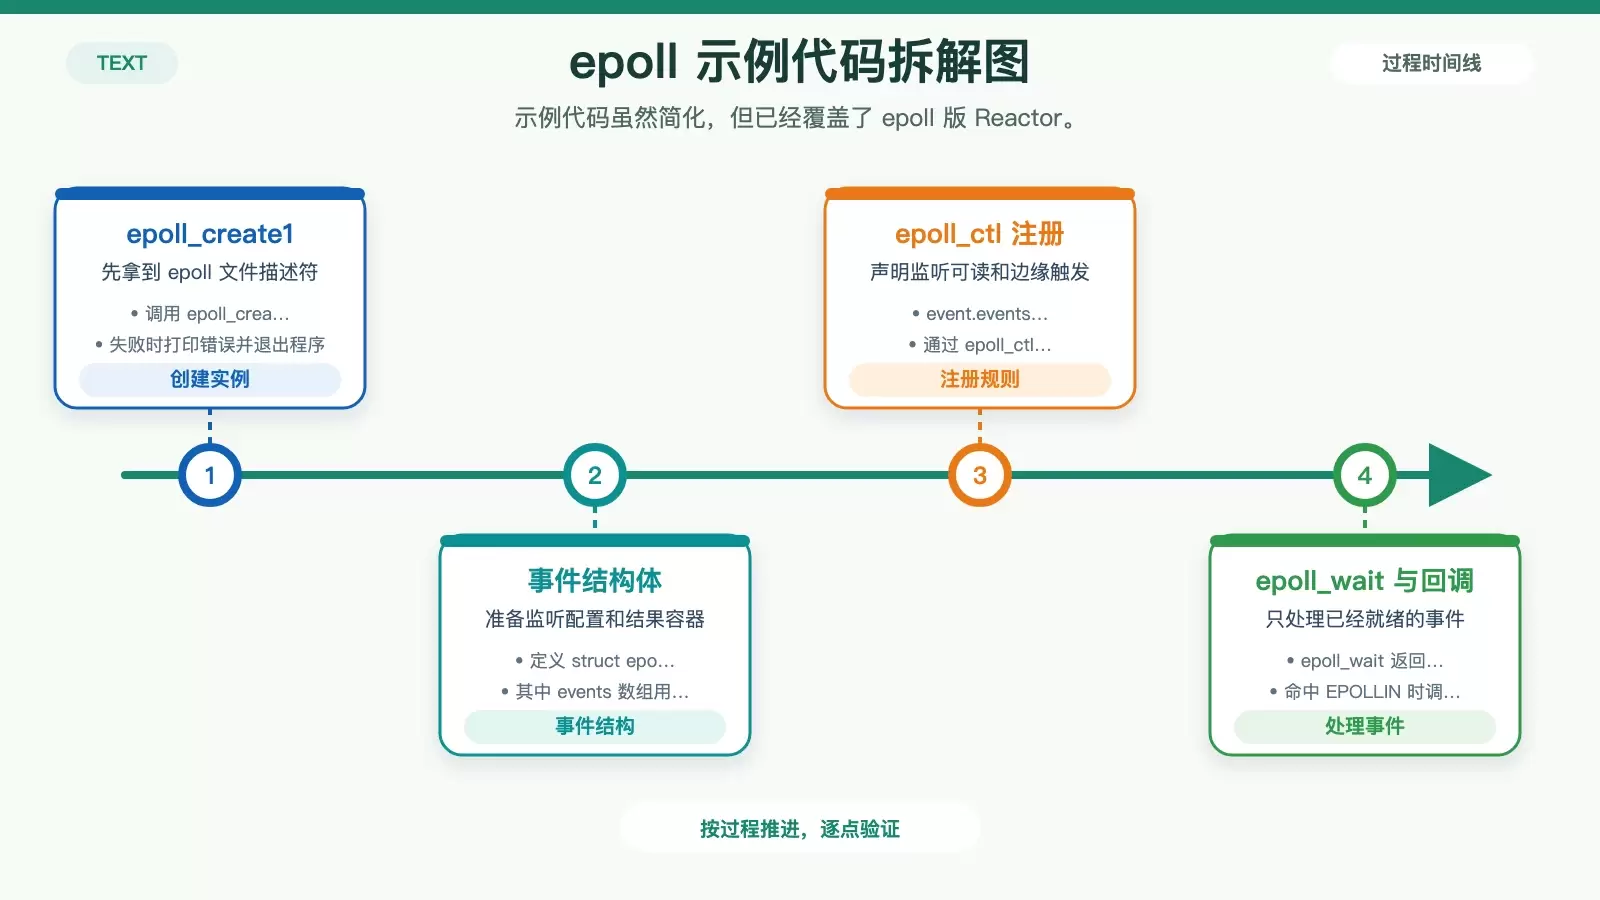
1. 创建 epoll 实例
int epfd = epoll_create1(0);
if (epfd == -1) {
    perror("epoll_create1");
    exit(EXIT_FAILURE);
}
epoll_create1(0)创建一个新的epoll实例,并返回文件描述符epfd。- 如果创建失败,就打印错误并退出。
2. 准备事件结构
struct epoll_event event, events[MAX_EVENTS];
struct epoll_event是epoll的基本事件结构。events数组用于接收epoll_wait返回的事件结果。
3. 注册要监听的事件
event.events = EPOLLIN | EPOLLET;
event.data.fd = STDIN_FILENO;
if (epoll_ctl(epfd, EPOLL_CTL_ADD, STDIN_FILENO, &event) == -1) {
    perror("epoll_ctl");
    exit(EXIT_FAILURE);
}
EPOLLIN表示监听可读事件。EPOLLET表示使用边缘触发(Edge Triggered)模式,也就是只在状态变化时收到通知。event.data.fd = STDIN_FILENO表示这里监听的是标准输入;实际网络程序中,通常会换成客户端连接对应的文件描述符。epoll_ctl用于把这个监听对象加入epoll实例。
4. 进入事件循环
while (1) {
    int nfds = epoll_wait(epfd, events, MAX_EVENTS, -1);
    if (nfds == -1) {
        perror("epoll_wait");
        exit(EXIT_FAILURE);
    }
    for (int n = 0; n < nfds; ++n) {
        if (events[n].events & EPOLLIN) {
            handle_read(events[n].data.fd);
        }
    }
}
epoll_wait会阻塞等待事件发生,返回本次就绪事件数量nfds。- 程序遍历返回的事件,判断它是否为
EPOLLIN可读事件。 - 一旦可读,就调用
handle_read处理读取逻辑。
5. 关闭实例并释放资源
close(epfd);
return 0;
- 关闭
epoll文件描述符,释放相关资源。
从这段示例能看出,Redis 事件处理的基本思想并不复杂:先把连接交给事件系统统一管理,再在循环中只处理那些已经就绪的连接。
为什么这种模型能让 Redis 保持高性能
把原理和代码对上之后,Redis 的性能来源就更容易理解了:
- I/O 多路复用:通过
epoll等机制,单个线程可以同时监听多个文件描述符,从而高效处理并发连接。 - 事件驱动:只有当某个文件描述符状态发生变化,例如数据可读时,程序才会被唤醒处理。
- 边缘触发模式:示例中的
EPOLLET只在状态变化时通知应用程序,减少不必要的重复通知。 - 单线程处理:避免了多线程环境中的频繁上下文切换和同步开销,也让执行路径更容易保持简单。
原文还提到一点需要单独看待:Redis 6.0 引入了多线程来处理客户端请求和回复,但这并不意味着它放弃了事件驱动和 I/O 多路复用。更准确地说,多线程是在既有网络模型基础上的补充优化,而不是把架构改成传统的“一连接一线程”。
文中提到的性能优化项,应该怎么理解
原文最后列出了一组“性能优化”建议,不过这里混入了 Lettuce 客户端层面的内容,需要和 Redis 服务端 I/O 模型区分开看。
- 连接池配置:合理配置连接池大小,主要影响客户端如何复用连接,应对并发访问。
- 使用 Pipeline:通过 Pipeline 批量发送命令,减少网络往返次数。
- 集群支持:在 Redis 集群环境中,客户端配置是否正确,会直接影响请求分发和访问效率。
- 监控和调优:通过监控工具持续观察性能指标,再根据结果调整配置。
这几项并不是 Redis 的 I/O 多路复用机制本身,而是面向客户端使用方式和整体系统调优的补充建议。把这两层分开理解,才不容易把“Redis 为什么快”和“应用怎么把 Redis 用好”混为一谈。
总结
Redis 能在单线程模型下高效处理大量并发连接,核心原因不是“线程少”,而是借助 I/O 多路复用和 Reactor 模式,把大量连接交给一个事件循环统一管理。这样可以减少线程切换和资源消耗,把 CPU 主要用在已经就绪的连接上。
如果你要判断 Redis 的网络层为什么高效,可以抓住三个关键词:非阻塞、事件驱动、I/O 多路复用。它们共同构成了 Redis 高性能的底层基础,而 epoll、kqueue 这样的系统能力,则是这套模型在不同平台上的具体落点。









