

Python爬虫常用第三方库对比:Requests与Scrapy怎么选
深入对比Python爬虫开发中两大主流工具Requests与Scrapy的核心差异、运行机制、代码实现与工程边界,提供基于实际应用场景的清晰选型依据与决策路径。
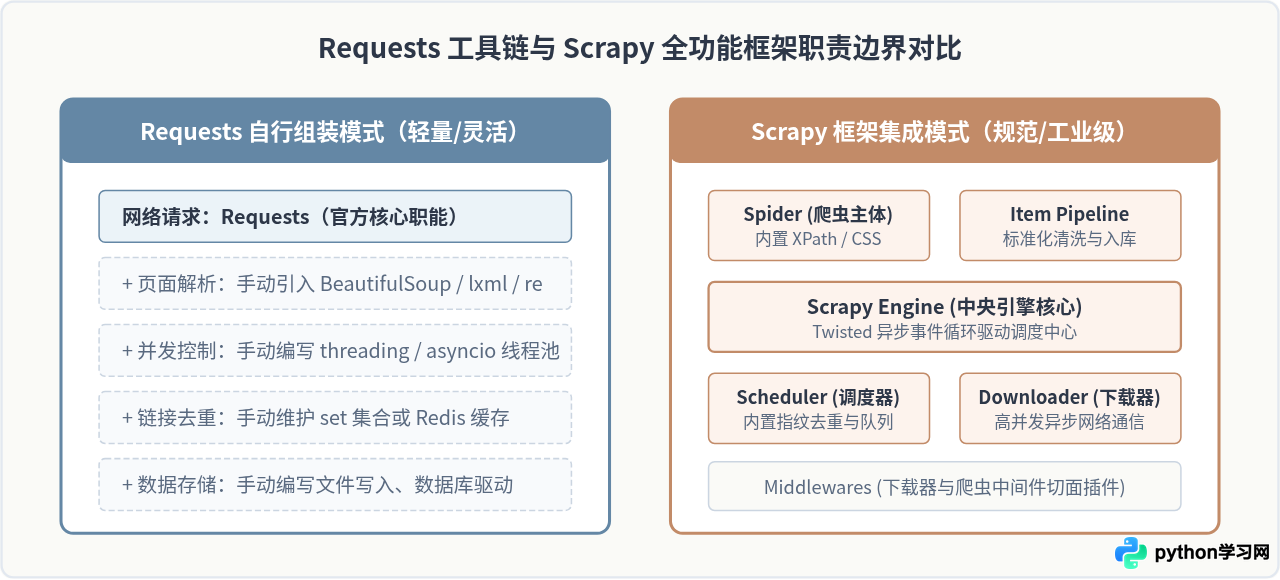
在 Python 爬虫开发中,面对形形色色的网页与数据抓取任务,选择工具的核心判断依据非常直接:如果目标是几十个规则简单的网页、结构明确的 JSON 数据接口,或者需要将采集功能随手嵌入某个日常自动化脚本中,选用 Requests 搭配轻量解析库是成本最低、启动最快的方案;如果目标涉及成千上万个链接的网状爬取、要求严格的并发速率与请求排队、需要避免重复抓取并持续落库,选用 Scrapy 框架在性能保障、容错机制和工程可维护性上具备压倒性优势。本文将围绕两者的本质区别、运行机制、开发实施及应用边界展开具体对比,帮助读者根据实际任务条件作出明确的技术选择。
一、定位差异与核心设计理念
很多初学者容易将 Requests 与 Scrapy 放在同一维度比较,但两者在软件工程中的定位截然不同。弄清两者的边界,是避免选型失误的前提。
Requests 的本质是一个专注于 HTTP 协议通信的基础客户端库。 它的设计理念是“HTTP for Humans”,即用极简、符合直觉的 API 解决网络数据收发问题。Requests 仅负责建立连接、处理请求头、发送数据并接收服务端的原始响应体。它本身不关心响应内容是 HTML、JSON 还是二进制文件,也不提供任何解析、提取、存储或爬取链路控制功能。若要完成一个完整的爬虫,开发者必须自行组装解析库(如 BeautifulSoup、lxml)、网络并发调度逻辑以及本地存储模块。
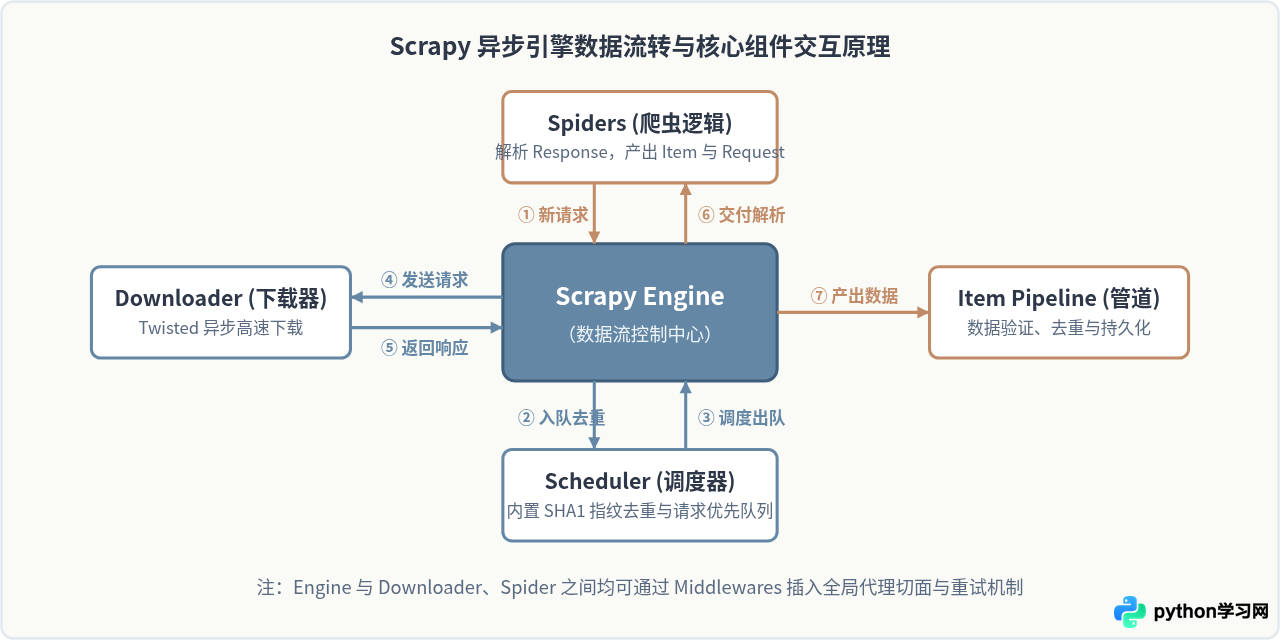
Scrapy 的本质是一套工业级网络爬虫应用框架。 它基于 Python 的 Twisted 异步网络引擎构建,提供了一整套标准化的爬取生命周期管理机制。Scrapy 内部预置了请求调度器(Scheduler)、异步下载器(Downloader)、数据提取选择器(Selectors)、爬虫切面中间件(Middlewares)以及数据处理管道(Item Pipeline)。使用 Scrapy 时,开发者不需要重复编写网络通信与循环调度的基础代码,而是按照框架规范,专注于提取规则和清洗逻辑。
二、Requests 方案:轻量任务的实施流程与代码实现
当抓取需求明确、目标页面少于数百页、或数据直接由结构化 API 提供时,使用 Requests 是最自然的选择。其典型实施链路遵循直观的线性过程:构建请求参数、发起同步 HTTP 请求、检查返回状态、解析内容并输出保存。
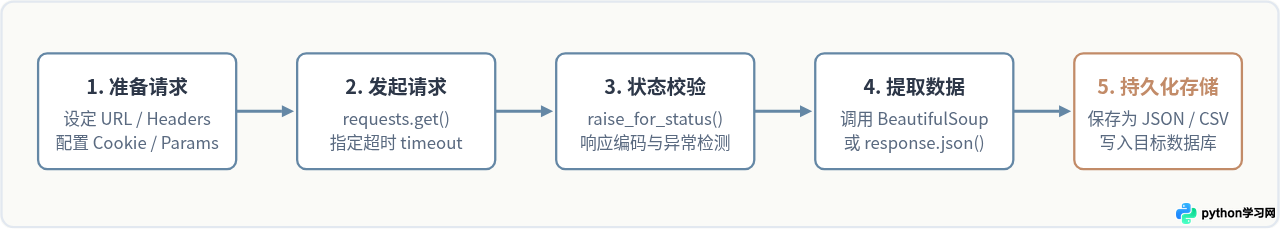
下面是一个使用 Requests 抓取书籍示例网站标题与价格的完整脚本:
import requests
from bs4 import BeautifulSoup
import csv

def fetch_book_quotes(page_num=1):
    url = f"https://books.toscrape.com/catalogue/page-{page_num}.html"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    try:
        # 发起 HTTP GET 请求,设置 10 秒超时
        response = requests.get(url, headers=headers, timeout=10)
        response.raise_for_status()  # 若状态码非 200 则抛出异常
        response.encoding = response.apparent_encoding
    except requests.exceptions.RequestException as e:
        print(f"请求发生异常: {e}")
        return []

    # 配合 BeautifulSoup 解析 HTML
    soup = BeautifulSoup(response.text, "html.parser")
    books = []

    for article in soup.select("article.product_pod"):
        title_tag = article.select_one("h3 > a")
        price_tag = article.select_one(".price_color")
        if title_tag and price_tag:
            books.append({
                "title": title_tag.get("title", title_tag.text.strip()),
                "price": price_tag.text.strip()
            })
    return books

# 保存结果至 CSV 文件
data = fetch_book_quotes(1)
if data:
    with open("books.csv", "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=["title", "price"])
        writer.writeheader()
        writer.writerows(data)
    print(f"采集完成,已保存 {len(data)} 条数据至 books.csv")
Requests 的代码直观、易于单步断点调试。但当爬取页面数量上升至成千上万、且需要按深度持续提取下一页链接时,单纯使用 Requests 就会遇到瓶颈:网络 IO 是同步阻塞的,若手动使用线程池并发,则必须自行设计线程安全的 URL 去重机制、失败请求重试队列与文件写入锁,代码复杂度会迅速失控。
三、Scrapy 方案:工程化规模爬取的运作原理与实践
面对大规模采集需求,Scrapy 的优势在于其内置的事件驱动模型。Scrapy 基于 Twisted 异步网络库,所有请求都在单线程事件循环中非阻塞派发,不需要为每个网络连接分配系统线程,从而能够以极低的内存开销维持数百甚至上千的并发网络连接。
Scrapy 项目的标准组织与核心代码
Scrapy 采用命令行工具管理工程。开发者在命令行中执行以下命令生成项目骨架:
# 1. 创建项目
scrapy startproject book_crawler

# 2. 生成爬虫模板
cd book_crawler
scrapy genspider books books.toscrape.com
在生成的 spiders/books.py 中,开发者只需定义抓取规则和翻页逻辑,请求调度与异常重试由引擎自动接管:
import scrapy

class BooksSpider(scrapy.Spider):
    name = "books"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/page-1.html"]

    def parse(self, response):
        # 使用 Scrapy 内置 CSS 选择器提取当前页数据
        for article in response.css("article.product_pod"):
            yield {
                "title": article.css("h3 a::attr(title)").get(),
                "price": article.css(".price_color::text").get(),
            }

        # 自动提取下一页 URL 并交给调度器
        next_page = response.css("li.next a::attr(href)").get()
        if next_page:
            # urljoin 处理相对路径并生成新的 Request
            yield response.follow(next_page, callback=self.parse)
在终端中直接运行该爬虫,并指定输出为 JSONLines 格式:
scrapy crawl books -o books.jsonlScrapy 会自动打印并发统计、下载字节数、抓取成功率,并在后台利用内置的 SHA1 指纹算法过滤已经爬过的页面,彻底解决死循环递归抓取的问题。
四、全方位核心维度深度对比
为了给实际工程选型提供确切支撑,下面从性能并发、扩展机制、反爬治理以及开发维护成本四个关键维度展开对比:
| 对比维度 | Requests 方案 | Scrapy 框架 |
|---|---|---|
| 并发模型 | 默认单线程同步阻塞;需自行集成 ThreadPoolExecutor 或 gevent,高并发下线程切换损耗大。 |
基于 Twisted 异步事件驱动,单进程可轻松维持数百并发连接,吞吐量极高。 |
| 链接追踪与去重 | 无内置机制;需开发者自行编写哈希去重集合、深度/广度遍历队列。 | 内置 Scheduler,基于请求指纹算法自动去重,原生支持优先级队列与断点续爬。 |
| 数据处理与落库 | 手动在业务代码中写入文件或连接池;缺乏结构化管道规范。 | 内置 Item Pipeline,提供标准化验证、丢弃无用数据、批量存储与异步入库机制。 |
| 中间件与切面扩展 | 通过 Session 或封装装饰器实现;针对不同请求的定制略显分散。 | 提供 Downloader Middleware,可在全局统一拦截请求,动态轮换 User-Agent、挂载代理 IP。 |
| 学习曲线与调试 | 极低;5 分钟即可上手,直接支持标准 pdb 或 IDE 断点调试。 |
中等偏高;需理解 Twisted 异步生命周期、信号机制、回调逻辑与配置文件体系。 |
| 工程复杂度 | 轻量直接;单文件脚本即可运行,适合零散任务和快速验证。 | 规范化工程;包含规范的目录结构、配置项与扩展接口,适合团队协作与长期演进。 |
五、选型决策路径与实用建议
在面对具体业务需求时,切忌盲目追求框架的庞大,也不要因贪图简单而陷入不断打补丁的泥潭。我们可以通过一条清晰的决策路径来锁定最适合的工具:
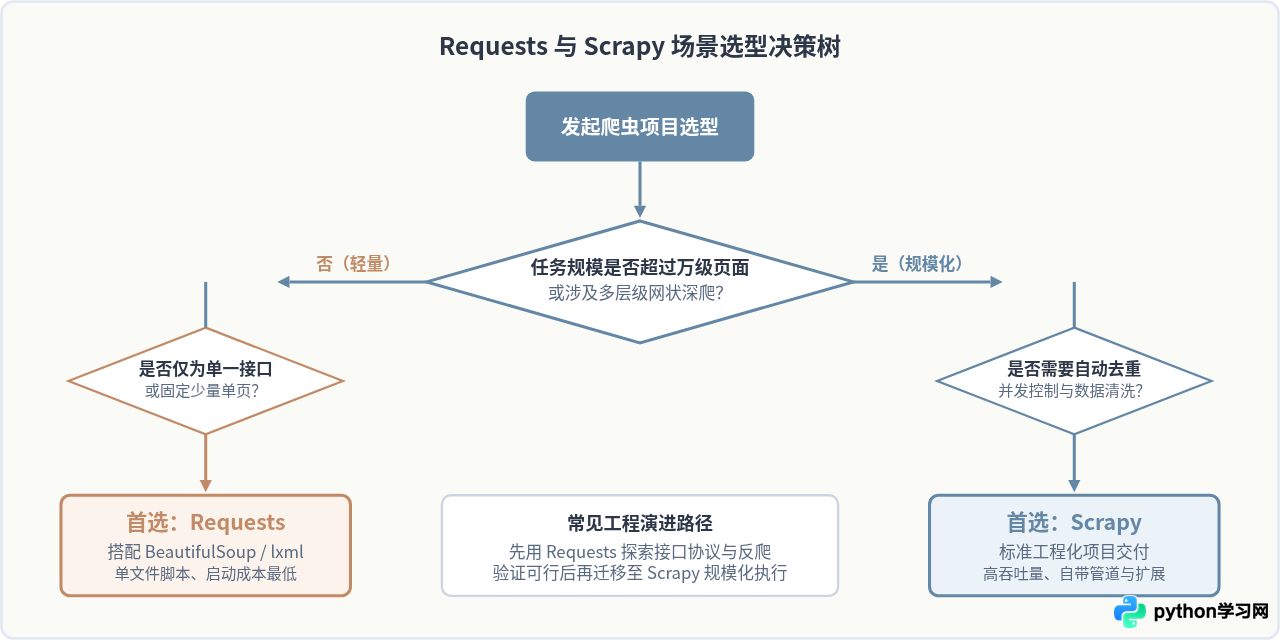
1. 坚定选择 Requests 的典型场景
- 接口逆向分析与探路:在研究某个网站的加密参数、登录凭据或签名算法时,Requests 配合交互式环境(如 Jupyter Notebook 或 IPython)能实现随改随跑、即时查看响应头,调试效率远高于框架。
- 单点定时数据同步:例如每天早晨定时抓取汇率接口、天气数据、或某个内部系统的报警状态并推送到企业微信机器人,编写一个几十行的独立
.py脚本最为清爽,没有额外的框架包袱。 - 作为已有系统的内部模块:如果正在开发一个 Web 后台系统(基于 Django 或 FastAPI),需要在特定业务动作下同步调用外部网站拉取一条数据,直接引入 Requests 是最轻量的解法。
2. 坚定选择 Scrapy 的典型场景
- 垂直领域全站爬取:例如电商全品类商品监控、新闻资讯全站归档、房产交易平台历史挂牌数据采集。这类任务的页面规模通常在十万甚至百万级别,必须依靠 Scrapy 的异步并发能力和自动去重机制。
- 结构复杂的深层爬取:从分类索引页出发,逐层下钻到子分类列表,再进入详情页,并从详情页提取相关推荐链接继续深入。Scrapy 的
response.follow和回调函数设计能够优雅地解耦各级页面逻辑。 - 需要统一管理代理与风控:面临频繁封禁 IP、需要随机轮换 User-Agent、自动化重试 403/503 错误的场景,在 Scrapy 中只需编写一个 Download Middleware 即可对全站所有爬虫统一生效,无需侵入抓取业务代码。
- 团队长期协作开发:Scrapy 强制的 Item、Spider、Pipeline 分离规范,使得不同开发者编写的代码风格高度统一,新成员可以快速接手老项目的维护和规则变更。
六、常见认知误区与规避建议
在实际选型与开发中,开发者常常会产生以下两个误区:
误区一:“只要页面有反爬或 JavaScript 动态渲染,Scrapy 就不如 Requests”
事实是,动态渲染属于页面解析层的问题,与 Requests 或 Scrapy 本身无关。无论使用哪种工具,如果页面核心数据由前端 JavaScript 异步渲染生成,首选方案都是在浏览器开发者工具(Network 面板)中寻找真实的 JSON 数据接口;如果接口强加密必须使用无头浏览器(如 Playwright 或 Selenium),Scrapy 同样可以通过 scrapy-playwright 中间件实现异步渲染驱动,与框架的并发机制无缝衔接。
误区二:“Requests 加上多线程或 Gevent 就能完全替代 Scrapy”
用 concurrent.futures.ThreadPoolExecutor 确实能让 Requests 实现并发抓取,但这只是解决了“发起连接”这一个动作。随着任务规模扩大,开发者不得不手动处理线程同步锁、共享队列的内存溢出、崩溃后的断点续爬状态保存、以及异常请求的重试管理。最终写出的代码,往往是一个简陋、脆弱且难以维护的“半成品 Scrapy”。当并发与去重成为系统性需求时,直接拥抱成熟框架才是更负责任的工程决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









