

Python爬虫实战:使用Scrapy与Requests抓取京东商品数据

本文详解如何利用Python爬取京东商城商品数据。通过分析Ajax异步加载机制,结合Requests获取HTML源码,使用BeautifulSoup解析DOM结构提取data-pid及图片URL。教程涵盖简化请求URL、处理懒加载图片属性、多线程加速抓取及MySQL/MongoDB存储方案,提供完整代码逻辑与优化建议。
前言与工具介绍
前言
本文详细讲解如何利用Python技术实现京东商城数据的爬取。内容涵盖从环境搭建到代码实现的完整流程,旨在为读者提供清晰的操作指南。
主要工具
- scrapy
- BeautifulSoup
- requests
京东页面分析与数据抓取策略
分析步骤
1、访问京东首页,在搜索框输入“裤子”并回车。页面跳转至搜索结果页,此即我们需要分析的起始页面。
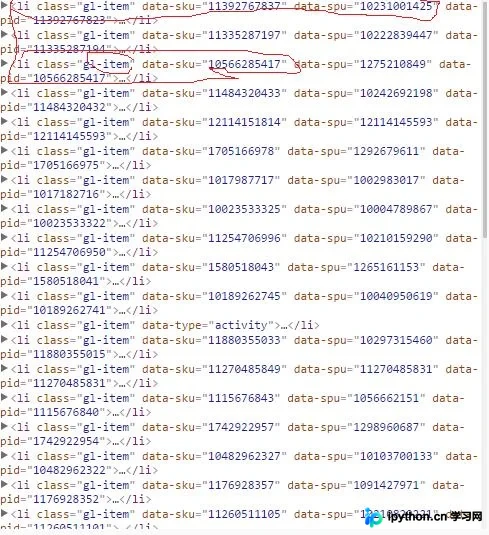
2、观察页面可知,初始加载的内容并不完整。向下滚动时,图片会持续动态加载,这表明页面使用了Ajax技术。当滚动至底部时,页面共加载了60条商品信息。通过Chrome开发者工具检查元素,可以发现每条商品信息的结构均包裹在<li class='gl-item'></li>标签内,具体结构如下图所示:
3、查看网页源代码会发现,源码中仅包含前30条数据,后30条数据无法在源码中直接找到。这证实了数据是通过Ajax异步加载的。因此,我们需要通过抓包工具获取真实的数据接口。按下F12打开开发者工具,切换到Network(网络)标签页,筛选XHR(XMLHttpRequest)请求,即可捕获到异步加载的请求数据,抓包过程如下图所示:
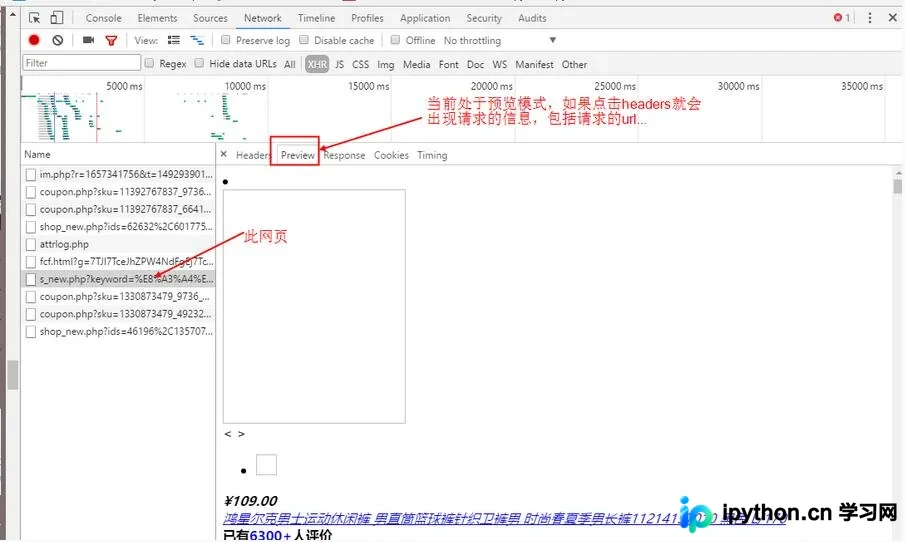
4、从抓包结果中可以定位到请求的URL。该URL参数较长,我们可以尝试简化以验证其有效性。简化后的URL格式如下: https://search.jd.com/s_new.php?keyword=%E8%A3%A4%E5%AD%90&enc=utf-8&qrst=1&rt=1&stop=1&vt=2&offset=3&wq=%E8%A3%94%E5%AD%90&page={0}&s=26&scrolling=y&pos=30&show_items={1} 其中,show_items参数对应商品的ID,page参数用于控制翻页。分析表明,只需修改这两个参数即可访问不同页面。值得注意的是,主网页的page值为奇数,而Ajax异步加载接口的page值为偶数。因此,在构造请求时,page参数应填入偶数(尽管填入奇数也能访问,但偶数符合异步加载逻辑)。show_items参数即商品ID,可在页面源码中通过查找li标签的data-pid属性获得,具体位置如下图所示:
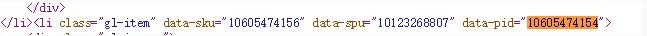
明确了参数获取方法后,接下来即可开始编写代码。
Python代码实现详解
代码讲解
1、首先,我们需要获取网页的源代码。这里选用requests库,安装方法为pip install requests。核心代码如下:
def get_html(self):
 res = requests.get(self.url, headers=self.headers)
 html = res.text
 return html #返回的源代码
2、根据前述分析,第二步是获取Ajax加载URL中的show_items参数,即li标签中的data-pid值。实现代码如下:
def get_pids(self):
 html = self.get_html()
 soup = BeautifulSoup(html, 'lxml') #创建BeautifulSoup对象
 lis = soup.find_all("li", class_='gl-item') #查找li标签
 for li in lis:
  data_pid = li.get("data-pid")  #得到li标签下的data-pid
  if (data_pid):
   self.pids.add(data_pid) #这里的self.pids是一个集合,用于过滤重复的
3、接下来获取前30张图片的URL,这些图片位于主网页中。需要注意的是,img标签的属性存在差异:已加载完成的图片使用src属性,而未加载的图片(懒加载)则使用data-lazy-img属性。因此,在解析页面时必须同时处理这两种情况。
具体实现代码如下:
def get_src_imgs_data(self):
 html = self.get_html()
 soup = BeautifulSoup(html, 'lxml')
 divs = soup.find_all("div", class_='p-img') # 图片
 # divs_prices = soup.find_all("div", class_='p-price') #价格
 for div in divs:
  img_1 = div.find("img").get('data-lazy-img') # 得到没有加载出来的url
  img_2 = div.find("img").get("src") # 得到已经加载出来的url
  if img_1:
   print img_1
   self.sql.save_img(img_1)
   self.img_urls.add(img_1)
  if img_2:
   print img_2
   self.sql.save_img(img_2)
   self.img_urls.add(img_2)
前30张图片已获取,现在开始处理后30张图片。这需要请求之前抓取的异步加载URL。由于前文已找到所需参数,后续处理较为直接,代码如下:
def get_extend_imgs_data(self):
 # self.search_urls=self.search_urls+','.join(self.pids)
 self.search_urls = self.search_urls.format(str(self.search_page), ','.join(self.pids)) #拼凑url,将获得的单数拼成url,其中show_items中的id是用','隔开的,因此要对集合中的每一个id分割,page就是偶数,这里直接用主网页的page加一就可以了
 print self.search_urls
 html = requests.get(self.search_urls, headers=self.headers).text #请求
 soup = BeautifulSoup(html, 'lxml')
 div_search = soup.find_all("div", class_='p-img') #解析
 for div in div_search:
  img_3 = div.find("img").get('data-lazy-img') #这里可以看到分开查找img属性了
  img_4 = div.find("img").get("src")
  if img_3: #如果是data-lazy-img
   print img_3
   self.sql.save_img(img_3) #存储到数据库
   self.img_urls.add(img_3)  #用集合去重
  if img_4: #如果是src属性
   print img_4
   self.sql.save_img(img_4)
   self.img_urls.add(img_4)
4、基于上述逻辑即可完成数据爬取。考虑到效率问题,此处采用多线程策略,每个页面开启一个线程进行抓取,速度表现良好,几分钟内即可完成100个网页的数据爬取。数据存储方面,本文使用MySQL数据库,需导入MySQLdb库(具体配置请参考官方文档)。
当然,也可以选用MongoDB进行存储,但本文未涉及该部分。如需完整源码,请参考以下链接:
一、GitHub源码
二、本地下载
拓展总结与源码获取
拓展总结
观察搜索结果页URL可知,keyword和wq参数均对应用户输入的搜索词。若需爬取其他类别的商品,只需将这两个参数替换为目标关键词即可。直接输入汉字,请求库会自动进行编码处理,经测试可有效抓取源码。若需持续抓取,可将目标关键词写入文件,程序从文件中读取关键词进行循环抓取。以上仅为基础爬虫示例,未使用复杂框架。后续将介绍基于Scrapy框架的爬取方案,敬请关注本站更新。
至此,本文内容全部结束。希望本文对大家在Python学习或实际应用中有所帮助。如有任何疑问,欢迎留言交流,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









