

Python爬虫常用库有哪些?从Requests到Scrapy的选型指南

选择合适的Python爬虫库,取决于目标网站的渲染方式、抓取规模以及工程复杂度。如果是抓取静态页面或调用现成接口,Requests配合BeautifulSoup是上手最快且最稳定的组合;面对高并发场景,支持原生异步的HTTPX能大幅提升网络I/O吞吐;遇到重度前端JavaScript渲染的单页应用,则需借助Playwright进行无头浏览器驱动;而面向百万级以上的分布式持久化抓取,工业级框架Scrapy则是规范开发的首选。本文将逐层拆解各主流工具的核心机制,并通过选型决策图与完整代码示例,帮助读者快速找到最佳技术方案。
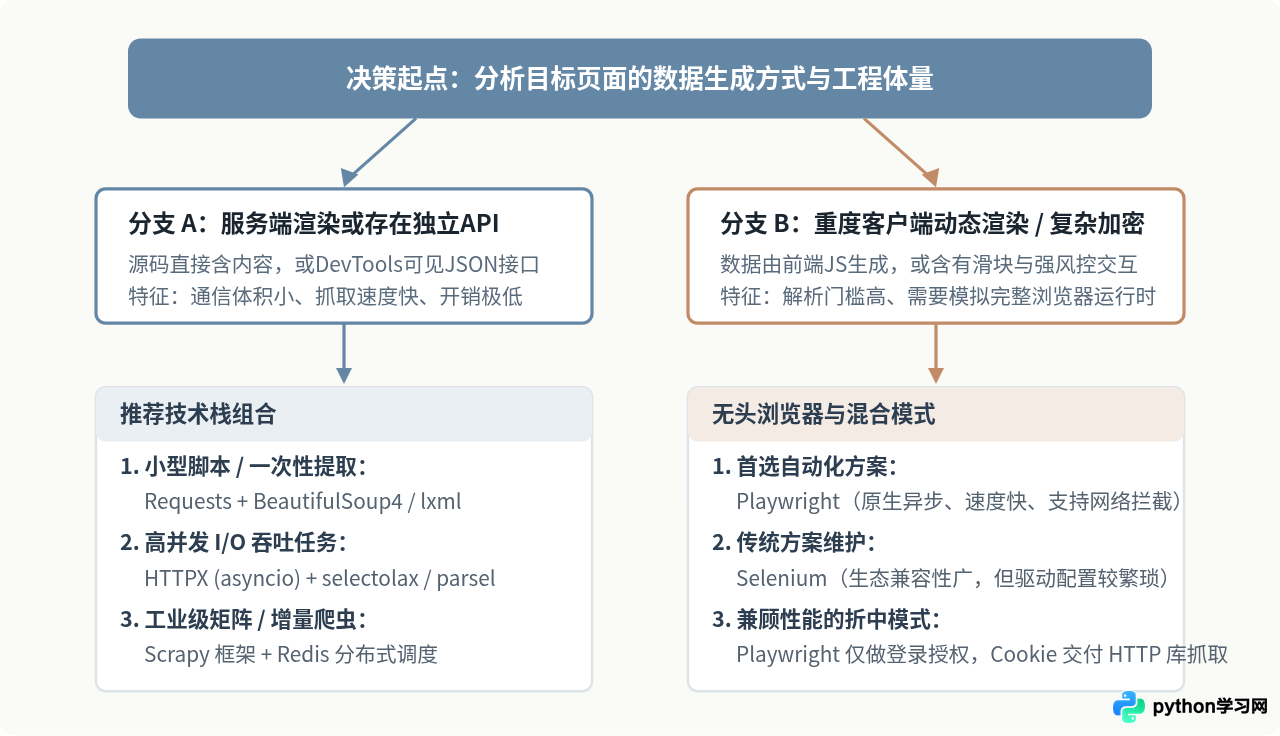
一、爬虫工具生态与核心选型决策树
在开始编写抓取脚本前,首要任务不是盲目安装第三方库,而是先分析目标页面的响应形式与工程目标。常见的网络采集可分为两大技术主线:第一类是直接通过网络协议拉取静态HTML文本或JSON数据接口;第二类是通过浏览器内核模拟真实用户操作以获取动态渲染内容。技术选型越轻量,系统的资源消耗越低,吞吐性能越高。
二、网络请求层:Requests、HTTPX 与 Aiohttp
网络请求是爬虫的第一步,主要目标是模拟合法的客户端行为向服务端拉取资源。
1. Requests:经典易用的同步请求库
Requests 是Python生态中最知名且应用最广泛的HTTP库。它的核心优势是人性化的API设计,隐藏了底层urllib3的复杂连接池细节。通过几行代码即可完成带有请求头伪装、Cookie管理和超时控制的请求。
import requests

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}

# 使用 Session 保持长连接与会话状态
with requests.Session() as session:
    session.headers.update(headers)
    try:
        response = session.get("https://httpbin.org/get", timeout=10)
        response.raise_for_status()
        data = response.json()
        print("请求成功,源IP为:", data.get("origin"))
    except requests.exceptions.RequestException as err:
        print("网络请求异常:", err)
适用场景与边界:Requests采用同步阻塞I/O模型。每一个请求发出后,当前线程必须等待服务器返回数据后才能继续执行下一个任务。对于万级以下的小型爬虫或日常测试,其开发效率极高;但当目标URL达到数万甚至更高时,同步阻塞会导致CPU大部分时间处于等待I/O的状态,即使引入多线程,也会受限于GIL和线程上下文切换开销。
2. HTTPX:下一代支持异步与HTTP/2的高性能客户端
HTTPX 完全兼容Requests的常用API,同时提供了原生的async/await异步支持,并且支持HTTP/2协议。它可以在单个事件循环中并发维持数百个非阻塞网络连接,极大提升网络利用率。
import asyncio
import httpx

async def fetch_status(client, url):
    try:
        resp = await client.get(url, timeout=5.0)
        return resp.status_code
    except httpx.HTTPError:
        return None

async def main():
    urls = ["https://httpbin.org/status/200" for _ in range(20)]
    async with httpx.AsyncClient() as client:
        tasks = [fetch_status(client, u) for u in urls]
        results = await asyncio.gather(*tasks)
        print("成功状态码数量:", results.count(200))

# 运行异步事件循环
asyncio.run(main())
httpx.Client编写代码,待遇到并发瓶颈时无缝迁移至httpx.AsyncClient。
三、数据解析层:BeautifulSoup、lxml 与 Parsel
获取到HTML响应后,爬虫需要从层层嵌套的标签结构中精确提取文本与属性。主流解析工具在容错度与执行效率上有明确的分工。
| 解析库 | 底层依赖 | 查询语法 | 解析性能 | 主要优势与适用场景 |
|---|---|---|---|---|
| BeautifulSoup4 | html.parser / lxml | Pythonic 方法、CSS选择器 | 中等 | 语法直观、对破碎错误的HTML容错极强,适合初学者与小型项目 |
| lxml | libxml2 (C语言) | XPath 1.0、CSS选择器 | 极快 | 直接调用C底层,速度快、内存占用低,海量页面解析标准选择 |
| Parsel | lxml | CSS、XPath、正则表达式混合 | 极快 | Scrapy官方抽取引擎,链式调用体验佳,支持提取与正则二次过滤 |
四、轻量级爬虫的完整实现步骤
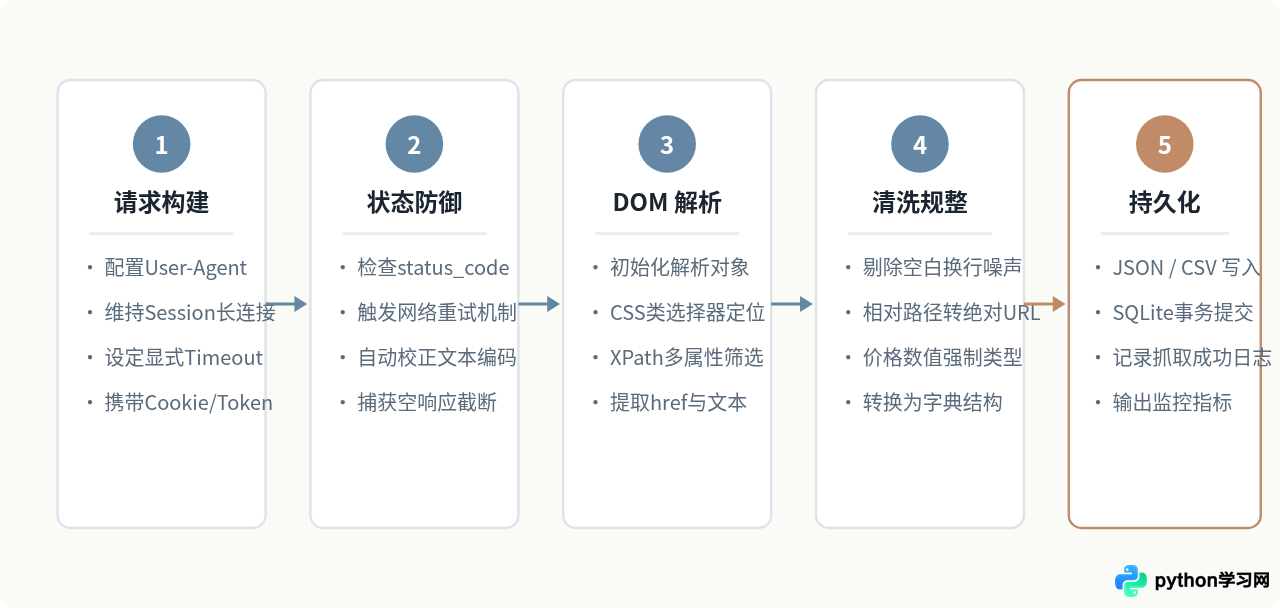
一个标准的生产级轻量爬虫通常包含“请求发送”、“异常防护”、“结构解析”、“清洗规整”与“数据落盘”五个顺序环节。以下流程图展示了数据在各个模块之间的流动方向:
下面是一个使用 requests 结合 BeautifulSoup4 抓取图书示例页面的完整单文件可运行脚本:
import json
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

BASE_URL = "http://books.toscrape.com/"

def scrape_top_books():
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
    }

    # 步骤 1:构建带超时的请求
    try:
        response = requests.get(BASE_URL, headers=headers, timeout=10)
        # 步骤 2:状态防御
        response.raise_for_status()
    except requests.RequestException as e:
        print(f"网络异常导致抓取终止: {e}")
        return []

    # 步骤 3:DOM解析
    soup = BeautifulSoup(response.text, "html.parser")
    book_nodes = soup.select("article.product_pod")

    items = []
    # 步骤 4:数据清洗与结构化
    for node in book_nodes[:5]:
        title_tag = node.select_one("h3 a")
        price_tag = node.select_one("p.price_color")

        if not title_tag or not price_tag:
            continue

        title = title_tag.get("title", "").strip()
        link = urljoin(BASE_URL, title_tag.get("href", ""))
        raw_price = price_tag.text.strip().replace("£", "")

        items.append({
            "title": title,
            "price_gbp": float(raw_price) if raw_price.replace(".", "", 1).isdigit() else 0.0,
            "url": link
        })

    return items

# 步骤 5:持久化存储
if __name__ == "__main__":
    data = scrape_top_books()
    with open("books.json", "w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False, indent=2)
    print(f"抓取完成,成功导出 {len(data)} 条格式化数据到 books.json")
五、核心框架能力对比:Requests vs HTTPX vs Scrapy
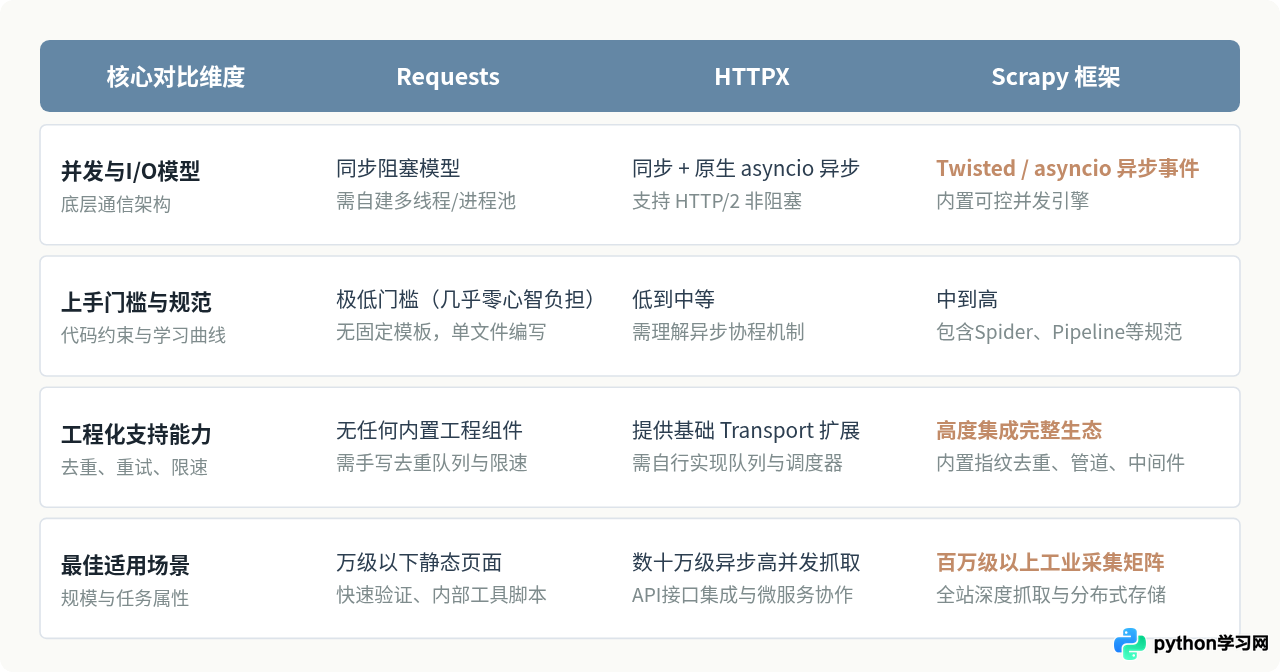
在工程演进过程中,开发者最容易遇到的困惑是:什么时候应该脱离 Requests 脚本,转向 HTTPX 或完整的 Scrapy 框架?下面的对比矩阵详细解构了三者的架构差异:
六、动态渲染挑战:Playwright 与 Selenium
当页面核心内容依赖客户端Vue、React动态挂载,或者请求接口含有复杂的动态签名(如Token每次请求由前端WASM计算生成)时,直接发HTTP请求往往只能得到空的HTML骨架。此时就需要引入自动化浏览器技术。
1. 为什么推荐优先选用 Playwright 而非传统 Selenium?
- 安装与驱动管理:Selenium需要手动下载与当前系统浏览器大版本完全匹配的ChromeDriver,升级频繁时极易产生兼容报错;Playwright通过
playwright install命令自动下载优化过的浏览器内核,开箱即用。 - 架构与并发效率:Playwright基于WebSocket长连接与Chromium底层DevTools协议直连,通信开销远低于Selenium使用的HTTP JSON Wire协议;此外,Playwright的
BrowserContext类似于无痕窗口,单个浏览器实例即可并发启动数十个隔离的Context,内存消耗比Selenium重复启动完整浏览器进程降低70%以上。 - 网络事件拦截:Playwright原生支持在浏览器发包前截获网络请求,允许直接阻止无关图片与CSS加载,或直接读取接口返回的JSON响应,避免在DOM树上繁琐寻址。
import asyncio
from playwright.async_api import async_playwright

async def run_playwright():
    async with async_playwright() as p:
        # 启动无头浏览器
        browser = await p.chromium.launch(headless=True)
        context = await browser.new_context()
        page = await context.new_page()

        # 监听并拦截所有的XHR/Fetch接口响应
        page.on("response", lambda resp: print("捕获动态响应:", resp.url) if "api" in resp.url else None)

        await page.goto("https://quotes.toscrape.com/js/")
        # 等待目标动态元素渲染完成
        await page.wait_for_selector(".quote")

        quotes = await page.locator(".quote .text").all_text_contents()
        print(f"成功抓取动态渲染内容 {len(quotes)} 条,第一条示例: {quotes[0][:30]}...")

        await browser.close()

asyncio.run(run_playwright())
七、工业级工程采集:Scrapy 核心架构与优势
当爬虫项目不再是一次性脚本,而是需要每日稳定抓取数百万页面并实时入库时,自建多线程往往会遇到连接泄漏、重复抓取、未持久化崩溃等问题。Scrapy 作为成熟的工业框架,其架构将爬虫生命周期严格划分为五个核心部件:
- 引擎(Scrapy Engine):负责控制整个系统的数据流,并在各个组件之间触发事件。
- 调度器(Scheduler):维护待抓取URL的优先级队列,并基于请求指纹(Fingerprint)进行全局去重。
- 下载器(Downloader):基于Twisted异步网络库高速下载网页,支持自动限速(AutoThrottle)。
- 爬虫解析器(Spiders):开发者编写的核心逻辑,专注于从响应中提取数据Item或生成后续抓取的Request。
- 数据管道(Item Pipeline):负责对抽取出的Item进行验证、清洗、去重,并持久化写入MongoDB、PostgreSQL或Elasticsearch。
此外,通过社区成熟的 Scrapy-Redis 扩展,可以无缝将内置调度器替换为Redis分布式队列,支持多台机器协同爬取,随时停机续爬,展现出极强的工业韧性。
八、爬虫工具选型总结全景
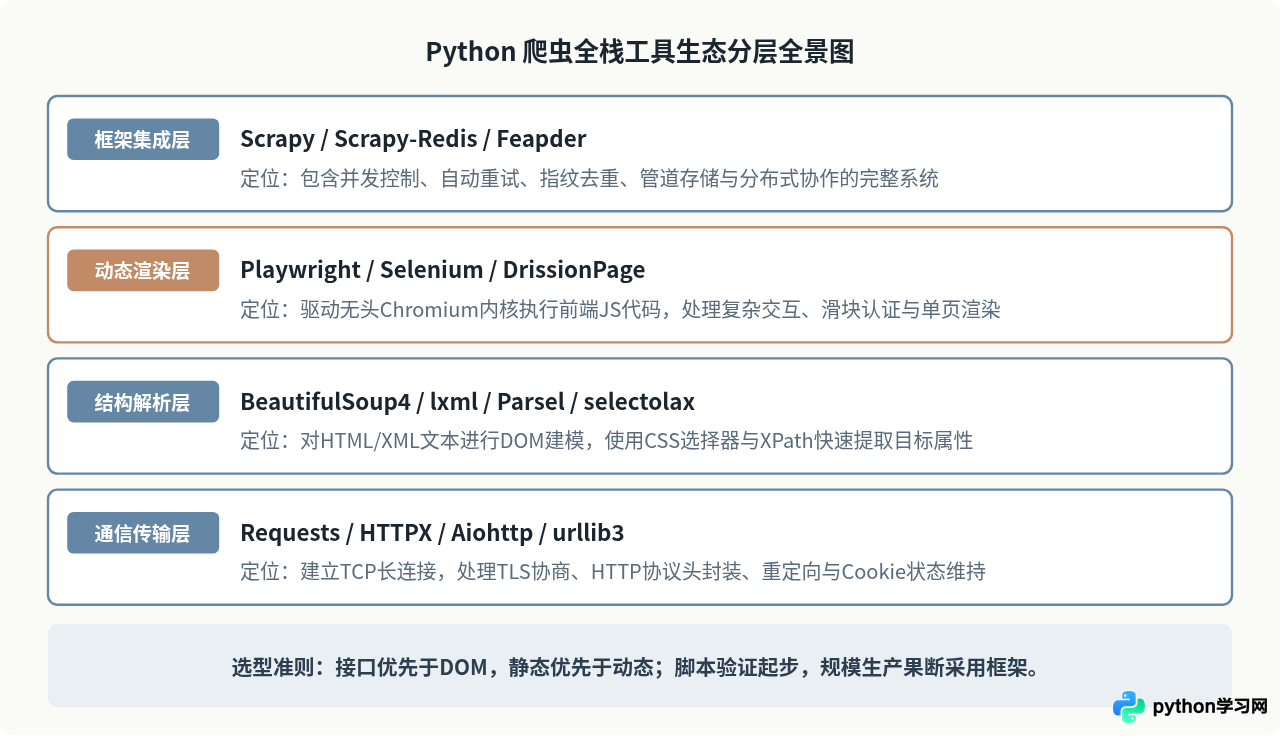
为了让不同阶段的开发者直观掌握工具定位,我们将Python爬虫的核心库按照技术层次进行了完整梳理:
避坑与实战落地建议
- 切忌滥用浏览器渲染:无头浏览器虽然简单粗暴,但极易成为采集系统的吞吐瓶颈。在写出第一行
playwright代码前,务必先在控制台搜索响应关键字,确认是否存在直出接口。 - 必须设置超时(Timeout):默认情况下,Requests的请求如果不加
timeout参数,当目标服务器挂起连接时,你的爬虫线程会永久阻塞。任何线上生产代码都必须显式设定合理的超时值。 - 重视会话复用(Session):频繁调用
requests.get()会导致每次请求都经历完整的TCP三次握手和TLS握手。使用requests.Session()或httpx.Client()保持长连接,通常能直接带来30%以上的耗时降低。 - 遵守Robots协议与合规限速:无论选用何种框架,过高频率的并发请求不仅容易导致IP被封禁,也可能对目标服务器造成拒绝服务攻击风险。合理添加延迟与限速,是爬虫长期稳定运行的基础前提。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









