

Python将MySQL查询结果直接转换为Pandas DataFrame
详细讲解在Python中将MySQL查询结果直接转换为Pandas DataFrame的标准方法,包括SQLAlchemy引擎配置、pd.read_sql核心参数解析、分块读取海量数据及常见排错指南。
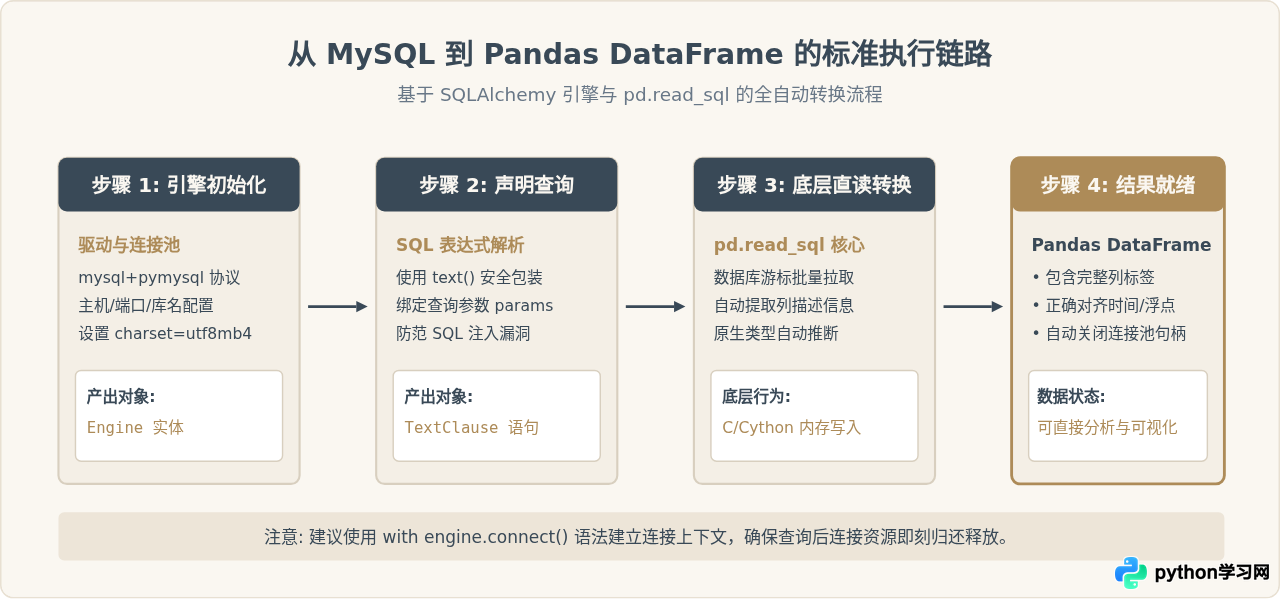
pandas.read_sql 结合 SQLAlchemy 数据库引擎对象。这一方式能够单行完成底层执行、字段名抓取、缺失值处理以及 NumPy/Arrow 内存数据结构的自动组装,无需手动编写游标循环提取逻辑。
一、标准实现方案与依赖准备
在执行数据库查询与类型转换之前,Python 环境中需要具备数据处理库 Pandas、数据库抽象层框架 SQLAlchemy,以及 MySQL 的底层驱动。当前最主流且无需编译 C 依赖的驱动库为 PyMySQL。
首先通过包管理器完成基础依赖库的安装:
pip install pandas sqlalchemy pymysql自 Pandas 2.0 及 SQLAlchemy 2.0 发布后,官方明确推荐使用标准的 SQLAlchemy 连接引擎或独立连接对象作为 pd.read_sql 的驱动来源,不再建议直接传入原生的 DB-API 数据库连接。标准的使用范式如下:
import pandas as pd
from sqlalchemy import create_engine, text

# 1. 构建数据库连接URL (mysql+pymysql://用户名:密码@主机:端口/数据库名?charset=utf8mb4)
db_url = "mysql+pymysql://root:password123@127.0.0.1:3306/sales_db?charset=utf8mb4"
engine = create_engine(db_url, pool_recycle=3600)

# 2. 编写查询SQL
sql_query = "SELECT order_id, user_id, order_amount, created_at, status FROM orders WHERE status = 'completed'"

# 3. 通过上下文管理器安全执行查询并转换为DataFrame
with engine.connect() as connection:
    df = pd.read_sql(sql=text(sql_query), con=connection)

# 4. 验证生成的DataFrame结构
print(df.head())
print(df.info())上述代码中,text() 构造器将原生 SQL 字符串封装为安全的执行表达式;engine.connect() 在上下文管理器中获取数据库连接,并在代码块执行完毕后自动归还连接池,避免数据库连接泄漏。生成的 df 对象具备完整的列名和正确推断出的数据类型。
二、传统游标提取与 pd.read_sql 的性能机制对比
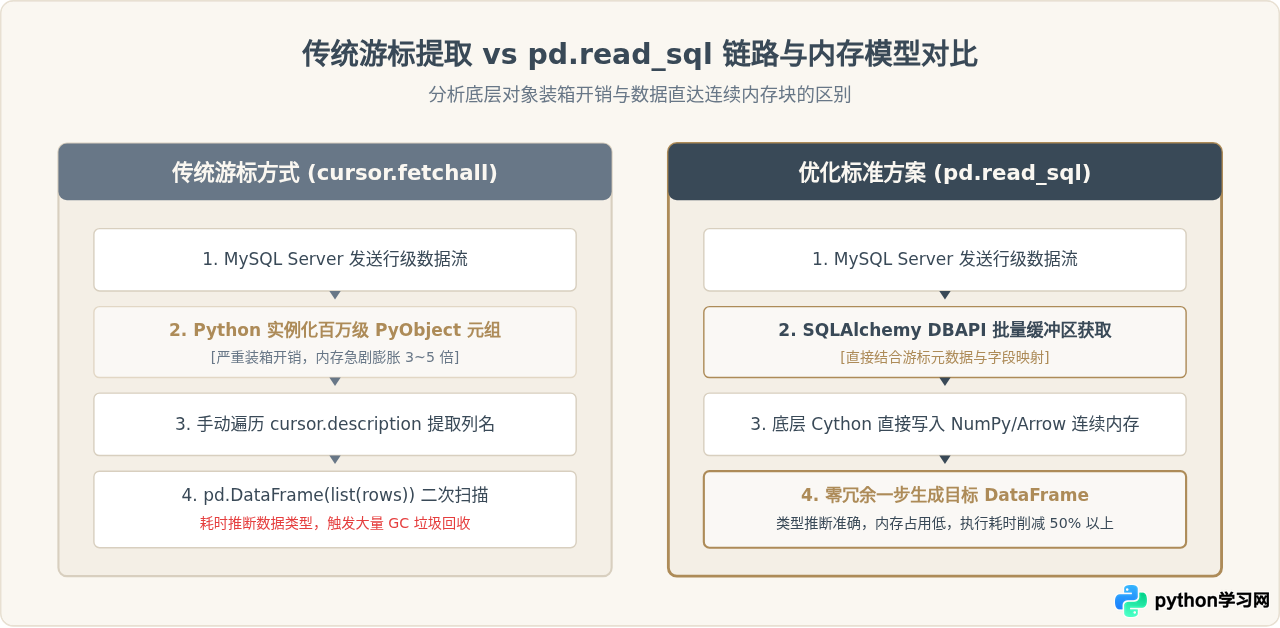
在没有使用 pd.read_sql 之前,很多初学者常通过纯 PyMySQL 游标获取元组或字典,再传递给 pd.DataFrame() 构造器。这种手写方式不仅代码冗长,在数据量达到数万至数十万行时,存在显著的性能开销。
传统手工转换的典型代码形式如下:
import pymysql
import pandas as pd

# 传统手工写法 (不推荐)
conn = pymysql.connect(host='127.0.0.1', user='root', password='password123', database='sales_db')
cursor = conn.cursor()
cursor.execute("SELECT * FROM orders")

rows = cursor.fetchall()  # 内存中创建巨大的 Python Tuple 嵌套列表
columns = [desc[0] for desc in cursor.description]  # 手动提取表头列名

df_legacy = pd.DataFrame(list(rows), columns=columns)  # 再次迭代进行类型推断与对象重构
cursor.close()
conn.close()
这种手动转换存在两大致命瓶颈:
- 内存膨胀严重:
fetchall()会先在 Python 堆中为每一行、每个字段实例化对应的 Python 对象(如 int、str、float、Decimal 等)。当查询结果达到几十万行时,这会产生数百万个单独的 PyObject,造成数倍于原始数据的内存占用。 - 二次类型推断开销:当把 Python 列表传入
pd.DataFrame()时,Pandas 必须逐列遍历这些 Python 对象,再次推断其 NumPy 数据类型并拷贝至连续内存块中,CPU 消耗非常大。
相比之下,pd.read_sql 在底层通过 C/Cython 层面实现批处理读取,直接将数据库驱动返回的底层缓冲写入 NumPy 数组的连续内存空间,减少了无谓的中间对象创建与垃圾回收压力。
三、核心参数详解与实用配置技巧
pd.read_sql 提供了丰富的参数用于精细化控制转换行为。合理设置这些参数不仅能够避免 SQL 注入等安全问题,还能省去后续繁复的数据清洗步骤。
1. 参数化查询(params 参数)
在涉及变量过滤时,严禁使用 Python 字符串格式化(如 f"SELECT ... WHERE id = '{user_id}'")拼接 SQL,这会直接暴露于 SQL 注入风险下。正确做法是使用占位符配合 params 参数:
query = "SELECT user_id, username, score FROM users WHERE status = :status AND score >= :min_score"

with engine.connect() as conn:
    df_filtered = pd.read_sql(
        sql=text(query),
        con=conn,
        params={"status": "active", "min_score": 80}
    )
2. 指定主键或时间作为索引(index_col 参数)
默认情况下,Pandas 会自动生成一个从 0 开始的整数索引(RangeIndex)。若查询结果中已包含自增 ID 或唯一业务主键,可通过 index_col 参数直接将其设为 DataFrame 的索引列,避免多余的内存占用:
df_indexed = pd.read_sql(
    sql=text("SELECT order_id, order_no, total_price FROM orders"),
    con=conn,
    index_col="order_id"
)
3. 自动解析时间类型(parse_dates 参数)
虽然 MySQL 中的 DATETIME 类型通常能被自动识别,但在部分复杂查询、函数计算结果(如 DATE_FORMAT)或存为字符串的时间列中,Pandas 可能将其推断为 object 类型。通过传入 parse_dates 参数,可以在读取过程中直接将其解析为 datetime64[ns]:
df_dates = pd.read_sql(
    sql=text("SELECT order_id, created_at, updated_at FROM orders"),
    con=conn,
    parse_dates=["created_at", "updated_at"]
)
4. 精确指定数值类型(dtype 参数)
若数据库中的状态字段是小整数(如 TINYINT),或用户标识为大整数,可在读取时显式指定更紧凑的类型,大幅节省内存空间:
df_typed = pd.read_sql(
    sql=text("SELECT order_id, status_code, user_id FROM orders"),
    con=conn,
    dtype={"status_code": "int8", "user_id": "int64"}
)
四、海量数据查询与内存控制(chunksize 分块流式处理)
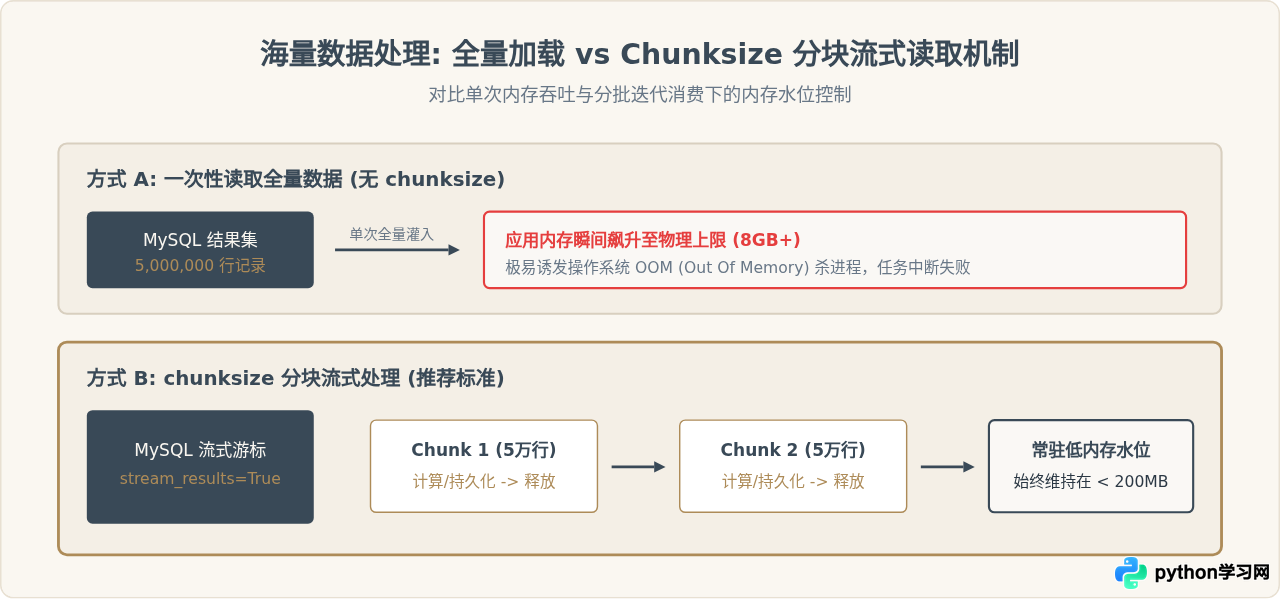
当查询的数据集非常庞大(例如数百万甚至上千万行历史记录)时,若仍然使用普通调用,程序会试图将整个结果集一次性全部加载到内存中。这极易导致系统物理内存耗尽,触发系统的 OOM Killer 强行终止 Python 进程。
通过传入 chunksize 参数,pd.read_sql 将不再返回单一的 DataFrame,而是返回一个可迭代的生成器(Iterator)。每次迭代只会从数据库提取指定行数并封装为一个独立的 DataFrame 分块,处理完成后该分块内存可及时释放。
# 设定每个分块 50,000 行
chunk_size = 50000
query_large = text("SELECT user_id, order_amount, created_at FROM orders_history")

total_orders = 0
total_revenue = 0.0

with engine.connect() as conn:
    # 返回迭代器对象
    chunk_iterator = pd.read_sql(
        sql=query_large,
        con=conn,
        chunksize=chunk_size
    )

    # 逐批消费与流式聚合
    for i, chunk_df in enumerate(chunk_iterator):
        batch_count = len(chunk_df)
        batch_revenue = chunk_df["order_amount"].sum()

        total_orders += batch_count
        total_revenue += batch_revenue
        print(f"处理第 {i+1} 批次: 读取 {batch_count} 行,当前累计营收: {total_revenue:.2f}")

print(f"全部处理完毕,总订单数: {total_orders},总营收: {total_revenue:.2f}")SSCursor),否则 MySQL 驱动在底层依然会把全部网络数据包暂存在客户端缓冲区内。在 SQLAlchemy 中可通过执行选项指定:conn.execution_options(stream_results=True)。
五、常见报错排查与生产避坑要点
在实际工程环境中,将 MySQL 查询转换为 DataFrame 时经常会遇到几类具有代表性的问题,以下列举核心成因与对应解决方案。
1. UserWarning: pandas only supports SQLAlchemy connectable
表现:在运行 pd.read_sql(query, raw_pymysql_conn) 时,终端输出严重警告,提示原生 DBAPI 连接未来将不再受支持。
原因:Pandas 2.0+ 对底层数据库交互接口进行了标准化收拢,明确将兼容层绑定在 SQLAlchemy 上。原生驱动连接缺乏跨数据库的类型映射与统一元数据规范。
解决办法:通过 create_engine 包装连接字符串,并传入 engine.connect() 获取的连接对象执行读取。
2. 中文乱码或特殊字符截断
表现:读取生成的 DataFrame 中,中文字符显示为 ??? 或乱码字符。
原因:MySQL 默认的字符集可能为 latin1 或未指定 UTF-8 编码,特别是包含 Emoji 或生僻字时,必须使用全功能 UTF-8。
解决办法:在 SQLAlchemy 的连接 URL 尾部显式声明 charset=utf8mb4 参数:"mysql+pymysql://user:pwd@host/db?charset=utf8mb4"。
3. 数据库 DECIMAL 与 float 精度转换
表现:财务金额字段在 DataFrame 中被识别为 Python 的 decimal.Decimal 对象,无法直接使用向量化的数值运算函数(如计算均值或移动平均)。
解决办法:若不需要严格的高精度 Decimal 计算,可在读取后使用 astype(float) 转换,或在 SQL 查询中通过 CAST(amount AS DOUBLE) 直接在数据库端完成类型转换。
4. 避免连接泄漏:务必使用上下文管理器
如果直接使用 conn = engine.connect() 而没有配对的 close() 逻辑,一旦中途出现查询报错,数据库连接将保持挂起状态。当短时间内调用频繁时,MySQL 会报出 Too many connections 错误。因此,始终推荐使用 with engine.connect() as conn: 确保连接无论成功与否均能正常释放归还。
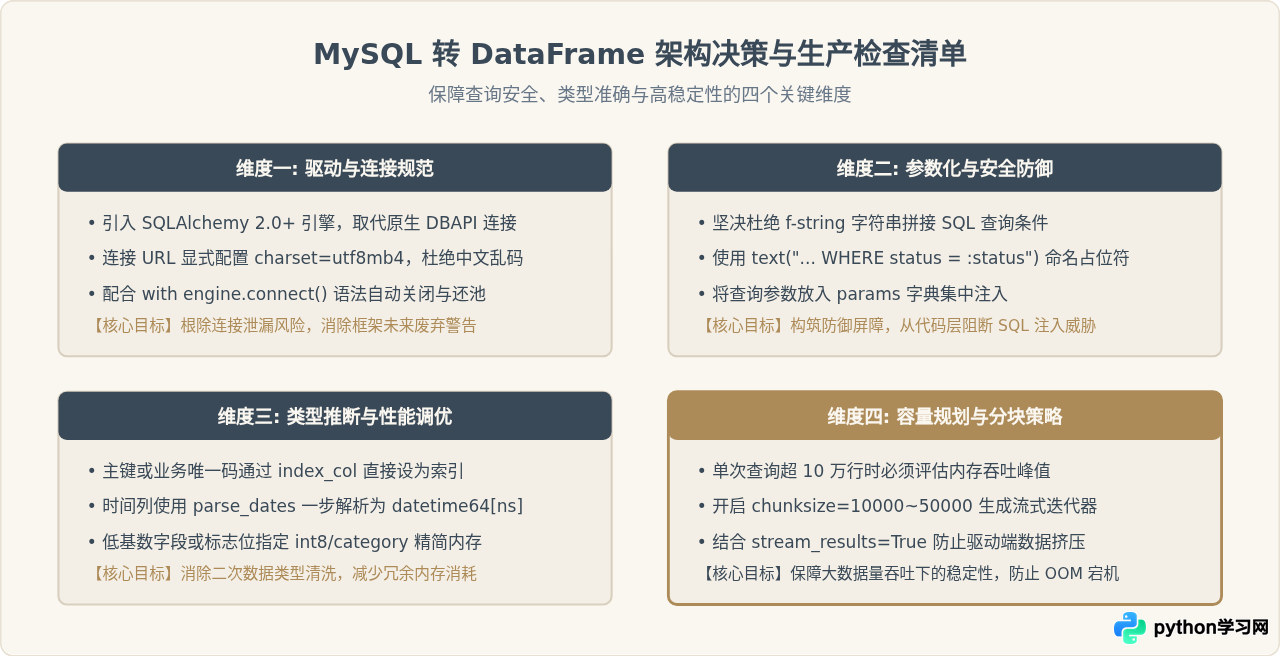
六、方案选型与核心检查清单
下表归纳了不同业务规模与场景下,将 MySQL 转换为 DataFrame 的选型策略:
| 场景需求 | 推荐方法 / 参数组合 | 优势与适用边界 |
|---|---|---|
| 中小型日常查询 (< 10 万行) | pd.read_sql(text(sql), conn) |
代码最简洁,自动映射字段与基础数据类型,开发效率高。 |
| 动态条件与参数化过滤 | pd.read_sql(text(sql), conn, params={...}) |
彻底避免 SQL 注入风险,符合参数化安全审计规范。 |
| 海量数据离线导出 (> 50 万行) | pd.read_sql(..., chunksize=50000) |
分块流式迭代,避免内存溢出崩溃,可配合批量落盘或计算。 |
| 高频时间序列分析 | pd.read_sql(..., parse_dates=[...], index_col=...) |
一步将时间字段解析为索引,省去后续两次转换操作。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









