

写Python爬虫怎么遵守robots.txt协议?数据采集合规性与法律边界
深入讲解Python网络爬虫如何正确解析和遵守robots.txt协议,结合urllib.robotparser标准库实操、抓取频率控制,并系统剖析网络数据采集的合规要点与法律责任边界。
在编写 Python 网络爬虫时,遵守 robots.txt 协议的核心做法是:在向目标站点发起采集请求前,先拉取并解析该域名根目录下的 robots.txt 文件,提取与自身爬虫标识(User-Agent)相匹配的 Allow 与 Disallow 规则,并在调度层判断拟访问的 URL 是否具备抓取许可,同时配合延时参数限制请求速率。但必须明确的是,robots.txt 本质上是互联网早期形成的非强制性技术协议,遵守该协议是程序合规的基础门槛,却绝不等于拥有了绝对合法抓取的豁免权;合规采集还需要在请求频次控制、个人隐私防护以及反不正当竞争等法律红线内审慎运行。
一、认识 robots.txt:基本语法与匹配规则
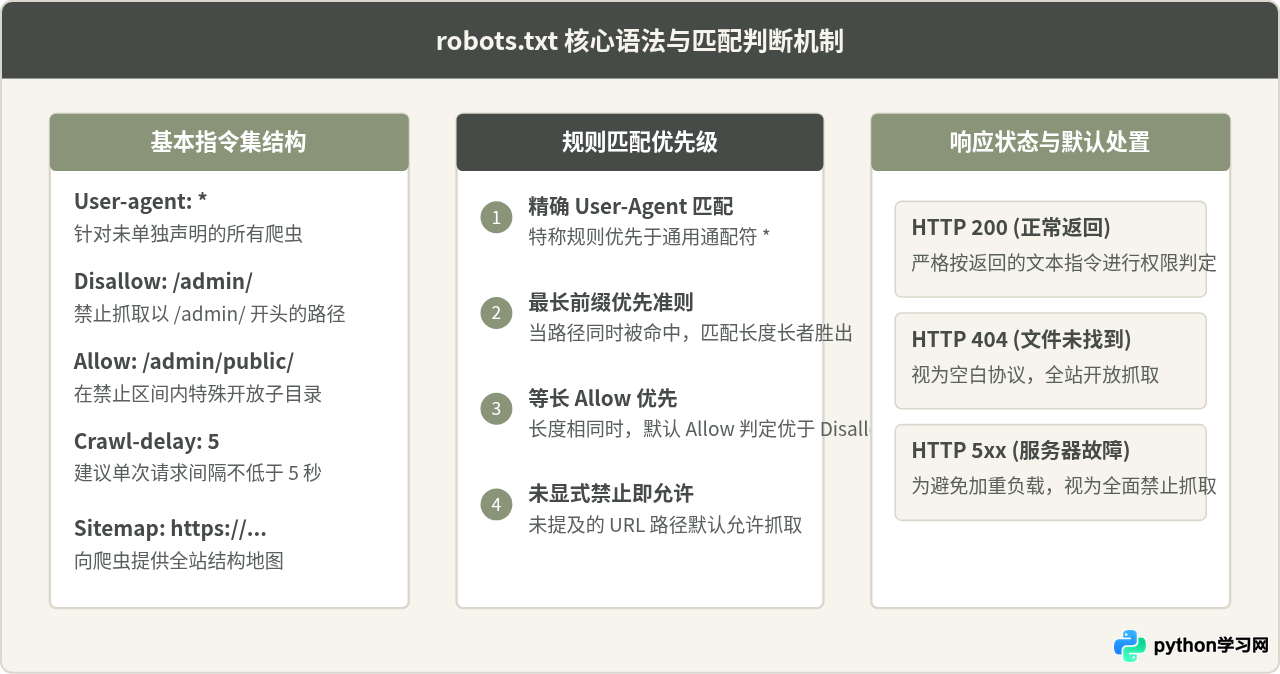
robots.txt(即机器人排除标准,Robots Exclusion Protocol)放置在网站根目录下(例如 https://example.com/robots.txt)。它使用简洁的纯文本格式,向符合规范的网络蜘蛛和抓取程序声明站点持有者对不同路径的抓取偏好。
一个标准的 robots.txt 主要由若干规则块构成,每个规则块由 User-agent 开头,并伴随一个或多个路径指令:
- User-agent:指定规则生效的客户端身份标识。
*代表匹配所有未单独列出的爬虫。当网站定义了具体爬虫名称(如Googlebot、Baiduspider)且与当前爬虫匹配时,优先适用针对该爬虫的专用规则。 - Disallow:声明不允许抓取的路径前缀。如果值为 空(例如
Disallow:),表示允许抓取所有路径。 - Allow:声明允许抓取的具体路径,通常用于在被
Disallow的父目录下开放某些特定子路径。 - Crawl-delay:非官方标准但被多数引擎支持的指令,声明两次请求之间的最小等待秒数,用于避免服务器过载。
二、实操步骤:使用 Python 原生库遵守协议
在 Python 生态中,无需手写复杂的正则表达式来解析 robots.txt。Python 标准库自带了 urllib.robotparser 模块,其中的 RobotFileParser 类专门用来读取、解析规则并核对访问权限。
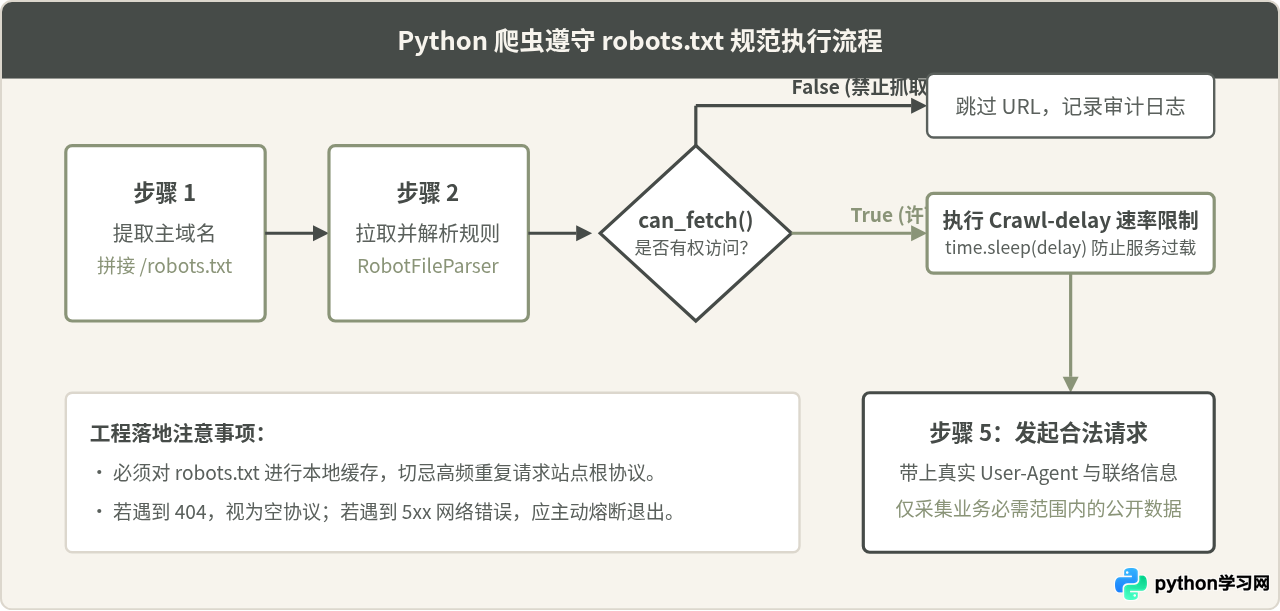
规范的爬虫执行链路分为五个关键阶段:
- 定位协议 URL:无论当前待抓取的页面在多深的子目录下,协议文件永远固定在网站协议与主机域名后的
/robots.txt。 - 请求并解析:通过
set_url()指定地址并调用read()方法完成网络下载与规则初始化。 - 权限判别:对队列中的每个待抓取 URL,调用
can_fetch(user_agent, url)进行布尔判断。 - 遵循频控建议:若定义了
crawl_delay,在调度器中注入等待时间。 - 本地缓存复用:避免每抓取一个页面就重新请求一次
robots.txt,必须在内存中缓存解析对象,并设定合理的过期时间(通常建议缓存 6 至 24 小时)。
下面给出一段在生产级爬虫中可以直接封装使用的合规检查模块完整代码:
import time
import urllib.robotparser
from urllib.parse import urlparse, urljoin
import urllib.request
import urllib.error

class CompliantCrawlerVerifier:
    def __init__(self, user_agent="MyDataCollector/1.0 (+https://example.com/bot-contact)"):
        self.user_agent = user_agent
        self.parsers = {}       # 域名到 RobotFileParser 实例的映射
        self.cache_time = {}     # 缓存时间戳
        self.cache_ttl = 86400   # 缓存 24 小时

    def _get_robots_url(self, target_url):
        parsed = urlparse(target_url)
        return f"{parsed.scheme}://{parsed.netloc}/robots.txt"

    def get_parser(self, target_url):
        parsed = urlparse(target_url)
        domain = f"{parsed.scheme}://{parsed.netloc}"
        now = time.time()

        # 检查缓存是否有效
        if domain in self.parsers and (now - self.cache_time.get(domain, 0)) < self.cache_ttl:
            return self.parsers[domain]

        robots_url = self._get_robots_url(target_url)
        parser = urllib.robotparser.RobotFileParser()
        parser.set_url(robots_url)

        try:
            # 显式使用带有自定义 User-Agent 的请求读取,避免被误判为恶意请求
            req = urllib.request.Request(
                robots_url,
                headers={"User-Agent": self.user_agent}
            )
            with urllib.request.urlopen(req, timeout=10) as response:
                content = response.read().decode("utf-8", errors="replace")
                parser.parse(content.splitlines())
        except urllib.error.HTTPError as e:
            if e.code == 404:
                # 404 Not Found:无协议,默认允许所有访问
                parser.allow_all = True
            elif e.code >= 500:
                # 5xx 服务器错误:为避免造成负担,暂时视作禁止抓取
                parser.disallow_all = True
            else:
                parser.disallow_all = True
        except Exception:
            # 其他网络超时或连接重置异常,保守处理为禁止
            parser.disallow_all = True

        self.parsers[domain] = parser
        self.cache_time[domain] = now
        return parser

    def can_fetch(self, target_url):
        parser = self.get_parser(target_url)
        return parser.can_fetch(self.user_agent, target_url)

    def get_crawl_delay(self, target_url):
        parser = self.get_parser(target_url)
        delay = parser.crawl_delay(self.user_agent)
        return delay if delay is not None else 1.0  # 默认保底 1 秒间隔

# 示例调用
if __name__ == "__main__":
    verifier = CompliantCrawlerVerifier()
    test_url = "https://example.com/articles/python-tutorial"

    if verifier.can_fetch(test_url):
        delay = verifier.get_crawl_delay(test_url)
        print(f"[允许抓取] 正在等待建议延时 {delay} 秒...")
        time.sleep(delay)
        # 随后执行 requests.get 或 aiohttp 请求
    else:
        print(f"[禁止抓取] 目标 URL 受 robots.txt 约束,已被调度器跳过。")
三、认知辨析:破除常见误区与模糊地带
在实际开发与技术讨论中,很多初学者对 robots.txt 的性质产生过偏差理解。厘清这些误区,对把握采集行为的合规底线极为重要。
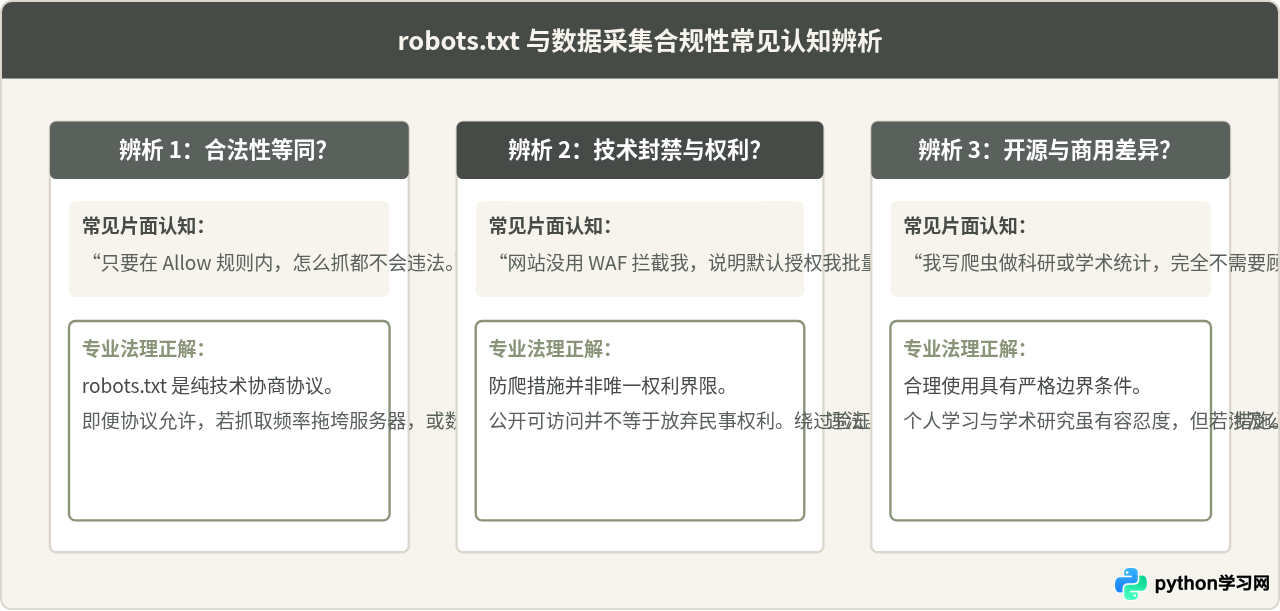
1. “遵守 robots.txt 等同于完全合法”这一说法的合理性与局限:
这种说法在搜索引擎生态中看似合理,因为主流搜索引擎(如 Google、Bing、Baidu)与网站管理者之间建立了默契:只要爬虫在协议范围内建立索引并带来搜索回流流量,便互利共赢。但在商业爬虫、竞品监控、AI 模型训练数据采集等场景下,抓取目的通常是提取结构化数据并在自身业务中复用。此时,网站往往并不希望核心数据资产被第三方廉价转移,即便协议未显式配置 Disallow,直接全量搬运并形成同质化竞争也会触发《反不正当竞争法》的诉讼维权。
2. “robots.txt 毫无法律约束力,违背也无所谓”这一误区的危险性:
虽然没有一部刑法条文直接规定“违反 robots.txt 判刑”,但在大量司法判例(如国内知名的“百度诉奇虎360违反Robots协议不正当竞争案”、“大众点评诉爱帮网案”)中,法院明确将 robots.txt 认定为互联网行业公认的商业道德与技术规范。在明知网站通过 robots.txt 声明禁止抓取的情况下,强行修改 User-Agent、伪造头部信息绕过限制,往往成为认定侵权方“主观恶意”的直接铁证。
四、数据采集合规性与法律责任边界
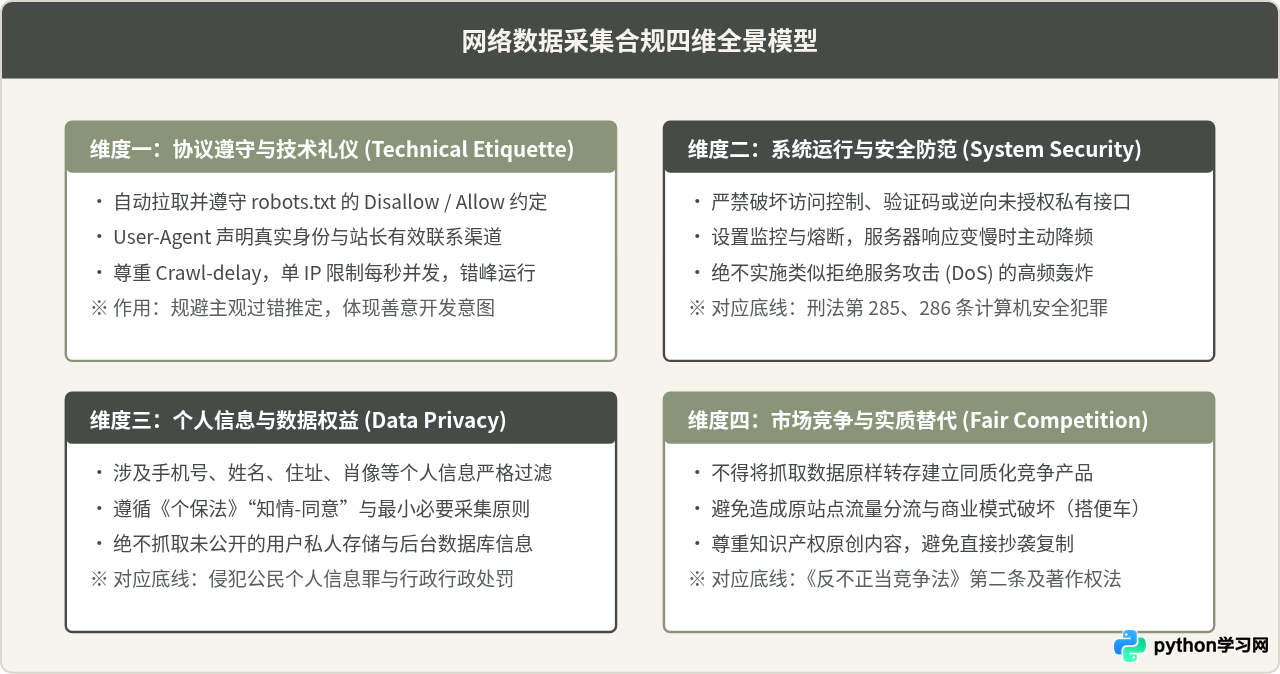
网络爬虫本质上是一项中立的技术工具。决定其法律性质的,是采集的手段方式、数据对象以及后续使用目的。在我国法律框架下,爬虫开发者与企业应当牢牢守住三条核心红线:
1. 计算机信息系统安全红线(刑法第 285 条、第 286 条)
爬虫如果不加节制地高并发请求,导致目标服务器 CPU 占满、数据库连接耗尽甚至宕机,即属于通过技术手段干扰计算机系统正常运行。情节严重的,可能构成破坏计算机信息系统罪。此外,如果爬虫通过逆向破解验证码、暴力破解登录鉴权或突破未公开 API 抓取非公开数据,极易触犯非法侵入计算机信息系统罪或非法获取计算机信息系统数据罪。
2. 数据与个人隐私保护红线(《个人信息保护法》《数据安全法》)
任何包含自然人身份识别可能性的信息(包括姓名、手机号、家庭住址、身份证号、行踪轨迹甚至关联的社交账号画像),均属于个人信息范畴。未经用户明示同意,即使是页面上未经遮蔽展示的公开信息,爬虫大规模爬取、转存、清洗并形成数据库转卖或商业化,均属于非法收集个人信息,严重者直接触犯侵犯公民个人信息罪。
3. 市场竞争与知识产权红线(《反不正当竞争法》第二条)
这是当前民事纠纷中高发的领域。如果被采集数据是原告平台耗费大量人力、物力、财力经营积累的核心竞争资源(例如大众点评的用户真实评价、房产平台的真实成交房源数据、招聘平台的简历库),爬虫运营方抓取后直接在自身产品中展示,造成用户分流或实质性替代原告产品,法院通常适用《反不正当竞争法》第二条原则性条款,认定其构成“搭便车”、“食人脂膏”的不正当竞争行为,判处高额经济赔偿。
五、合规开发行动指南:工程落地检查清单
为确保采集程序在工程实践中兼顾数据需求与合规安全,团队应在部署运行前逐项对照以下清单:
| 审核环节 | 具体核验标准 | 推荐落实技术 |
|---|---|---|
| 入口前置验证 | 系统调度器在排队抓取前必须调用 can_fetch(),且对 Disallow 路径做阻断熔断。 |
urllib.robotparser 结合 Redis 缓存,每 24h 更新一次。 |
| 请求特征透明 | 不得冒用 Googlebot 或常见浏览器的伪造标识,在 Header 中清晰载明应用名及联系邮箱。 | 配置固定格式:User-Agent: BotName/1.0 (+http://company.com/bot)。 |
| 频控与退避 | 单域名并发严格限制,遇到 429(Too Many Requests)或 503 时指数退避。 | 令牌桶(Token Bucket)算法或分布式限流器,保底间隔 > 1s。 |
| 数据清洗与脱敏 | 入库环节设立过滤管道,手机号、身份证、住址等敏感数据即刻哈希或丢弃。 | 数据清洗中间件(Clean Pipeline)配置个人信息识别正则脱敏。 |
| 业务用途评估 | 仅将数据用于统计建模、内部分析或事实引用,不建立对外实质性竞争的镜像网站。 | 法务与技术联合出具《数据合规使用风险评估报告》。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









