

Python爬虫入门到进阶:50个典型网页抓取练习案例
发布时间:2026-11-15| 19人浏览过
系统梳理Python网络爬虫从入门到进阶的50个典型实战案例,涵盖基础静态网页解析、异步API接口抓包、常见反爬机制攻防、无头浏览器自动化以及企业级分布式系统架构全流程。
网络爬虫的本质是模拟客户端向服务端发送网络请求、获取响应并从中提取结构化数据的自动化程序。掌握爬虫技术的核心在于建立分层的解决思维:从简单的单页静态文本提取,逐步扩展到异步接口分析、动态逆向解密、多进程高并发调度以及工程化运维。本文梳理了50个具备代表性的经典练习案例,划分为五个循序渐进的技术阶段,帮助读者搭建稳固的实战体系。
一、整体技术演进路线与案例分层
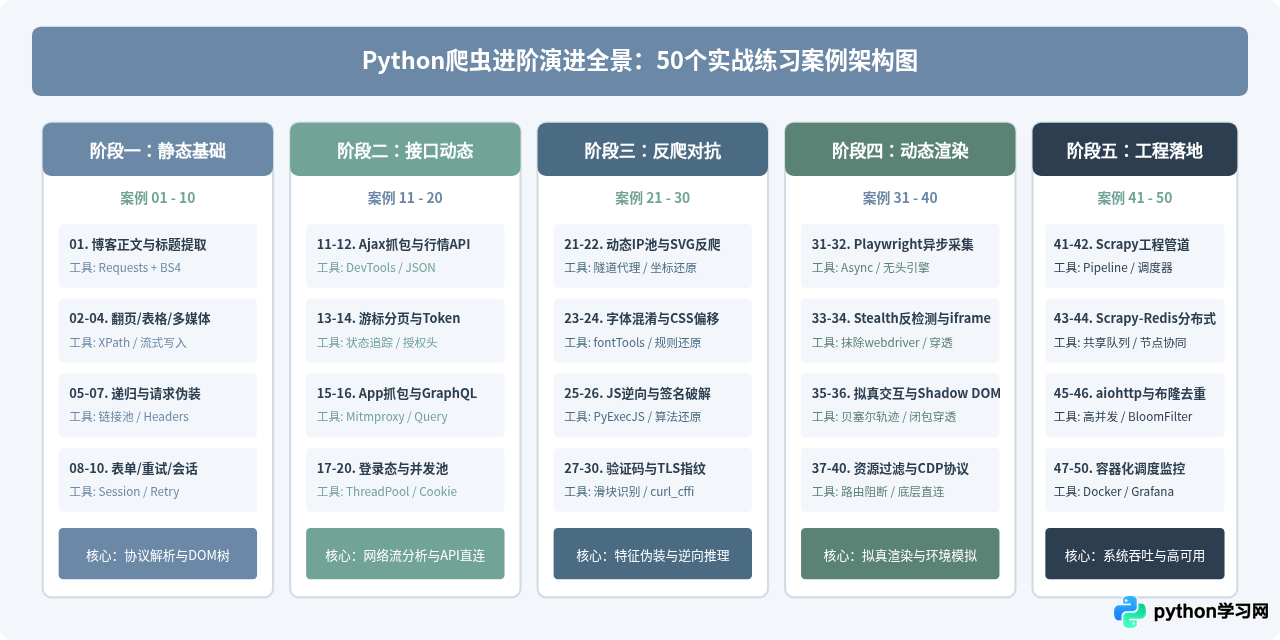
学习爬虫最容易遇到的瓶颈不是语法,而是在面对复杂多变的网页结构与防御机制时缺乏明确的排查路径。爬虫开发可以明确划分为五个阶段:静态页面采集、动态API接口挖掘、前端反爬与逆向解密、自动化无头浏览器渲染,以及大规模分布式采集调度。
下图展示了这50个案例的技术分布与能力演进路线,读者可依据当前水平对照训练:
二、第一阶段:静态网页抓取与基础文本解析(案例1-10)
该阶段针对传统的服务端渲染网页(SSR)。服务器在收到请求后直接组装好HTML并返回,读者需要掌握HTTP基础请求构造、响应内容解码、CSS选择器与XPath语法匹配。
案例 01: 静态博客标题与正文提取
Requests + BS4
针对标准HTML结构的博客页面,使用Requests发送GET请求,通过BeautifulSoup解析DOM,提取文章标题、发布日期及主体正文内容。
案例 02: 分页图书目录与价格抓取
URL模式构造
分析URL路径中page参数变化规律,编写循环自动遍历1到50页数据,解析每页包含的书名、评分与售价,并处理最后一页空响应退出逻辑。
案例 03: 复杂表格数据提取与CSV导出
XPath / lxml
针对嵌套table标签、跨行跨列(rowspan/colspan)的财务或统计报表页面,利用lxml的XPath定位精确行元素,清洗后导出为本地标准CSV。
案例 04: 高清图片批量流式下载
stream=True
从壁纸站提取图片源URL列表,设置stream=True以分块(chunk_size=1024)方式写入二进制文件,防止大文件一次性载入内存引发OOM。
案例 05: 多级分类目录递归爬取
深度/广度优先
从网站主分类导航出发,提取子分类链接,再深入详情页获取数据。维护待访问URL集合,利用set实现同域名下的基础去重。
案例 06: 罕见编码识别与乱码清洗
chardet / GBK
面对GB2312、GBK或Big5老旧政府企业网站,学习使用chardet检测字节流真实编码,或从meta charset头提取规范编码进行手动解码转换。
案例 07: 请求头指纹伪装与防盗链
Headers / Referer
配置标准浏览器的User-Agent、Accept-Language以及对应的Referer来源页字段,突破针对纯脚本默认请求头的简单阻断。
案例 08: POST表单搜索数据批量拉取
form-data
抓取站内搜索功能接口,分析提交的POST表单载荷,使用requests.post携带关键字、时间区间等参数,抓取返回的检索列表。
案例 09: 网络波动自动重试机制
HTTPAdapter / Retry
配置urllib3的Retry策略,挂载到requests.adapters.HTTPAdapter上,针对500、502、503、504状态码及连接超时实现指数退避重试。
案例 10: 基于Session的会话状态保持
requests.Session
利用Session对象在连续多个请求间自动维持服务端Set-Cookie下发的Token,保持同一TCP连接池以显著降低握手延迟。
实战关键点示例(案例09:网络重试与会话配置):
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

def create_robust_session():
    session = requests.Session()
    # 定义重试策略:总共重试3次,退避系数为1秒,针对特定状态码生效
    retry_strategy = Retry(
        total=3,
        backoff_factor=1,
        status_forcelist=[429, 500, 502, 503, 504],
        allowed_methods=["HEAD", "GET", "OPTIONS"]
    )
    adapter = HTTPAdapter(max_retries=retry_strategy)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    })
    return session
三、第二阶段:结构化接口与动态API数据采集(案例11-20)
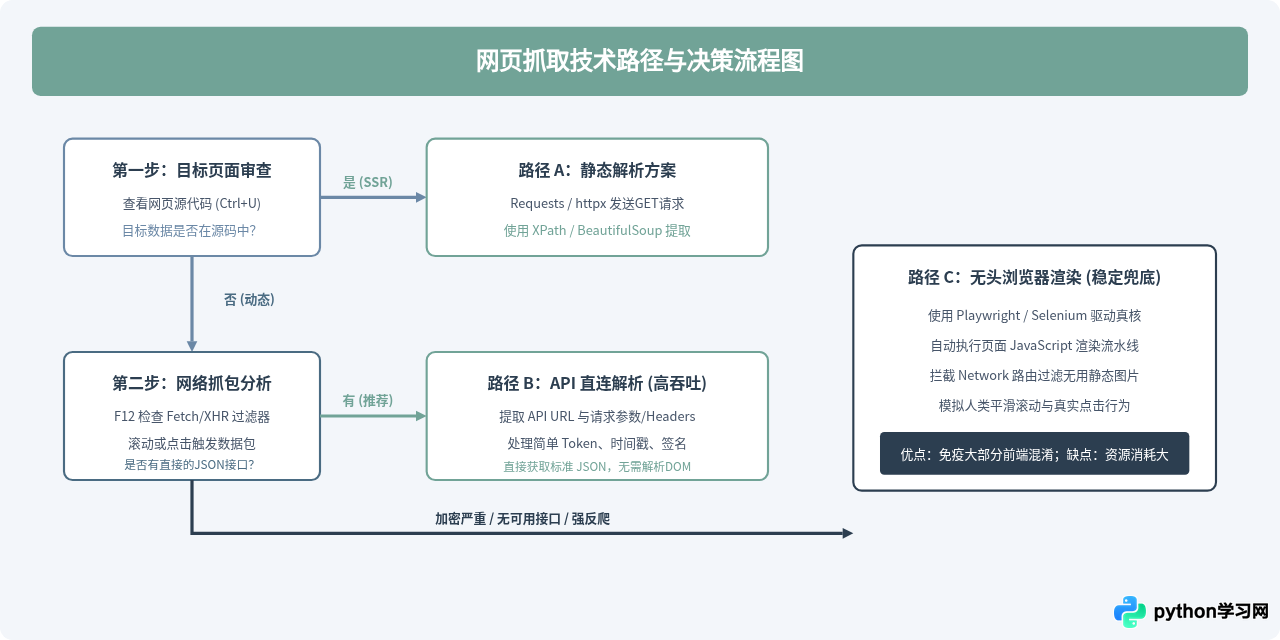
当网页采用Vue、React或移动端App架构时,页面数据通常通过Ajax或Fetch异步加载。此时直接解析HTML既低效又容易漏掉数据。最优策略是利用浏览器开发者工具(F12)定位底层JSON数据包,直接向API发起请求。
案例 11: 瀑布流无限滚动图片抓包
XHR 接口逆向
在社交媒体或图片分享站点滚动到底部时,定位触发的XHR请求,分析参数中的cursor/offset字段递增规律,直接批量获取图片高清链接。
案例 12: 股票行情秒级实时JSON拉取
时间戳 / 格式解析
财经平台实时推送的行情数据接口,分析请求参数中附带的13位毫秒时间戳验证,并提取多层嵌套字典中的开盘、收盘与交易量字段。
案例 13: 游标式分页数据深度抓取
Cursor Pagination
传统page页码已被游标淘汰。学习从本次请求返回的JSON中提取next_cursor,作为下次请求的URL参数,实现百万级条目的链式抓取。
案例 14: 带Bearer Token的API鉴权
Authorization
针对现代前后端分离架构,学习在HTTP Headers中注入Authorization: Bearer <token>,并处理Token有效期超时与自动刷新重换逻辑。
案例 15: 移动端App网络流量代理抓包
Mitmproxy / Charles
配置移动设备或安卓模拟器的WiFi代理,安装CA根证书信任,通过Mitmproxy脚本实时拦截并保存App内部交互的专属JSON协议包。
案例 16: GraphQL接口灵活查询构建
POST JSON Query
面对GitHub、Shopify等采用GraphQL的接口,构造包含query和variables字段的JSON体,按需精确索取指定字段,避免获取冗余数据。
案例 17: 模拟登录与CSRF Token自动捕获
CSRF-Token
在登录表单提交前,先请求一次登录页提取隐藏的csrf_token或从响应Cookie中提取csrftoken,作为后续POST请求的验证凭据。
案例 18: 账号池与Cookie持久化维护
CookiePool
维护多个有效账号登录态,将Cookie序列化存入Redis。请求时采用轮询策略,定期探测Cookie可用性,失效时自动触发告警或重新授权。
案例 19: ThreadPoolExecutor多线程并发抓取
多线程并发
使用concurrent.futures.ThreadPoolExecutor并发分发网络I/O请求,结合as_completed实时收集处理结果,抓取速度提升5至10倍。
案例 20: 大文件断点续传与Range请求
HTTP Range
在下载几百兆以上数据集时,读取本地已有文件大小,发送带Range: bytes=start-end的头部,支持中断后继续下载,节约带宽与时间。
四、第三阶段:常见反爬机制攻防与逆向进阶(案例21-30)
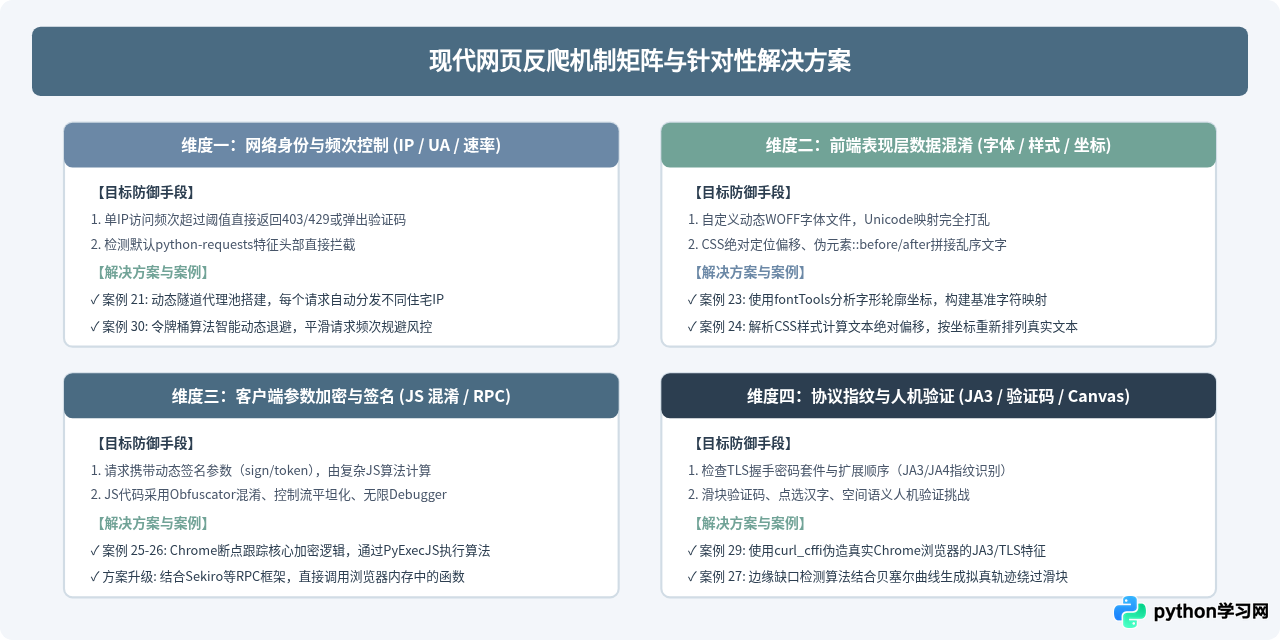
当目标网站部署了专业安全风控策略时,简单的参数模拟会被直接阻断。此时需要深入分析客户端与服务端的指纹特征、反爬混淆算法及行为监测机制。
案例 21: 动态代理IP池搭建与健康校验
ProxyPool
使用Redis存储代理IP,后台异步定时向测试接口发起请求,剔除响应超时或失效的IP,对外提供高可用HTTP代理接口。
案例 22: Canvas与矢量SVG数据渲染提取
SVG / 坐标还原
部分网站将数字转化为SVG曲线或HTML5 Canvas绘制。通过解析SVG中path坐标定义或提取Canvas初始化绘制指令还原真实文本。
案例 23: 动态字体混淆反爬映射解析
fontTools / WOFF
针对美团、猫眼等平台的自定义字体反爬,从网络下载对应.woff文件,利用fontTools提取字符轮廓(Glyph坐标),建立特征比对字典还原数字。
案例 24: CSS背景雪碧图与位移计算还原
CSS Sprite
价格数字以图片雪碧图配合background-position展示。爬取样式文件,解析负偏移像素除以单字符宽度,将视觉显示还原为逻辑字符。
案例 25: 前端JS参数签名加密分析
MD5 / SHA / AES
在浏览器断点调试中定位sign或token生成的代码段,分析其入参时间戳、随机数与密钥规则,在Python中使用hashlib或pycryptodome复现。
案例 26: 本地Node.js子进程执行混淆JS
PyExecJS / subprocess
面对高难度混淆代码,直接剥离核心加密函数,补齐必要的window/document环境伪装后,在Python中通过执行JS脚本完成参数计算。
案例 27: 滑块验证码缺口识别与轨迹拟真
OpenCV / 贝塞尔曲线
利用OpenCV对背景图和滑块图进行边缘灰度化与模板匹配计算位移,生成带有加速度、减速度和轻微抖动的拟真轨迹完成拖动验证。
案例 28: 字符与点选验证码OCR识别
ddddocr / Tesseract
针对变形成扭曲字符或点击指定汉字的验证码,使用本地轻量深度学习OCR模型进行文字与坐标识别,实现自动化过码。
案例 29: TLS/JA3指纹反爬识别与绕过
curl_cffi / tls-client
Cloudflare等WAF会审查Client Hello握手包指纹。使用curl_cffi库模拟真实Chrome/Safari的JA3指纹,绕过底层网络协议层的封锁。
案例 30: 动态限流规避与令牌桶算法
Token Bucket
针对限制每秒请求数的接口,在客户端实现令牌桶或漏桶算法,精准控制请求间歇,并在捕获429状态码时自动指数退避。
五、第四阶段:复杂渲染与无头浏览器自动化(案例31-40)
对于逆向成本极高、逻辑频繁变更或深度依赖复杂环境验证的站点,使用自动化浏览器直接驱动真实渲染引擎是最稳妥的解决方案。现代首选Playwright,其性能与异步支持显著优于传统Selenium。
案例 31: Selenium无头Chrome动态单页采集
Headless Chrome
配置ChromeOptions的headless无头参数,使用WebDriverWait显式等待特定元素加载完成,提取单页应用(SPA)渲染后的最终DOM。
案例 32: Playwright高性能异步爬虫搭建
Playwright Async
基于asyncio架构编写Playwright异步爬虫,充分利用事件循环处理页面等待,同等资源下吞吐量比同步Selenium提升数倍。
案例 33: 无头浏览器反检测与特征抹除
stealth.min.js
在页面启动前注入JS脚本,覆写navigator.webdriver、window.chrome等自动化标识属性,避免被防护脚本直接识别为爬虫。
案例 34: 多层嵌套iframe与跨域页面穿透
frame_locator
针对将核心内容嵌入跨域iframe的页面结构,利用Playwright的frame_locator链式定位子文档元素,解决常规选择器无法穿透的问题。
案例 35: 模拟真实用户键鼠操作流
平滑鼠标 / 随机延时
使用mouse.move配合随机步长轨迹,模拟人类阅读网页时的滚动与悬停,表单输入时加入每个字符30-100毫秒的随机延时。
案例 36: Shadow DOM闭包组件内容穿透
Shadow Root
面对Web Components封装的shadow-root节点,利用现代选择器引擎的 piercing 语法或通过JS执行 shadowRoot.querySelector 提取数据。
案例 37: 网络请求拦截与静态资源阻断
page.route
在Playwright中配置路由拦截规则,阻断.png、.jpg、.woff、css等媒体资源的下载,节省80%以上的网络带宽并大幅提升渲染速度。
案例 38: 多浏览器上下文(Context)并发隔离
BrowserContext
单实例Browser下开启多个独立的BrowserContext,每个上下文拥有互不干扰的Cookie、缓存与代理设置,极大节省内存开销。
案例 39: 动态报表整页长截图与PDF固化
screenshot / pdf
针对无法直接复制文本的图表报表或合同页面,调用page.screenshot(full_page=True)捕获高清整页,或导出为A4格式的PDF归档。
案例 40: 基于CDP底层协议的高级操作
CDP Session
直接创建Chrome DevTools Protocol会话,调用Network.setExtraHTTPHeaders、Emulation.setDeviceMetricsOverride等底层接口精确调控浏览器。
六、第五阶段:工程化架构与大规模分布式爬虫(案例41-50)
当抓取规模从数万提升到千万甚至数亿级别时,单机脚本将彻底无法支撑。必须采用具备良好分层架构的框架(如Scrapy),配合分布式协调中间件(Redis)、海量去重算法与容器化部署方案。
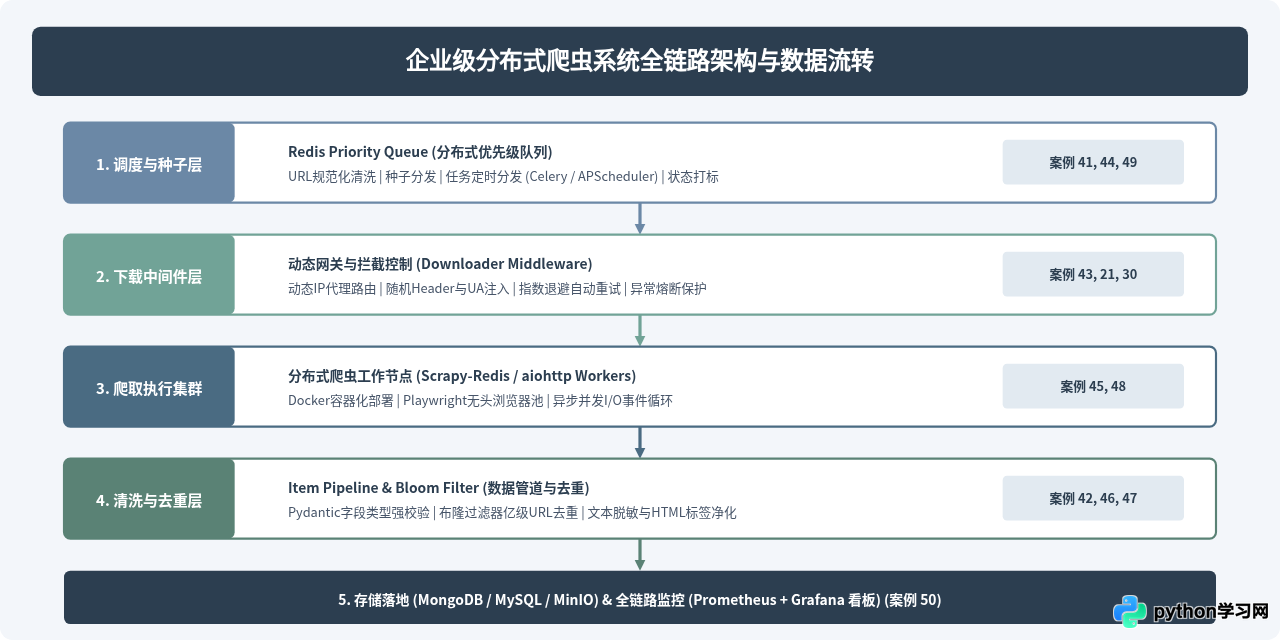
案例 41: Scrapy标准工程结构与Item建模
Scrapy Core
使用scrapy startproject初始化脚手架,定义清晰的scrapy.Item数据模型,通过Spider实现规范化的请求发起与字段提取。
案例 42: Scrapy ItemPipeline数据入库
ItemPipeline
编写多个独立的Pipeline处理类,按顺序完成字段格式化、无效数据剔除,以及批量写入MongoDB与MySQL数据库。
案例 43: 自定义Downloader Middleware
Middleware
深入Scrapy下载中间件机制,编写process_request处理动态代理与User-Agent切换,编写process_response拦截验证码重试。
案例 44: 基于Redis的Scrapy分布式扩展
Scrapy-Redis
引入scrapy-redis,将请求调度器与指纹集合迁移至Redis,实现多台云服务器上的爬虫节点共享任务队列协同作业。
案例 45: aiohttp原生轻量高并发爬虫引擎
asyncio + aiohttp
脱离重型框架,基于asyncio.Queue与aiohttp.ClientSession自主设计微型异步爬虫引擎,在单节点实现上万并发连接吞吐。
案例 46: 亿级URL布隆过滤器高效去重
BloomFilter
在海量数据采集场景中,使用基于位图的布隆过滤器替代传统哈希集合,将亿级URL指纹占用的内存从数GB降低至数十兆。
案例 47: Pydantic数据Schema清洗校验
Pydantic
在数据持久化前,利用Pydantic的BaseModel进行强类型验证、缺失值填充和异常字段校验,杜绝脏数据污染底层仓库。
案例 48: Docker容器化封装与Compose编排
Docker Compose
编写Dockerfile固化运行环境与字体依赖,使用docker-compose一键拉起Crawler、Redis、Mongo及代理池容器集群。
案例 49: 基于Celery的周期性定时调度系统
Celery Beat
构建基于Celery与RabbitMQ的定时调度架构,支持按Cron表达式自动化分发增量抓取任务,实现失败重试与任务状态跟踪。
案例 50: 全链路监控看板与告警熔断机制
Prometheus + Grafana
埋点收集抓取速度、状态码分布、代理消耗等运行指标,利用Prometheus汇聚并在Grafana看板展示,异常率突增时触发钉钉/邮件告警。
七、50个案例的核心技术栈与工具速查表
| 阶段 | 典型案例区间 | 核心库 / 协议 / 工具 | 适用业务场景 | 关键攻关难点 |
|---|---|---|---|---|
| 一、静态基础 | 案例 01 - 10 | Requests, BeautifulSoup4, lxml, urllib3 | 企业官网、博客文库、规范公开报表 | DOM选择器精准匹配、编码转换、网络波动容错 |
| 二、接口动态 | 案例 11 - 20 | Chrome DevTools, Mitmproxy, ThreadPool | 瀑布流、长列表、移动端App、前后端分离站点 | 网络流量过滤分析、鉴权Token刷新、状态保持 |
| 三、反爬对抗 | 案例 21 - 30 | fontTools, OpenCV, PyExecJS, curl_cffi | 电商平台、房产租赁、高频交易行情站 | 字体坐标映射、JS控制流平坦化、JA3指纹伪造 |
| 四、动态渲染 | 案例 31 - 40 | Playwright, Selenium, Chrome CDP | 重度前端混淆、复杂人机验证、Canvas/PDF图表 | 自动化环境指纹消除、资源拦截加速、异步调度 |
| 五、工程落地 | 案例 41 - 50 | Scrapy-Redis, aiohttp, BloomFilter, Docker | 千万级全网聚合、持续性数据仓库同步 | 内存去重开销控制、高并发网络I/O吞吐、集群监控 |
八、开发建议与合规注意事项
学习建议:初学者不要一开始就将时间耗费在逆向高难度商业网站上。推荐按照顺序推进:先完成前10个案例打牢网络协议基础,进而通过11-20案例培养直接抓包分析API的习惯(这通常能解决80%的实际业务需求)。当API遇到签名阻断时再深入学习21-30案例的逆向与反爬知识。
合规与法律边界:网络爬虫必须遵循合法合规原则。严格遵守目标网站的
robots.txt协议规范,合理限制并发请求速率,严禁对目标服务器造成高负载瘫痪;绝不获取涉及个人隐私、未公开商业秘密或受到版权强保护的资产数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









