

Python初学者常犯的5个错误及避坑指南
深入剖析Python初学者最常犯的5个典型错误,涵盖可变默认参数、同一性比较、遍历修改列表、作用域陷阱与裸except捕获,提供底层原理图解与可落地的避坑规范。
Python 凭借简洁明了的语法成为众多开发者的首选入门语言。然而,许多初学者在写代码时,往往直接按照直觉书写,忽略了 Python 底层的对象引用机制、作用域判定规则与异常传播方式。这常常导致一些看似完全合乎语法、却在特定输入或多次调用后表现出诡异行为的隐蔽缺陷。本文系统梳理初学者最常犯的 5 个典型错误,从错误表现、底层机理到防御性工程实践逐一展开,帮助你在写出整洁代码的同时彻底避开这些陷阱。
一、将可变对象作为函数的默认参数
在编写函数时,我们经常需要给某些参数设定默认值。许多初学者的第一反应是在参数定义中直接写一个空列表 [] 或空字典 {}。但这正是 Python 最著名的“特性陷阱”之一。
1. 典型错误示例
观察下方代码,该函数旨在向传入的列表中追加元素并返回列表:
def append_task(task, task_list=[]):
    task_list.append(task)
    return task_list

# 预期:每次不传 task_list 时,得到一个只包含当前 task 的新列表
print(append_task("写文档"))  # 输出: ['写文档']
print(append_task("修Bug"))   # 输出: ['写文档', '修Bug'](产生预期外的污染!)
2. 为什么会发生这种情况?
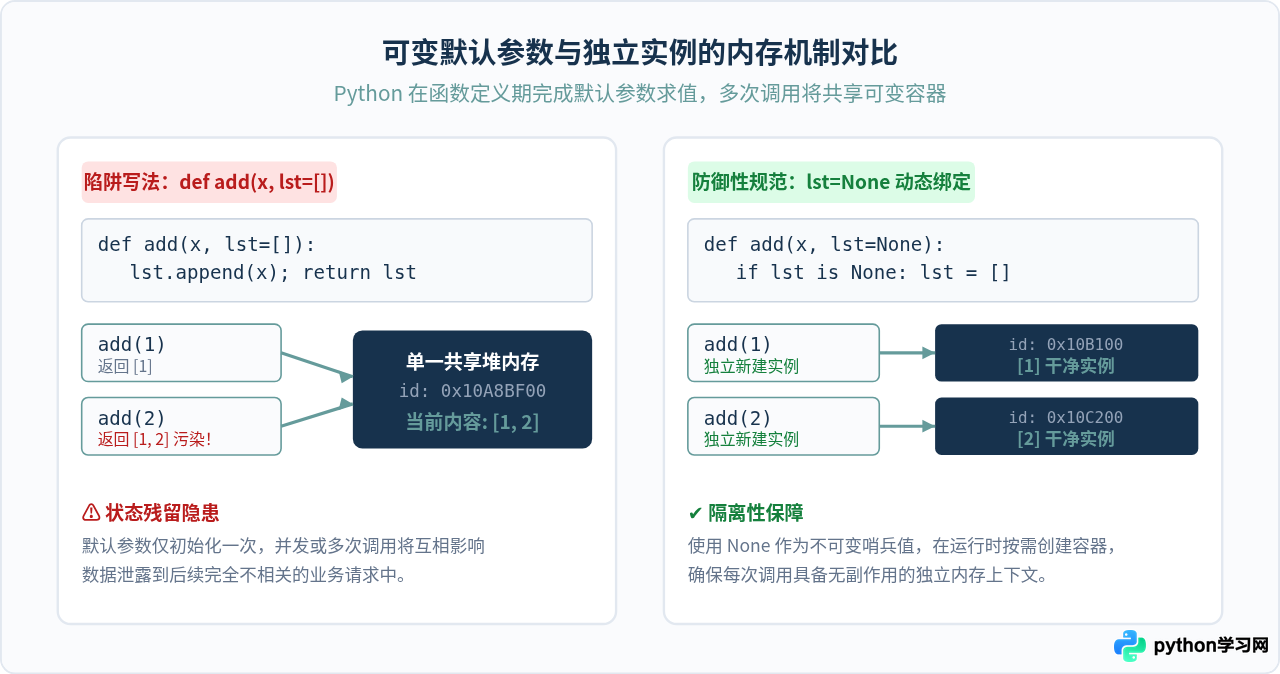
在 Python 中,函数是一等公民,也是一个独立的对象。函数的默认参数只在函数定义被解释执行时求值一次,而不是在每次调用函数时动态生成。也就是说,定义语句 def append_task(..., task_list=[]) 执行后,Python 在堆内存中创建了一个空列表对象,并将函数对象的 __defaults__ 属性直接指向这个列表的内存地址。后续所有未传实参的调用,都将共享并修改这同一个列表实例。
3. 避坑指南
对于任何可变容器(列表、字典、集合或自定义类的可变实例),永远使用不可变对象 None 作为形参的默认占位符,并在函数内部完成防御性初始化:
def append_task(task, task_list=None):
    if task_list is None:
        task_list = []  # 仅在每次未传实参时动态创建独立容器
    task_list.append(task)
    return task_list
二、混淆值相等(==)与引用同一性(is)
在判断两个变量是否相同时,初学者常随意混用 == 和 is,甚至误以为 is 是某种更加高级或“优雅”的相等写法。
1. 典型错误示例
a = 256
b = 256
print(a is b)  # 输出: True(在小整数范围内似乎运行良好)

c = 1000
d = 1000
print(c is d)  # 交互式环境中输出: False!初学者往往在此处陷入困惑
2. 为什么会发生这种情况?
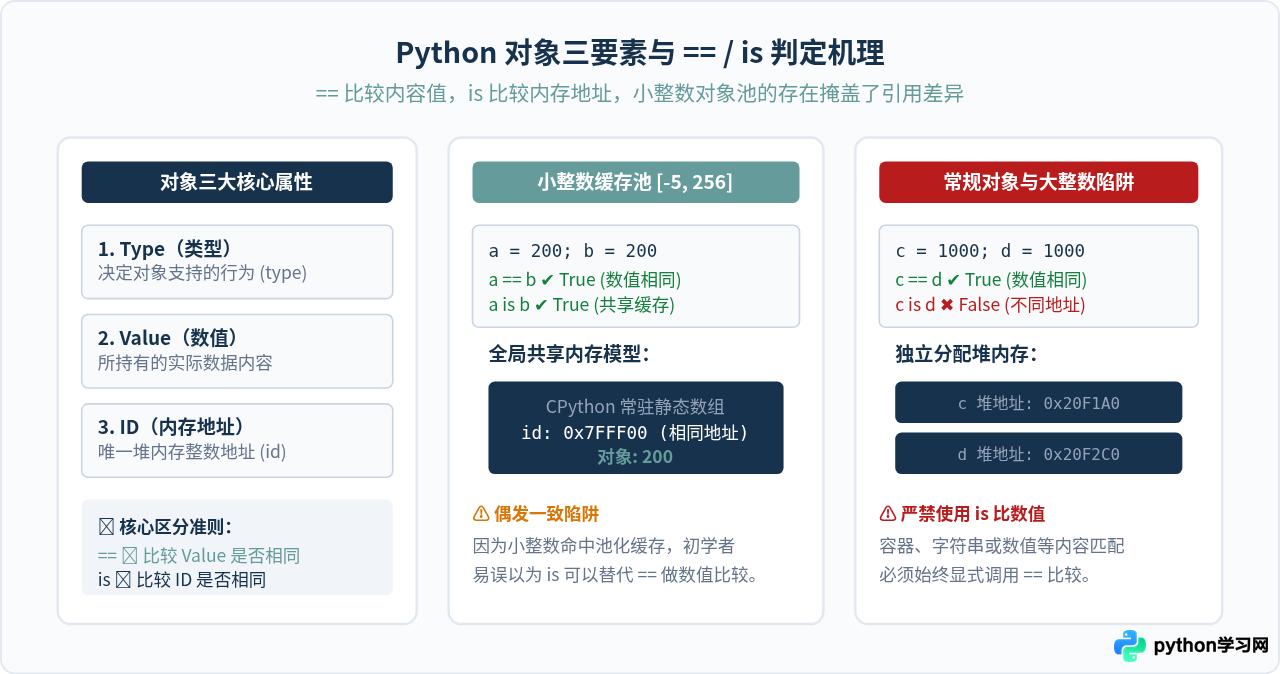
Python 中一切皆对象,每个对象具备三个关键特征:Type(类型)、Value(数值内容)、ID(内存地址)。
==运算符调用对象的__eq__()特殊方法,比较的是两个对象的内容(Value)是否相等。is运算符比较的是两个引用是否指向同一内存地址,等价于比较id(a) == id(b)。
上面的例子之所以在前 256 内表现为 True,是因为 CPython 解释器在内部实现了一套小整数对象池(范围为 -5 到 256)。在这个范围内的整数在虚拟机启动时就已预先分配且全局共享,因此 a 和 b 恰好指向同一个常驻对象。超出这个范围的数字(如 1000),解释器每次都会在堆上分配全新的数字对象,两者的 ID 自然不同,导致 is 判定失败。
3. 避坑指南
- 单例对象判断:只有针对全局唯一单例(如
None、True、False)以及自定义枚举项时,使用is或is not,例如规范写法if user is None:。 - 数值与容器比较:所有数值计算、文本匹配、列表与字典内容对比,一律使用
==或!=。
三、在循环遍历列表的同时直接增删元素
当需要从一个列表中剔除不合规的元素时,初学者经常顺理成章地使用 for item in my_list: 遍历并在循环体内调用 my_list.remove(item) 或 del。这种做法会导致严重的漏项和逻辑偏离。
1. 典型错误示例
下面的代码试图删除列表中的所有偶数:
nums = [1, 2, 4, 5, 6]
for n in nums:
    if n % 2 == 0:
        nums.remove(n)

print(nums)  # 输出: [1, 4, 5] —— 数字 4 居然没有被删除!
2. 为什么会发生这种情况?
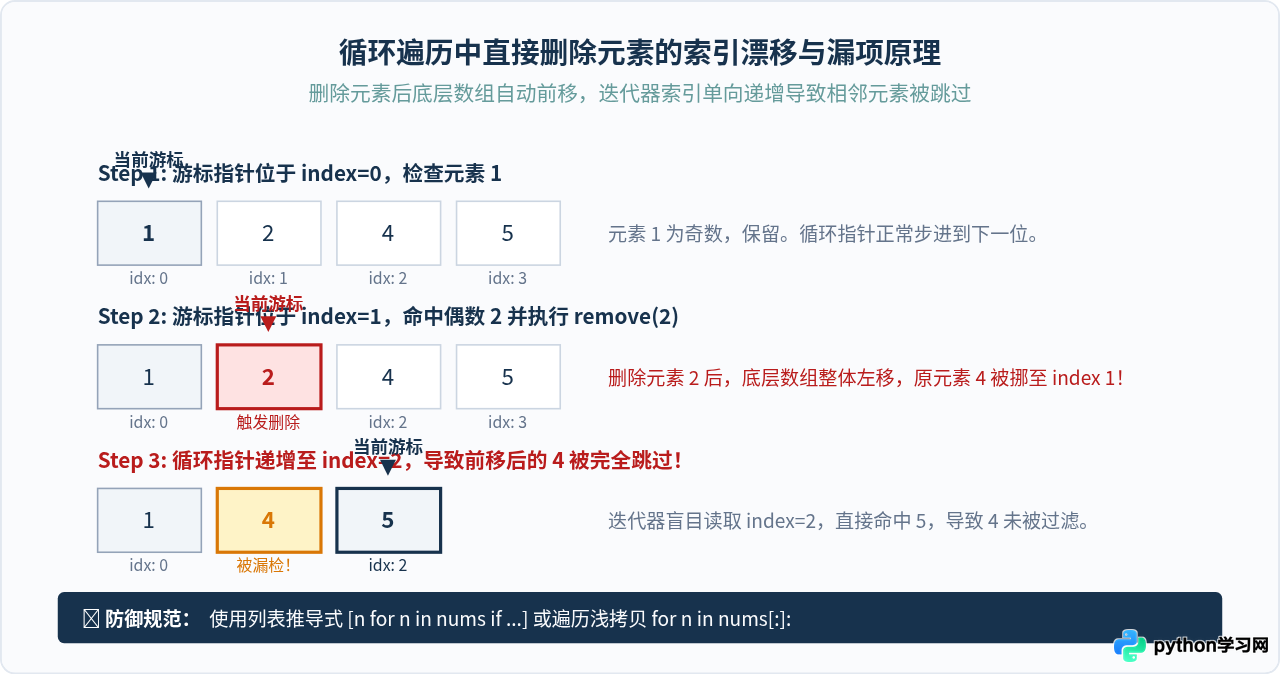
Python 的 for 循环内部通过一个隐式索引计数器来追踪当前遍历的偏移量。当遍历到索引 1(值为 2)并将其从 nums 中移除时,列表发生结构性重整:原索引 2 处的数字 4 自动向前挪动到了索引 1。而下一轮循环中,迭代器的内部指针按部就班递增到索引 2,此时索引 2 对应的值已经是数字 5。原本位于后一位的数字 4 被彻底跳过。
3. 避坑指南
- 首选方案:列表推导式(List Comprehension)
生成新列表替代原位修改,不仅语义清晰,而且底层为 C 语言优化循环,执行效率更高:nums = [1, 2, 4, 5, 6] clean_nums = [n for n in nums if n % 2 != 0] - 必须原地修改时:遍历切片副本
通过nums[:]创建浅拷贝供迭代器读取,修改操作则作用于原列表:for n in nums[:]: if n % 2 == 0: nums.remove(n)
四、作用域陷阱与 UnboundLocalError 报错
初学者在函数内读取全局变量时一切正常,但一旦尝试对变量进行累加或修改,程序便会突然崩溃,抛出令人费解的 UnboundLocalError。
1. 典型错误示例
counter = 0

def track_request():
    counter += 1  # 抛出: UnboundLocalError: local variable 'counter' referenced before assignment

track_request()
2. 为什么会发生这种情况?
Python 遵循 LEGB 作用域解析规则(Local 局部 -> Enclosing 闭包 -> Global 全局 -> Built-in 内建)。但有一个极其关键的编译期机制:只要函数体内出现了对某个变量名的赋值操作(包括 =、+=、-= 等),Python 在编译该函数的字节码时就会无条件将该变量判定为当前函数的局部变量。
在执行 counter += 1 时,右侧表达式需要先读取 counter 的值,但由于 counter 已被标记为局部变量,而此时局部作用域内尚未给它绑定任何对象,因此系统抛出“局部变量在赋值前被引用”的错误,并不会回退去查找全局变量。
3. 避坑指南
虽然可以使用 global counter 或在嵌套函数中使用 nonlocal 关键字解除该限制,但在实际工程中,隐式依赖全局可变状态是代码混乱和并发Bug的温床。更推荐将状态作为显式参数传入,并由函数返回:
# 推荐写法:无副作用的纯函数设计
def track_request(current_count):
    return current_count + 1

counter = track_request(counter)
五、滥用裸 except 捕获吞掉真实异常
为了防止程序闪退,很多新手喜欢在可能出错的地方套上一个宽泛的 try...except:,并在异常分支里写上 pass 或简单的打印。这不仅无法真正解决问题,还会让后续排错陷入灾难。
1. 典型错误示例
try:
    user_input = get_user_data()
    result = calculate_score(user_input)
except:
    pass  # 极度危险:程序看似继续运行,但数据状态已损坏
2. 为什么会发生这种情况?
裸 except: 实际上捕获的是 BaseException。这不仅会捕获你的业务代码报错,还会拦截:
KeyboardInterrupt:用户在终端按下 Ctrl+C 时发送的中断信号,导致程序无法正常被手动终止;SystemExit:系统退出信号;- 致命代码拼写错误:如函数名打错导致的
NameError或AttributeError。这些本应在开发阶段立即修复的低级Bug会被静默吞没,使得下游逻辑拿到None或无效数据,最终在完全无关的地方引发更离奇的连锁故障。
3. 避坑指南
- 精准捕获特定派生异常:明确声明捕获预期的异常类型,如
ValueError、KeyError或IOError。 - 保留堆栈上下文:若需要做兜底处理,必须使用
logging.exception()记录完整的回溯轨迹,或者在处理后重新向上抛出:
import logging

try:
    user_input = get_user_data()
    result = calculate_score(user_input)
except (ValueError, KeyError) as err:
    logging.warning(f"输入解析失败: {err}")
    result = 0  # 给定明确的保底默认值
六、Python初学者避坑准则与规范矩阵
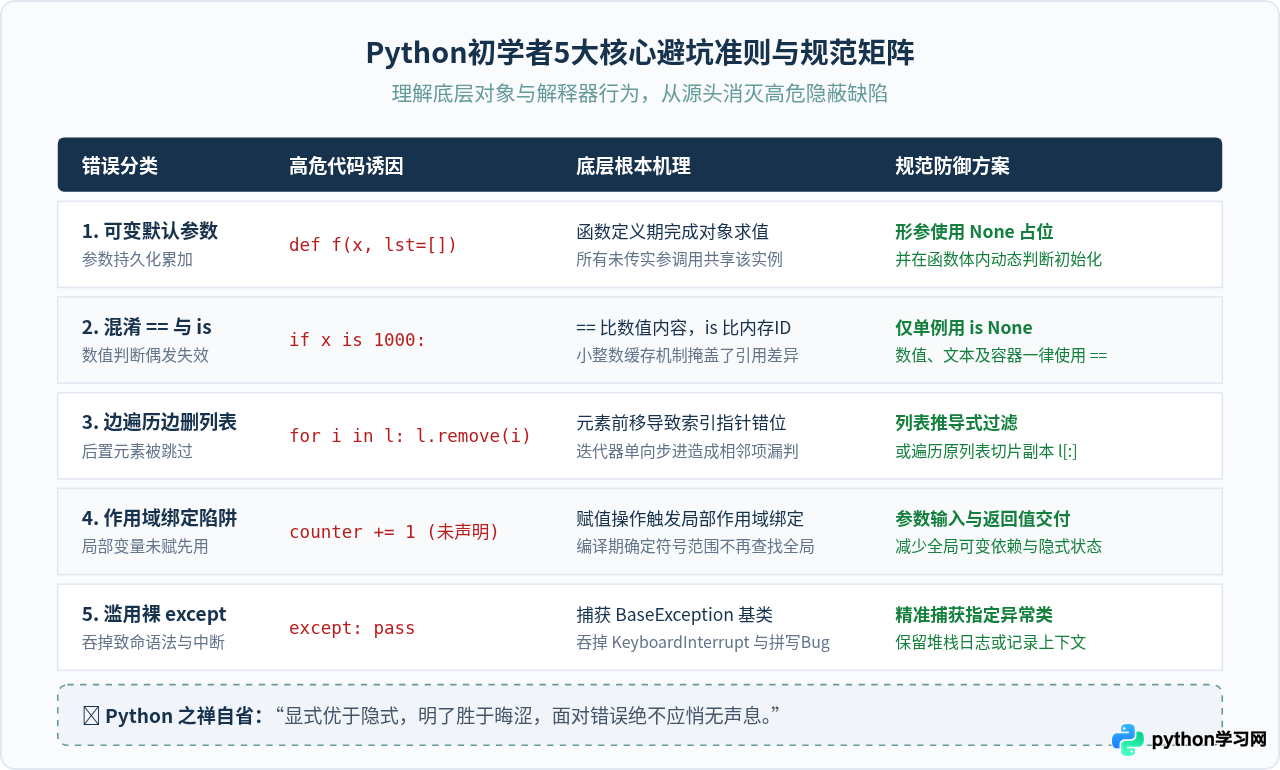
为了帮助大家建立系统化的防御性编程直觉,下方的架构全景矩阵对上述 5 个高频错误进行了横向对比与归纳,展示了从诱因机理到防范规范的完整闭环:
七、结语:写出稳健 Python 代码的自查清单
掌握一门编程语言,不仅在于熟悉其表层的语法糖,更在于理解解释器在背后如何调度内存与管理变量。在日常编码与提交 Review 前,建议对照以下简明自查表:
| 检查维度 | 风险信号 | 合格标准 |
|---|---|---|
| 函数参数 | 定义处存在 arg=[] 或 arg={} |
默认值使用 None,在函数内部按需动态新建 |
| 逻辑比较 | 使用 is 比较整数、浮点数或字符串 |
只有比较 None 时用 is,其余一律使用 == |
| 容器迭代 | 在 for x in lst: 循环体中调用 remove |
改用列表推导式重构,或使用 lst[:] 副本遍历 |
| 状态管理 | 在函数内部直接修改外部全局变量 | 显式通过形参传入数据,通过 return 交付结果 |
| 异常捕获 | 代码中出现裸 except: 或静默 pass |
指明具体的 Exception 派生类,并记录错误日志 |
养成防御性编程习惯,主动站在解释器的角度审视代码执行路径,你的 Python 代码将会变得更加健壮、可靠且优雅。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









