

Python增强赋值运算符+=陷阱:可变对象引用变化分析
深入剖析Python中增强赋值运算符+=在可变对象与不可变对象上的底层机制差异,通过对象内存引用变化、特殊方法__iadd__与__add__解析及元组嵌套列表等经典陷阱,帮助开发者规避隐蔽的引用副作用Bug。
在 Python 编程中,+= 通常被当作 a = a + b 的简写方式。然而在处理可变对象(如列表、字典、集合)与不可变对象(如整数、字符串、元组)时,+= 的底层运行逻辑与常规加法赋值存在本质差异。这种差异会导致变量内存引用是否重定向的截然不同表现,并衍生出许多极为隐蔽的副作用与程序异常。本文将从底层方法实现、内存引用检测及字节码指令入手,彻底厘清 += 的行为陷阱与应对方案。
一、核心机制:+= 运算符的双重底层分流
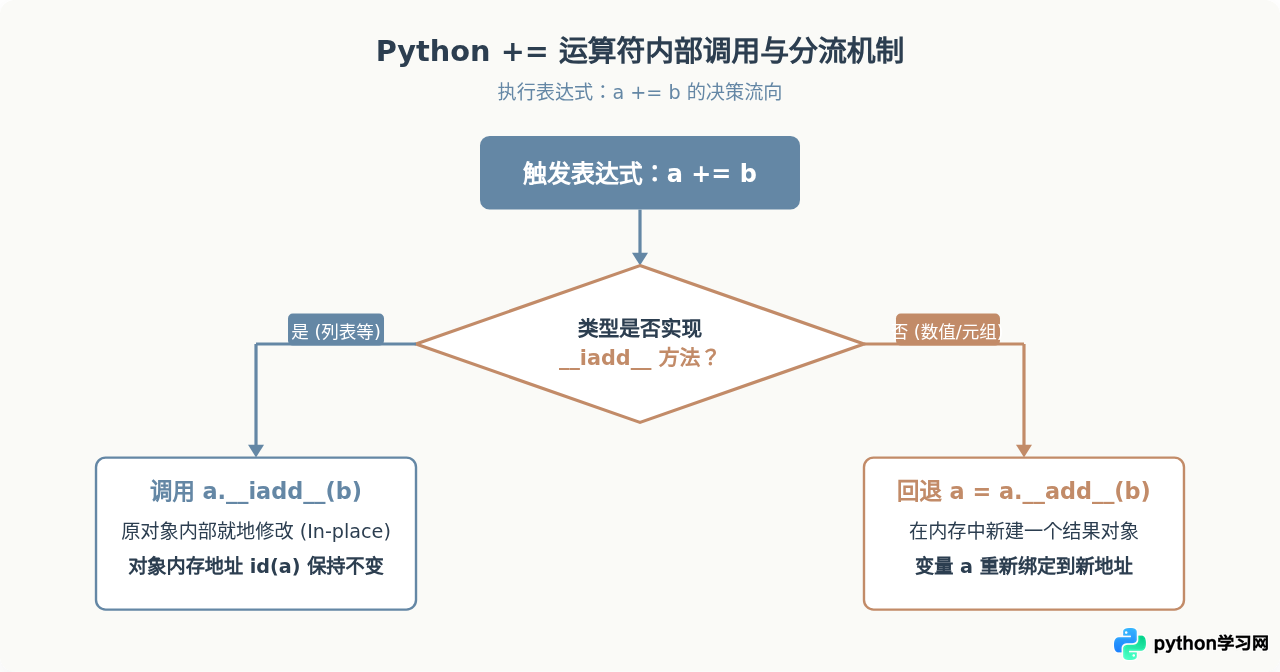
表面上看,+= 只是单纯的“相加并赋值”,但 Python 在语言规范中为增强赋值定义了专属的特殊方法调度优先级:
- 优先尝试调用
__iadd__(就地修改):如果左侧操作数所属的类实现了__iadd__方法,Python 会直接调用该方法。对于可变对象(如list),该方法通常在原对象内部就地追加元素,并返回该对象本身的引用。此时不会在内存中创建新对象。 - 回退调用
__add__(新建对象):如果该对象未实现__iadd__方法(例如不可变类型int、str、tuple),解释器则会回退执行普通加法__add__,在内存中计算并创建一个全新对象,最后将变量名重新绑定(Rebind)到这个新对象上。
二、内存引用实测:不可变对象与可变对象的对比
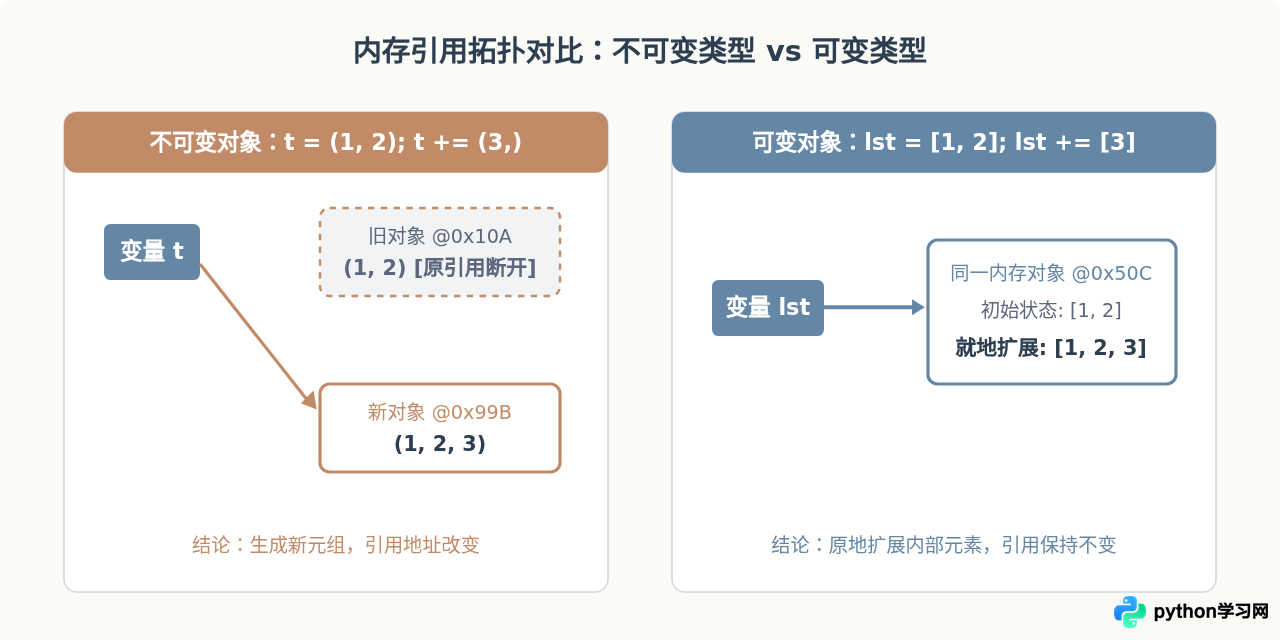
通过内置函数 id(),我们可以直观观察执行 += 前后变量所指向对象的内存唯一标识符。
1. 不可变对象(以整数与元组为例)
不可变对象在初始化后其内部状态便不能变更。对不可变对象应用 +=,必然会分配新的内存空间:
# 整数示例
x = 1000
print("运算前 id:", id(x))
x += 1
print("运算后 id:", id(x))  # id 发生改变,绑定到了新整数对象

# 元组示例
t = (1, 2)
print("元组运算前 id:", id(t))
t += (3,)
print("元组运算后 id:", id(t))  # id 发生改变,创建了新元组
2. 可变对象(以列表为例)
对于实现了 __iadd__ 的 list,+= 实际上等价于调用 list.extend(),操作直接在原内存区域进行:
# 列表示例
lst = [1, 2]
print("运算前 id:", id(lst))
lst += [3]
print("运算后 id:", id(lst))  # id 完全一致!依然是同一个列表对象
但如果把 lst += [3] 改写为 lst = lst + [3],情况则完全不同:普通加号 + 调用的是 __add__,会先构造一个合并后的新列表,再赋给 lst,导致 id(lst) 改变。
三、经典陷阱一:元组嵌套列表执行 += 的“薛定谔报错”
这是 Python 进阶面试与实际生产中极具迷惑性的一个经典问题。请观察以下代码并预判其执行结果:
t = ([1, 2], "hello")
try:
    t[0] += [3, 4]
except TypeError as e:
    print("发生异常:", e)

print("最终元组 t 的内容:", t)
1. 执行结果
发生异常: 'tuple' object does not support item assignment
最终元组 t 的内容: ([1, 2, 3, 4], 'hello')现象看似自相矛盾:代码既抛出了 TypeError 异常声明不支持对元组元素赋值,但元组内部的列表却实打实地被修改了。为什么会产生这种现象?
2. 字节码级深层原理解析
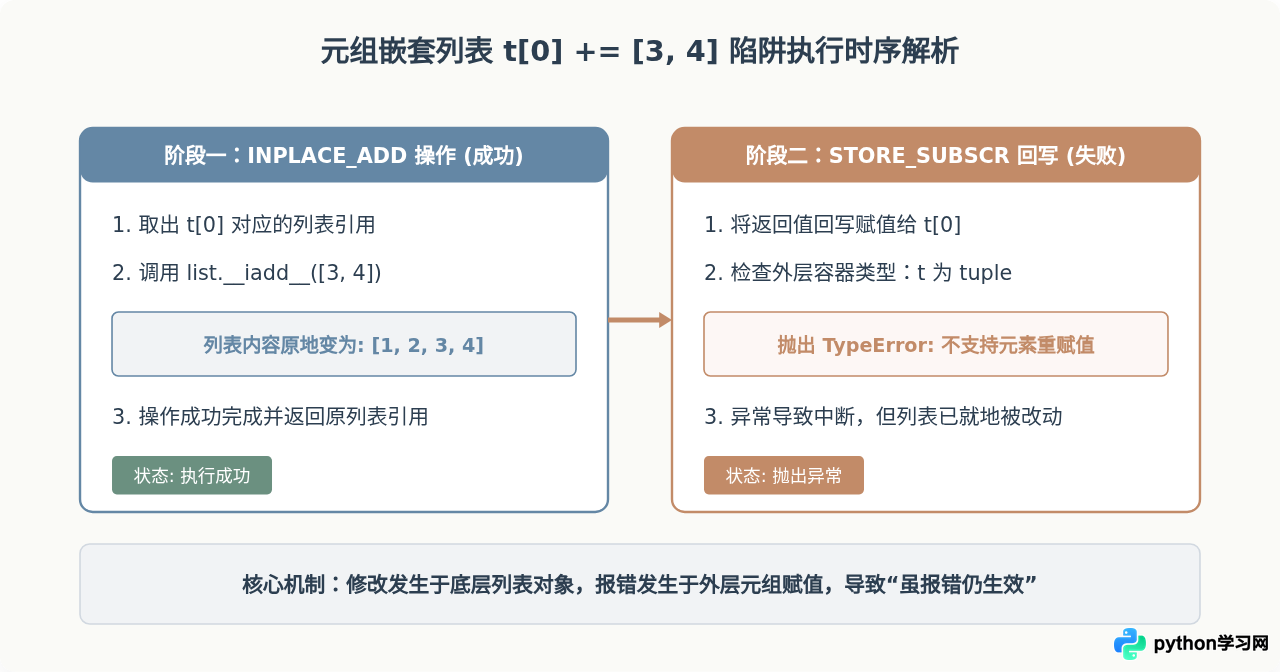
在 Python 底层,表达式 t[0] += [3, 4] 会被拆解为两个阶段执行:
- 取值与就地增量操作:解释器首先计算
t[0]得到列表对象,然后对该列表执行INPLACE_ADD(即调用列表的__iadd__)。列表在内存中成功追加了[3, 4],变为了[1, 2, 3, 4],并且该方法返回了该列表的原引用。 - 执行回写赋值操作:增强赋值语句规定,
__iadd__的返回值必须重新赋值给左侧目标(即执行类似于t[0] = result的STORE_SUBSCR指令)。然而t是不可变元组,元组严格禁止任何下标项的重绑定操作,因此在执行STORE_SUBSCR时触发了TypeError。
正是因为“修改列表”发生在第一步且已成功落地,而“禁止赋值”发生在第二步,才导致了“修改成功却同时抛出异常”的怪异表象。
四、经典陷阱二:别名共享与函数传参副作用
由于可变对象在 += 运算时不改变引用地址,当一个对象存在多个变量名引用(别名,Aliasing)时,会产生意料之外的联动改动。
1. 别名变量意外同步被改
对比以下两段看似相近的代码:
# 场景 A:使用 +=
list_a = [1, 2]
list_b = list_a
list_a += [3]
print("list_b:", list_b)  # 输出 [1, 2, 3]!list_b 受到影响!

# 场景 B:使用 +
list_a = [1, 2]
list_b = list_a
list_a = list_a + [3]
print("list_b:", list_b) # 输出 [1, 2]!list_b 保持原状,不受影响!+= 就地修改了底层的单一列表,list_b 依然指向该列表,因此观测到变化;场景 B 中 list_a + [3] 新建了独立对象,list_a 指向新对象,而 list_b 依然绑定在旧对象上。
2. 函数参数传递中的隐式篡改
在函数传参时,传递的是对象引用的副本。如果函数内部直接对入参使用 +=,调用方传入的实参将被原地修改:
def append_data(items):
    items += ["DONE"]  # 就地修改外部实参!

data = ["task1", "task2"]
append_data(data)
print(data)  # 输出 ['task1', 'task2', 'DONE'],原列表被隐式污染
五、避坑准则与防御式编程
理解了 += 在不同对象上的内存行为后,我们在实际开发中应遵循以下工程实践:
| 业务场景 | 推荐做法 | 技术理由与防范目标 |
|---|---|---|
| 对元组内部的可变容器做追加 | 显式调用 t[0].extend(...) 或 t[0].append(...) |
明确意图为就地操作,不触发元组下标回写,消除 TypeError 异常 |
| 函数入参处理列表且不应影响外部 | 在函数开头切片复制 items = items[:] 或使用普通加法 items = items + [val] |
切断外部对象的引用绑定,保证函数纯粹性与无副作用 |
| 需要明确原位高性能扩展 | 使用 lst += extra 或 lst.extend(extra) |
避免 lst = lst + extra 重复分配大块内存与数据搬迁 |
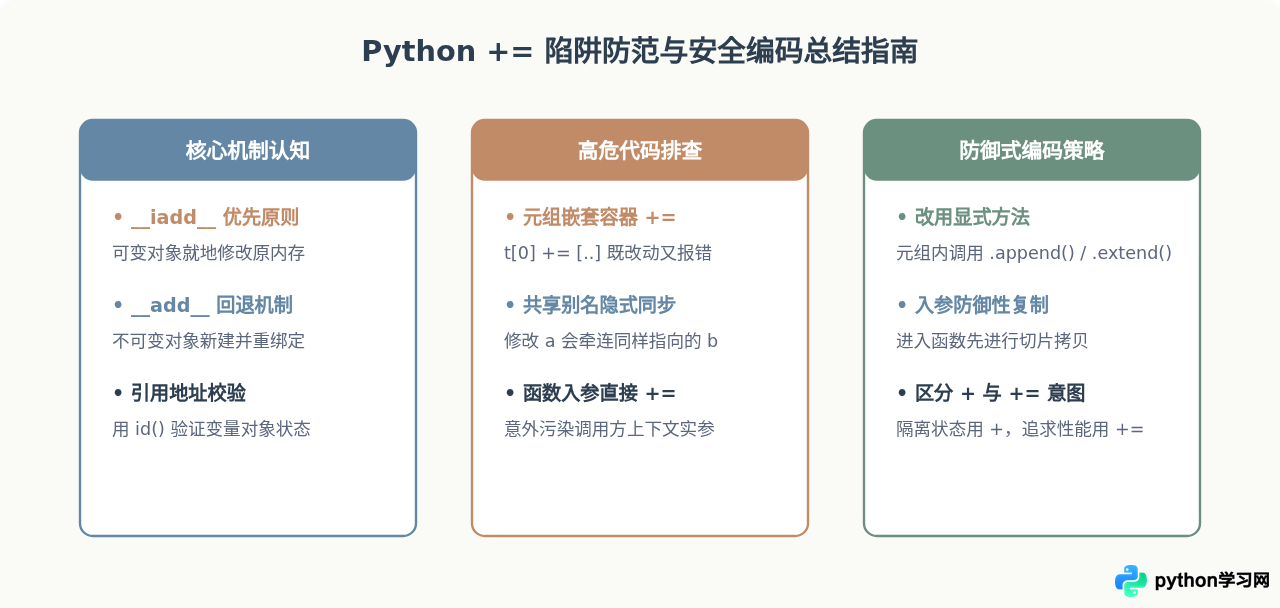
总结
Python 的增强赋值运算符 += 绝不仅是简单的语法糖。对于不可变对象,它遵循“创建新对象并重定向指针”的安全语义;而对于可变对象,它优先调度 __iadd__ 执行“就地修改”,维持原有引用。在日常编码与架构设计中,务必警惕别名共享、函数传参及元组嵌套场景下的隐式状态变动,合理运用显式方法与防御性拷贝,从而彻底规避引用变化引发的隐蔽缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









