

Python反射读取现有数据库表结构的方法
详细讲解在Python中反射读取已有数据库表结构的方法。通过SQLAlchemy的inspect轻量审查器与Table autoload机制,演示如何快速获取表名、字段定义、主键、外键与索引,并深入解析适用场景与生产注意事项。
在编写数据库维护脚本、数据同步程序或自动化代码生成器时,我们经常需要面对已经存在的数据库。面对成百上千张结构复杂的表,人工逐个手写对应的数据模型(ORM Model)不仅繁琐,而且极易遗漏字段类型、主键或约束条件。在 Python 中,通过“数据库反射”(Database Reflection)机制,程序可以直接向数据库服务端查询系统元数据,动态提取现有表的字段列表、数据类型、索引和外键关系。本文将从最主流、成熟的 SQLAlchemy 方案切入,分别演示轻量级元数据检查和表对象动态加载的具体实现,并剖析实际使用中的核心注意事项。
一、什么是数据库反射及其工作流程
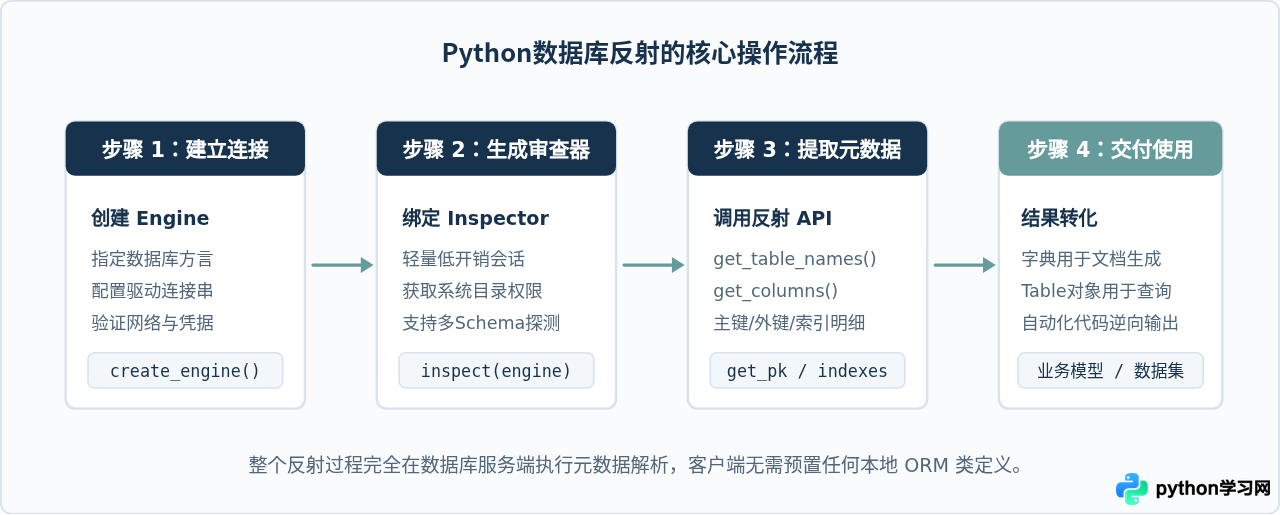
数据库反射是指在运行时无需开发者预先声明代码模型,由程序直接连接数据库并解析存储在系统目录(如 information_schema、系统视图或元数据字典)中的表结构信息,进而在内存中还原出完整的表定义对象。这种方式广泛应用于逆向工程、动态报表查询、数据迁移校验等场景。
在 Python 生态中,完成这一任务的标准流程通常分为四个环节:创建统一的数据库连接引擎(Engine)、实例化元数据检查器或载入模式字典、按需提取目标表的元数据明细,最后转换为字典或结构化对象供上层业务消费。
二、环境准备与连接建立
在开始反射前,首先需要安装 Python 中最权威的数据库工具包 SQLAlchemy 以及对应数据库的驱动程序。例如对于 PostgreSQL 可以使用 psycopg2 或 psycopg,对于 MySQL 可以安装 pymysql,而 SQLite 则属于 Python 标准库内置,无需额外安装驱动:
pip install sqlalchemy pymysql psycopg2-binary准备好驱动后,使用 create_engine 建立数据库连接对象。为了让示例可以直接独立运行,以下代码使用 SQLite 并在内存中动态预置一张具备主键、非空约束、默认值和索引的测试表:
from sqlalchemy import create_engine, text

# 创建连接引擎(此处使用内存SQLite演示,MySQL/PostgreSQL只需替换连接串)
# 例如 MySQL: create_engine("mysql+pymysql://user:pwd@localhost:3306/test_db")
engine = create_engine("sqlite:///:memory:", echo=False)

# 初始化一张包含典型约束的测试表
with engine.connect() as conn:
    conn.execute(text("""
        CREATE TABLE sys_users (
            id INTEGER PRIMARY KEY AUTOINCREMENT,
            username VARCHAR(50) NOT NULL UNIQUE,
            email VARCHAR(100) DEFAULT 'unknown@local',
            is_active BOOLEAN DEFAULT 1,
            created_at DATETIME DEFAULT CURRENT_TIMESTAMP
        );
    """))
    conn.execute(text("CREATE INDEX idx_user_email ON sys_users(email);"))
    conn.commit()
三、方法一:使用 inspect 模块做轻量级只读审查
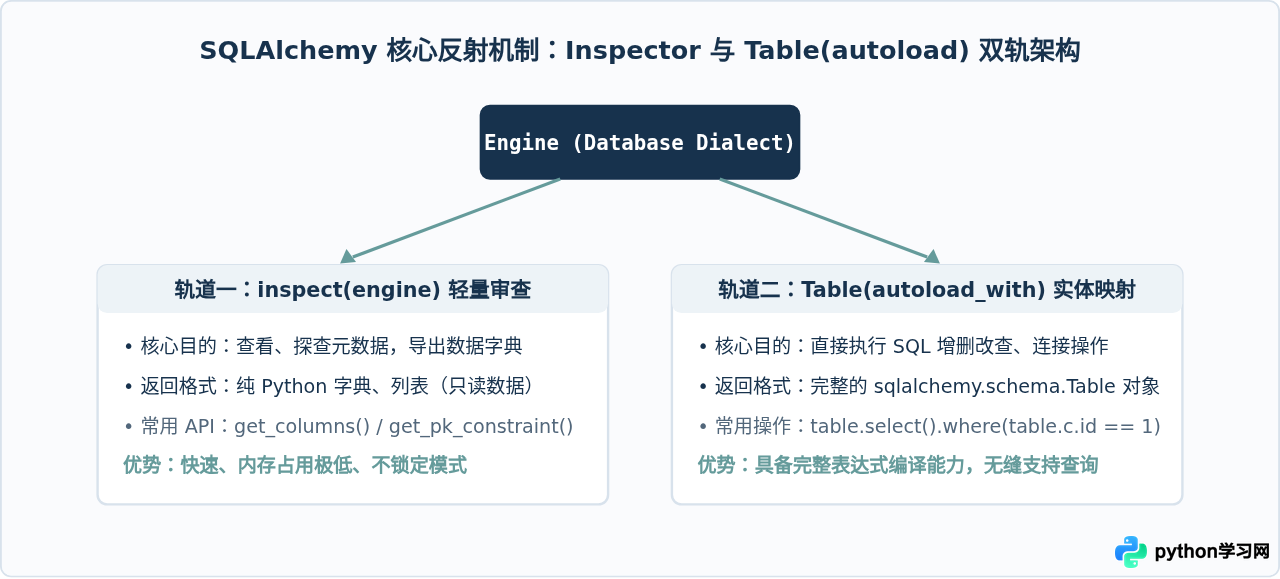
如果你只需要查看表名、获取列名、字段类型、主键或索引结构,以用于生成数据字典、导出 Excel 架构或做自动化模型校验,推荐直接使用 SQLAlchemy 提供的 inspect 审查器。这种方式只抓取系统元数据,返回最轻量的原生 Python 字典和类型对象,不构建笨重的 Table 实体,性能损耗最小。
1. 获取所有表名与视图名
调用 inspect(engine) 获得审查器实例后,可以使用 get_table_names() 和 get_view_names() 列举当前数据库中存在的所有实体:
from sqlalchemy import inspect

inspector = inspect(engine)

# 获取默认命名空间下的所有表名
tables = inspector.get_table_names()
print(f"检测到的数据表: {tables}")
# 示例输出: 检测到的数据表: ['sys_users']
2. 读取列定义(Column Information)
通过 inspector.get_columns(table_name) 可以获取表中每一个字段的详细属性。每个字段返回一个字典,包含 name(列名)、type(SQLAlchemy 类型实例)、nullable(是否允许为空)、default(默认值定义)以及 primary_key 等关键属性:
columns = inspector.get_columns("sys_users")
for col in columns:
    print(f"列名: {col['name']:<12} | 类型: {str(col['type']):<14} | 允许NULL: {str(col['nullable']):<6} | 默认值: {col.get('default')}")
执行该段代码后的示例输出如下:
示例输出:
列名: id           | 类型: INTEGER        | 允许NULL: False  | 默认值: None
列名: username     | 类型: VARCHAR(50)    | 允许NULL: False  | 默认值: None
列名: email        | 类型: VARCHAR(100)   | 允许NULL: True   | 默认值: 'unknown@local'
列名: is_active    | 类型: BOOLEAN        | 允许NULL: True   | 默认值: 1
列名: created_at   | 类型: DATETIME       | 允许NULL: True   | 默认值: CURRENT_TIMESTAMP
3. 读取主键、外键及索引
除了普通字段,数据库约束对于理解表结构同样重要。Inspector 提供了对应的专用方法:
# 读取主键信息
pk_info = inspector.get_pk_constraint("sys_users")
print("主键字段:", pk_info.get("constrained_columns"))

# 读取索引信息
indices = inspector.get_indexes("sys_users")
for idx in indices:
    print(f"索引名: {idx['name']}, 包含列: {idx['column_names']}, 是否唯一: {idx['unique']}")

# 读取外键关系(如果是关联表)
foreign_keys = inspector.get_foreign_keys("sys_users")
print("外键约束:", foreign_keys)
示例输出:
主键字段: ['id']
索引名: idx_user_email, 包含列: ['email'], 是否唯一: 0
外键约束: []四、方法二:使用 Table 与 autoload_with 加载可操作表对象
如果读取表结构的目的不仅是“查看”,还要在随后的代码中直接执行 select()、insert() 等 SQL 操作,那么将表反射为 sqlalchemy.Table 实例是更直接的方案。在 SQLAlchemy 2.0 及更高版本中,通过指定 autoload_with=engine 参数即可完成单表反射:
from sqlalchemy import MetaData, Table, select

metadata = MetaData()

# 动态反射已存在的 sys_users 表
users_table = Table("sys_users", metadata, autoload_with=engine)

# 打印所有列属性
print("反射生成的列集合:", users_table.c.keys())

# 直接使用反射出的表对象编写查询,无需声明 ORM 类
stmt = select(users_table.c.id, users_table.c.username).where(users_table.c.is_active == True)
print("生成的 SQL 语句:", stmt)
通过 users_table.c(即 users_table.columns 的简写),可以像访问普通 SQLAlchemy 模型属性一样访问表中每一个字段,例如 users_table.c.username.type 可以获取该字段在 SQLAlchemy 体系内映射的类型对象。
五、方法三:全量模式反射与按需过滤
如果希望一次性将数据库中的全部表或多张指定表全部加载到 MetaData 集合中,可以使用 metadata.reflect() 方法:
metadata_all = MetaData()

# 反射数据库内全部表结构
metadata_all.reflect(bind=engine)

# 打印已加载的所有表对象
for tbl_name, tbl_obj in metadata_all.tables.items():
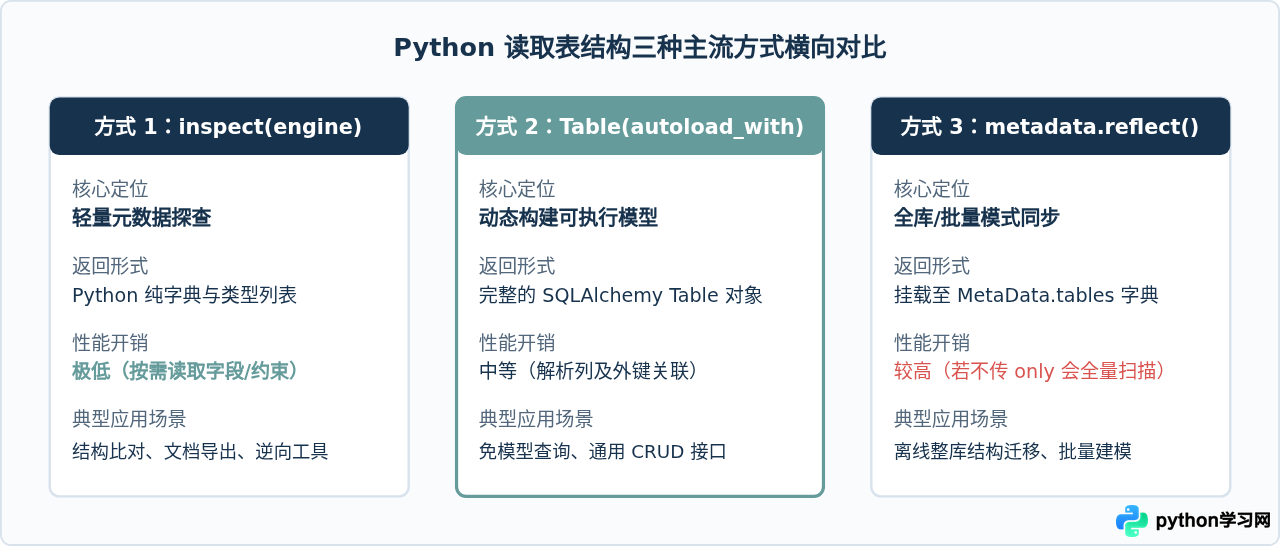
print(f"表: {tbl_name}, 包含 {len(tbl_obj.columns)} 个字段")避坑提示:在生产库中尽量避免执行无参数的 metadata.reflect(bind=engine)。对于包含成百上千张表、大量视图和外键的复杂数据库,全量反射会向数据库系统目录发起大量元数据查询,导致明显的耗时与连接占用。建议务必通过 only 参数按需指定要反射的表清单:
# 仅反射指定的两张关键表,显著减少网络交互与执行时间
metadata_all.reflect(bind=engine, only=["sys_users", "sys_roles"])
六、三种反射读取方案横向对比与技术选型
在面对不同的业务需求时,选择合适的技术手段能大幅减少代码量并提高运行性能。下表和对比图整理了三种主要反射方案的特性对比:
七、生产环境下的关键细节与避坑指南
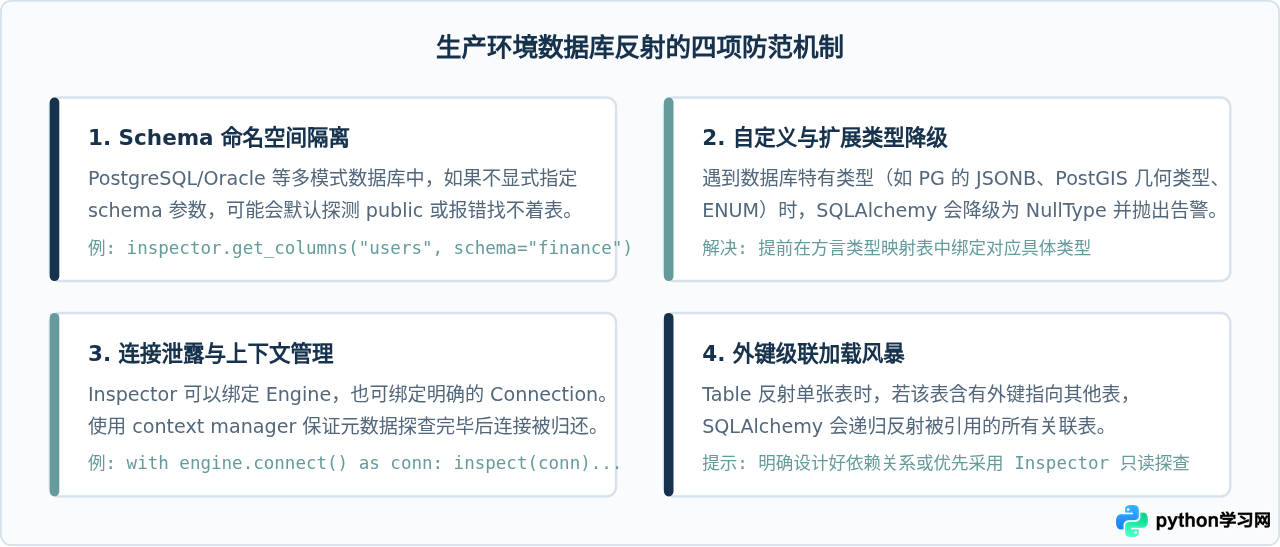
在生产环境的复杂数据库中进行反射时,有四个容易引发异常或性能瓶颈的问题需要特别注意:
-
多模式(Schema)环境明确指定命名空间:
在 PostgreSQL、SQL Server 或 Oracle 这类支持多 Schema 的数据库中,一张表可能隶属于
auth、finance等非默认 Schema。在调用get_columns("users", schema="finance")或Table("users", metadata, schema="finance", autoload_with=engine)时,务必通过schema参数显式指定,否则系统默认只在当前用户的默认模式(如public)中查找,导致抛出NoSuchTableError。 -
外键级联连带反射:
当使用
Table("orders", metadata, autoload_with=engine)时,如果orders表中定义了外键指向users表,SQLAlchemy 会自动连带反射users表结构。如果你的数据库外键网状依赖十分复杂,单表反射可能会引发递归链式查询。如果不希望发生这种级联,推荐优先使用inspect读取字段信息,再手动构建需要的关系。 -
非标准字段类型与警告处理:
某些数据库具备专有的存储类型或用户自定义数据类型(UDT)。当 SQLAlchemy 的内置方言无法精确匹配时,会产生
SAWarning: Did not recognize type 'citext' of column...并回退到NullType。此时只要表用于一般元数据查看,程序仍能正常运行;若要进行严格的模型构建,可以通过在连接方言中注册自定义类型映射(ischema_names)解决。 -
连接生命周期管理:
inspect(engine)在内部会从连接池借出连接并执行查询。如果在大型循环任务中频繁创建和丢弃未妥善管理的引擎或连接,可能会耗尽连接池。最佳实践是配合上下文管理器明确管理连接生命周期:with engine.connect() as connection: inspector = inspect(connection) column_list = inspector.get_columns("sys_users")
八、总结与选择建议
掌握 Python 反射数据库表结构的方法,能显著提升开发动态数据工具和系统架构逆向时的效率。在实际开发中:
- 若任务以分析、导出、对比或报表文档化为核心,优先选用
inspect模块。它具备出色的执行效率、最小的内存开销以及最直接的字典化数据结构。 - 若任务需要在代码中直接运行针对现有表的 SQL 表达式,优先选用
Table(name, metadata, autoload_with=engine),省去手工维护字段映射的同时保留 SQLAlchemy 强大的表达能力。 - 始终关注生产数据库的
schema隔离与外键关联边界,避免无过滤的全局反射,确保代码既高效又健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









