

Python中len()与NumPy .size属性的区别及适用场景
深入解析Python内置函数len()与NumPy数组.size属性的核心区别、底层运行机制、维度处理差异及工程适用场景,附详细代码示例与高清图解。
在处理数值计算和多维数据时,初学者常常混淆 Python 原生内置函数 len() 与 NumPy 数组的 .size 属性。核心区别在于:len() 仅返回容器最外层维度(即轴 0)的元素长度;而 NumPy 的 .size 属性返回的是数组中所有元素的总个数(各轴长度的乘积)。对于一维数据,两者的返回数值恰好相同,但一旦进入高维张量、标量或不规则序列,两者的底层行为与返回值会发生根本分化。本文将拆解两者的运行原理、对比不同维度下的具体表现,并给出明确的工程选型建议。
一、核心机制与计算模型对比
理解两者差异的前提是看清它们对“长度”这一概念的抽象视角。Python 的 len() 是一个全局内置函数,其本质是协议调用;而 .size 是 NumPy 核心数据结构 ndarray 的内置属性,直接反映底层连续或跨步存储块中的数据单元总数。
| 对比维度 | Python len(obj) | NumPy ndarray.size |
|---|---|---|
| 定义与形式 | 内置函数(协议接口) | 类属性(C 语言结构体字段) |
| 度量目标 | 最外层容器的第一维度大小(Axis 0) | 数组内所有元素的总数量(所有轴长度的乘积) |
| 支持对象 | 原生列表、元组、字符串、字典、ndarray 等 | 仅限 NumPy 数组(ndarray 及衍生类型) |
| 0 维数组支持 | 抛出 TypeError: len() of unsized object |
正常返回整数 1 |
| 时间复杂度 | O(1)(读取对象元数据中的 ob_size) | O(1)(直接读取 PyArrayObject 中的 Py_ssize_t) |
二、底层工作原理解析
1. Python len() 的底层调用机制
在 Python 中,内置函数 len(x) 并非直接读取某个特定名称的属性,而是调用对象底层的特殊魔法方法 x.__len__()。对于 CPython 解释器内置的标准序列(如 list、tuple、dict),CPython 会直接读取对应 C 结构体中的 ob_size 字段,耗时为严格的 O(1)。
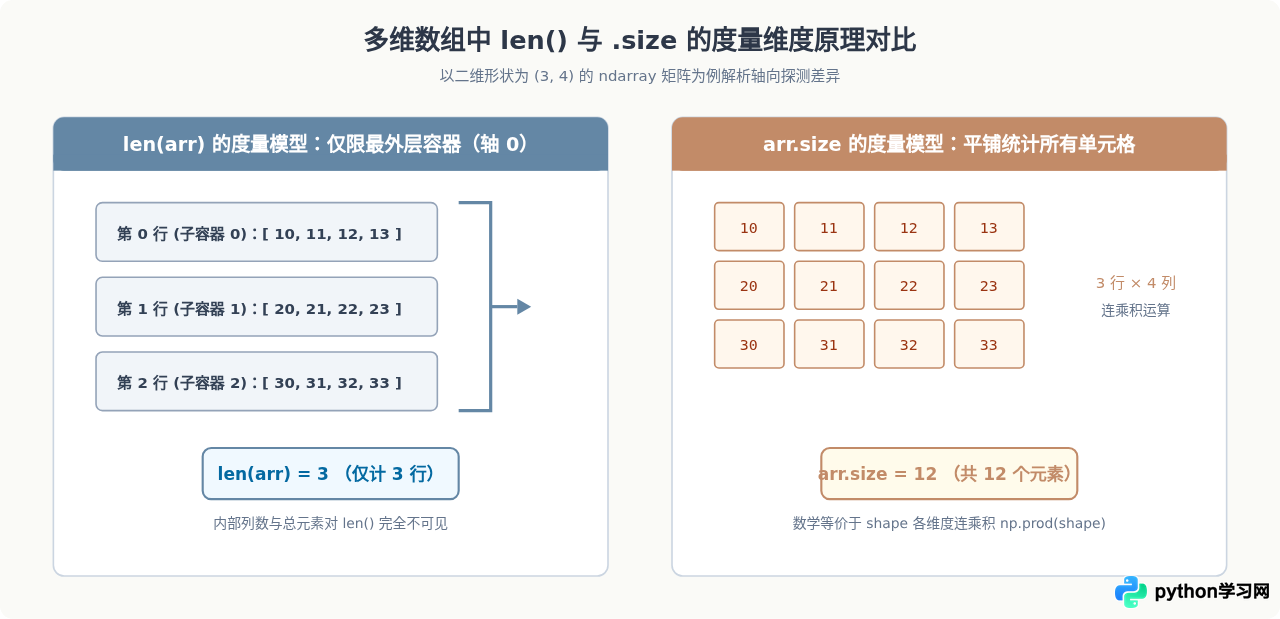
当将 NumPy 数组传入 len(arr) 时,NumPy 的 C 扩展实现了映射协议(Sequence Protocol)中的 sq_length 槽函数。该函数只返回数组 shape[0] 的数值。因此,即使一个三维数组包含 1,000,000 个浮点数,只要其第一维度长度为 10,len(arr) 的返回值就恒为 10。
2. NumPy .size 的底层实现机制
NumPy 的 .size 是在 C 语言层级预先计算并缓存在 PyArrayObject 结构体中的标量字段。当数组被创建、重塑(reshape)或切片时,NumPy 会计算其各维度尺寸的乘积:
# 数学等价关系
arr.size == np.prod(arr.shape)
由于该值直接保存在元数据中,读取 arr.size 不需要进行动态数组循环或逐元素遍历,也是极速的 O(1) 操作。值得注意的是,.size 关注的是“逻辑元素总数”,并不因跨步切片(Strided View)是否连续而发生改变。
三、多维度数据场景下的具体表现与代码验证
为了直观掌握两者的区别,我们通过不同维度的典型场景进行代码实测与结果对照。
场景 1:一维数组(表现完全一致)
在一维数组中,第一维度的大小与元素总个数重合,因此两者返回值相同:
import numpy as np

arr_1d = np.array([10, 20, 30, 40, 50])

print(len(arr_1d))    # 示例输出: 5
print(arr_1d.size)    # 示例输出: 5
场景 2:二维矩阵与高维张量(核心分水岭)
对于二维矩阵,len() 返回矩阵的行数(Axis 0),而 .size 返回行乘列的总单元格数:
# 构造 3 行 4 列的二维数组
arr_2d = np.arange(12).reshape(3, 4)

print(arr_2d.shape)   # 示例输出: (3, 4)
print(len(arr_2d))    # 示例输出: 3  (仅度量行数,即最外层容器元素个数)
print(arr_2d.size)    # 示例输出: 12 (3 * 4 = 12 个元素)

# 构造 2 x 3 x 4 的三维张量
arr_3d = np.zeros((2, 3, 4))
print(len(arr_3d))    # 示例输出: 2  (仅返回第一轴深度)
print(arr_3d.size)    # 示例输出: 24 (2 * 3 * 4 = 24)
场景 3:0 维数组(标量数组的异常边界)
NumPy 允许创建 0 维数组(标量包装对象)。这是日常开发中容易触发程序崩溃的隐蔽边界:
arr_0d = np.array(42)

print(arr_0d.shape)   # 示例输出: ()
print(arr_0d.size)    # 示例输出: 1 (包含 1 个标量元素)

# 尝试对 0 维数组调用 len() 会直接引发异常
try:
    print(len(arr_0d))
except TypeError as e:
    print(f"异常捕捉: {e}")
    # 示例输出: 异常捕捉: len() of unsized object
场景 4:Python 原生嵌套列表的不可替代性
原生 Python list 没有 .size 属性。如果误在普通列表上调用 .size,解释器会报 AttributeError:
py_list = [[1, 2, 3], [4, 5, 6]]

print(len(py_list))       # 示例输出: 2 (外层含有 2 个子列表)

try:
    print(py_list.size)
except AttributeError as e:
    print(f"错误: {e}")
    # 示例输出: 错误: 'list' object has no attribute 'size'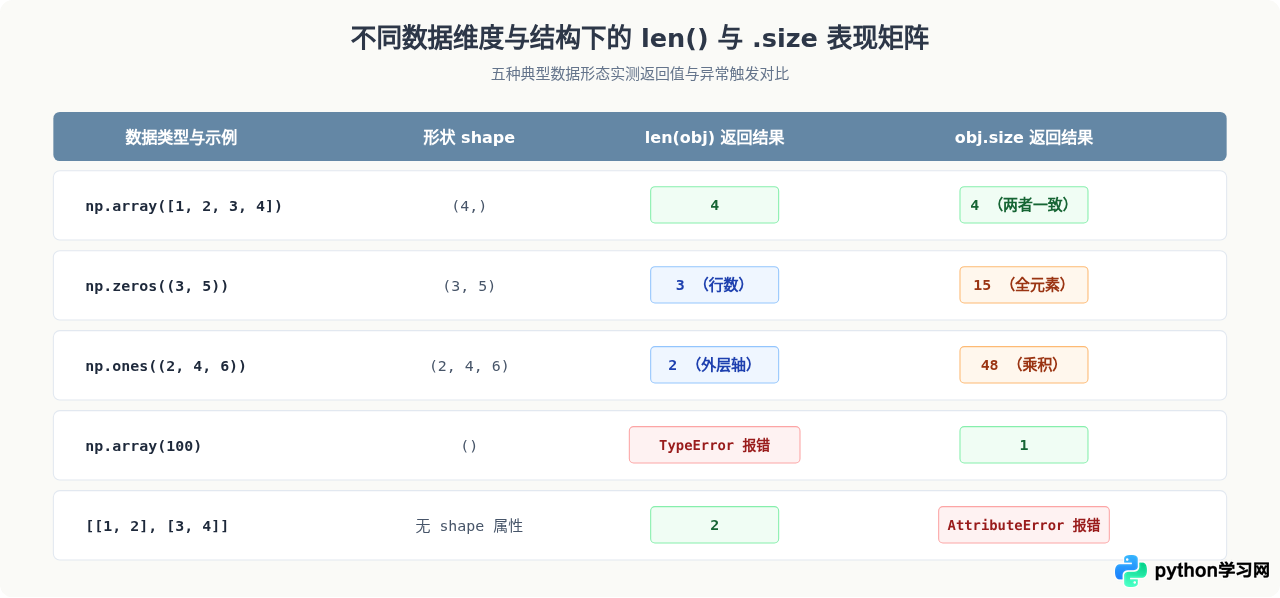
四、工程选型指南与决策流程
在实际项目(如数据清洗、特征工程、神经网络张量处理)中,盲目使用 len() 或 .size 容易埋下严重的逻辑缺陷。例如,在验证批次样本量时,若误用 arr.size,计算出的将是整个批次的像素点数或标量数,而非样本条数。
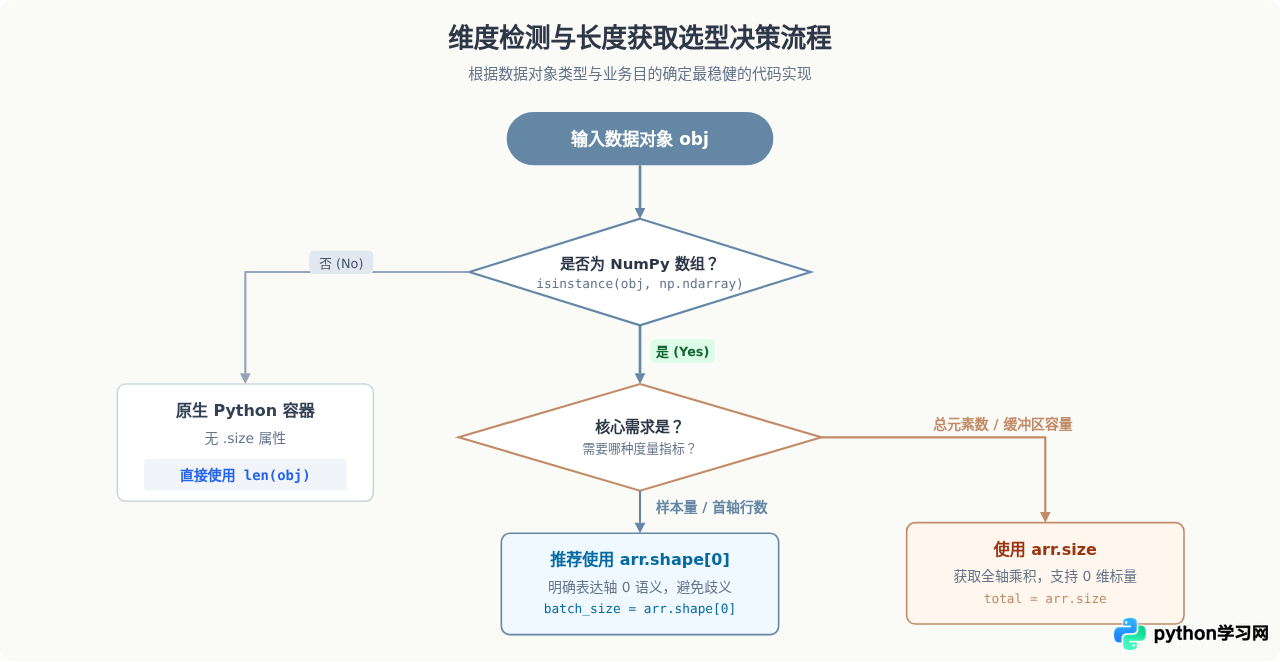
为了规范代码编写,建议遵循以下选择路径:
- 统计数据集样本量 / 矩阵行数时:应当直接读取
arr.shape[0]或使用len(arr)。但在数值计算工程中,arr.shape[0]的语义比len(arr)更加明确,能够防御 0 维数组或标量传参带来的异常。 - 校验内存占用、缓冲区大小或展平(flatten/ravel)容量时:必须使用
arr.size。它直接指示重构数组时所必须容纳的元素总容量。 - 面对未知对象(可能为原生列表或 NumPy 数组):如果仅需获取顶层项数,使用
len()具有最好的兼容性;若确需获取所有嵌套元素总数,需结合递归或先通过np.asarray()标准化后再读取.size。
五、常见避坑点与注意事项
避坑准则 1:谨防把 len() 用于多维数组的元素总量判断。
如果传入一个图像张量 image_batch(形状为 (32, 224, 224, 3)),执行 len(image_batch) 仅得到 32(即批次大小)。若误用该值分配全图处理的内存或循环处理像素,将导致极其严重的计算截断。
避坑准则 2:谨防在多维数组重塑(reshape)时依赖 len()。
当使用 arr.reshape(...) 变换形状时,所有维度的乘积必须与原数组严格相等。此处校验必须使用 arr.size,例如 assert new_h * new_w == arr.size,万不可写成 len(arr)。
避坑准则 3:注意标量(0 维数组)的兼容性处理。
在编写接受多类型输入的通用函数时,如果对象可能是 np.array(10),直接使用 len() 会引发 TypeError。若需要支持标量,优先使用 getattr(obj, 'shape', None) 进行安全判定,或者使用 np.ndim(obj) 判断维度。
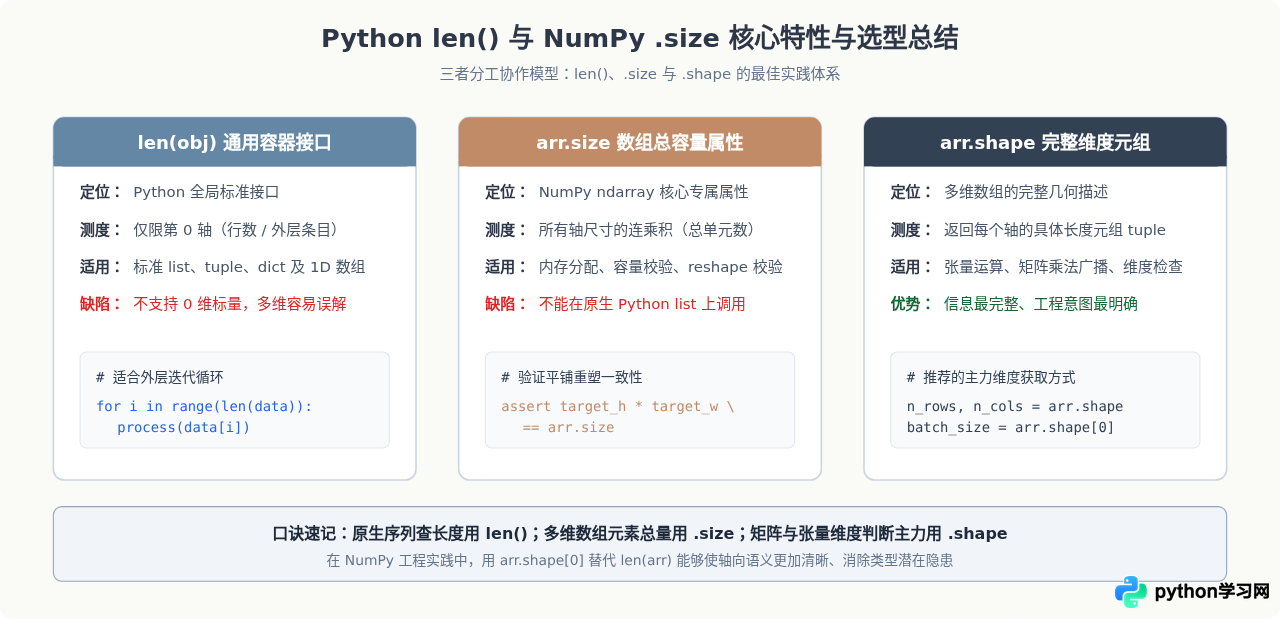
六、总结
在 Python 与 NumPy 的混合编程中,len() 与 .size 的差异本质上是外层容器协议与数值存储空间模型的差异:
len(arr)是 Python 容器通用操作符,对于多维数组它仅仅映射至arr.shape[0],无法感知深层维度。arr.size是 NumPy 数组专属的高性能属性,代表整个数组全部元素连乘积累加的总容量。- 在涉及二维矩阵或高维张量的工业级代码中,建议尽量显式调用
arr.shape[0]获取样本量或行数,以替代语义模糊的len(arr);而在需要平铺或校验元素总容量时,使用arr.size则是唯一正确且高效的选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









