

Python函数定义参数传递与返回值代码演示
深入解析Python函数定义的语法结构、参数传递机制(包括位置参数、默认参数、可变参数及不可变与可变对象的传参本质差异)与返回值规范,附带完整可运行代码演示与高清内联SVG原理解析图。
def 声明清晰的签名与作用域边界、深刻理解由“对象引用传递”决定的参数绑定机制(尤其是可变对象与不可变对象的行为差异),以及通过规范的 return 输出单一值或多值解构结果。本文结合具体可运行的代码演示与全景原理图,为你逐一梳理 Python 函数的定义规范、传参底层细节与返回值工程实践。
一、函数基本定义与调用流程
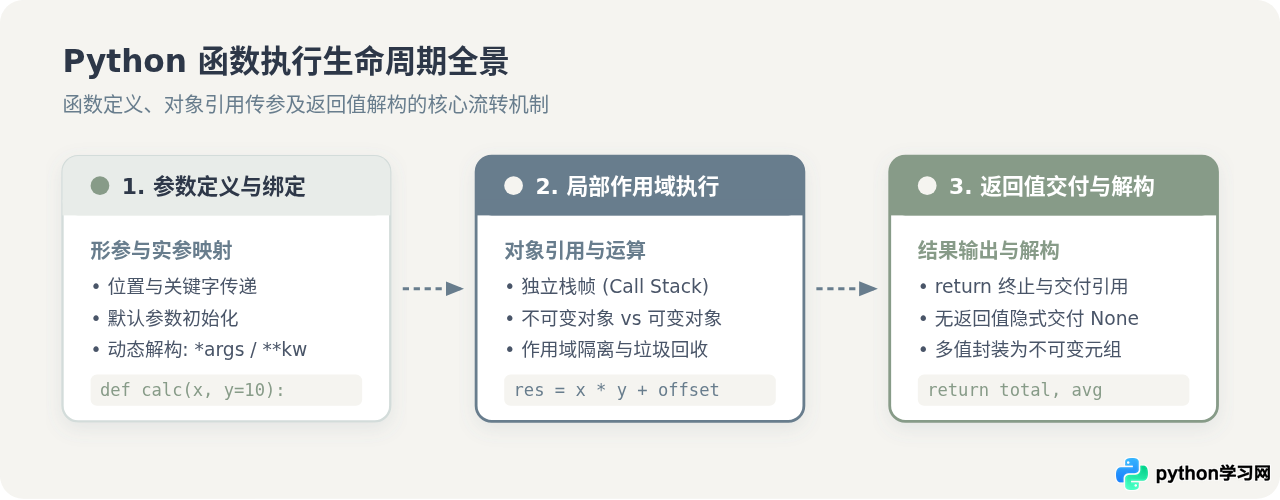
在 Python 中,定义函数使用 def(define)关键字,后接函数名、圆括号包围的形参列表(Parameters)以及英文冒号 :。随后缩进的代码块即为函数体。
区分两个基础术语至关重要:形参(Parameter)是函数声明时写在签名中的变量名,相当于占位符;而实参(Argument)是调用函数时传入的实际具体对象。
def calculate_discount(price: float, rate: float = 0.9) -> float:
    """计算商品折扣后的实付金额。

    :param price: 商品原价(必须大于0)
    :param rate: 折扣率,默认为0.9(九折)
    :return: 最终实付金额
    """
    if price <= 0:
        return 0.0
    final_amount = price * rate
    return round(final_amount, 2)

# 函数调用演示
order_original = 250.0
result_default = calculate_discount(order_original)          # 使用默认九折
result_custom = calculate_discount(order_original, rate=0.8) # 关键字传参八折

print(f"原价: {order_original}元")
print(f"九折实付: {result_default}元")
print(f"八折实付: {result_custom}元")九折实付: 225.0元
八折实付: 200.0元
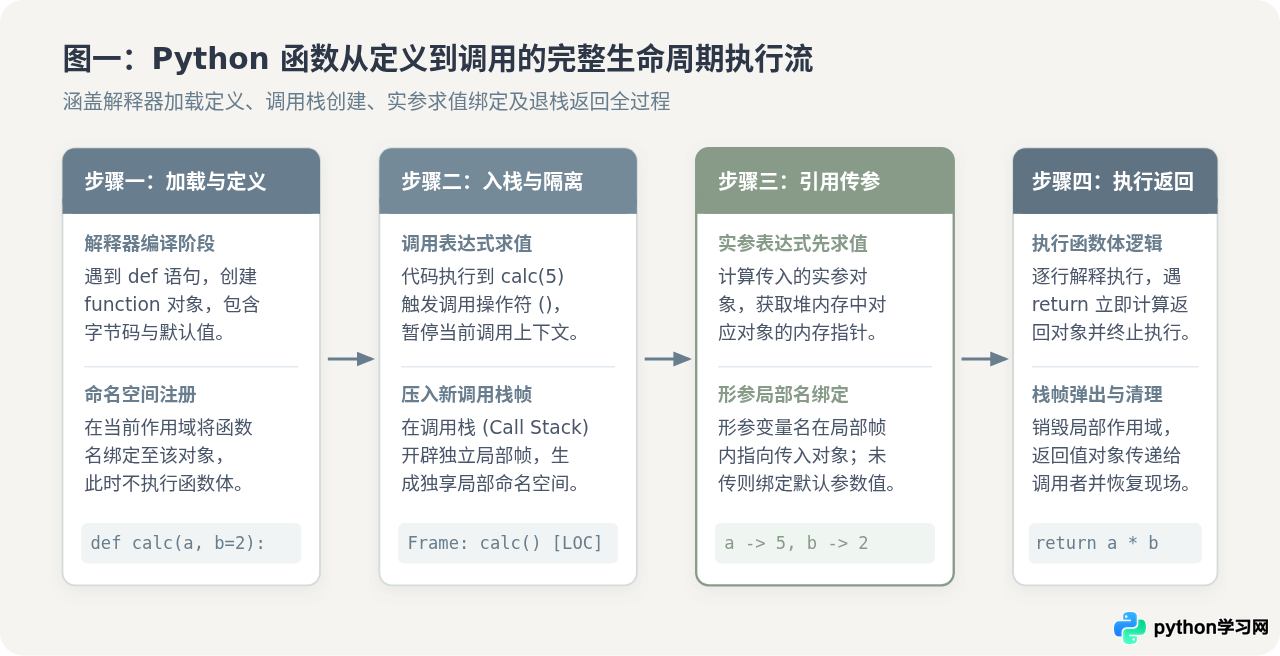
当 Python 解释器读到 def 语句时,并不会立刻执行函数体,而是在当前全局(或模块)命名空间中创建一个函数对象,并将函数名绑定至该对象。只有在后续代码遇到调用操作符 () 时,解释器才会分配局部栈帧并开始逐行求值。
二、参数传递体系与匹配规则
Python 提供了极具弹性的参数传递体系。在实际定义与调用时,形参和实参按特定优先级进行匹配。
1. 位置参数与关键字参数
位置参数(Positional Arguments):调用方传入的实参严格按照函数定义中的形参顺序从左到右一一对应。
关键字参数(Keyword Arguments):调用方通过 参数名=值 的形式显式指定实参。使用关键字传参时可以打破定义的先后顺序,极大提高调用端代码的可读性。
2. 默认参数(Default Arguments)
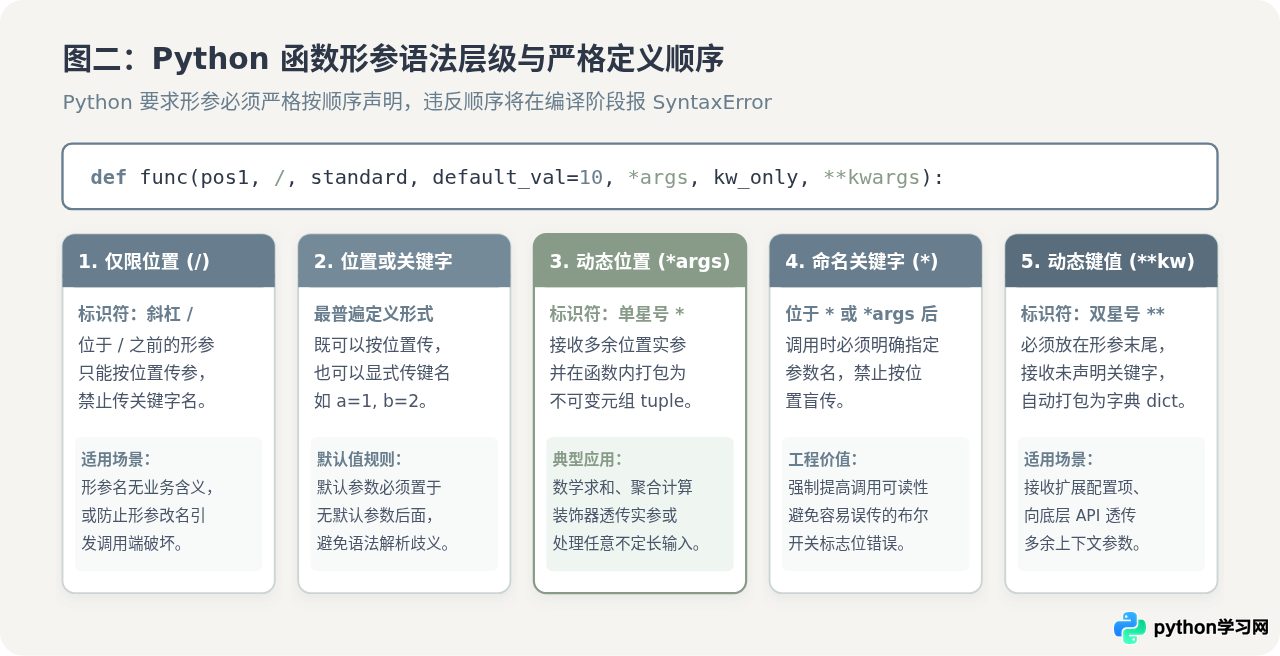
在函数定义时为形参赋初始值。调用时如果未提供该实参,则自动采用默认值。语法限制:非默认参数必须全部排在默认参数的前面,否则 Python 解释器在编译阶段将抛出 SyntaxError: non-default argument follows default argument。
3. 不定长参数:*args 与 **kwargs
当无法预先确定调用方会传入多少个参数时,可使用星号操作符:
*args:捕获所有多余的位置参数,在函数内部自动组装为一个元组(tuple)。**kwargs:捕获所有未在形参中明确列出的关键字参数,在函数内部自动组装为一个字典(dict)。
4. 仅限位置参数与命名关键字参数
Python 3.8 完善了参数控制语法:
/:斜杠之前的参数为仅限位置参数(Positional-Only),调用时不能使用关键字形式。*:单独的星号或*args之后的参数为命名关键字参数(Keyword-Only),调用时必须显式写出参数名。
def complex_service(pos_only, /, standard, default_val=10, *args, kw_only, **kwargs):
    print("--- 参数解析结果 ---")
    print(f"仅限位置参数 pos_only : {pos_only}")
    print(f"标准参数 standard     : {standard}")
    print(f"默认参数 default_val  : {default_val}")
    print(f"变长位置参数 *args    : {args} (类型: {type(args).__name__})")
    print(f"命名关键字 kw_only    : {kw_only}")
    print(f"变长键值对 **kwargs   : {kwargs} (类型: {type(kwargs).__name__})")

# 调用演示
complex_service(
    100,             # 仅限位置
    "alpha",         # 标准参数
    20,              # 覆盖默认参数
    "extra_1", "extra_2", # 收入 *args
    kw_only="SECURE_KEY", # 强制命名关键字
    env="production", timeout=30 # 收入 **kwargs
)仅限位置参数 pos_only : 100
标准参数 standard : alpha
默认参数 default_val : 20
变长位置参数 *args : ('extra_1', 'extra_2') (类型: tuple)
命名关键字 kw_only : SECURE_KEY
变长键值对 **kwargs : {'env': 'production', 'timeout': 30} (类型: dict)
三、核心机制与关键差异对比:不可变对象与可变对象传参本质
许多初学者常问:“Python 究竟是值传递(Pass by Value)还是引用传递(Pass by Reference)?”
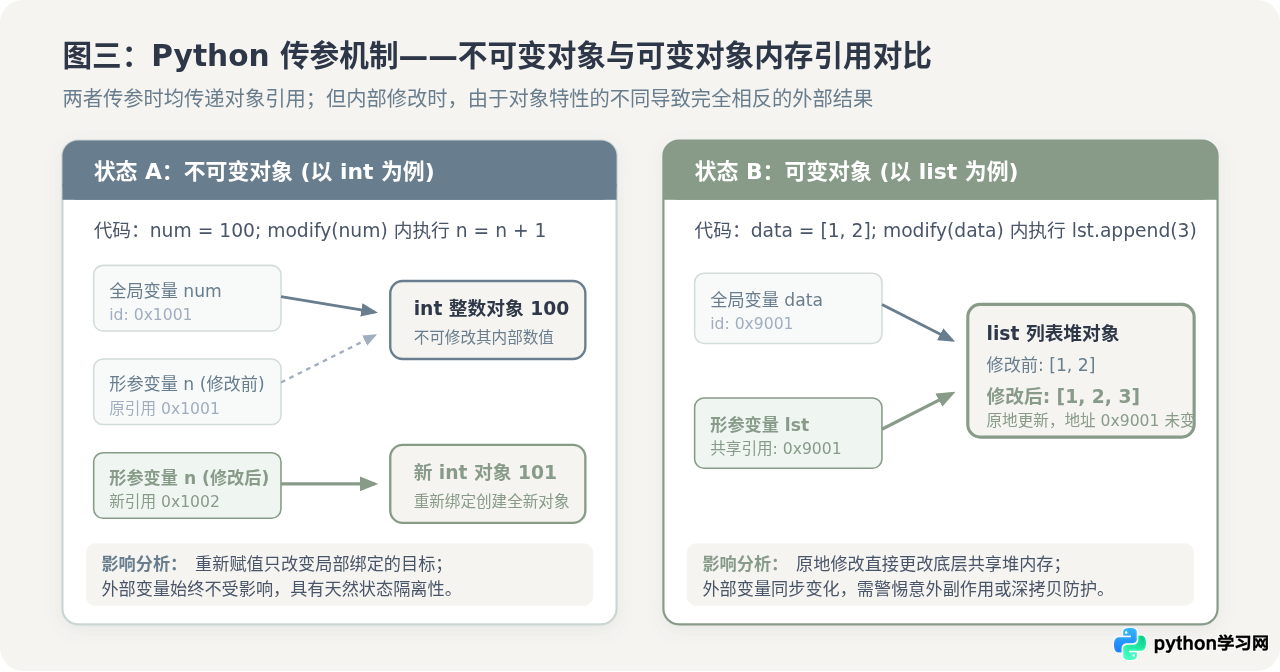
官方最准确的定义是“对象引用传递(Pass by Object Reference)”或“赋值传递(Pass by Assignment)”。当一个变量作为实参传入函数时,传入的是该变量指向的对象引用(即内存地址),而不是把对象复制一份传入,也不是传递变量名指针本身。
然而在完全一致的传参方式下,传入不可变对象与传入可变对象会表现出根本性的差异。理解这个差异对于防止程序出现隐蔽 Bug 至关重要。
| 对比维度 | 不可变对象(int, str, tuple, float) | 可变对象(list, dict, set) |
|---|---|---|
| 对象本质 | 一旦在堆内存中创建,其内部内容永远无法被改变 | 在内存地址不变的前提下,内部元素支持增删改查 |
| 函数内部执行赋值 | x = x + 1 创建全新对象,形参 x 重新绑定新地址 |
若执行 lst = [1] 则重新绑定局部名,不影响外界 |
| 函数内部执行原地修改 | 不支持原地修改(无此方法) | lst.append(item) 直接在原堆内存中追加数据 |
| 对调用方外部变量的影响 | 毫无影响。外部变量依然牢牢指向原有对象 | 产生副作用。外部变量看到的内容被同步修改 |
| 工程设计考量 | 天然线程安全、状态隔离,调用方无需担心状态被污染 | 若不期望外部数据改变,必须在入参时做浅拷贝或深拷贝 |
def modify_immutable(num: int):
    print(f"  [不可变实验] 接收实参时的内存 id: {id(num)}")
    num += 1  # 整数是不可变对象,+= 相当于 num = num + 1,创建新对象
    print(f"  [不可变实验] 修改赋值后的内存 id: {id(num)} (发生重定向)")

def modify_mutable(data_list: list):
    print(f"  [可变实验] 接收实参时的内存 id:   {id(data_list)}")
    data_list.append("NEW_ITEM")  # 原地修改,底层堆内存不发生迁移
    print(f"  [可变实验] 原地追加后的内存 id:   {id(data_list)} (内存地址恒定)")

# --- 执行一致条件下的对比测试 ---
print(">>> 实验 A:不可变对象传参测试")
outer_val = 100
print(f"调用前 outer_val = {outer_val}, id: {id(outer_val)}")
modify_immutable(outer_val)
print(f"调用后 outer_val = {outer_val} (外部数值未受任何影响)")

print("\n>>> 实验 B:可变对象传参测试")
outer_list = ["apple", "banana"]
print(f"调用前 outer_list = {outer_list}, id: {id(outer_list)}")
modify_mutable(outer_list)
print(f"调用后 outer_list = {outer_list} (外部列表已被内部修改!)")调用前 outer_val = 100, id: 4302914480
[不可变实验] 接收实参时的内存 id: 4302914480
[不可变实验] 修改赋值后的内存 id: 4302914512 (发生重定向)
调用后 outer_val = 100 (外部数值未受任何影响)
>>> 实验 B:可变对象传参测试
调用前 outer_list = ['apple', 'banana'], id: 4303882880
[可变实验] 接收实参时的内存 id: 4303882880
[可变实验] 原地追加后的内存 id: 4303882880 (内存地址恒定)
调用后 outer_list = ['apple', 'banana', 'NEW_ITEM'] (外部列表已被内部修改!)
四、函数返回值与多值解构
函数计算完毕后,通过 return 语句将结果交付给调用者,并立即退出当前函数栈帧。
1. 显式返回与隐式返回 None
若函数体内未编写 return 语句,或者只写了单个 return 而没有附带任何表达式,Python 会默认隐式返回 None。在需要表达“无有效结果”、“操作完成但无需输出”或“验证不通过提前终止”时,显式 return None 或直接 return 是常见的规范写法。
2. 返回多个值的本质:元组打包与解构
Python 语法允许通过逗号分隔直接返回多个变量:return total, average, max_val。
严格来说,Python 函数永远只能返回一个对象。当使用逗号返回多个值时,Python 解释器自动将其隐式打包为一个 tuple(元组)。调用方可以使用相同数量的变量接收,通过 Python 的序列解包(Tuple Unpacking)机制优雅地获取各个独立结果。
from typing import List, Tuple, Optional

def analyze_scores(scores: List[float]) -> Optional[Tuple[float, float, float]]:
    """分析学生成绩,返回(总分、平均分、最高分)。

    使用卫语句(Guard Clause):如果列表为空,提前返回 None。
    """
    if not scores:
        return None  # 提前退出防御

    total = sum(scores)
    average = round(total / len(scores), 2)
    highest = max(scores)

    # 语法看似返回三个变量,本质返回单一 tuple: (total, average, highest)
    return total, average, highest

# 场景 1: 正常数据集
class_scores = [88.5, 92.0, 79.5, 95.0, 84.0]
result = analyze_scores(class_scores)

if result is not None:
    # 方式 A:元组解包(推荐,直观易读)
    sum_score, avg_score, max_score = result
    print(f"总分: {sum_score}, 平均分: {avg_score}, 最高分: {max_score}")

    # 方式 B:通过元组索引访问
    print(f"验证元组类型: {type(result).__name__}, 长度: {len(result)}")

# 场景 2: 空列表边界处理
empty_result = analyze_scores([])
print(f"空数据返回值: {empty_result}")验证元组类型: tuple, 长度: 3
空数据返回值: None
五、工程实践中的常见陷阱与避坑规范
这是 Python 新手最容易踩入的经典陷阱之一。例如写成
def append_item(item, target_list=[])。在 Python 中,默认参数表达式只在函数被解释器加载(编译)时求值一次,而不是在每次调用时都重新求值。这意味着所有后续调用将共享同一个列表对象!
# ❌ 错误示范:列表默认参数被多次调用共享
def bad_add_tag(tag, tags_cache=[]):
    tags_cache.append(tag)
    return tags_cache

print(bad_add_tag("python"))  # 预期 ['python'], 实际 ['python']
print(bad_add_tag("web"))     # 预期 ['web'], 实际 ['python', 'web']!状态残留!

# ----------------------------------------------------

# ✅ 规范写法:使用 None 作为不可变哨兵值
def good_add_tag(tag, tags_cache=None):
    if tags_cache is None:
        tags_cache = []  # 每次调用独立创建全新列表
    tags_cache.append(tag)
    return tags_cache

print(good_add_tag("python")) # 输出 ['python']
print(good_add_tag("web")) # 输出 ['web'],互不干扰,干净独立['python', 'web']
['python']
['web']
六、全文总结
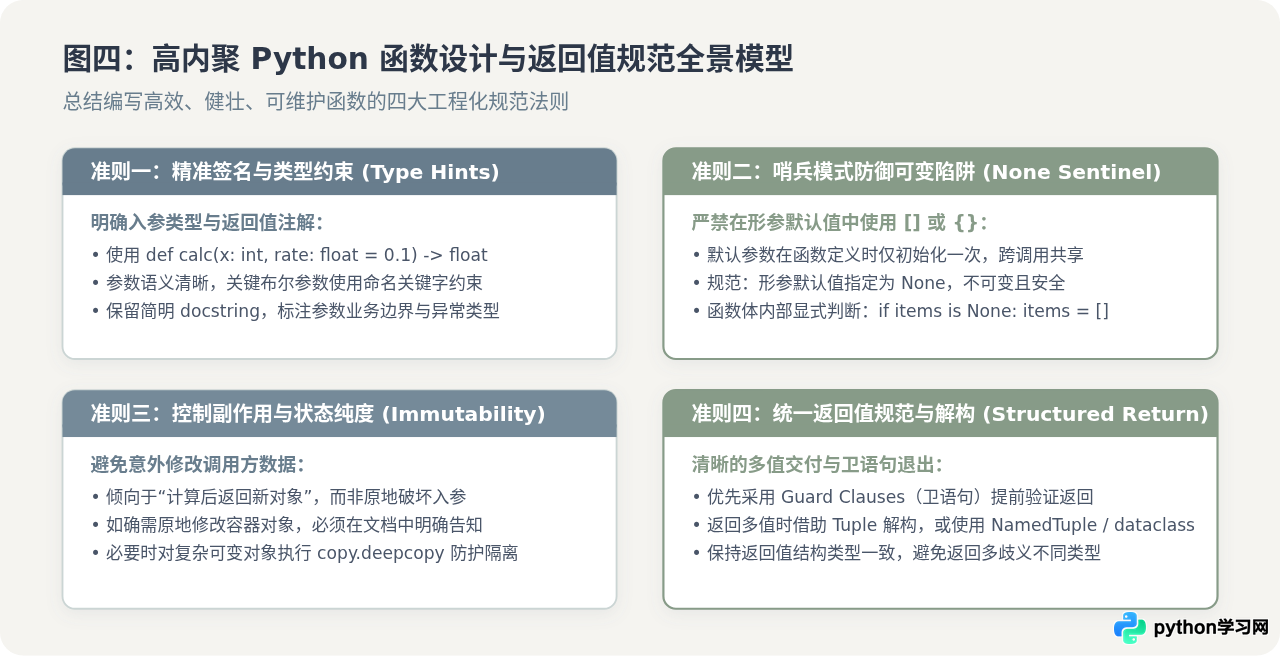
掌握 Python 函数的运行机制是写出可靠工程代码的前提。回顾本文重点:
- 定义与加载:
def声明在执行时生成函数对象,调用时通过调用栈(Call Stack)开辟独立局部帧,执行完毕即弹栈回收。 - 参数体系:按
仅限位置 -> 标准位置/关键字 -> 默认参数 -> *args -> 命名关键字 -> **kwargs规范声明,保证调用端表达清晰、灵活。 - 传参本质:Python 采用“对象引用传递”。传入不可变对象时,内部重赋值产生新对象,外部受隔离保护;传入可变对象时,内部原地修改会直接影响外部数据,需谨慎控制函数副作用。
- 返回值与解构:善用
None哨兵和卫语句提前退出;返回多个值时底层利用不可变元组封装,配合元组解包可实现干净利落的多值交互。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









