

Python复合赋值运算符(+=,-=)怎么简化代码编写?
深入解析Python复合赋值运算符(+=、-=等)的简化优势与底层工作机制。对比传统赋值写法,剖析__iadd__和__isub__特殊方法、可变与不可变对象的内存引用差异及实战避坑技巧。
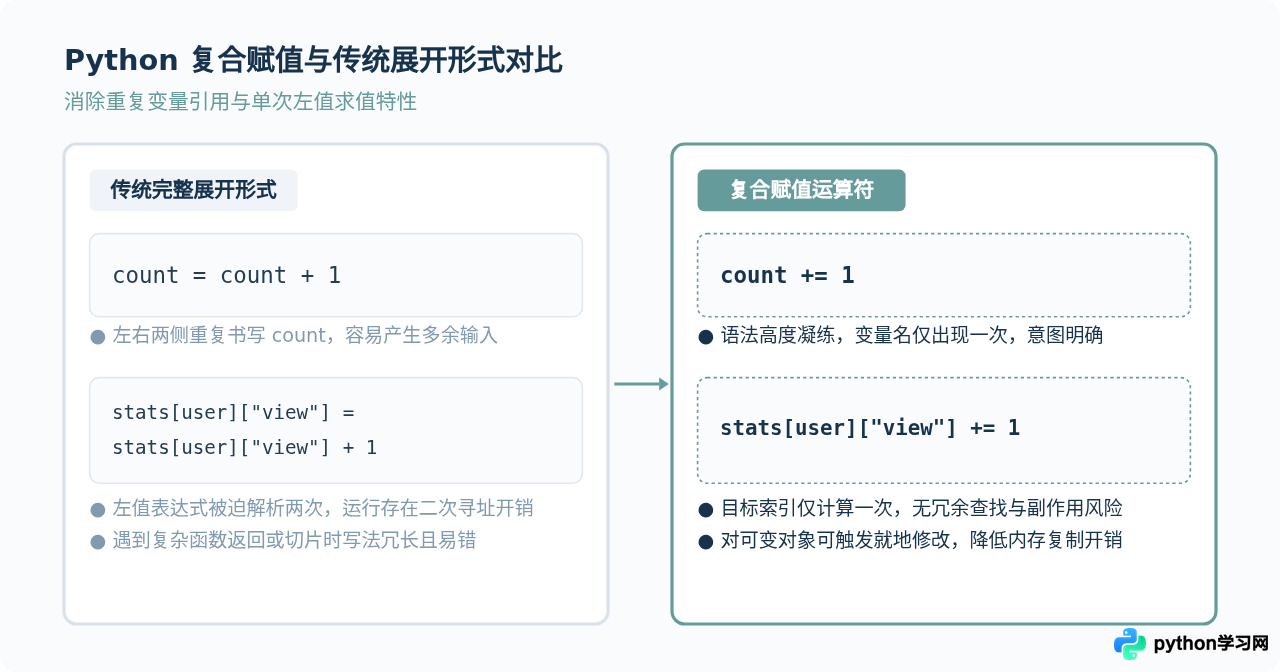
+= 与 -=)通过将常规算术运算与变量赋值合并为一步操作,直接消除了等号两侧重复键入同一个变量名的冗余。不仅能把常见的计数递增从 count = count + 1 精炼为 count += 1,更能在处理嵌套字典、对象深层属性等复杂数据结构时,避免重复编写长表达式与重复求值,从代码体积、表达直观度和执行开销三个层面切实优化代码编写体验。
一、从繁琐到精简:复合赋值的核心机制与语法对比
在没有复合赋值运算符时,对一个已有变量进行增量更新,需要先将该变量作为操作数参与右侧算术运算,再把计算所得的新值赋回给左侧同一个变量。例如在循环统计中,传统的写法必须完整书写 x = x + 1。
复合赋值运算符(Augmented Assignment Operators)通过保留左侧目标变量、紧随特定运算符与等号的形式,将运算与绑定紧密结合。在 Python 语法体系中,+= 称为“加法赋值运算符”,-= 称为“减法赋值运算符”。除了二者之外,乘法(*=)、浮点除法(/=)、整除(//=)以及取模(%=)等也遵循完全统一的简化规律。
| 复合赋值语法 | 基础展开等效形式 | 简化核心收益 |
|---|---|---|
x += 5 |
x = x + 5 |
省略重复变量名,提升计数逻辑易读性 |
balance -= 20.0 |
balance = balance - 20.0 |
明确“就地扣除”语义,降低拼写错误概率 |
cache[key][sub_key] += 1 |
cache[key][sub_key] = cache[key][sub_key] + 1 |
消除多级索引重复书写,避免二次寻址求值 |
二、日常代码中复合赋值的具体简化场景
在真实业务代码编写中,+= 与 -= 的简化价值通常体现在以下三个典型开发场景:
1. 循环累加与递减步进
最常见的使用场景是遍历集合时的计数器与总计值累计。代码从原本的双向绑定转变为单向自增,逻辑焦点完全放在“步长”是多少,而非“变量赋给谁”。
# 示例代码:统计总成绩与及格人数
scores = [78, 92, 58, 84, 61]
total_score = 0
passed_count = 0

for s in scores:
    total_score += s      # 简化自 total_score = total_score + s
    if s >= 60:
        passed_count += 1 # 简化自 passed_count = passed_count + 1

# 示例输出:总分 373,及格人数 4
2. 深层嵌套索引与属性访问
当变量并非简单标识符,而是涉及字典取键或对象多层属性访问时,简化的价值格外显著。例如 inventory[warehouse_id][item_code] -= quantity。若使用展开式写法,开发者必须把长达数十个字符的字典索引完整复制一遍,既容易打错字段,又导致行宽超标;而复合赋值写法仅需书写一次左值,并确保左侧表达式仅被 Python 解释器求值一次。
3. 序列与字符串的拼装累积
在处理文本拼接或列表合并时,+= 同样适用。对于字符串,+= 提供了直观的追加语法;对于列表,+= 能够接受任何可迭代对象并完成就地扩展。
# 示例代码:合并动态生成的数据列表
data_list = [10, 20]
data_list += [30, 40]   # 等价于调用 data_list.extend([30, 40])

# 示例输出:data_list 的内容变为 [10, 20, 30, 40]
三、底层运作原理:Python 如何解析 += 与 -=
许多初学者误以为 x += y 仅仅是编译器层面的“语法糖”字符串替换,但实际上 Python 为复合赋值设计了专门的底层数据模型协议。
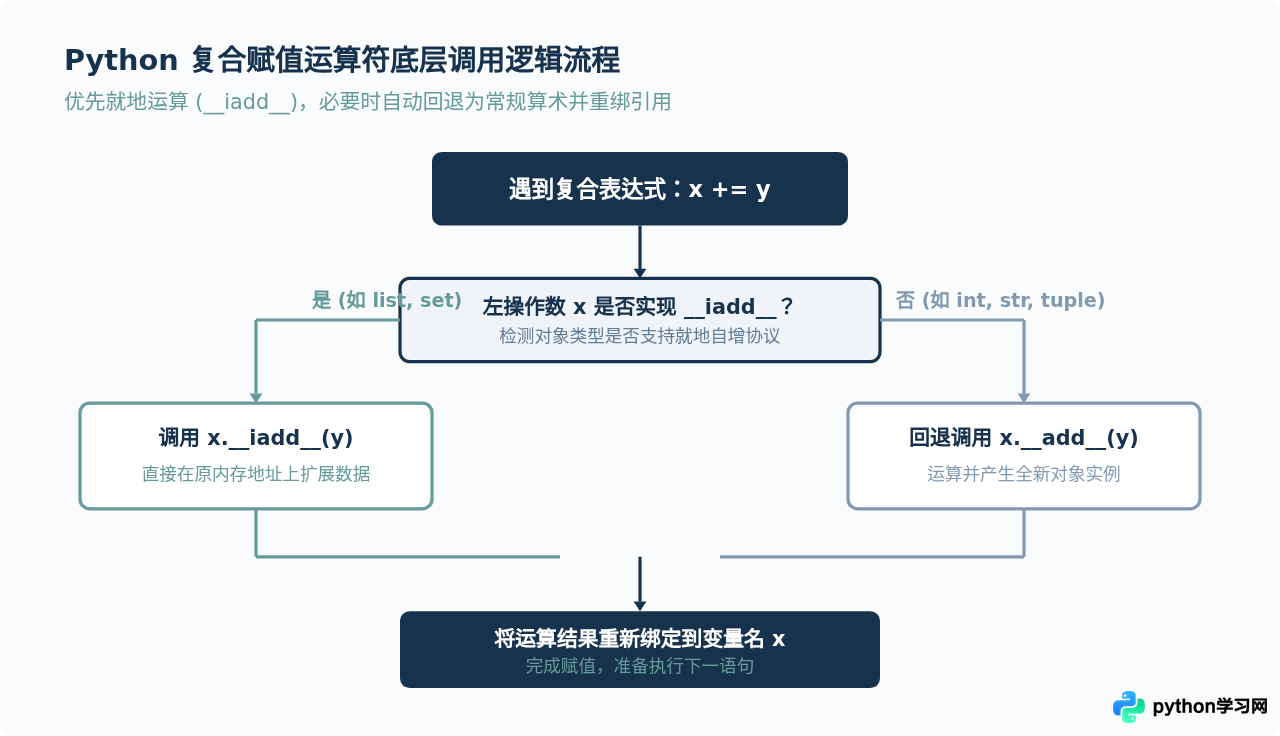
当 Python 解释器遇到 x += y 时,并不会立即展开为 x = x + y,而是按照以下严格顺序进行方法派发:
- 首先检查左操作数
x对应的类是否实现了特殊就地方法__iadd__(In-place Addition); - 如果该方法存在且返回非
NotImplemented,则直接执行x.__iadd__(y),并将返回值重新赋给x; - 如果该类没有定义
__iadd__,解释器才会回退(Fallback)到常规的二元算术方法__add__,执行x = x.__add__(y)。
对于减法复合赋值 x -= y,其底层对应的方法为 __isub__,回退方法为 __sub__。正是由于 __iadd__ 与 __isub__ 的存在,使得可变对象能够在复合赋值时进行“就地修改”,而不必重新开辟整块新内存。
四、关键差异:不可变类型与可变对象的内存表现
由于 Python 将数据类型划分为“可变类型(Mutable)”与“不可变类型(Immutable)”,+= 与 -= 在这两类对象上的底层行为存在根本差异。这是编写高质量 Python 代码必须掌握的知识点。
1. 不可变类型(int、float、str、tuple)
数值、字符串与元组属于不可变对象。不可变对象在内存中一旦创建,其值就无法被修改。因此,对于 num = 10; num += 1,Python 并没有改变原始数字 10,而是计算出新数值 11,并在内存中创建新对象,最后将变量名 num 指向新对象的地址。通过内置函数 id() 可以清晰验证地址的变化。
# 示例代码:验证不可变对象的内存地址改变
a = 100
print("原始 a 的内存地址:", id(a))

a += 1
print("自增后 a 的内存地址:", id(a))

# 示例输出:两个 id 输出不同的长整数,证明 a 重新绑定了新对象
2. 可变类型(list、dict、set)
列表等可变类型实现了 __iadd__。当对列表执行 lst += [3] 时,它会直接在现有列表对象的尾部追加元素,整个过程不需要重新开辟列表内存,变量指向的内存地址完全不变。
# 示例代码:验证可变对象就地修改的地址一致性
my_list = [1, 2]
print("原始列表地址:", id(my_list))

my_list += [3, 4]
print("+= 操作后地址:", id(my_list))

# 示例输出:两个 id 保持一致,证明列表是就地被修改,而非创建新列表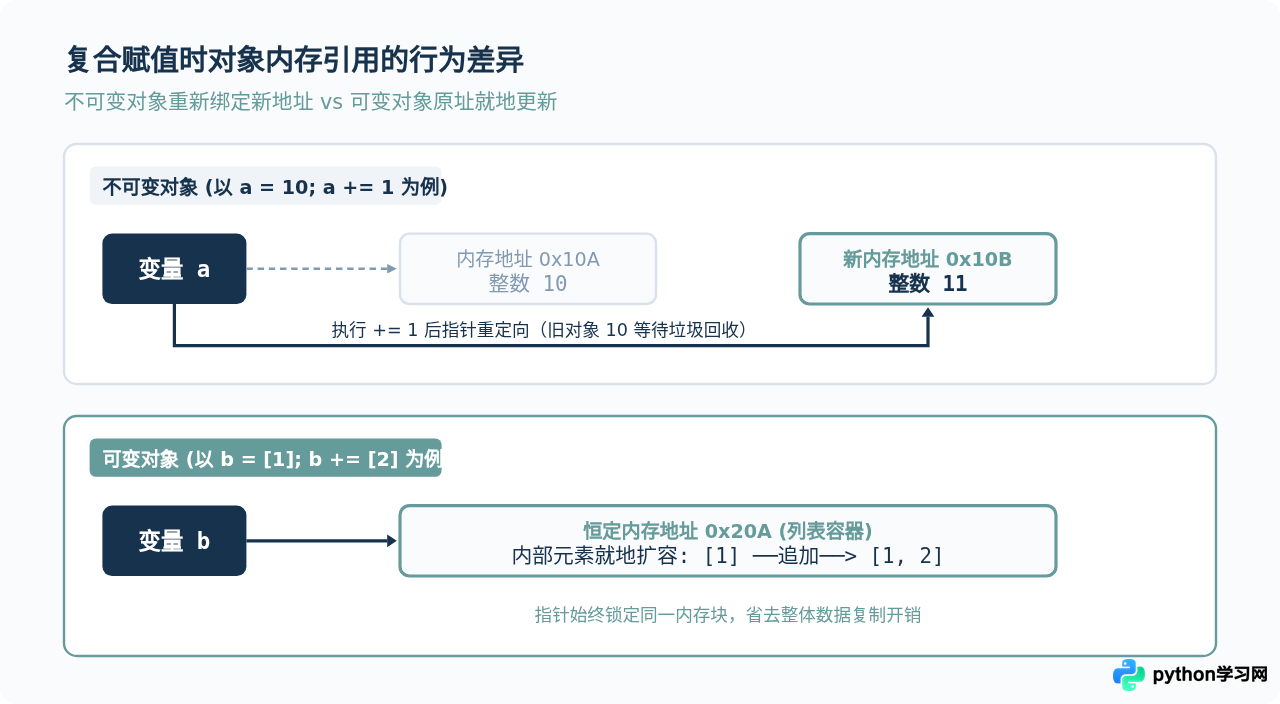
五、注意事项与开发避坑指南
复合赋值虽然大幅精简了书写,但正由于其“可变对象就地修改、不可变对象重新赋值”的双重特性,在特定场景下需要保持警惕:
list_a += [99] 会同步改变 list_b 的内容;而使用展开式 list_a = list_a + [99] 则会为 list_a 创建新列表,二者从此脱钩。因此在需要保留原列表快照时,应谨慎使用 +=。
经典陷阱:元组中包含可变列表时的 +=
Python 中有一道广为人知的经典陷阱题:如果一个不可变元组内部包含了一个可变列表,对这个列表执行 += 会发生什么?
# 陷阱示例代码
t = ([1, 2], "ok")
try:
    t[0] += [3]
except TypeError as e:
    print("捕获异常:", e)

print("元组当前内容:", t)

# 示例输出:
# 捕获异常: 'tuple' object does not support item assignment
# 元组当前内容: ([1, 2, 3], 'ok')
原因分析: t[0] += [3] 分为两步:第一步调用列表的 __iadd__,此时列表就地成功追加了 3;第二步尝试将返回的列表赋值给 t[0],但由于 t 是元组,禁止对元素重新赋值,因而抛出 TypeError。结果导致:运算成功了,但赋值报错了。在编写复杂嵌套数据处理时,应避免将可变结构放入元组中再进行复合修改。
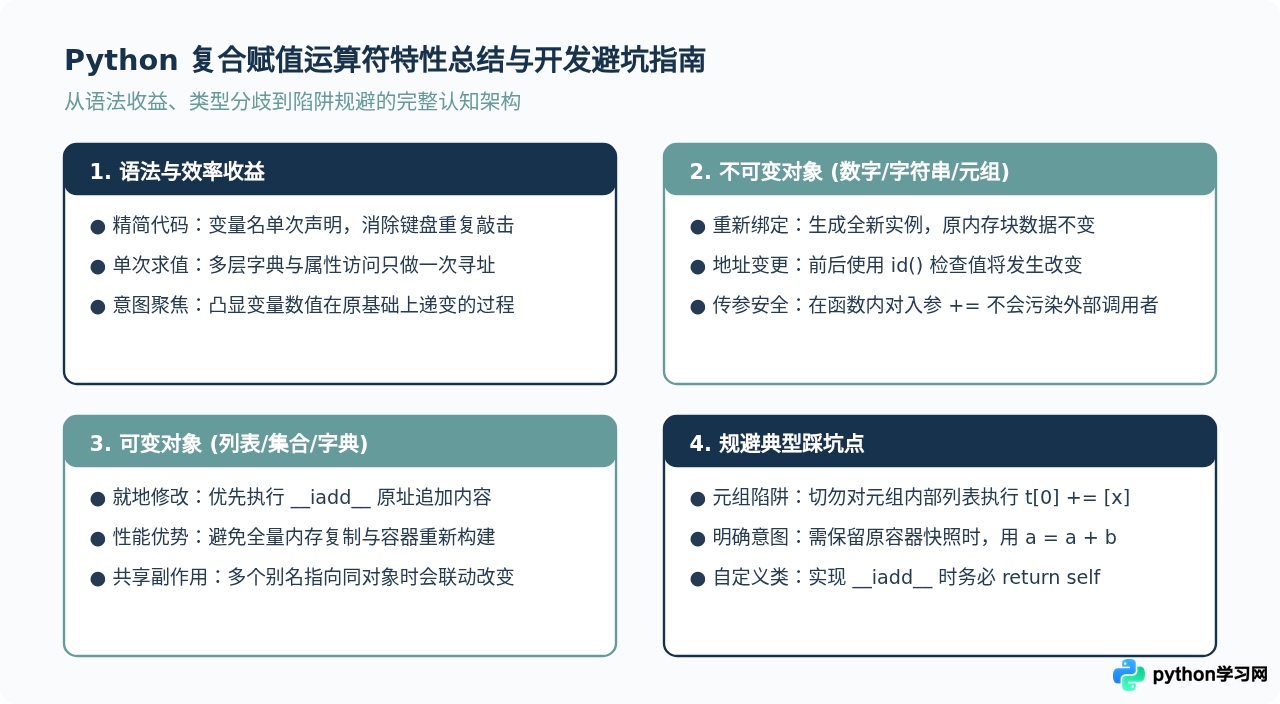
六、核心要点总结
综合来看,+= 与 -= 之所以能够成为 Python 日常编写中高频推荐的语法实践,核心原因在于:
- 代码精炼度提升: 省略了机械重复的左值书写,无论是单变量还是深层嵌套数据,都能使赋值语句更加紧凑;
- 运算效率优化: 复合赋值保证左侧表达式仅执行一次求值,并在可变对象上优先触发就地操作,减少无谓的内存开销;
- 语意更加清晰: 明确传达“在原值基础之上进行增减演变”的操作意图,便于后续代码维护与团队审阅。
只要理解了不可变对象生成新实例、可变对象就地更新的内存逻辑,并在面对嵌套容器时规避混合赋值陷阱,开发者就能在保证程序健壮性的同时,充分享受复合赋值运算符带来的整洁与高效。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









