

Python编写自动化脚本:批量重命名文件的实现方法
详细讲解使用Python编写自动化脚本批量重命名文件的完整实现方法。涵盖pathlib现代路径操作、三种核心命名规则、预演(Dry Run)与重名冲突防护机制。
日常在整理数码照片、下载文档或整理项目素材时,经常会遇到文件名杂乱无章、缺乏有效标识的问题。手动逐一修改不仅枯燥低效,还容易出现错漏。借助 Python 编写批量重命名脚本,可以通过清晰的逻辑规则在数秒内完成数百上千个文件的标准化命名。本文将围绕目标文件的获取、命名规则的映射转换以及磁盘写操作的防御性设计,系统展示一套稳健、可复用的自动化脚本实现方案。
一、自动化重命名脚本的工作原理与生命周期
批量重命名看似只是简单地调用更名接口,但若直接进行磁盘写入,容易因路径错误或规则失控导致不可逆的数据混乱。一个标准且可靠的自动化重命名流程由五个相互独立的阶段构成:定位扫描、筛选匹配、规则映射、预演校验(Dry Run)以及最终的物理写入。
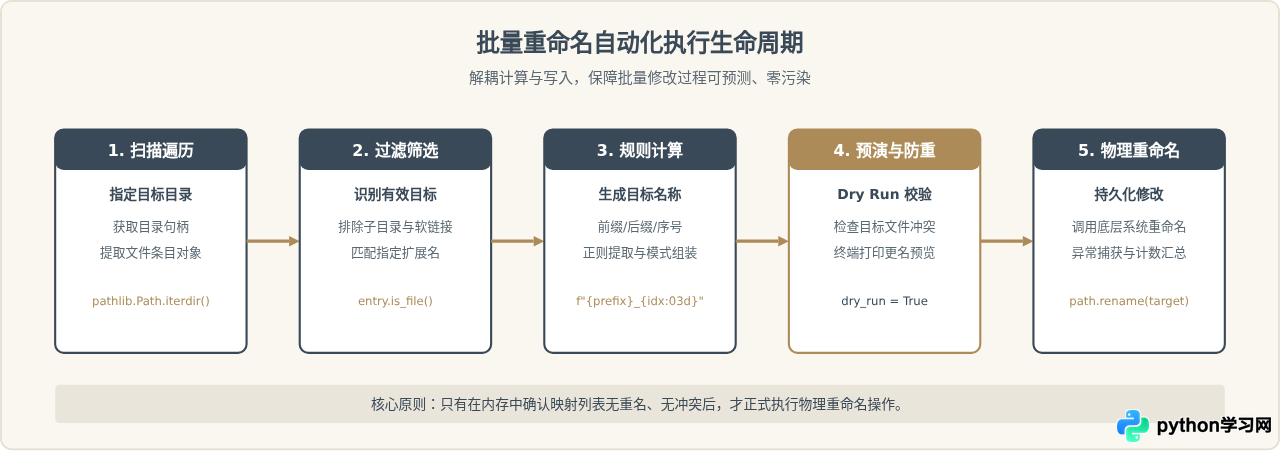
在设计脚本结构时,必须确保“计算逻辑”与“执行动作”明确分离。通过先生成由 (原路径, 目标路径) 构成的元组列表,脚本能够提前进行同名冲突检测或打印重命名清单,最大程度规避意外覆盖或数据损毁。
二、选择文件操作库:os 还是 pathlib?
Python 标准库提供了两种主流的文件与路径处理模块:传统的 os / os.path 和现代面向对象的 pathlib。在重命名脚本中,强烈推荐优先使用 Python 3.4 引入的 pathlib 模块。
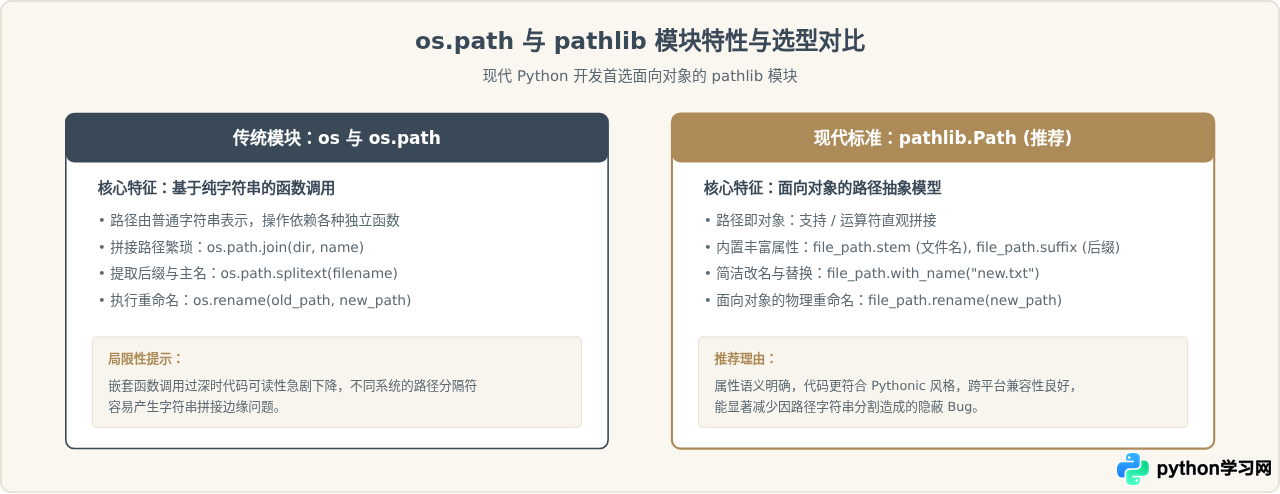
pathlib.Path 对象将文件路径抽象成具有丰富属性的实体。例如对于文件 report_2026.docx:
path.name直接返回全名"report_2026.docx";path.stem获取去除了后缀的文件主名"report_2026";path.suffix获取文件扩展名".docx";path.parent获取所在目录对象。
在批量更名场景中,我们需要经常基于原有主名拼接新名字并保留原后缀,pathlib 提供的这些原生属性可以省去繁杂的字符串切割操作。
三、常见批量重命名场景与实现方法
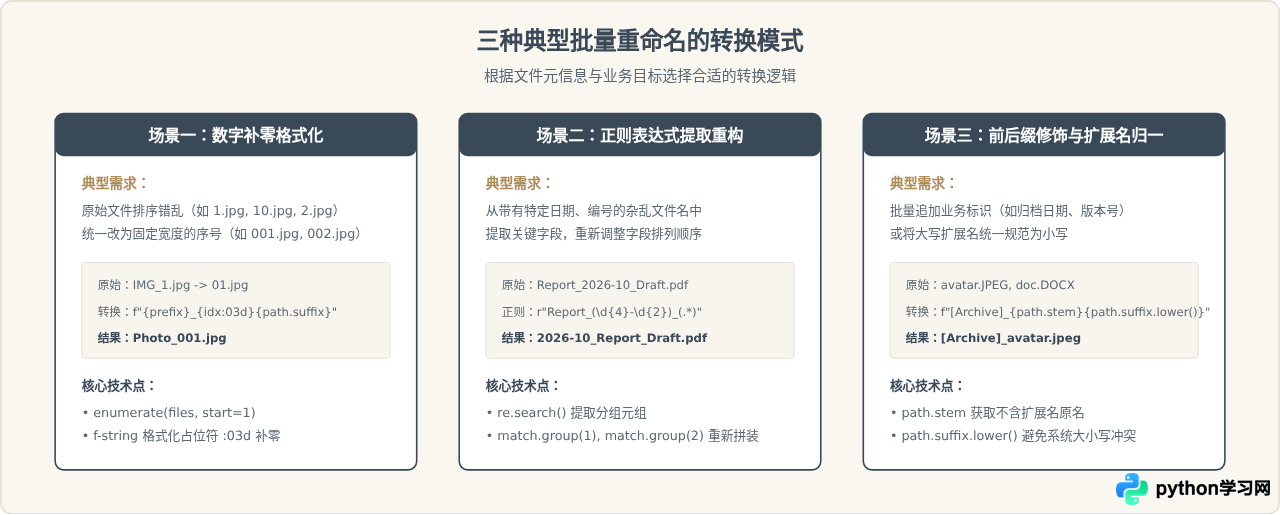
批量重命名的核心在于“如何从旧名称映射出符合期望的新名称”。在实际工作中,最常见的业务需求可归纳为三类:格式化数字序号、模式匹配替换与前缀修饰、以及扩展名标准化统一。
1. 按固定格式补零重命名
当文件按文件名升序排列时,1.jpg 与 10.jpg 容易排在一起,而 2.jpg 会被排在后面。通过在数字前面补充固定位数的 0(例如三位数的 001、002),即可实现操作系统的自然排序。
from pathlib import Path

def batch_rename_sequential(target_dir: str, prefix: str = "item", digits: int = 3, dry_run: bool = True):
    folder = Path(target_dir)
    if not folder.exists() or not folder.is_dir():
        print(f"错误:指定路径 {target_dir} 不存在或不是有效目录。")
        return

    # 获取所有非隐藏文件并保持稳定排序
    files = sorted([f for f in folder.iterdir() if f.is_file() and not f.name.startswith(".")])

    print(f"共发现 {len(files)} 个待处理文件。当前模式:{'【模拟预演】' if dry_run else '【真实修改】'}")

    for index, file_path in enumerate(files, start=1):
        # 构造新名称:例如 item_001.png
        new_name = f"{prefix}_{index:0{digits}d}{file_path.suffix.lower()}"
        target_path = file_path.with_name(new_name)

        if dry_run:
            print(f"[预演] {file_path.name}  ->  {new_name}")
        else:
            file_path.rename(target_path)
            print(f"[已重命名] {file_path.name}  ->  {new_name}")
2. 使用正则表达式提取并重排文件名信息
在处理下载的文件时,常包含随机流水号或复杂的日期格式。通过 Python 的 re 模块,可以精准捕获所需的关键子串,并按指定结构重构文件名。
import re
from pathlib import Path

def batch_rename_by_pattern(target_dir: str, dry_run: bool = True):
    folder = Path(target_dir)
    # 匹配示例:Invoice-2026-05-18_ClientA.pdf
    pattern = re.compile(r"^Invoice-(\d{4}-\d{2}-\d{2})_(.+)\.pdf$", re.IGNORECASE)

    for file_path in folder.glob("*.pdf"):
        match = pattern.match(file_path.name)
        if match:
            date_str, client_name = match.groups()
            # 重排为:ClientA_2026-05-18_Invoice.pdf
            new_name = f"{client_name}_{date_str}_Invoice.pdf"
            target_path = file_path.with_name(new_name)

            if dry_run:
                print(f"[匹配预演] {file_path.name} -> {new_name}")
            else:
                file_path.rename(target_path)
                print(f"[完成] {file_path.name} -> {new_name}")
        else:
            print(f"[跳过不匹配] {file_path.name}")
四、防御性设计:避免覆盖与冲突的工程实践
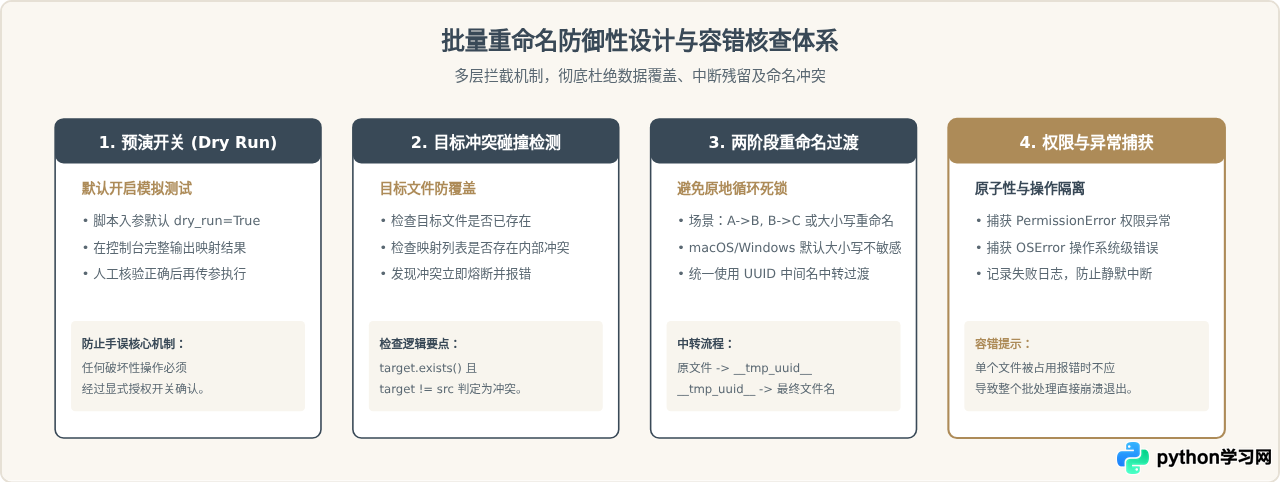
自动化脚本具备批处理的高效性,但如果缺乏防御机制,逻辑错误可能会被瞬间放大,甚至导致原文件被直接覆盖。编写生产级重命名脚本时,必须落实以下四项防御策略:
特别提醒:大小写敏感度陷阱
在 Windows 和 macOS 默认的文件系统(APFS / NTFS)下,文件名是不区分大小写的。如果直接将 photo.jpg 重命名为 PHOTO.JPG,由于系统视二者为同一文件,file.rename() 可能会抛出错误或静默失效。对于这类仅调整大小写的需求,必须通过一个临时的中间过渡文件名进行“两阶段重命名”。
五、完整的工业级批量重命名脚本工程示例
结合上述分析,下面给出一个兼顾预演校验、冲突排查、异常捕获的完整脚本模板。你可以直接将其保存为独立的 Python 文件使用:
import sys
import uuid
from pathlib import Path
from typing import List, Tuple, Callable

def safe_batch_rename(
    target_dir: str,
    rule_func: Callable[[Path, int], str],
    filter_ext: str = None,
    dry_run: bool = True
) -> bool:
    """
    通用安全批量重命名执行器
    :param target_dir: 目标文件夹路径
    :param rule_func: 命名规则函数,接收 (file_path, index) 返回新的文件名(含后缀)
    :param filter_ext: 可选的扩展名过滤,例如 ".jpg"
    :param dry_run: 是否处于模拟预演模式
    :return: 执行是否成功
    """
    folder = Path(target_dir).resolve()
    if not folder.is_dir():
        print(f"[错误] 目录不存在: {folder}")
        return False

    # 1. 扫描并过滤文件
    files = [f for f in folder.iterdir() if f.is_file() and not f.name.startswith(".")]
    if filter_ext:
        ext = filter_ext.lower() if filter_ext.startswith(".") else f".{filter_ext.lower()}"
        files = [f for f in files if f.suffix.lower() == ext]

    # 按原始文件名排序,保证序号分配的确定性
    files = sorted(files, key=lambda x: x.name)

    if not files:
        print("[提示] 未找到符合条件的待处理文件。")
        return True

    # 2. 计算映射关系
    rename_plan: List[Tuple[Path, Path]] = []
    target_names = set()

    for idx, file_path in enumerate(files, start=1):
        new_name = rule_func(file_path, idx)
        target_path = file_path.with_name(new_name)

        # 检查规则是否生成了空名
        if not new_name.strip():
            print(f"[错误] 文件 {file_path.name} 计算得到的新名称为空,已终止操作。")
            return False

        # 检查本次任务内部是否有重名冲突
        if new_name.lower() in target_names:
            print(f"[冲突] 规则计算出现重复目标名: {new_name},任务熔断。")
            return False

        target_names.add(new_name.lower())
        rename_plan.append((file_path, target_path))

    # 3. 检查是否与磁盘中非本次重命名的既有文件发生冲突
    existing_untracked = {
        f.name.lower() for f in folder.iterdir() if f.is_file() and f not in files
    }
    for _, target_path in rename_plan:
        if target_path.name.lower() in existing_untracked:
            print(f"[冲突] 目标文件名已存在于磁盘且不属于重命名列表: {target_path.name},任务熔断。")
            return False

    # 4. 预演或物理执行
    print(f"\n==================== 计划重命名清单 ({'预演模式' if dry_run else '正式写入'}) ====================")
    for src, dst in rename_plan:
        status_flag = "[保持原名]" if src == dst else "[变更]"
        print(f"{status_flag} {src.name}  ->  {dst.name}")
    print("=======================================================================\n")

    if dry_run:
        print("[安全提示] 以上为模拟预览结果,未对磁盘做任何实际修改。")
        print("[安全提示] 如确认映射无误,请将 dry_run 设置为 False 重新运行。")
        return True

    # 5. 正式执行两阶段安全重命名(防止大小写覆盖与互锁)
    stage_temp_map: List[Tuple[Path, Path, Path]] = []
    success_count = 0

    try:
        # 阶段 A:将所有变更文件重命名为唯一的临时名
        for src, dst in rename_plan:
            if src == dst:
                continue
            temp_name = f"__temp_{uuid.uuid4().hex[:8]}_{src.name}"
            temp_path = src.with_name(temp_name)
            src.rename(temp_path)
            stage_temp_map.append((src, temp_path, dst))

        # 阶段 B:从临时名重命名为目标名
        for _, temp_path, dst in stage_temp_map:
            temp_path.rename(dst)
            success_count += 1

        print(f"[执行完成] 成功重命名 {success_count} 个文件。")
        return True

    except Exception as e:
        print(f"\n[严重错误] 执行重命名过程中出现异常: {e}")
        print("[回滚处理] 正在尝试将临时文件恢复原状...")
        for src, temp_path, _ in stage_temp_map:
            if temp_path.exists():
                try:
                    temp_path.rename(src)
                except Exception as rollback_err:
                    print(f"  回滚失败: {temp_path.name} -> {src.name}: {rollback_err}")
        return False


# ==================== 业务调用示例 ====================
if __name__ == "__main__":
    # 定义重命名规则示例:统一加上业务归档前缀与四位序号
    def my_rule(file_path: Path, index: int) -> str:
        return f"Project_Doc_{index:04d}{file_path.suffix.lower()}"

    # 目标目录(请根据实际需要修改路径)
    work_dir = "./documents"

    # 先以 dry_run=True 预览结果
    safe_batch_rename(
        target_dir=work_dir,
        rule_func=my_rule,
        filter_ext=".pdf",
        dry_run=True
    )
六、排查与验证:执行前后的核验清单
为了保证批处理执行的万无一失,可以在正式执行前后对照以下清单逐一确认:
| 检查阶段 | 关注项 | 核对要点与说明 |
|---|---|---|
| 准备阶段 | 原文件备份 | 涉及重要生产数据时,建议在执行自动化脚本前对目录整体建立副本压缩包。 |
| 运行前核查 | 只读与权限 | 确认当前运行用户具备对目标文件夹及所有子文件的读写与重命名权限。 |
| 逻辑核对 | 预演日志抽样 | 在控制台仔细抽样核对前 3 个与后 3 个文件的变更映射,确认后缀及编号符合预期。 |
| 结果验证 | 文件总量对比 | 重命名完成后,通过 len(list(folder.iterdir())) 确认文件总数在操作前后完全一致。 |
通过遵循“扫描分离、模型抽象、预演校验、阶段写入”的标准化范式,Python 自动化脚本能够从容应对各种复杂的文件重命名需求,在大幅提升工作效率的同时,确保本地文件资产的绝对安全。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









