

怎么准备一场围绕Python3.14和pandas3.0的数据分析面试?
针对Python 3.14与pandas 3.0两大里程碑版本,深入拆解数据分析技术面试的核心考点、底层机制变更、代码避坑指南与五步系统备战路线。
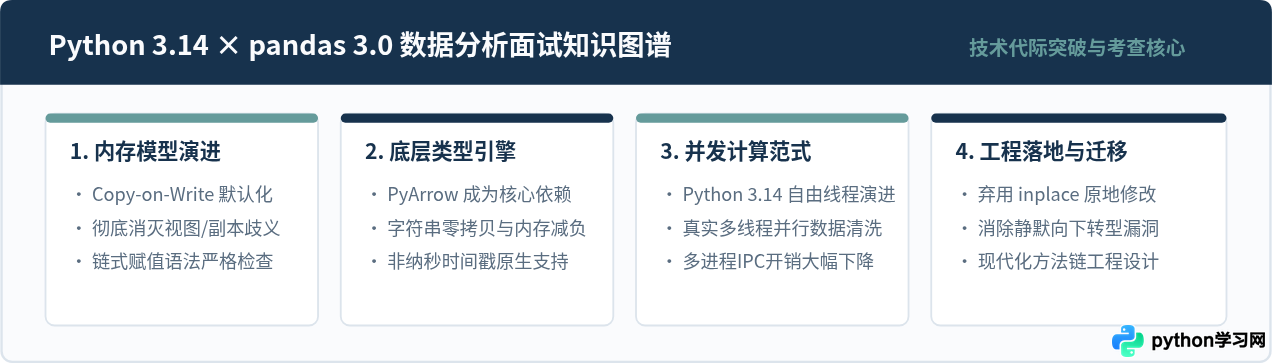
一、面试官的核心考察意图:技术代际迁移中的工程掌控力
当一家公司在数据分析或数据工程面试中明确提出 Python 3.14 与 pandas 3.0 时,考官通常并不打算考察基础的 df.groupby() 怎么写,而是想借由这两个里程碑版本,考察求职者对底层执行机制、内存性能管理以及存量工程迁移能力的深层理解。
在过去十余年里,pandas 开发者长期被两件事情困扰:一是由于底层切片视图(View)与副本(Copy)行为不确定而频发的 SettingWithCopyWarning;二是基于 Python 原生对象的字符串存储带来的严重内存膨胀。而在解释器层面,GIL(全局解释器锁)限制了 CPU 密集型数据清洗的高并发发挥。
pandas 3.0 正式将 Copy-on-Write (CoW) 设为不可关闭的默认行为,并将 PyArrow 提升为一等公民;而 Python 3.14 持续深化自由线程(Free-threaded CPython,即无 GIL 构建版本)并优化 JIT 编译器。面试官最希望听到的,是你如何在实际项目中利用这些特性设计高性能流水线,以及如何排查新特性带来的行为变更。
二、深入两大核心底层机制:必考原理与技术推导
要在面试中脱颖而出,必须讲透 pandas 3.0 和 Python 3.14 的底层运作原理。面试官非常喜欢以“为什么”开头追问底层细节。
1. pandas 3.0 的核心:Copy-on-Write (CoW) 内存机制
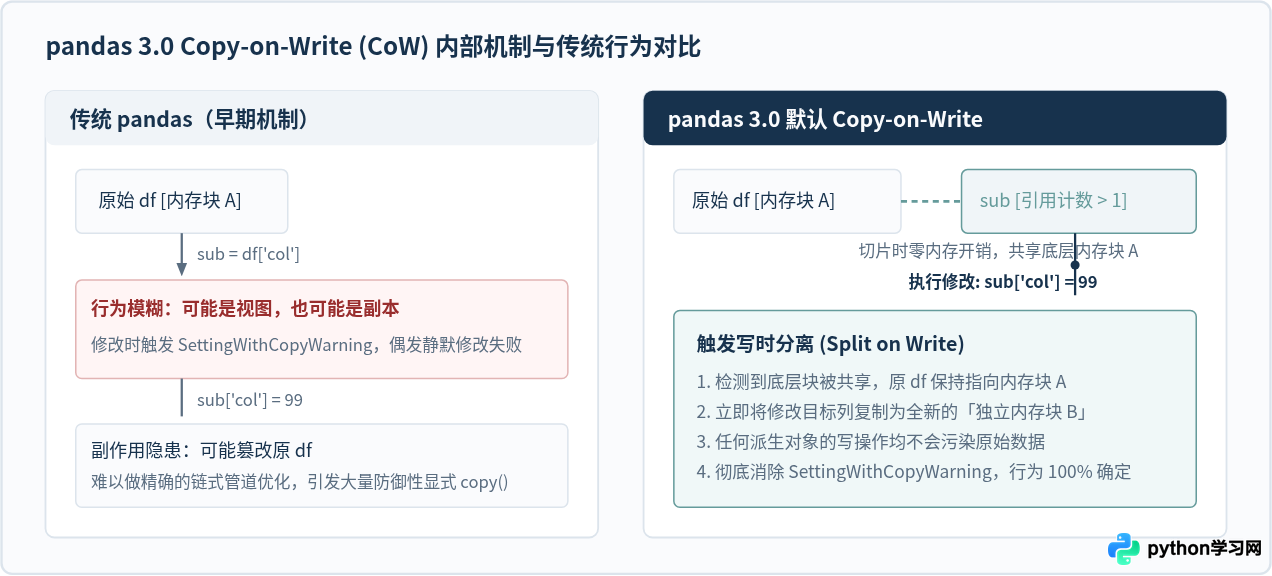
在 pandas 3.0 之前,获取 DataFrame 的子集究竟会产生视图还是副本取决于底层 NumPy 数组的内存布局(例如是否为连续内存),这种不确定性导致了令人头疼的防御性复制以及随时弹出的警告。
而在 pandas 3.0 中,所有派生切片在初始阶段都只共享同一个只读底层数据缓冲区。只有当用户尝试对某个对象执行写操作(修改、赋值)时,系统才会检查该底层内存块是否被多个对象引用。如果存在共享引用,pandas 此时才会单独将该列或数据块复制一份出来供写操作使用,这就是写时复制(Copy-on-Write)。
2. PyArrow 类型系统的深度集成与默认化
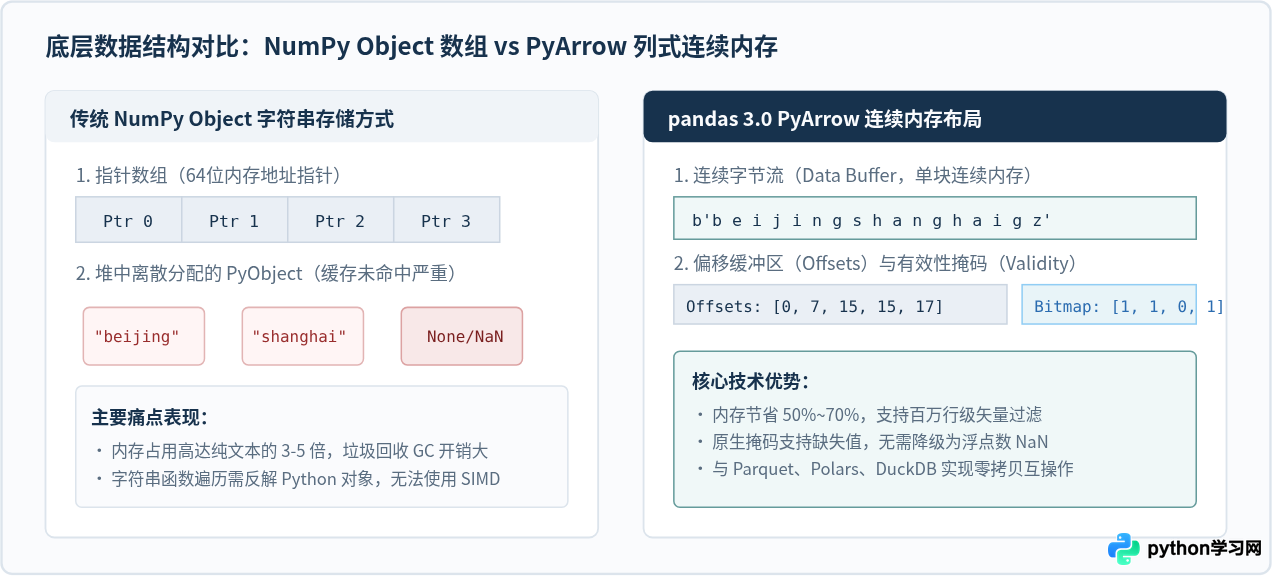
长久以来,pandas 默认使用 NumPy 处理数值列,而文本列则以纯 Python object 指针数组存储。每个字符串都是单独分配在堆上的 CPython 对象,不仅伴随着指针开销与内存碎片,而且无法享受 CPU 级 SIMD 向量化指令加速。
pandas 3.0 深度拥抱 Apache Arrow。在默认配置下,字符串类型全面推荐并迁移为 string[pyarrow]。Arrow 数据在内存中以连续二进制块布局,由连续数据缓冲区、偏移量缓冲区(Offsets Buffer)和有效性掩码位图(Validity Bitmap)构成。
3. Python 3.14 自由线程与数据工程并发
Python 3.13 首次实验性引入 PEP 703(Free-threaded CPython,即消除 GIL),在 Python 3.14 中,自由线程的生态兼容性和多线程运行时稳定性迈入实用化阶段。
在以往的数据清洗中,面对数十 GB 的无规律文本或复杂正则清洗,数据分析师通常必须借助 multiprocessing.Pool。然而,多进程意味着沉重的进程创建开销、独立的内存空间以及高昂的跨进程数据序列化(Pickle)成本。在 Python 3.14 自由线程构建环境下:
- 多线程计算开销大幅降低:多线程可以直接共享只读 DataFrame 内存,直接利用现代多核 CPU 进行真正并行的数据预处理,彻底告别序列化瓶颈。
- 扩展库无锁化适配成为考查点:面试中被问及“无 GIL 是否意味着我们写多线程 Python 不需要加锁了?”时,务必明确指出:GIL 的消除只保护了 CPython 内部运行时的内存安全,并不等于保证应用层的业务线程安全。多线程向同一个 pandas 容器写入时,依旧需要合理的互斥锁或采用分块并行、最后合并(Map-Reduce)的无竞争架构。
三、必须掌握的破坏性变更(Breaking Changes)与代码反模式
考官常常通过一段看似正常的代码让你挑错,或者让你解释为什么在 pandas 3.0 下抛出了异常。你需要熟练指出以下关键变更:
1. 链式索引赋值(Chained Assignment)彻底失效
过去常见的链式写法在 pandas 3.0 的严格 CoW 下被严格禁止或不再产生预期效果。
# 传统危险写法(pandas 3.0 抛出 ChainedAssignmentError 或直接失效)
# 错误示范:
df["user_age"][df["user_age"] < 0] = 0

# 3.0 标准推荐写法(明确指定行列索引与赋值目标):
df.loc[df["user_age"] < 0, "user_age"] = 0
2. inplace=True 的淡出与方法链规范
在启用 CoW 后,传统的 df.fillna(0, inplace=True) 或 df.drop(columns=[...], inplace=True) 不再带来任何内存节省优势,反而割裂了执行上下文。pandas 3.0 推荐全面转向返回新对象的链式调用(Method Chaining):
# 现代数据清洗流水线范式
clean_df = (
    raw_df
    .rename(columns={"old_col": "new_col"})
    .assign(processed_val=lambda x: x["val"] * 1.05)
    .dropna(subset=["key_id"])
)
3. 静默类型向下转换(Silent Downcasting)被移除
在早期版本中,调用 df.fillna() 或 df.replace() 时,如果填入的数据类型与原列不符,pandas 可能会静默将整列类型转换(例如将整型列转为浮点型甚至 object)。在 pandas 3.0 中,如果不显式指定转换,将直接抛出类型不匹配异常或保留严格类型约束,这要求候选人在数据摄入阶段就要做好清晰的 Schema 定义。
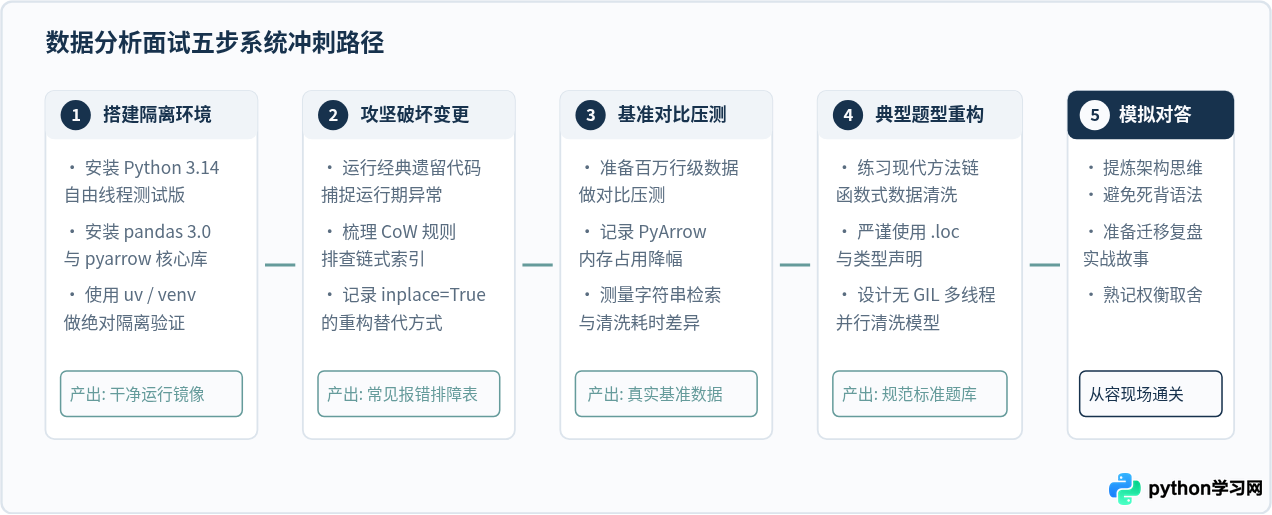
四、五步系统备考路径:从环境搭建到现场表达
准备这场面试需要一套条理清晰的落地方法。建议按照以下五个阶段逐步推进,确保理论、实操与表达融会贯通。
步骤一:搭建专属双版本测试实验台
不要停留在看文档的层面,动手搭建一套真实的实验环境。你可以使用现代工具 uv 或官方包管理器快速安装 Python 3.14 预编译版本以及 pandas 3.0 测试环境:
# 使用 uv 快速初始化 Python 3.14 隔离虚拟环境
uv venv --python 3.14 env_p314
source env_p314/bin/activate

# 安装 pandas 3.0 与 pyarrow
uv pip install "pandas>=3.0.0" pyarrow
步骤二:跑通经典基准测试,获取量化说服力
在面试中,量化指标比形容词更有说服力。你可以准备一个简短的脚本,亲自测试生成 100 万条字符串记录,对比 object 类型与 string[pyarrow] 类型的内存占用与正则过滤耗时:
import pandas as pd
import numpy as np

# 构造含有随机文本的数据集
n = 1_000_000
raw_text = ["user_" + str(i) for i in range(1000)]
data = np.random.choice(raw_text, size=n)

# 比较传统 object 与 pyarrow 类型的内存差异
df_obj = pd.DataFrame({"text_col": pd.Series(data, dtype="object")})
df_arrow = pd.DataFrame({"text_col": pd.Series(data, dtype="string[pyarrow]")})

# 在面试中你可以直接引用结论:Arrow 格式内存占用从约 64MB 骤降至 11MB 左右,降幅超过 80%
五、高频经典面试场景与满分回答策略
在实际面试沟通中,考官常常抛出开放性场景题。以下是三道核心真题及推荐的应答结构:
高分回答要点:
1. 定位风险源:主要隐患集中在三点:一是存量代码中的链式索引修改失效;二是过度依赖 inplace=True 的遗留逻辑;三是未声明类型的文本列在引入 Arrow 后因类型强校验导致的隐式转换失败。
2. 两步平滑策略:在旧版本(如 2.2+)上提前通过 pd.set_option("mode.copy_on_write", True) 开启 CoW 模式,开启全套单元测试,在现有环境中捕获所有报警与异常;
3. CI 阶段阻断:在自动化测试流程中设置 warnings.filterwarnings('error', category=FutureWarning),在升级前彻底清理所有不规范语法。
高分回答要点:
1. 肯定收益:在共享只读数据集的场景下(如基于公共维表进行特征提取),多线程具有绝对优势,无需通过 IPC 序列化复制数据,内存占用减少,线程切换开销极小;
2. 指出边界:多线程并非银弹。首先,第三方 C/C++ 扩展库若尚未完成自由线程安全适配(未去除全局静态状态),可能导致段错误;其次,如果并发流水线涉及大量写操作,Python 级别的字典/列表操作仍需业务层锁同步;对于超大规模、单机内存无法容纳的特征矩阵,分布式计算(如 Spark/Ray)仍是唯一解。
高分回答要点:
1. 历史误区:过去很多开发者误以为 inplace=True 不消耗额外内存,但事实上底层大多数操作依然先在内部创建副本再替换指针,并没有真正节省内存;
2. 阻碍优化:在 Copy-on-Write 架构下,每个数据块的引用状态由引用计数精确跟踪。inplace=True 隐式破坏了方法链(Method Chaining)的纯函数性质,使编译器和分析引擎难以推导计算图,因此全面推荐管道式声明式清洗。
六、技术选型与考点速查矩阵
为了在面试前快速复习,下表及全景决策图归纳了版本演进中最核心的对比要素:
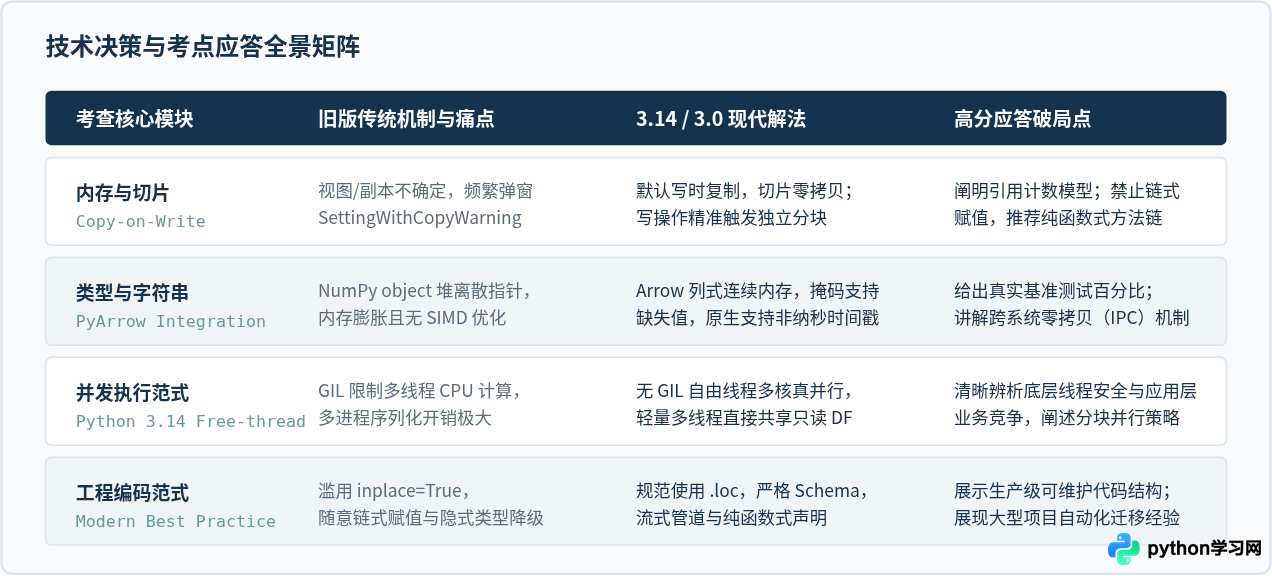
| 考查要点 | 老版本常见表现 | 3.0 / 3.14 规范要求 | 面试避坑建议 |
|---|---|---|---|
| 切片修改赋值 | df['col'][mask] = val 弹警告 |
必须使用 df.loc[mask, 'col'] = val |
强调 CoW 下链式赋值可能直接抛出错误或静默失效 |
| 字符串列存储 | 默认 object 类型,内存开销大 |
推荐 string[pyarrow],默认内存减负 |
提及与 Parquet / Polars 跨框架零拷贝交互优势 |
| 多线程清洗 | 受制于 GIL,多线程无加速效果 | Python 3.14 自由线程支持真正多核并行 | 指出业务逻辑仍需关注竞争风险,推荐分块汇总模式 |
| 函数修改模式 | 广泛使用 inplace=True |
完全转向方法链(Method Chaining) | 澄清历史误区:inplace 从未带来真正的零内存分配 |
综上所述,准备一场聚焦 Python 3.14 与 pandas 3.0 的数据分析面试,关键在于跳出语法层面的细枝末节,立足于内存行为、类型引擎与并发架构。当你能准确指出写时复制如何从根本上终结视图与副本之争、PyArrow 如何重塑字符串列式存储,并结合实际工程迁移给出防御性编码建议时,你所展现出的就不再是一个普通的工具使用者,而是一位具备技术前瞻性与扎实工程底蕴的资深数据专业人才。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









