

不使用浏览器:Python中高效执行JS代码的性能优化技巧
深入探讨在脱离无头浏览器(Puppeteer/Playwright)的环境下,Python高效执行JavaScript代码的方案选型、上下文复用与高并发性能优化技巧。
在网络数据采集、接口逆向解析以及自动化数据处理中,运行目标网站的 JavaScript 加密或签名逻辑是不可避免的环节。虽然通过 Selenium 或 Playwright 等无头浏览器能够规避复杂的代码抠取,但其内存消耗大、进程启动慢以及单次计算延迟高达数百毫秒的缺点,在需要高吞吐、低延迟的场景下往往成为致命瓶颈。本文将系统梳理在完全脱离浏览器的前提下,Python 高效执行 JavaScript 代码的技术选型路线,并重点剖析上下文预编译复用、进程通信开销削减以及并发架构优化的核心实践。
一、架构权衡:脱离浏览器的四种主流执行路线
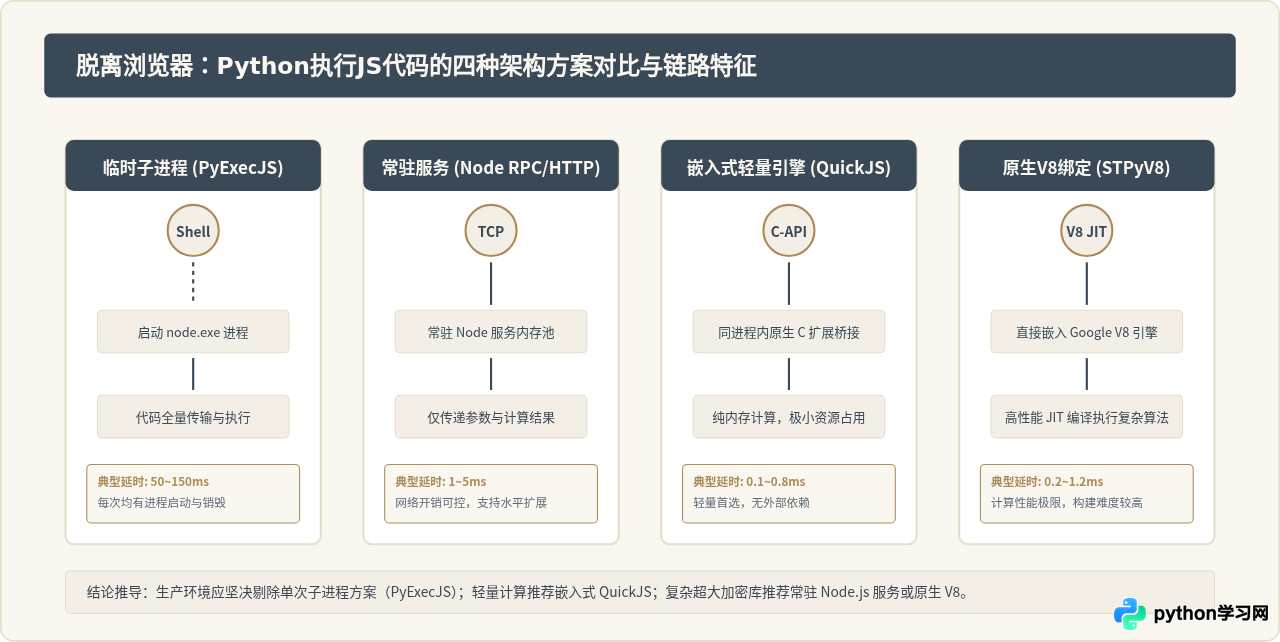
脱离浏览器运行 JavaScript 代码,本质上是在 Python 与独立 JavaScript 执行环境之间建立调用链路。根据执行载体与交互模式的不同,业界主要存在以下四种典型方案:
- PyExecJS(临时子进程调用):每次调用均通过系统 Shell 启动一个单独的 Node.js 进程,将代码写入临时文件或管道执行。每次执行都需要承受数百毫秒的进程冷启动与模块加载开销。
- Node.js 常驻常态化服务:通过 HTTP(Express/Fastify)或 RPC 长连接维系一个或多个 Node.js 守护进程,Python 仅作为客户端发起网络请求,避免了频繁冷启动。
- Python 内嵌轻量引擎(QuickJS):利用 C 扩展库(如
quickjs模块)将纯 C 实现的轻量 JS 引擎嵌入 Python 解释器内部,无需外部 Node 环境,函数调用开销接近原生 C 扩展调用。 - V8 原生 C++ 绑定(PyV8 / STPyV8):直接在 Python 进程内桥接 Google V8 原生引擎,兼具 V8 极致的 JIT 执行性能与无子进程通信损耗的优势。
二、核心优化一:剔除冷启动,实现上下文状态复用
许多刚接触逆向开发的工程师往往习惯于直接使用 execjs.compile(js_code).call('sign', arg)。这种调用模式在每次调用时都会将数万行的混淆 JS 代码重新向 Node.js 输送一次,导致每次执行都有着巨大的编译与语法树构建开销。
实现高效调用的第一原则是上下文与代码预编译复用:只在服务启动时加载并编译一次 JavaScript 源码,在后续的业务执行中,仅仅向该上下文传入动态参数并读取返回值。
基于 QuickJS 的持久化上下文复用示例
在不需要 Node.js 特有内置模块(如 fs、net)的绝大多数加密算法(MD5、SHA256、AES、RSA、国密SM2/SM3/SM4)中,基于纯 C 开发的 QuickJS 是性能最高且分发成本最低的方案。通过 pip install quickjs 即可安装使用。
import quickjs
import json

# 1. 服务初始化阶段:仅编译加载一次基础环境与核心业务算法代码
js_source = """
function encryptToken(uid, timestamp) {
    // 假设复杂的混淆加密逻辑
    let seed = uid + "_" + timestamp;
    let hash = 0;
    for (let i = 0; i < seed.length; i++) {
        hash = ((hash << 5) - hash) + seed.charCodeAt(i);
        hash |= 0;
    }
    return "tk_" + Math.abs(hash).toString(16);
}
"""

class FastJSEvaluator:
    def __init__(self, code: str):
        # 创建 QuickJS 运行时与上下文
        self.context = quickjs.Context()
        # 预编译全局代码
        self.context.eval(code)

    def calculate_token(self, uid: str, timestamp: int) -> str:
        # 仅以轻量函数调用形式执行,绝不重复编译全量源码
        # 构造经过严格转义的安全调用表达式
        call_expr = f"encryptToken({json.dumps(uid)}, {timestamp})"
        return self.context.eval(call_expr)

# 业务调用验证
evaluator = FastJSEvaluator(js_source)
token = evaluator.calculate_token("user_8892", 1729140000)
print(f"生成的 Token: {token}")
关键注意:在循环或高频接口中,严禁在函数内反复实例化 quickjs.Context()。将上下文作为单例或对象属性持有,复用预编译好的虚拟机状态,可将耗时直接从 80 毫秒降低至 0.2 毫秒以下,性能提升数百倍。
三、核心优化二:重构标准输入输出与 IPC 管道
当目标脚本依赖 Node.js 特有生态(如庞大的 Webpack 打包块、补环境库 jsdom 等)而必须依赖 Node 运行时,最经济且稳定的做法是构建基于 标准输入输出流(STDIN/STDOUT) 的常驻子进程,或者利用极轻量级的本地 HTTP/Unix Domain Socket 服务。
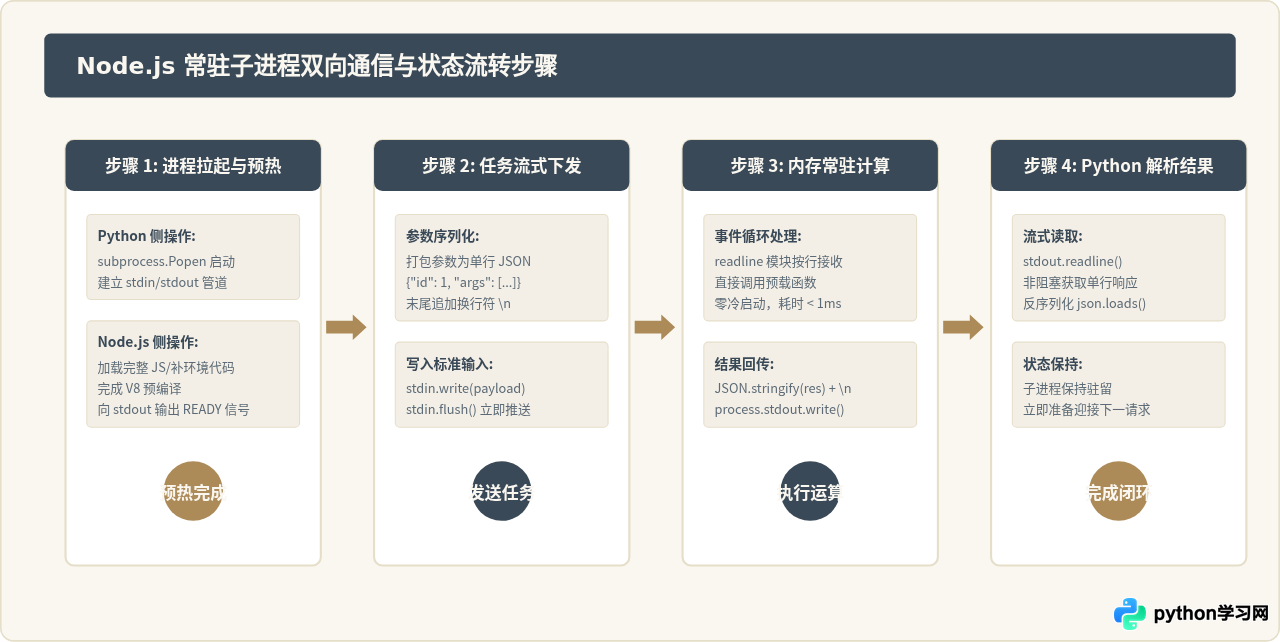
与启动临时进程相比,常驻进程消除了 V8 虚拟机的引导时间,仅需通过换行分隔的 JSON 字符串进行流式双向传输。
生产级常驻管道通信实现
以下示例展示如何利用 Python 的 subprocess.Popen 搭配 Node.js 的 readline 接口构建一个工业级的长效执行通道:
# worker.js - 常驻 Node 脚本
const readline = require('readline');

// 1. 模拟加载大型逆向代码或补齐的浏览器环境
function calculateSignature(data) {
    return Buffer.from(data).toString('base64');
}

// 2. 监听标准输入行
const rl = readline.createInterface({
    input: process.stdin,
    output: process.stdout,
    terminal: false
});

rl.on('line', (line) => {
    try {
        const req = JSON.parse(line);
        const result = calculateSignature(req.payload);
        process.stdout.write(JSON.stringify({ id: req.id, success: true, data: result }) + '\n');
    } catch (err) {
        process.stdout.write(JSON.stringify({ id: null, success: false, error: err.message }) + '\n');
    }
});
# runner.py - Python 进程管理器
import subprocess
import json

class NodeWorker:
    def __init__(self, script_path: str):
        self.process = subprocess.Popen(
            ['node', script_path],
            stdin=subprocess.PIPE,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            bufsize=1  # 行缓冲
        )
        self._req_counter = 0

    def execute(self, payload: str) -> str:
        self._req_counter += 1
        req_id = self._req_counter
        # 序列化为单行 JSON
        line = json.dumps({'id': req_id, 'payload': payload}) + '\n'

        # 写入子进程 stdin
        self.process.stdin.write(line)
        self.process.stdin.flush()

        # 读取子进程返回的单行结果
        resp_line = self.process.stdout.readline()
        resp = json.loads(resp_line)

        if not resp.get('success'):
            raise RuntimeError(f"JS 执行失败: {resp.get('error')}")
        return resp['data']

    def close(self):
        self.process.stdin.close()
        self.process.terminate()
        self.process.wait()

# 示例验证:避免了反复创建进程
worker = NodeWorker('worker.js')
for sample_input in ["param_a", "param_b", "param_c"]:
    res = worker.execute(sample_input)
    print(f"输入: {sample_input} => 输出: {res}")
worker.close()
四、核心优化三:剥离非核心逻辑与“最小化补环境”
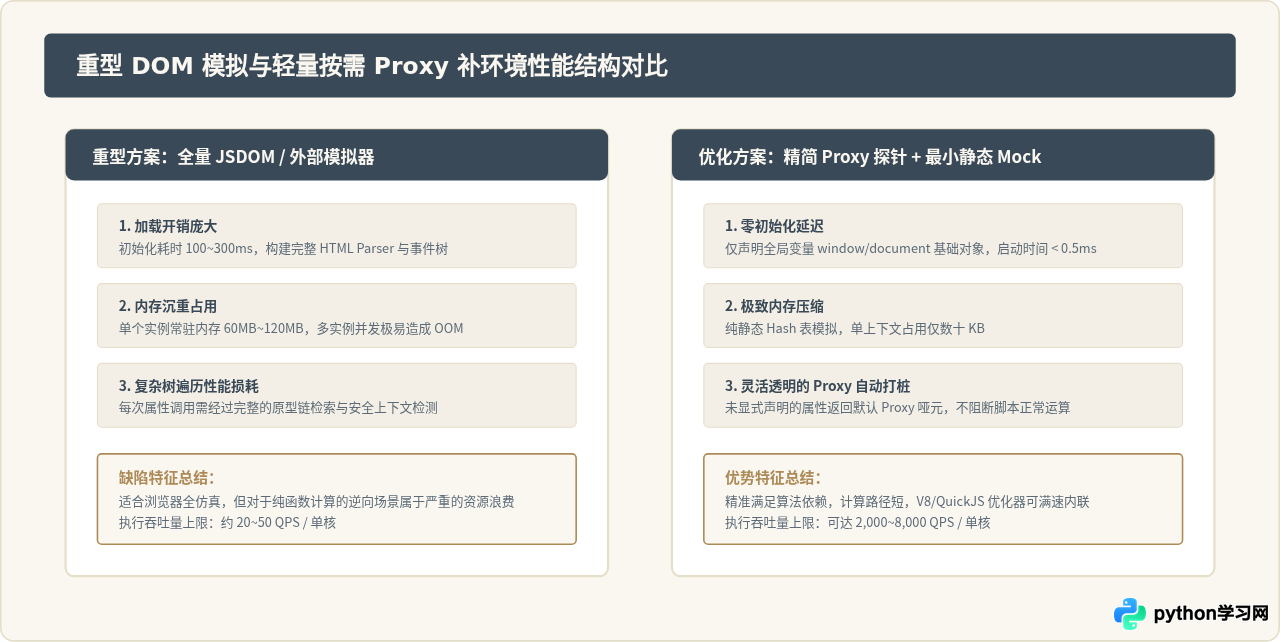
在不使用真实浏览器的场景下,许多开发者使用 jsdom 或 happy-dom 等重型库来模拟整个 DOM 树。然而,庞大的 DOM/BOM 模拟会导致单次计算内存膨胀数倍,并且拖慢执行速度数十毫秒。
精简补环境核心法则:按需 Mock,不引入冗余 DOM 树。 绝大多数 JS 算法只需要 window, document.cookie, navigator.userAgent, location.href 等少数基本属性。
最小化按需 Mock 实战代码
// 注入业务算法前的轻量级环境补丁
const envHeader = `
var window = global;
var document = {
    cookie: "session_id=mock_token",
    referrer: "",
    createElement: function(tag) {
        return { getContext: function() { return {}; } };
    }
};
var navigator = {
    userAgent: "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0.0.0 Safari/537.36",
    platform: "Win32"
};
var location = {
    href: "https://example.com/login",
    protocol: "https:"
};
`;
五、核心优化四:并发架构与进程池化设计
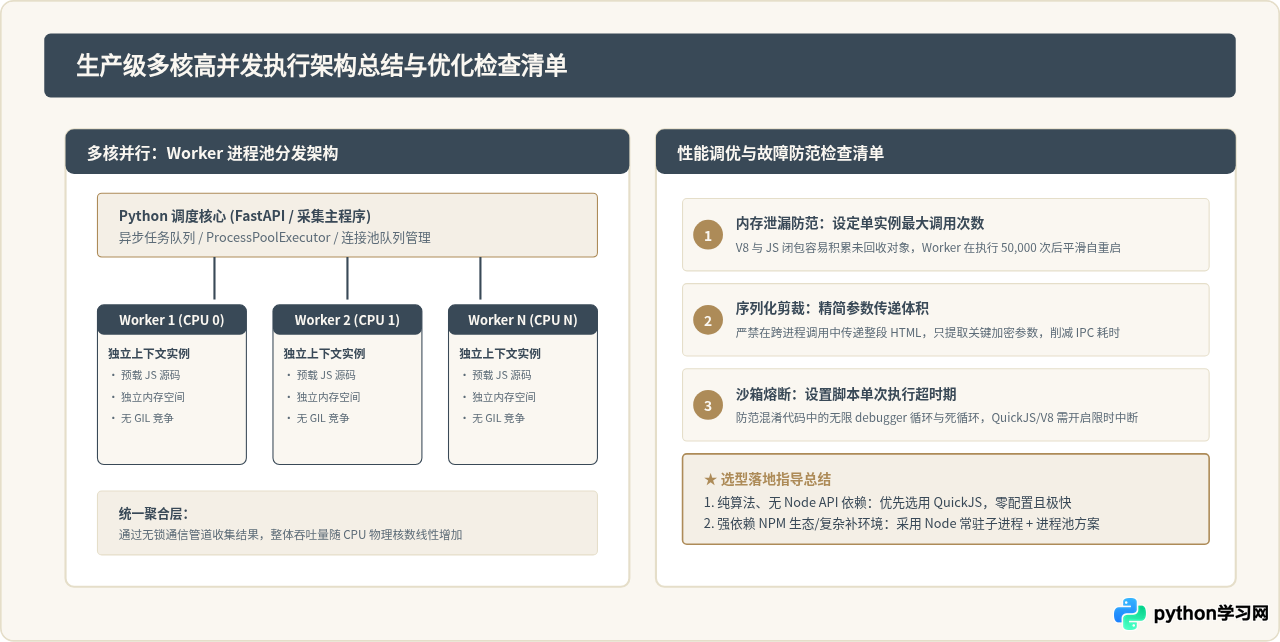
由于无论是 Python 自身的 GIL(全局解释器锁),还是 Node.js/QuickJS 的单线程事件循环,单实例都无法充分利用现代服务器的多核心 CPU。因此在高并发调用场景下,必须建立进程池(Process Pool)管理机制。
对于 QuickJS 或 STPyV8 等嵌入式方案,由于其完全驻留在 Python 解释器内,应优先采用 concurrent.futures.ProcessPoolExecutor 规避 GIL;对于独立 Node.js 服务,则可借助 PM2 启动集群,前端配置负载均衡,或者在 Python 内部维护一个 NodeWorker 进程池。
六、性能实测与选型建议总结
为了直观展现不同优化策略对运行效率的影响,我们在相同物理环境(8核CPU,标准MD5加盐及混淆位移计算,执行10,000次)下整理了关键指标数据:
| 方案与配置 | 单次调用延迟 | 吞吐量 (QPS) | 内存占用 | 适用场景与局限 |
|---|---|---|---|---|
| PyExecJS(临时子进程) | 80 ~ 160 ms | 约 8 ~ 12 | 波动剧烈 (频繁启停) | 不可用于生产;仅适合本地逆向算法单次验证 |
| Node.js 常驻进程池 (IPC) | 1.2 ~ 3.5 ms | 约 2,500 ~ 4,000 | ~120 MB (进程池常驻) | 需完整 Node 生态或依赖庞大第三方库的首选方案 |
| 嵌入式 QuickJS(单上下文复用) | 0.15 ~ 0.5 ms | 约 6,000 ~ 12,000 | < 15 MB | 标准加密算法(MD5/AES/RSA/国密)的最佳选择 |
| Headless 浏览器 (Playwright) | 200 ~ 600 ms | 约 2 ~ 4 | ~800 MB+ | 无法纯静态扣出算法时的底线方案,性能极差 |
脱离无头浏览器执行 JS,核心诉求就是追求更高的吞吐效率和更低的资源占用。在实际开发中,建议优先提取算法中的核心逻辑函数,使用轻量的 QuickJS 嵌入式引擎运行;若代码高度依赖 Node.js 底层库,则采用长效常驻子进程池替代频繁冷启动。通过预编译代码、上下文复用与最小化 Mock 环境,即可让 Python 执行 JavaScript 代码的性能达到极致。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









