

python必背源代码pandas筛选和分组代码
精选Python数据分析中最高频的Pandas筛选和分组必背核心源代码。涵盖布尔掩码、query表达式、loc切片、多条件匹配以及groupby、agg命名聚合、transform广播与filter组过滤,配图详解运行原理与高频避坑要点。
SettingWithCopyWarning 等常见警告与性能陷阱。
一、准备演示环境与基准数据集
为了保证文中所有源代码可直接复制运行并对比验证,本文使用一份包含员工部门、城市、薪资、绩效评分与入职状态的标准数据集作为演示基准。
import pandas as pd
import numpy as np

# 构造演示数据集
data = {
    'name': ['张三', '李四', '王五', '赵六', '钱七', '孙八', '周九', '吴十'],
    'dept': ['研发部', '研发部', '市场部', '研发部', '市场部', '运营部', '运营部', '研发部'],
    'city': ['北京', '上海', '北京', '深圳', '上海', '北京', '广州', '北京'],
    'salary': [18000, 22000, 15000, 26000, 12000, 16000, 14000, 31000],
    'score': [85, 92, 78, 95, 88, 82, 79, 98],
    'status': ['在职', '在职', '在职', '离职', '在职', '在职', '离职', '在职']
}

df = pd.DataFrame(data)
print(df)
二、Pandas 核心筛选必背源代码
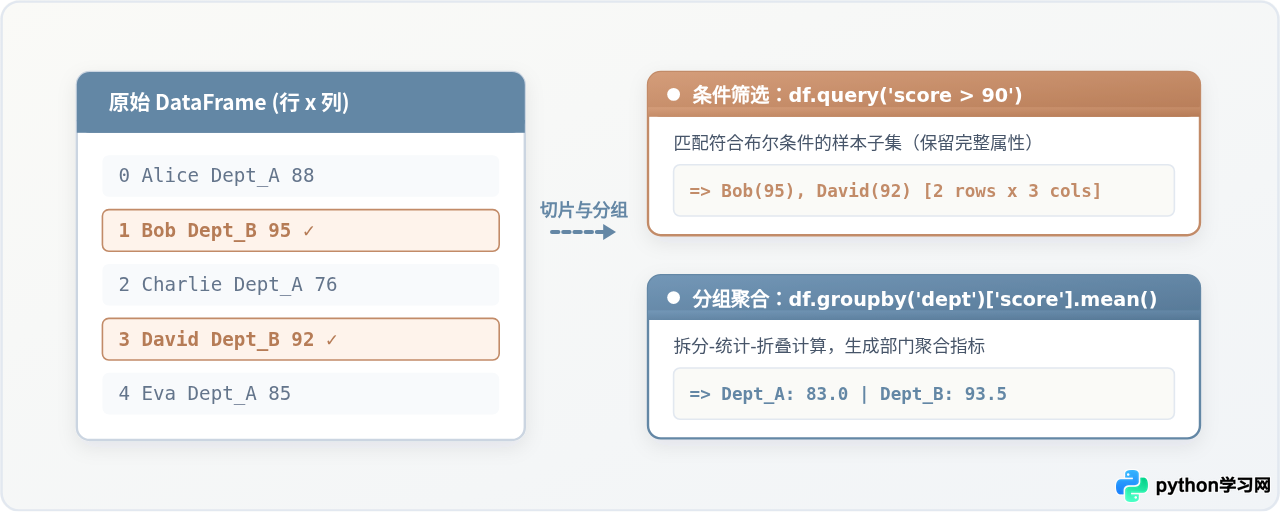
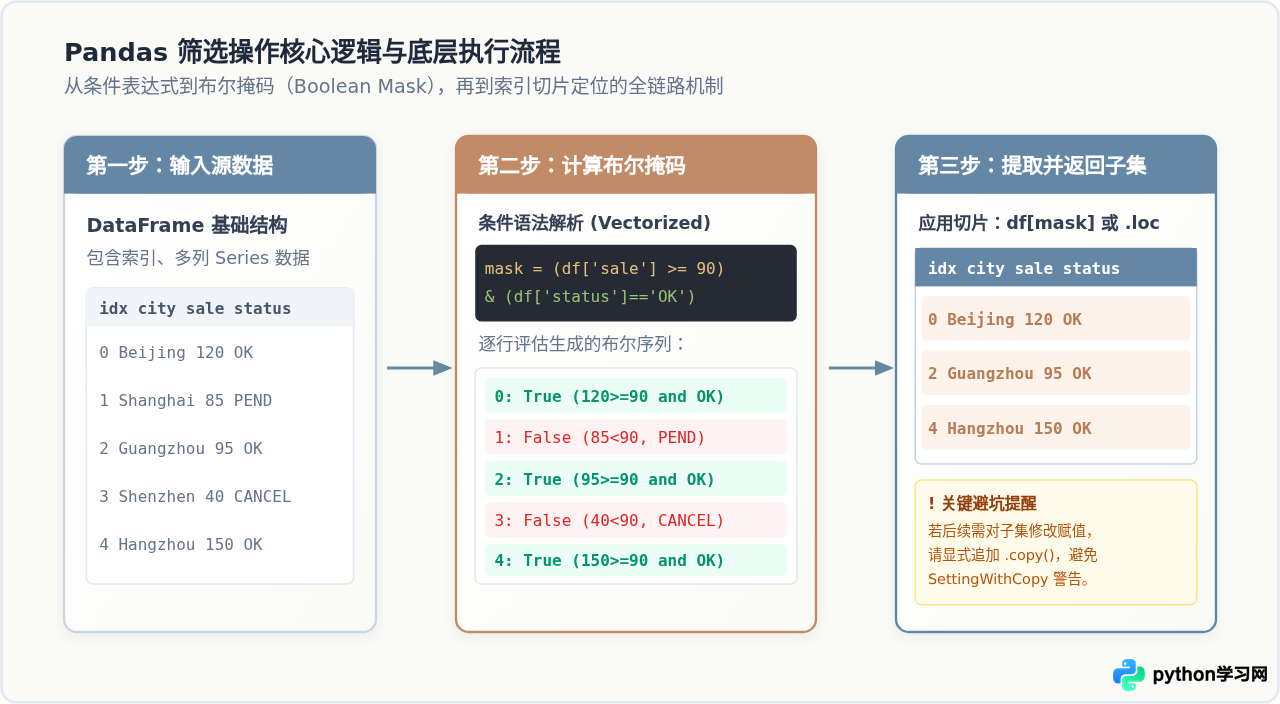
筛选的本质是通过布尔序列(Boolean Mask)从原始 DataFrame 中挑选满足特定条件的行。根据条件复杂度与匹配类型,常用的筛选方式分为五类。
1. 单条件与多条件布尔索引
多条件判断时必须使用位运算符 &(与)、|(或)、~(非),且每个子条件必须用小括号括起来。这是因为 Python 原生逻辑运算符 and/or 无法直接作用于向量序列,且位运算符的优先级高于比较运算符。
# 1. 单条件筛选:薪资大于 20000 的员工
res_single = df[df['salary'] > 20000]

# 2. 多条件与(&):研发部且在职员工(注意各子条件必须加小括号)
res_and = df[(df['dept'] == '研发部') & (df['status'] == '在职')]

# 3. 多条件或(|):城市在北京或薪资超过 25000
res_or = df[(df['city'] == '北京') | (df['salary'] > 25000)]

# 4. 非条件(~):筛选不在职的记录
res_not = df[~(df['status'] == '在职')]
2. 离散集合与数值区间筛选:isin 与 between
当需要匹配多个枚举值或判断连续数值区间时,使用 isin() 与 between() 比多重 | 拼接更简洁高效。
# 1. isin 筛选:属于研发部或运营部
res_isin = df[df['dept'].isin(['研发部', '运营部'])]

# 2. between 筛选:薪资在 15000 到 25000 之间(闭区间,两端均包含)
res_between = df[df['salary'].between(15000, 25000)]
3. 字符串与正则匹配:str.contains
对于文本列的子串查找,使用 str.contains()。生产环境中必须显式加入 na=False 参数,防止文本中存在缺失值时产生布尔混合类型报错。
# 查找城市包含“海”或“州”的记录
res_str = df[df['city'].str.contains('海|州', regex=True, na=False)]
4. 表达更自然的动态查询:df.query()
query() 方法允许直接传入类似 SQL 的文本表达式,代码无需反复书写 df[...]。当需要引用外部 Python 变量时,只需在变量名前加上 @ 符号。
min_salary = 15000
target_depts = ['研发部', '市场部']

# 引用外部变量进行链式查询
res_query = df.query("salary >= @min_salary and dept in @target_depts and status == '在职'")
5. 显式行与列同时定位:.loc 与 .iloc
如果筛选行的同时需要投影指定列,或者需要对筛选出来的子集赋值,必须使用 .loc[行条件, 列列表],严禁使用类似 df[条件]['列名'] = 值 的链式索引。
# 筛选北京员工,且仅取出姓名与薪资两列
res_loc = df.loc[df['city'] == '北京', ['name', 'salary']]

# 安全修改:将离职员工的状态统一更新为“已归档”(避免 SettingWithCopyWarning)
df_safe = df.copy()
df_safe.loc[df_safe['status'] == '离职', 'status'] = '已归档'
三、Pandas 核心分组必背源代码
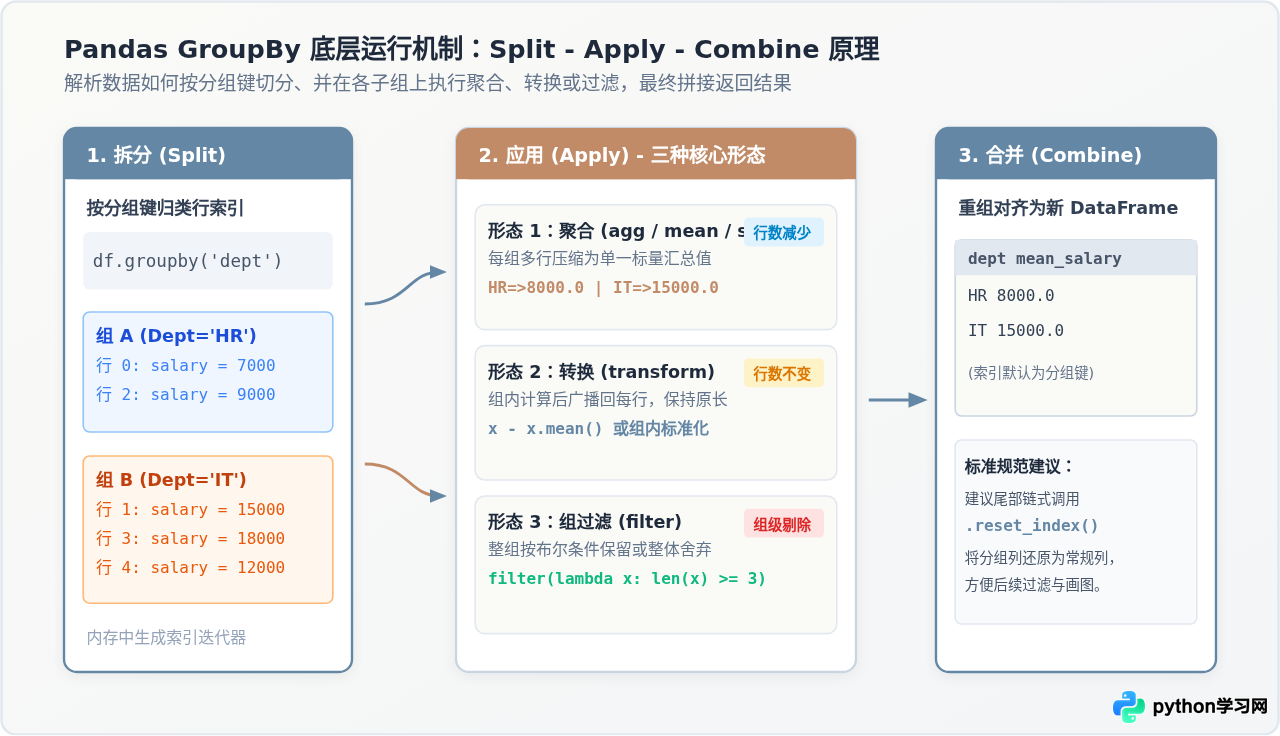
Pandas 的分组计算严格遵循 拆分-应用-合并(Split-Apply-Combine) 原理。分组之后,数据可以进行三种不同方向的运算:聚合(产生汇总标量)、转换(保留原形状广播)与组级过滤。
1. 基础单列与多列分组统计
最常规的用法是指定分组键后提取目标列求基础统计量(如 mean()、sum()、count()、max() 等)。
# 1. 单列分组单统计项:计算各部门平均薪资
dept_avg_sal = df.groupby('dept')['salary'].mean()

# 2. 多列复合分组:按部门和城市双维度统计员工人数
dept_city_count = df.groupby(['dept', 'city'])['name'].count()
2. 高阶精细化聚合:groupby().agg() 与命名聚合
在实际生产中,往往需要同时统计多个字段的不同指标。Pandas 推荐使用命名聚合(Named Aggregation),直接为统计结果指定清晰平整的列名,彻底避免多层索引(MultiIndex)带来的重命名烦恼。
# 推荐写法:命名聚合(Named Aggregation)
res_agg_named = df.groupby('dept').agg(
    emp_count=('name', 'count'),       # 员工人数
    avg_salary=('salary', 'mean'),     # 平均薪资
    max_salary=('salary', 'max'),     # 最高薪资
    avg_score=('score', 'mean')        # 平均绩效分
).reset_index()

print(res_agg_named)
3. 保持原行数的组内广播计算:groupby().transform()
agg() 会将每个组的多行数据折叠为一行,而 transform() 则会在各组内完成统计计算后,将结果广播回该组对应的每一行,输出的 Series 长度与原表完全一致。这在特征工程、计算相对偏差、组内缺失值均值填充时必不可少。
# 1. 计算每个员工的薪资相较于本部门平均薪资的差额
df['dept_mean_sal'] = df.groupby('dept')['salary'].transform('mean')
df['diff_from_dept'] = df['salary'] - df['dept_mean_sal']

# 2. 计算员工薪资在其所属部门内的占比
df['sal_dept_pct'] = df['salary'] / df.groupby('dept')['salary'].transform('sum')

print(df[['name', 'dept', 'salary', 'dept_mean_sal', 'diff_from_dept']])
4. 整组级别条件剔除:groupby().filter()
filter() 用于对分组本身进行布尔判断。若某分组满足传入 lambda 函数的条件,则保留该组内所有的原始记录;若不满足,则整组剔除。
# 仅保留员工总数大于等于 3 人的大部门的所有员工记录
res_filtered_group = df.groupby('dept').filter(lambda g: len(g) >= 3)
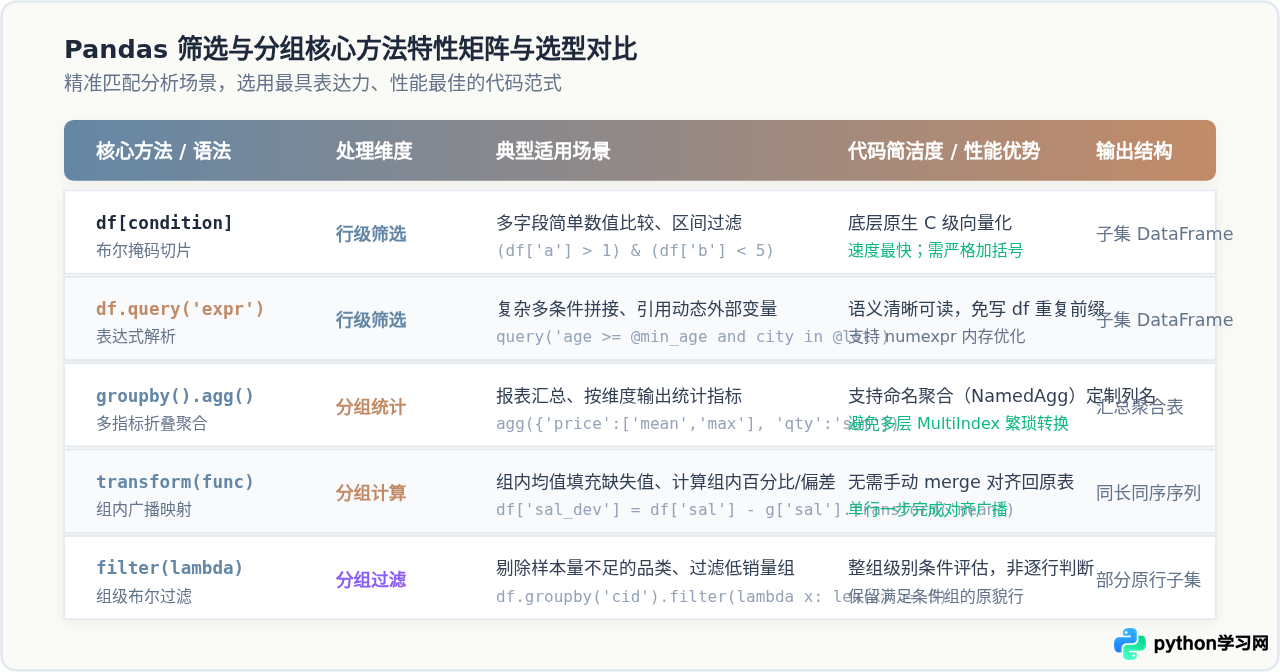
四、筛选与分组方法特性与选型对照
面对同一个业务问题,Pandas 通常有多种实现方式。根据代码执行效率、内存占用以及语义清晰度,以下是高频操作的特性对比。
五、筛选与分组的高频联用实战范式
在实际业务脚本中,筛选与分组极少孤立存在。掌握两者联合使用的最佳实践是编写整洁代码的关键。
1. “先筛选再分组”与“先分组后筛选”的选择
黄金原则:尽量“先筛选、后分组”。 提前通过布尔索引或 query 过滤掉无关记录(例如过滤已离职员工、异常值),可以成倍降低后续分组、哈希计算和聚合运算的数据规模。
# 推荐:先过滤在职员工,再统计各部门平均薪资
res_chain = (
    df.query("status == '在职'")
      .groupby('dept')
      .agg(
          active_emps=('name', 'count'),
          avg_salary=('salary', 'mean')
      )
      .reset_index()
      .query("avg_salary > 15000")  # 聚合后再次筛选高薪部门
)
print(res_chain)
六、高频避坑指南与性能注意事项
当你写出
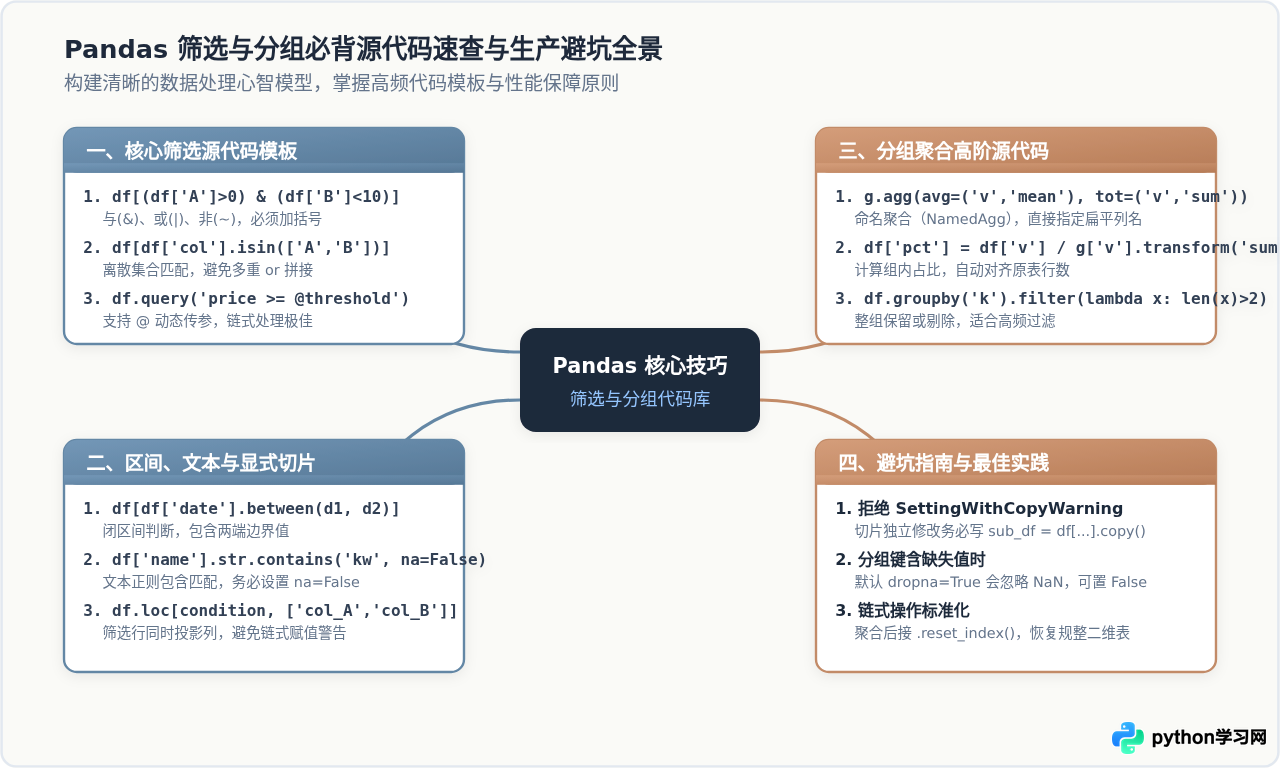
sub_df = df[df['salary'] > 20000] 后,紧接着对 sub_df['flag'] = 1 赋值时,Pandas 会抛出警告。这是因为 sub_df 可能是原 DataFrame 的一个“视图(View)”而非独立“副本(Copy)”。解决方案: 只要筛选出的子集需要后续修改赋值,务必显式调用
.copy():sub_df = df[df['salary'] > 20000].copy()
在 Pandas 默认机制下,
groupby() 的参数 dropna=True 会自动忽略分组列为 NaN 的记录,导致这部分数据在最终汇总表中直接消失。解决方案: 若需要将空值单独归为一组统计,请显式设置
dropna=False:df.groupby('dept', dropna=False)['salary'].mean()
当数据行数达到百万级别以上时,重复在字符列上进行
groupby 会耗费大量哈希运算时间。解决方案: 在分组前将字符串分组键转换为分类数据类型(
Categorical),计算速度通常可提升 2 到 5 倍:df['dept'] = df['dept'].astype('category')
七、核心代码极简速查清单
| 需求场景 | 必背核心源代码模板 |
|---|---|
| 多条件与筛选 | df[(df['col1'] > a) & (df['col2'] == 'b')] |
| 枚举匹配 | df[df['col'].isin(['v1', 'v2'])] |
| 数值区间 | df[df['col'].between(low, high)] |
| 子串模糊匹配 | df[df['col'].str.contains('keyword', na=False)] |
| 动态传参查询 | df.query('salary > @threshold and dept == @target') |
| 多字段命名聚合 | df.groupby('k').agg(new_col=('val', 'mean')).reset_index() |
| 组内对齐广播 | df['grp_avg'] = df.groupby('k')['val'].transform('mean') |
| 组级别整组过滤 | df.groupby('k').filter(lambda x: len(x) >= 5) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









