

Python 3机器学习入门常用库:TensorFlow与PyTorch适用场景解析
针对Python 3机器学习初学者,系统对比TensorFlow与PyTorch的设计机制、编码工作流、调试体验与工程部署能力,解析学术研究与工业落地的选型依据,助你快速找准适合自己的学习方向。
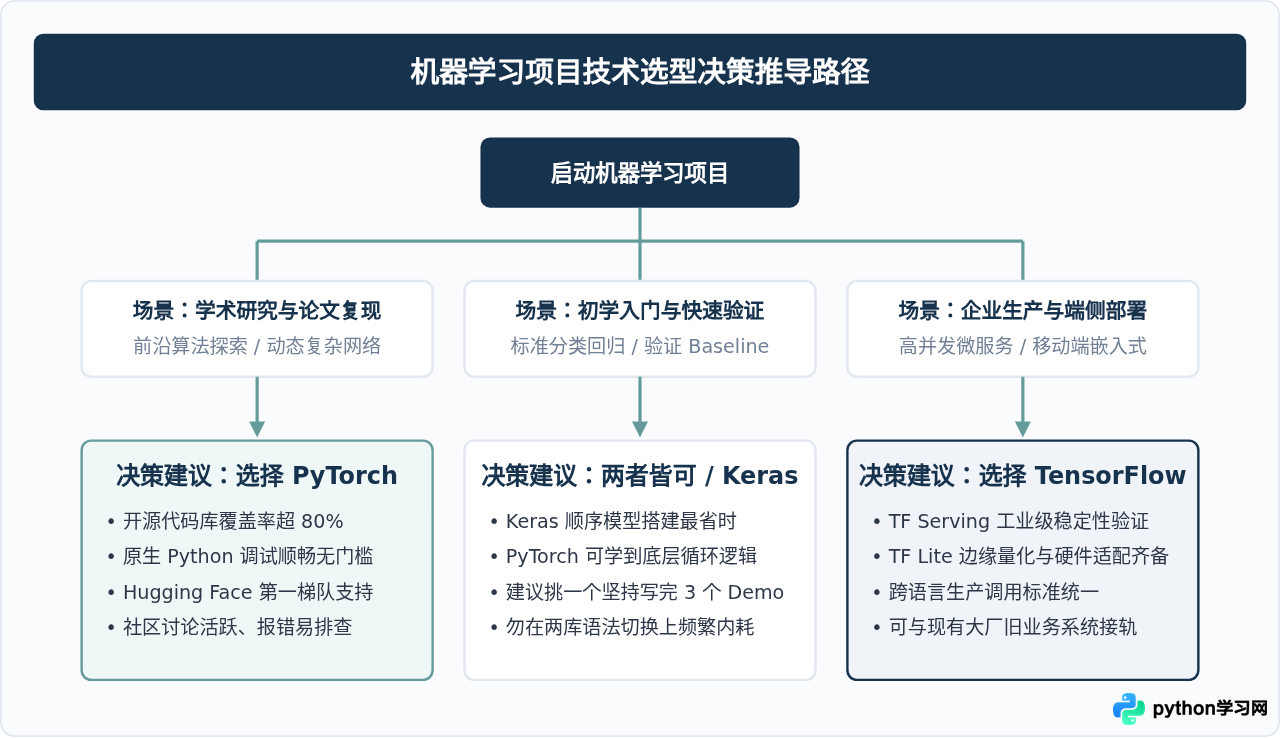
对于刚开始接触 Python 3 机器学习与深度学习的开发者来说,选择 TensorFlow 还是 PyTorch 往往是绕不开的第一道门槛。结论先放在前面:如果你的首要目标是学术探索、前沿论文复现或快速验证算法原型,PyTorch 凭借直观的原生 Python 调试体验与极为繁荣的高校科研生态是首选;如果你的目标是企业级工业化落地、跨平台高并发服务部署,或是移动端/嵌入式设备推理,TensorFlow 依托成熟的 TF Serving 与 TF Lite 生产工具链依然更具工程优势。两者的底层功能重合度已达 80% 以上,理解它们的设计差异与适用边界,才能帮助你在学习和业务实践中找准定位。
一、核心架构演进:动态即时计算图与混合执行模式
深度学习库的核心工作是组织多维张量(Tensor)运算,并在前向计算后自动构建计算图进行反向传播梯度求导。在计算图的构建机制上,两个框架存在显著的哲学差异。
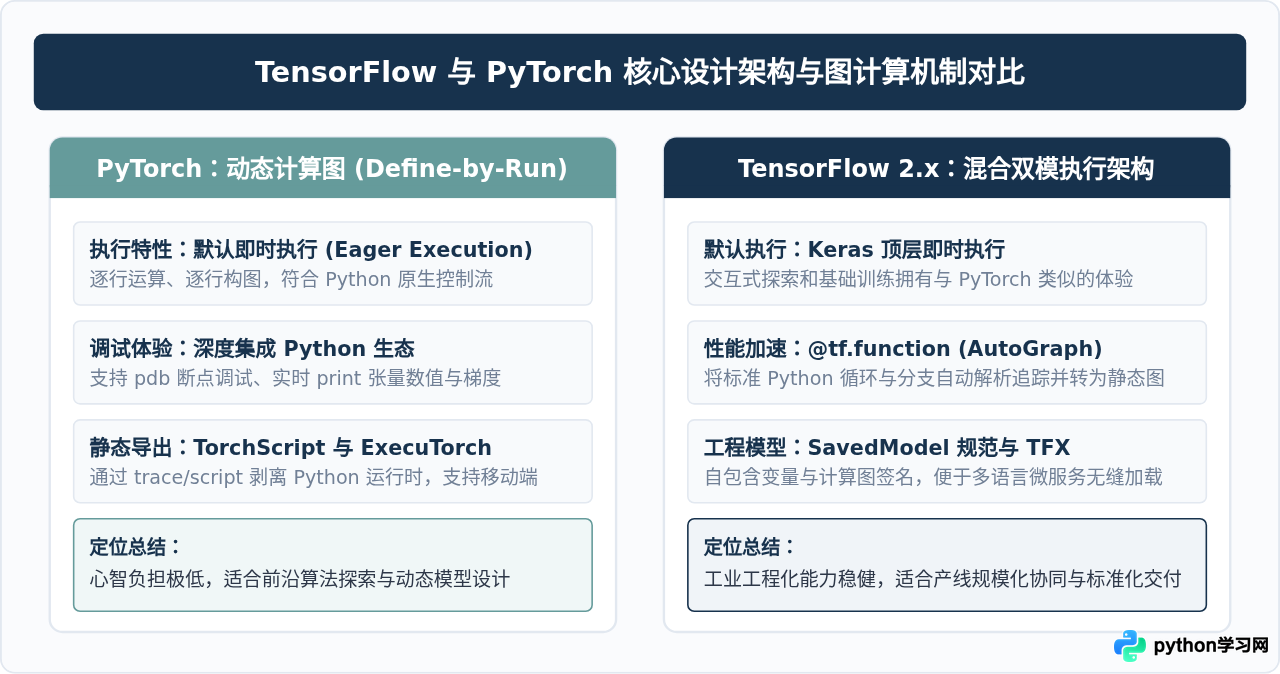
PyTorch 自诞生起就推崇即时执行(Eager Execution)与动态计算图(Define-by-Run)。每执行一行 Python 代码,PyTorch 就立即完成该节点的张量运算并把依赖关系记录到调用栈中。这意味着你可以在代码中随时插入标准 print() 语句打印张量形状,甚至可以直接使用 Python 原生的 pdb 或 IDE 断点调试。其执行流程完全遵循原生 Python 逻辑,对动态输入长度(如自然语言处理中的不定长句子)支持极其自然。
TensorFlow 在 1.x 时代采用静态图(Define-and-Run),必须先使用占位符定义完整的计算图网络,然后启动 tf.Session() 传入数据运行。这种方式虽然极利于跨语言序列化导出与编译器优化,但调试和报错极为隐晦。在 2.x 版本中,TensorFlow 全面转向默认即时执行模式,并引入 @tf.function 装饰器作为桥梁:在开发调试期像普通 Python 代码一样执行,在准备上线生产时通过 AutoGraph 机制自动追踪转为高性能静态图。
二、开发工作流与代码实现对比
在实际编码中,一个典型的机器学习训练任务包括四个标准环节:数据读取预处理、定义网络结构、执行前向传播与反向求导、更新参数与验证。通过具体代码片段可以清晰看到两者的编码风格区别。
1. 数据管道构建
PyTorch 依托 torch.utils.data.Dataset 和 DataLoader。你需要继承基类并实现 __len__ 与 __getitem__ 两个方法,逻辑直观:
import torch
from torch.utils.data import Dataset, DataLoader

class CustomDataset(Dataset):
    def __init__(self, data, labels):
        self.data = torch.tensor(data, dtype=torch.float32)
        self.labels = torch.tensor(labels, dtype=torch.long)
    def __len__(self):
        return len(self.data)
    def __getitem__(self, idx):
        return self.data[idx], self.labels[idx]

loader = DataLoader(CustomDataset(x_train, y_train), batch_size=32, shuffle=True)
TensorFlow 则主要使用 tf.data.Dataset 链式调用 API。它擅长利用内部多线程和预取机制优化大吞吐量 I/O:
import tensorflow as tf

dataset = tf.data.Dataset.from_tensor_slices((x_train, y_train))
dataset = dataset.shuffle(buffer_size=1024).batch(32).prefetch(tf.data.AUTOTUNE)
2. 网络定义与模型训练
在模型定义阶段,PyTorch 习惯面向对象风格,继承 nn.Module 并显式重写 forward 过程;在训练阶段,PyTorch 默认要求编写显式的 Python for 循环,逐批次完成梯度归零、反向传播与优化器步进:
import torch.nn as nn
import torch.optim as optim

class SimpleMLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc = nn.Linear(784, 10)
    def forward(self, x):
        return self.fc(x)

model = SimpleMLP()
optimizer = optim.Adam(model.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()

for epoch in range(5):
    for batch_x, batch_y in loader:
        optimizer.zero_grad()
        loss = criterion(model(batch_x), batch_y)
        loss.backward()
        optimizer.step()
而在 TensorFlow 2.x 中,高层 Keras API 将网络定义与训练高度封装。只需几行代码即可完成模型搭建、损失函数绑定与全自动训练,适合快速起步:
model = tf.keras.Sequential([
    tf.keras.layers.Dense(10, activation='softmax', input_shape=(784,))
])

model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

model.fit(dataset, epochs=5)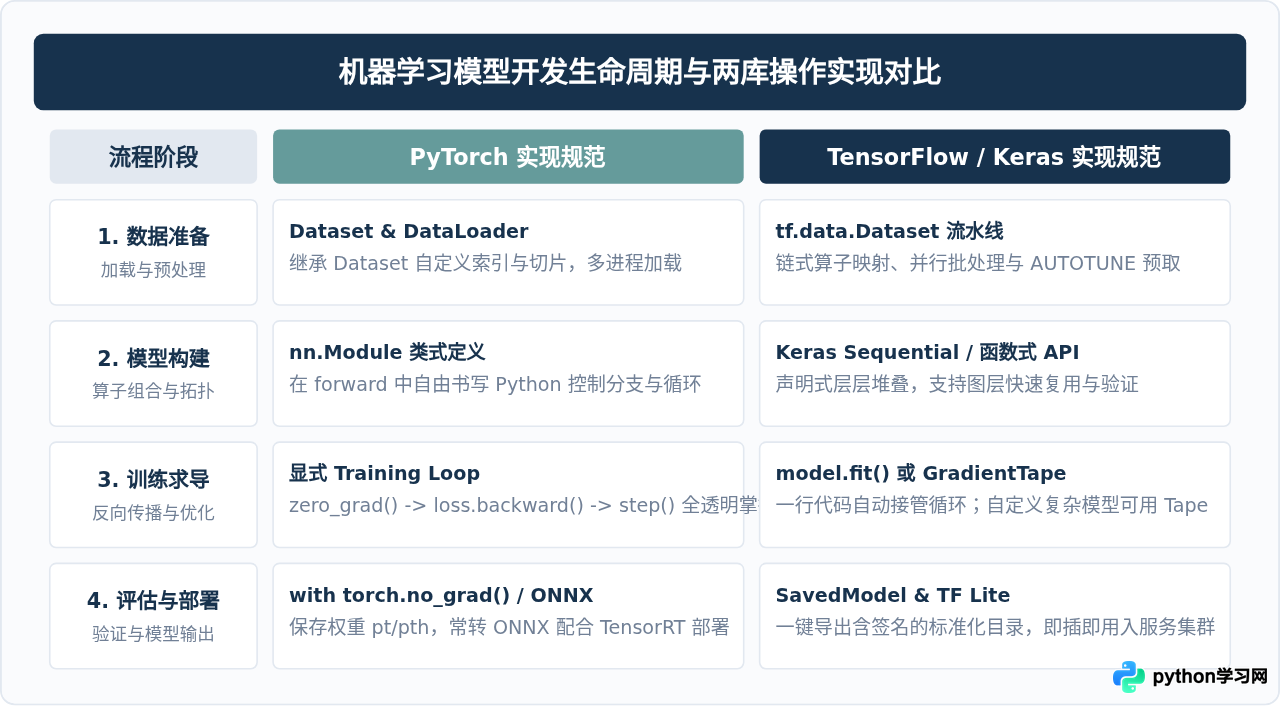
三、实际应用场景深度解析:何时选谁?
技术选型不能脱离具体的团队目标与硬件环境。以下从四个常见场景剖析两者的契合度:
1. 学术研究、论文复现与前沿算法设计(首选 PyTorch)
近年来 NeurIPS、ICLR、CVPR 等顶级 AI 会议中,超过 70%~80% 的开源代码基于 PyTorch 实现。Hugging Face Transformers 社区中最新的大语言模型(LLM)与多模态模型也基本以 PyTorch 作为首发权重格式。如果你是一名学生、研究生或算法研究员,选择 PyTorch 能让你在阅读论文时直接下载开源代码本地运行,省去大量的框架重写成本。此外,编写动态结构(如递归神经网络、可变拓扑图卷积)时,PyTorch 绝无拘束感。
2. 传统企业级生产、高并发线上推理与工程化交付(优先考量 TensorFlow)
在大型企业级服务中,模型训练往往只占机器学习工程(MLOps)生命周期的 20%,剩余的 80% 是数据验证、特征监控、多版本热更新、负载均衡与 RPC 推理。TensorFlow 拥有业界最成熟的配套生态:
- TensorFlow Serving:基于 C++ 开发的高性能 gRPC / REST 推理服务器,支持动态批处理(Dynamic Batching)、多模型热加载和微秒级延迟响应,开箱即用。
- TensorFlow Extended (TFX):提供从数据校验(TFDV)、特征转换(TFT)到模型评估(TFMA)的端到端管道规范。
3. 移动端App与嵌入式边缘计算设备(TensorFlow Lite 生态占优)
若需要将图像分类或语音唤醒模型部署到 Android、iOS 手机或树莓派等边缘设备,TensorFlow Lite (TFLite) 依然是目前覆盖最广、文档最齐备的方案。其量化工具(Post-training Quantization)能极低损耗地将 FP32 模型压缩为 INT8,并深度整合 Android NNAPI 硬件加速芯片。PyTorch 虽有 ExecuTorch 与 PyTorch Mobile,但在跨设备碎片化支持的成熟度上略逊一筹。
四、初学者常见误区与避坑建议
避坑提示:很多新手将大量精力浪费在“到底学哪个以后不会被淘汰”的心理摇摆中。实际上,深度学习的核心是线性代数、反向求导、损失函数设计、卷积注意力结构与泛化调优。这些知识在两个库之间是 100% 通用的。
在日常学习与开发中,需要特别警惕以下三个常见认知误区:
- 误区一:把学习 TensorFlow 等同于学习淘汰的 1.x 语法。互联网上仍残留大量
tf.placeholder、sess.run()等老旧教程,容易让初学者产生“TensorFlow 极其繁琐难学”的偏见。务必认准 TensorFlow 2.x 与 Keras 规范,它的写法同样十分优雅简明。 - 误区二:认为工业界只认某一个框架。现代工业化架构越来越倾向于“解耦”——许多团队采用 PyTorch 进行模型研究与训练探索,在确定网络结构后,通过
torch.onnx.export将模型转为通用的 ONNX 格式,再送入 NVIDIA TensorRT 或 Triton Inference Server 进行生产推理。掌握基本导出链路即可跨越框架壁垒。 - 误区三:初学者过早陷入复杂框架定制。刚入门时,应把重点放在使用标准数据集(如 MNIST、CIFAR-10、IMDB 影评分类)跑通完整的“数据清洗-特征归一化-定义模型-验证指标”流程上,而不是纠结内部优化器 C++ 层的实现差异。
五、综合选型总结与入门路径
为了让不同背景的读者有更直观的参考,下表对两者的关键维度进行了综合梳理:
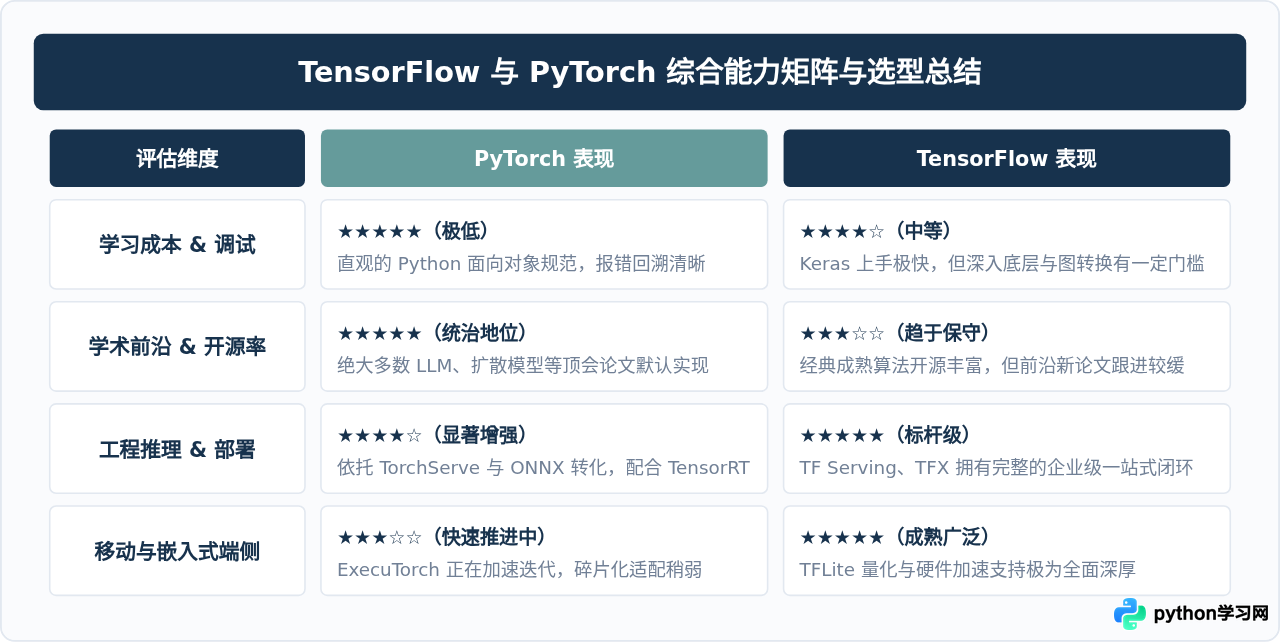
对于刚刚开始学习 Python 3 机器学习的新手,推荐按照以下路径开展实践:
- 推荐起步:以 PyTorch 为主力框架。先学习张量切片、广播机制与自动求导
autograd,亲手写一遍两层全连接神经网络训练手写数字识别。这种“白盒”式的代码编写方式能帮你彻底扫清对深度学习数学求导过程的恐惧。 - 拓展视野:在能够熟练编写 PyTorch 模型后,花半天时间体验 TensorFlow 2.x 的 Keras API,了解
tf.data的并行机制与SavedModel的导出结构。 - 融会贯通:进一步学习 ONNX 格式转换,理解现代 AI 工程中“PyTorch 搞实验开发,ONNX / TensorRT 搞推理落地”的跨框架主流协作方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









