

python必背源代码lambda匿名函数代码
系统梳理Python必背lambda匿名函数核心源代码,深入解析语法结构、多维数据排序、映射过滤、闭包延迟绑定陷阱排查及PEP 8工程规范选型。
在 Python 编程实践中,lambda 匿名函数是一种不需要使用 def 语句显式声明函数名的小型单行函数。它的核心设计目标并非替代传统函数,而是在高阶函数调用、多维数据排序以及临时回调处理等场景中,提供一种轻量、即用即抛的代码内联组织方式。掌握 lambda 匿名函数的核心语法骨架、高频实战模式以及变量作用域陷阱,是编写紧凑且地道 Python 源代码的必备基础。
一、lambda 匿名函数语法解构与运作模型
Python 中定义 lambda 匿名函数的基本语法格式如下:
lambda 参数1, 参数2, ... : 包含参数的单一表达式
该语法结构由三部分组成:lambda 关键字、以逗号分隔的形式参数列表,以及冒号后面的单一表达式。该表达式的计算结果即为函数的隐式返回值,开发者无需也不能在其中编写 return 语句。
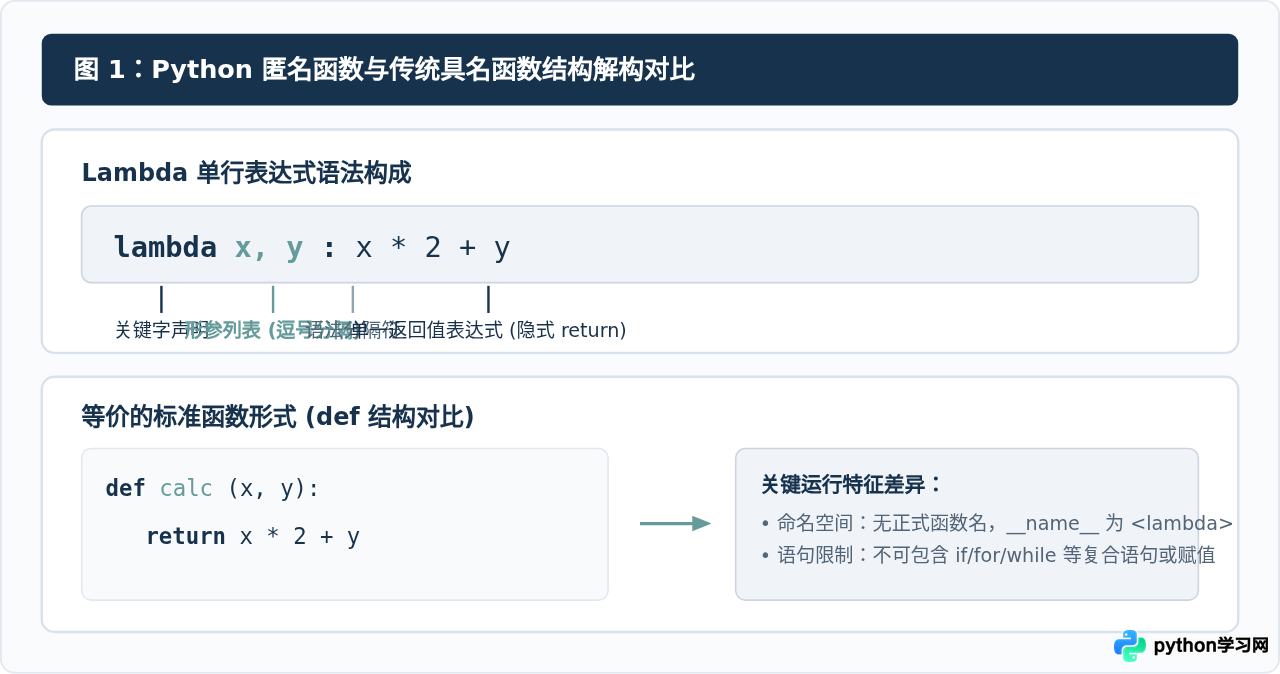
与传统的 def 语句相比,lambda 函数在底层同样生成一个可调用对象(FunctionType),但在代码层面上受到严格限制:
- 单行限制与表达式属性:冒号右侧必须是单一表达式,不能包含赋值语句(如
a = 1)或控制结构(如while、for循环)。三元条件表达式val1 if condition else val2则允许使用。 - 无正式标识符:lambda 函数对象的
__name__属性始终是字符串"<lambda>",在调试栈中不会显示具体的语义化函数名。
二、必背核心实战源代码模式
在工程开发与算法编写中,lambda 匿名函数最主要作为参数传递给高阶函数。以下整理四组必背的标准源代码模板。
1. 集合多维排序(sorted 与 list.sort 的 key 参数)
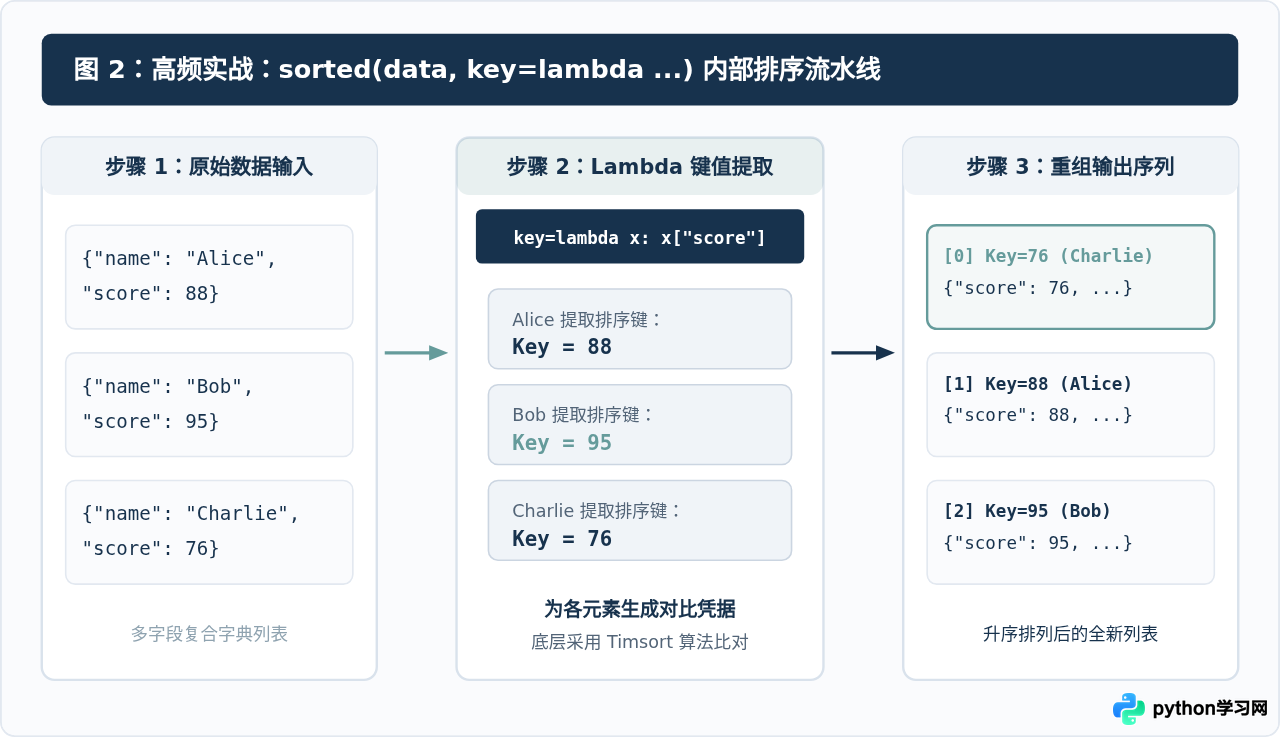
当处理复杂嵌套结构(例如字典列表、元组列表)时,sorted() 函数的 key 参数接收一个函数,用于从每个元素中提取出排序对比依据。
# 示例数据:包含姓名与成绩的学生记录列表
students = [
    {"name": "Alice", "score": 88, "age": 19},
    {"name": "Bob", "score": 95, "age": 20},
    {"name": "Charlie", "score": 88, "age": 18}
]

# 单维度升序排序:按成绩升序
by_score = sorted(students, key=lambda s: s["score"])
# 示例输出: [{'name': 'Alice', ...}, {'name': 'Charlie', ...}, {'name': 'Bob', ...}]

# 多维度复合排序:先按成绩降序,成绩相同再按年龄升序
by_complex = sorted(students, key=lambda s: (-s["score"], s["age"]))
# 示例输出: Charlie (88分/18岁) 排在 Alice (88分/19岁) 之前
2. 极值定位与动态比较(max / min 的 key 参数)
与排序类似,max() 与 min() 接收 key 函数以确定最大值或最小值的比较基准,直接返回原始数据对象而非仅仅是极值数值。
products = [
    {"title": "键盘", "price": 299, "sales": 1200},
    {"title": "鼠标", "price": 149, "sales": 3400},
    {"title": "显示器", "price": 1299, "sales": 450}
]

# 找出销量最高的产品记录
top_seller = max(products, key=lambda p: p["sales"])
# 示例输出: {'title': '鼠标', 'price': 149, 'sales': 3400}

# 找出单价最低的产品记录
cheapest = min(products, key=lambda p: p["price"])
# 示例输出: {'title': '鼠标', 'price': 149, 'sales': 3400}
3. 序列转换与条件过滤(map 与 filter 组合)
在数据管道和轻量清洗中,lambda 常与 map()、filter() 连用:
raw_scores = [65, 82, 49, 90, 73, 58]

# 过滤及格分数并统一进行标准差补偿加分
passed_scores = list(filter(lambda x: x >= 60, raw_scores))
# 示例输出: [65, 82, 90, 73]

curved_scores = list(map(lambda x: min(100, x + 5), passed_scores))
# 示例输出: [70, 87, 95, 78]
4. 分支路由与轻量计算工厂(字典 Dispatch 模式)
在没有 match-case 或需要配置化映射操作符时,将 lambda 作为字典值可以构建轻量级的分支计算器:
calculator = {
    "add": lambda x, y: x + y,
    "sub": lambda x, y: x - y,
    "mul": lambda x, y: x * y,
    "div": lambda x, y: x / y if y != 0 else float("inf")
}

# 执行运算
res_add = calculator["add"](10, 5)  # 示例输出: 15
res_div = calculator["div"](10, 0)  # 示例输出: inf
三、重点避坑:循环闭包中的延迟绑定机制
在初学及工程落地中,最常见且隐蔽的错误发生于循环结构内部定义 lambda 函数时。例如:
# 典型错误示例:试图创建一组分别乘以 0, 1, 2 的函数
multipliers = [lambda x: x * i for i in range(3)]

# 预期得到 [0, 10, 20],实际运行结果:
print([m(10) for m in multipliers])
# 示例输出: [20, 20, 20]
产生此现象的原因是 Python 闭包的延迟绑定(Late Binding)机制:lambda 函数体内的变量 i 是在函数被实际调用执行时才在外部作用域中查找解析,而不是在定义阶段固定。循环结束后,外层环境中的 i 最终停留在 2,导致所有函数调用时计算的均为 x * 2。
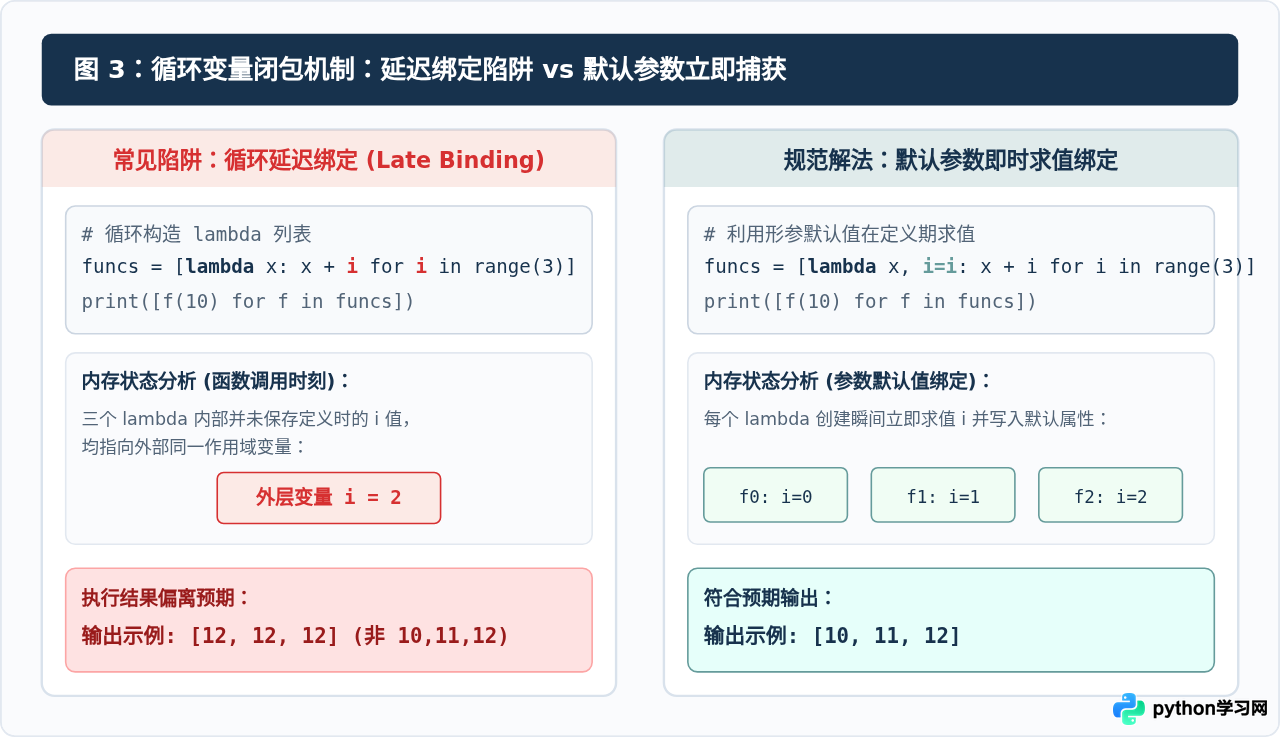
标准必背修复方案:利用函数默认参数在定义期求值的特性,将外层循环变量强制绑定至形参默认值中:
# 正确修复方案:使用 i=i 即时绑定当前循环值
multipliers_fixed = [lambda x, i=i: x * i for i in range(3)]

# 验证调用:
print([m(10) for m in multipliers_fixed])
# 示例输出: [0, 10, 20]
四、工程规范:PEP 8 指引与选型决策
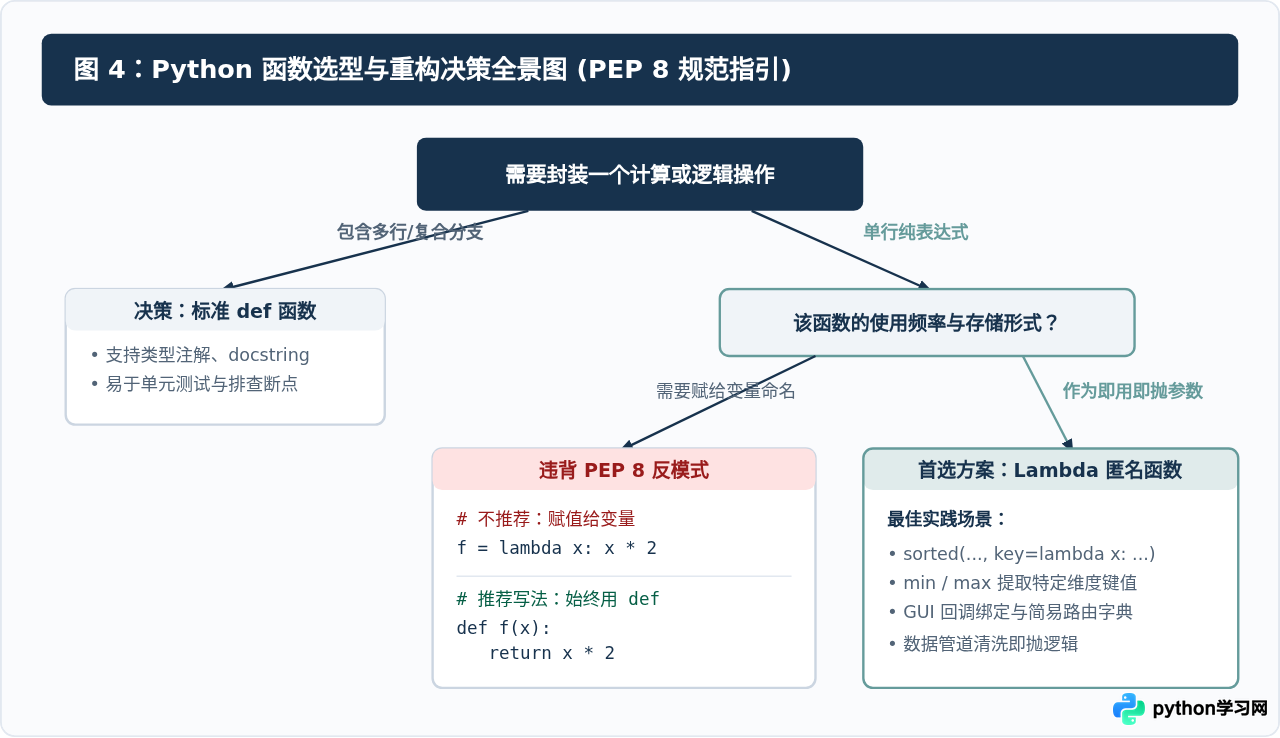
虽然 lambda 书写简短,但滥用会严重破坏代码可读性与可维护性。Python 官方代码风格规范(PEP 8)针对匿名函数给出了明确指引:
def 语句来绑定具名函数,避免使用赋值语句把 lambda 绑定到一个名称(例如反模式:f = lambda x: 2*x)。因为赋值给变量会剥夺 def 所带来的明确函数名、docstring 描述以及调试堆栈追溯优势。
| 场景需求 | 推荐方案 | 不推荐写法 | 选择理由 |
|---|---|---|---|
| 需要复用的具名逻辑 | def square(x): return x * x |
square = lambda x: x * x |
符合 PEP 8 规范,便于调试与测试 |
| 字典/对象属性提取排序 | operator.itemgetter("age") 或 lambda x: x["age"] |
嵌套三层以上的复杂 lambda | 标准库 operator 性能更高且语义明确 |
| 简单的序列映射与过滤 | 列表推导式 [x * 2 for x in data] |
list(map(lambda x: x * 2, data)) |
推导式更加 Pythonic 且执行速度更快 |
| 临时多条件排序或单次回调 | key=lambda x: (-x.score, x.id) |
单独编写只使用一次的五行 def 函数 | 上下文紧凑,无需跳读外部定义 |
五、总结
在 Python 代码编写中,lambda 匿名函数的定位是轻量级、无状态、局部的单行表达式封装。在编写涉及 sorted、max、min 等高阶函数的键值提取时,lambda 提供了极致紧凑的代码表现力;而在涉及多步逻辑、具名重用或复杂闭包时,应果断选用标准的 def 语句或列表推导式,以保证工程代码的健壮性与可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









