

Python namedtuple用法详解:让元组更具可读性
全面讲解 Python collections 模块中 namedtuple 的核心概念、创建方式、常用辅助方法、不可变机制以及与常规元组、字典和 dataclass 的选型对比。
record[2] 的取值方式极易引发索引混淆与维护困难。标准库 collections.namedtuple 提供了一个工厂函数,它能动态生成具备命名字段的元组子类,使开发者既能像访问对象属性一样直观读取数据,又能完全继承传统元组内存精简、执行高效且不可变(immutable)的底层优势。
一、namedtuple 核心价值与结构对比
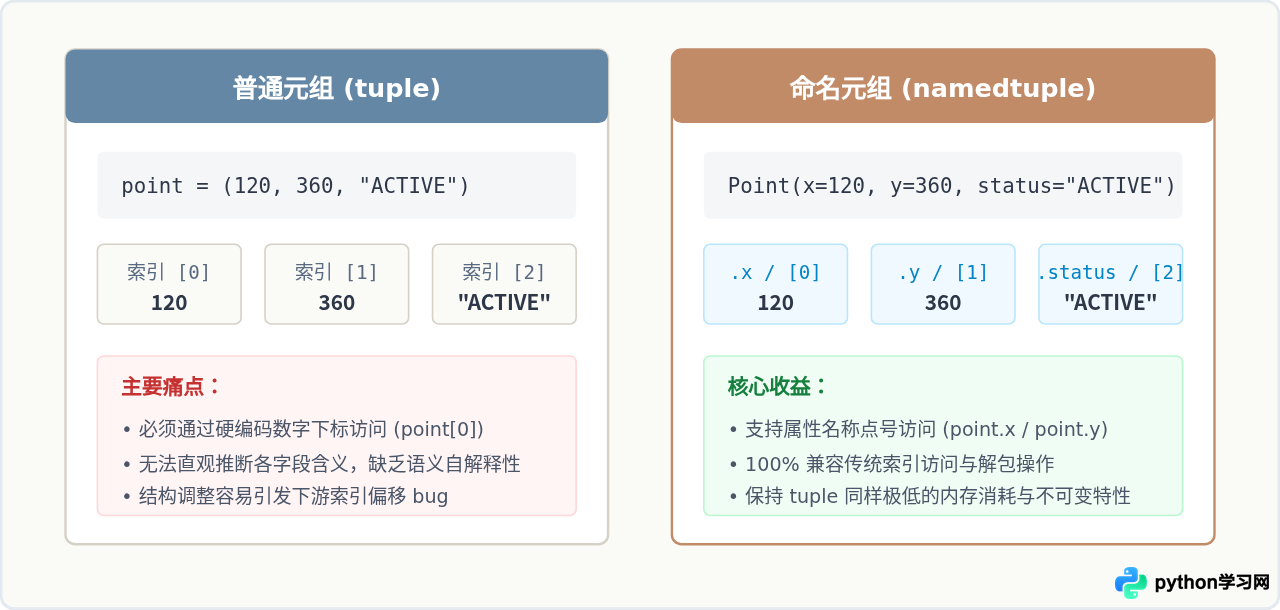
普通元组虽然能够打包多个数据项,但在表达具有明确业务语义的数据结构时存在天然短板:代码编写者必须在脑海中死记硬背每个下标对应的具体含义。一旦数据结构在后续迭代中插入或调整了字段顺序,所有依赖硬编码索引的切片与访问逻辑都可能悄然出错。
常规字典(dict)虽然通过键名解决了语意清晰度的问题,但字典是基于哈希表实现的动态可变结构,在存储大量只读数据时具有不容忽视的内存开销与哈希维护损耗。namedtuple 则在二者之间找到了平衡点:它在内存布局上与常规元组完全等价,在不增加对象体量的前提下,通过类属性描述符为每个字段建立了名称映射。
二、namedtuple 的标准定义与基本操作流程
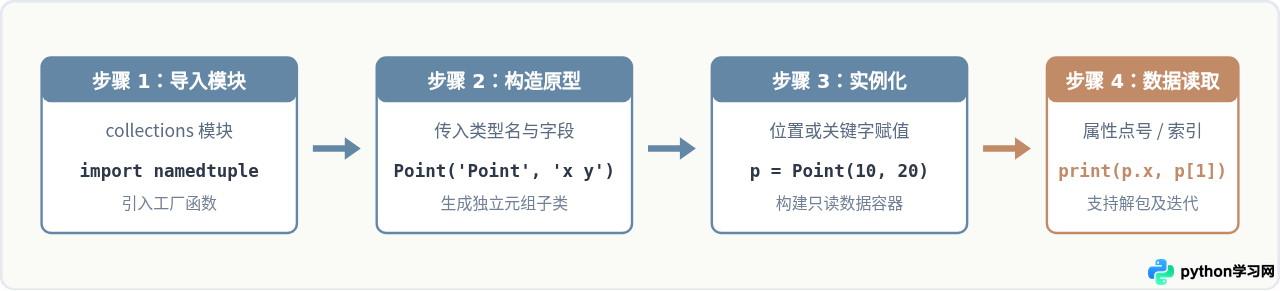
使用 namedtuple 主要遵循四个步骤:从 collections 模块导入工厂函数、声明具名子类类型、初始化实例对象、通过属性或解包消费数据。
1. 字段名的定义形式
在调用 namedtuple(typename, field_names) 时,field_names 支持多种灵活的书写方式。常用的包括单个字符串以空格分割、以逗号分割,或者直接传入字符串列表:
from collections import namedtuple

# 方式一:空格分隔字符串(最常用且简洁)
Point = namedtuple('Point', 'x y z')

# 方式二:逗号分隔字符串
User = namedtuple('User', 'id,name,role')

# 方式三:字符串列表或元组
Coordinate = namedtuple('Coordinate', ['latitude', 'longitude'])
2. 实例化与成员读取方式
声明完成后,生成的对象与普通类实例完全一致,可以使用位置参数、关键字参数进行初始化:
# 实例化
p = Point(10, 20, z=30)

# 方式一:属性访问(推荐,具备高度自解释性)
print(p.x)  # 输出: 10
print(p.z)  # 输出: 30

# 方式二:索引与切片访问(与普通元组完全兼容)
print(p[0])   # 输出: 10
print(p[1:])  # 输出: (20, 30)

# 方式三:多变量解包
coord_x, coord_y, coord_z = p
print(coord_x, coord_y) # 输出: 10 20class, def, import 等)重名。如果动态读取的数据源包含非法字段或重复字段,可以指定参数 rename=True,工厂函数会自动将冲突字段重命名为下划线加索引格式(如 _1, _2)。
三、不可变特性与内置专属辅助方法
namedtuple 实例是不可变序列。当试图修改实例的属性时(例如 p.x = 50),解释器会抛出 AttributeError: can't set attribute。正因其不可变,只要内部元素都是可哈希类型,namedtuple 实例本身就可以直接作为字典的键(Key)或加入集合(Set)。
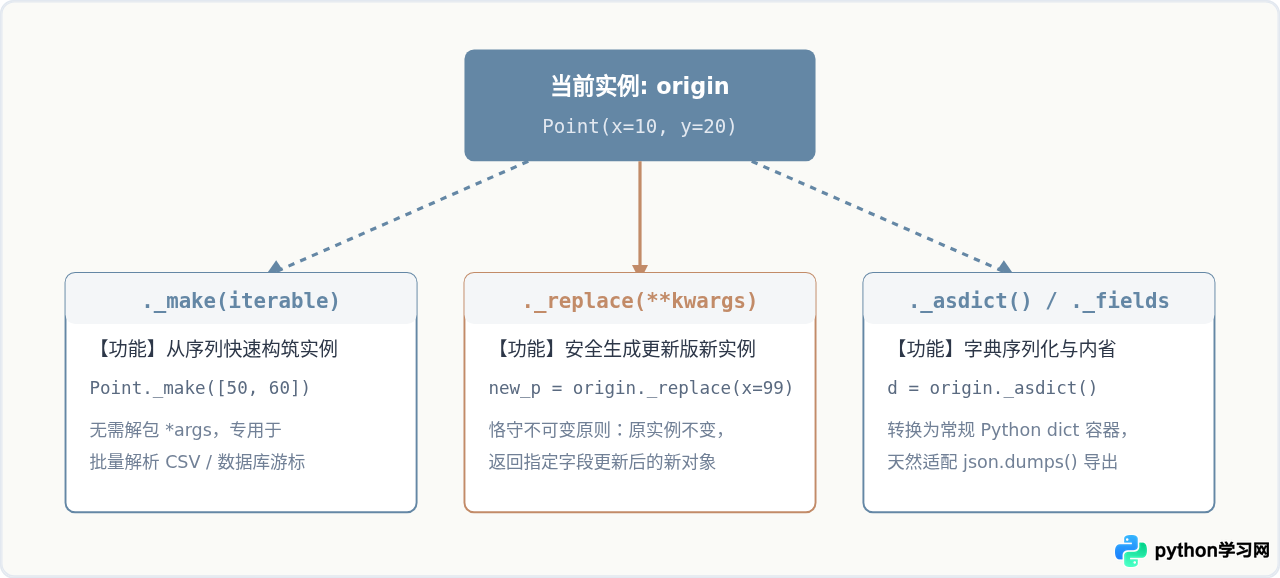
为了避免新增的方法与用户自定义的属性字段重名,namedtuple 提供的专属方法均以下划线 _ 开头。这并非表示私有方法,而是该工厂类的专用 API 规范。
1. _replace(**kwargs):构造新对象以模拟状态更新
由于元组内容不可更改,如果业务场景需要更新某一特定属性,不能原地赋值,而应当使用 _replace()。该方法会浅拷贝原对象,替换传入参数后生成一个新的具名元组实例:
Task = namedtuple('Task', 'id title status')
task1 = Task(1001, '编写文档', 'PENDING')

# 产生新实例,原 task1 内容不受影响
task2 = task1._replace(status='COMPLETED')

print(task1)  # 示例输出: Task(id=1001, title='编写文档', status='PENDING')
print(task2)  # 示例输出: Task(id=1001, title='编写文档', status='COMPLETED')
2. _asdict():无缝对接 JSON 与字典转换
在 Python 3.8+ 中,_asdict() 会直接将命名元组转为一个常规字典(在早期版本中为 OrderedDict)。这在需要将数据库实体或网络结果序列化输出时非常便捷:
import json

user_data = task2._asdict()
print(user_data)  # 示例输出: {'id': 1001, 'title': '编写文档', 'status': 'COMPLETED'}

# 直接参与序列化
json_str = json.dumps(user_data, ensure_ascii=False)
print(json_str)   # 示例输出: {"id": 1001, "title": "编写文档", "status": "COMPLETED"}
3. _make(iterable):批量数据装载
当从 CSV 文件、Excel 单元格或者数据库游标读取出一行行原始列表数据时,不需要编写繁复的解包循环,使用 _make() 可以直接从现有可迭代对象构造实例:
raw_records = [
    [101, '部署服务器', 'COMPLETED'],
    [102, '数据库备份', 'RUNNING']
]

# 统一装配为具名元组列表
tasks = [Task._make(row) for row in raw_records]
for t in tasks:
    print(f"任务 ID: {t.id}, 状态: {t.status}")
4. 默认值与字段内省(Python 3.7+ defaults 参数)
通过 defaults 参数可以为末尾字段赋予缺省值。defaults 必须是一个包含默认值的可迭代对象,其默认值从最右侧字段向前依次绑定:
# 为 status 设定默认值 'PENDING'
TaskWithDefault = namedtuple('TaskWithDefault', 'id title status', defaults=['PENDING'])

t_default = TaskWithDefault(103, '日常巡检')
print(t_default)  # 示例输出: TaskWithDefault(id=103, title='日常巡检', status='PENDING')

# 字段与默认值内省
print(TaskWithDefault._fields)          # 示例输出: ('id', 'title', 'status')
print(TaskWithDefault._field_defaults)  # 示例输出: {'status': 'PENDING'}
四、面向对象拓展:为 namedtuple 添加自定义方法
namedtuple 生成的本质上是一个标准的 Python 类,因此完全支持类继承。开发者可以通过子类继承的方式,为其补充计算属性(@property)或业务处理方法,使其具备更完善的对象封装特征,同时依然维持元组本身的不可变与内存优势:
import math
from collections import namedtuple

# 基础原型
BaseVector = namedtuple('BaseVector', 'x y')

# 通过继承添加方法
class Vector(BaseVector):
    __slots__ = ()  # 关键:避免生成实例字典 __dict__,保持轻量内存特性

    @property
    def magnitude(self):
        """计算向量模长"""
        return math.hypot(self.x, self.y)

    def dot(self, other):
        """向量点乘计算"""
        return self.x * other.x + self.y * other.y

v1 = Vector(3, 4)
v2 = Vector(1, 2)
print(v1.magnitude)  # 示例输出: 5.0
print(v1.dot(v2)) # 示例输出: 11 (3*1 + 4*2)__slots__ = () 的作用:
在子类化 namedtuple 时,若不主动声明 __slots__ = (),Python 会默认为子类实例创建 __dict__ 属性字典,从而丧失了元组省内存的优势。空 slots 声明能确保派生类保持纯粹的定长元组布局。
五、数据容器技术选型:namedtuple、dict 与 dataclass
Python 生态中提供了多种承载结构化数据的容器。为了在实际工程中做出恰当选型,需要从内存开销、数据可变性、访问性能及维护成本等多维度进行考量:
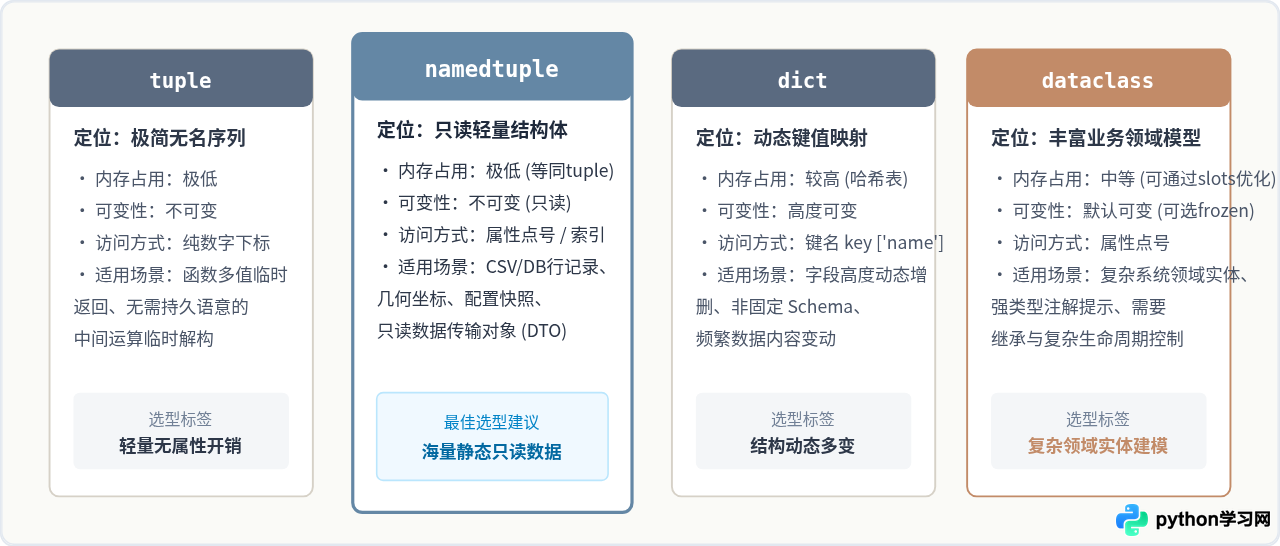
| 特性维度 | 传统元组 (tuple) | 命名元组 (namedtuple) | 字典 (dict) | 数据类 (dataclass) |
|---|---|---|---|---|
| 访问机制 | 纯数字索引 | 属性名点号 / 索引 | 字符串键名 | 属性名点号 |
| 默认可变性 | 不可变 | 不可变 | 可变 | 默认可变 (支持 frozen=True) |
| 内存消耗 | 极低 | 极低(与元组一致) | 较高(额外哈希表开销) | 中等(依赖 __dict__ 或 __slots__) |
| 类型提示 | 基础支持 | 需配合 typing.NamedTuple | 需配合 TypedDict | 原生声明式类型提示 |
| 核心优势场景 | 短生命周期临时打包 | 结构固定、静态只读的海量数据记录 | 结构动态变动、键值不固定的映射 | 包含校验、默认方法与行为的完整业务模型 |
六、工程实践中的常见问题与避坑指南
在生产工程中使用 namedtuple 时,有两个最容易引起歧义的细节需要特别留意:
1. 误区:试图直接修改字段属性
这是初学者最常犯的错误。必须牢记其基类是 tuple,任何试图就地赋值的操作都会引发崩溃:
Point = namedtuple('Point', 'x y')
p = Point(1, 2)

# 错误写法:抛出 AttributeError: can't set attribute
# p.x = 10

# 正确写法:使用 _replace 产出新对象
p = p._replace(x=10)
2. 拓展:使用 typing.NamedTuple 获得现代类型注解支持
如果项目全面启用了 Python 类型注解检查(如 mypy、Pyright),直接使用 collections.namedtuple 工厂函数可能无法在 IDE 中得到理想的代码自动补全。此时可以使用 Python 3.6 引入的 typing.NamedTuple。它基于类定义语法,底层实现机制与 collections.namedtuple 完全兼容:
from typing import NamedTuple

class ServerNode(NamedTuple):
    host: str
    port: int = 8080
    active: bool = True

node = ServerNode(host="192.168.1.100")
print(node.host)    # IDE 能够精确推导出 str 类型
print(node.port) # 示例输出默认值: 8080免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









