

Python高级编程技巧:装饰器、生成器与上下文管理器应用
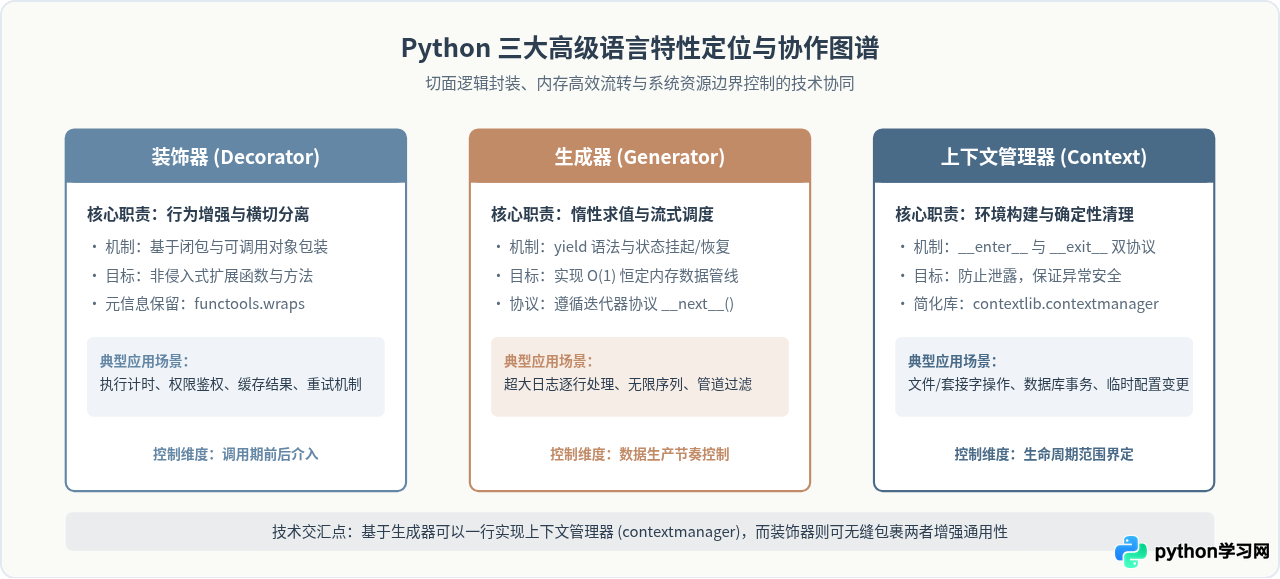
掌握 Python 的进阶开发能力,核心在于理解并灵活运用语言中三项最具代表性的抽象机制:装饰器(Decorator)、生成器(Generator)与上下文管理器(Context Manager)。这三者分别解决了业务逻辑与横切关注点的解耦、大数据流式计算的内存控制、以及系统资源的确定性安全释放。本文将直击核心概念与底层机理,通过可实际运行的代码案例,逐一拆解它们的应用模式与组合技巧,帮助你在日常工程中编写出兼具高可维护性与高性能的代码。
一、装饰器:切面逻辑的非侵入式封装
在编写业务代码时,诸如执行性能监控、请求鉴权、失败自动重试、日志记录等逻辑,往往会在多个函数中重复出现。如果直接将这些代码硬编码在函数体内部,不仅破坏了函数的单一职责原则,还会造成代码膨胀。Python 装饰器(Decorator)通过利用“函数是一等公民”和闭包机制,允许我们在不修改原函数定义的前提下,动态包装目标函数,实现横切关注点的解耦。
1. 装饰器的本质与调用生命周期
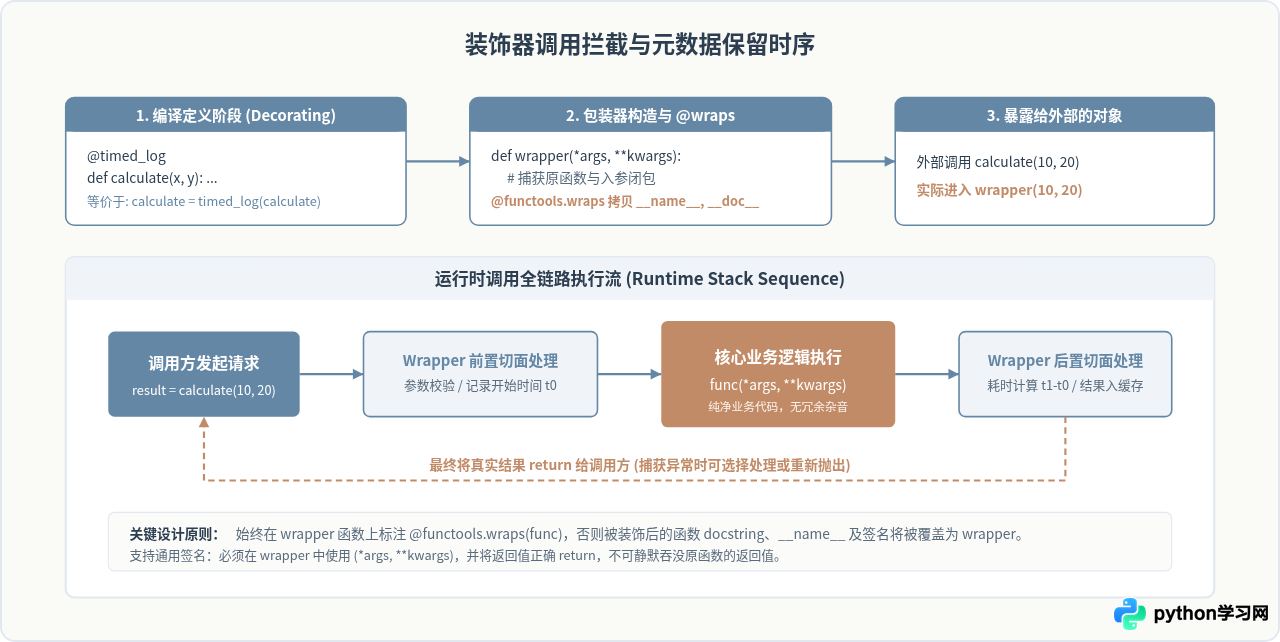
从语法上看,@decorator 只是语法糖。假设有一个装饰器函数 my_decorator 和目标函数 func,当解释器读取到如下结构时:
@my_decorator
def func():
pass其等价底层执行过程即为:func = my_decorator(func)。装饰器接收原函数对象作为参数,内部定义一个包装函数 wrapper,在执行原函数之前或之后注入自定义逻辑,最终返回这个 wrapper 对象供外部调用。
2. 实战编写:带参数的高通用性重试装饰器
在实际生产环境中,网络 I/O、数据库连接或外部 API 请求经常出现临时网络抖动。以下演示一个支持传入重试次数与间隔时间的装饰器完整实现:
import time
import functools
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def retry(max_attempts=3, delay_seconds=1.0, exceptions=(Exception,)):
    """
    通用重试装饰器(三层嵌套结构以支持参数配置)
    :param max_attempts: 最大尝试次数
    :param delay_seconds: 失败后重试间隔(秒)
    :param exceptions: 需要捕获并重试的异常元组
    """
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            attempts = 0
            while attempts < max_attempts:
                try:
                    return func(*args, **kwargs)
                except exceptions as e:
                    attempts += 1
                    logging.warning(
                        f"调用 {func.__name__} 失败 [第 {attempts}/{max_attempts} 次]: {e}"
                    )
                    if attempts >= max_attempts:
                        logging.error(f"达到最大重试次数 {max_attempts},抛出异常。")
                        raise
                    time.sleep(delay_seconds)
        return wrapper
    return decorator

# 模拟不可靠的远程接口
fail_counter = 0

@retry(max_attempts=3, delay_seconds=0.5, exceptions=(ConnectionError, TimeoutError))
def fetch_remote_metrics(server_id: str):
    """拉取服务器监控指标"""
    global fail_counter
    fail_counter += 1
    if fail_counter < 3:
        raise ConnectionError(f"节点 {server_id} 拒绝连接 (模拟故障)")
    return {"server": server_id, "cpu": "18%", "status": "UP"}

if __name__ == "__main__":
    result = fetch_remote_metrics("node-app-01")
    print(f"成功获取数据: {result}")
    print(f"函数元数据验证 -> 名称: {fetch_remote_metrics.__name__}")
当装饰器需要接收参数(如 max_attempts)时,需要构建三层结构:最外层接收装饰器参数并返回真正的装饰器;中层接收目标函数对象;最内层返回具体的包装调用。通过 @functools.wraps(func),即使被装饰,fetch_remote_metrics.__name__ 依然正确返回原函数名。
二、生成器:以恒定内存处理海量数据流
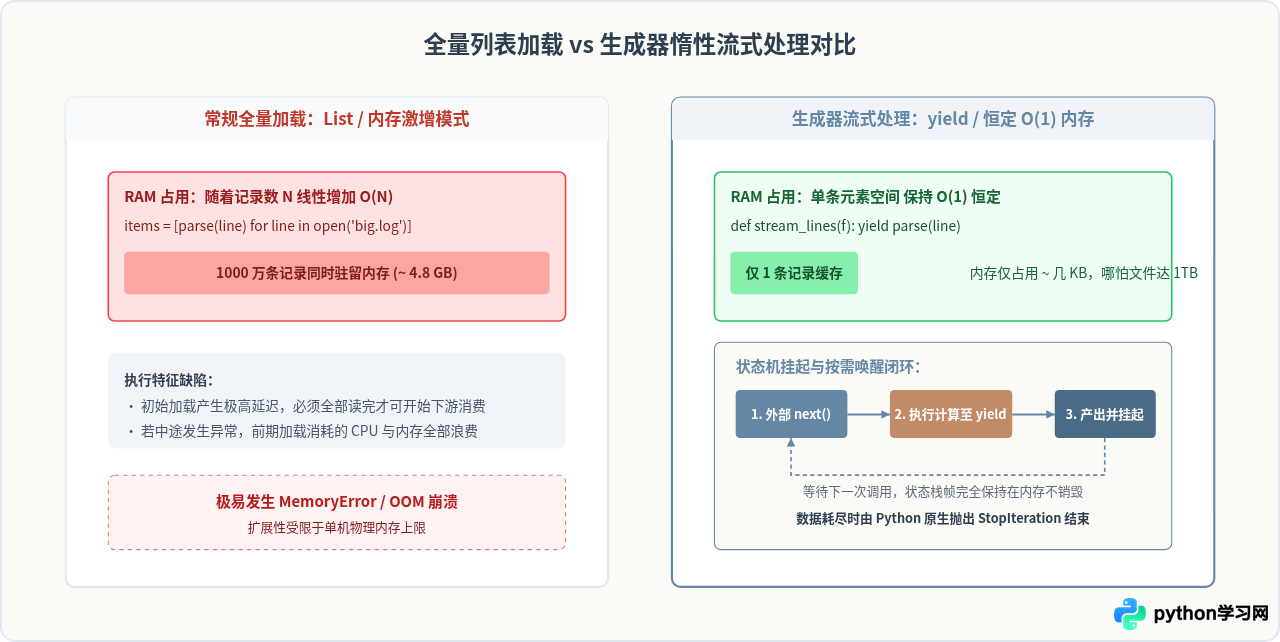
常规 Python 函数通过 return 一次性将全部计算结果返回。当面对百万行级别的日志文件、海量数据库游标或无限数据流时,一次性构造列表加载到内存会导致堆内存急剧飙升,甚至触发操作系统的 OOM(Out Of Memory)崩溃。生成器(Generator)通过 yield 关键字将函数转变为可挂起和恢复的状态机,实现惰性求值(Lazy Evaluation)。
1. 生成器管道模式(Pipeline Architecture)
在 Linux 命令行中,我们可以使用管道符 cat access.log | grep "ERROR" | awk '{print $4}' 将命令组合起来,每个命令按行处理数据。在 Python 中,通过将多个生成器串联,同样可以构建优雅、解耦且内存恒定的处理管道。
import io

# 模拟 10 万行日志数据输入流
mock_log_data = """
2026-10-26 01:00:01 INFO [auth] User login successful: user_id=101
2026-10-26 01:00:02 ERROR [payment] Gateway timeout: order_id=2026001 latency=3500ms
2026-10-26 01:00:05 INFO [api] Request processed: /v1/items latency=45ms
2026-10-26 01:00:08 ERROR [database] Connection deadlocked: trx_id=9872 latency=5200ms
2026-10-26 01:00:10 WARN [storage] Disk usage threshold > 85%
2026-10-26 01:00:12 ERROR [payment] Insufficient funds: order_id=2026002 latency=120ms
"""

def read_log_stream(stream):
    """阶段一:按行生成原始日志行(零内存缓冲)"""
    for line in stream:
        clean = line.strip()
        if clean:
            yield clean

def filter_by_level(lines, target_level="ERROR"):
    """阶段二:过滤指定日志级别"""
    for line in lines:
        if f" {target_level} " in line:
            yield line

def extract_error_metrics(lines):
    """阶段三:结构化解析错误行关键指标"""
    for line in lines:
        parts = line.split()
        timestamp = f"{parts[0]} {parts[1]}"
        module = parts[3].strip("[]")
        message = " ".join(parts[4:])
        yield {
            "timestamp": timestamp,
            "module": module,
            "detail": message
        }

# 组合管道:数据流按需驱动,各环节完全解耦
stream_source = io.StringIO(mock_log_data.strip())
raw_lines = read_log_stream(stream_source)
error_lines = filter_by_level(raw_lines, target_level="ERROR")
parsed_records = extract_error_metrics(error_lines)

# 终端消费环节
for record in parsed_records:
    print(f"告警捕获 -> 模块: {record['module']} | 详情: {record['detail']}")
在上述管道中,只有当终端的 for record in parsed_records 执行 next() 请求时,数据才会反向从最上游的 read_log_stream 中“拉取”一条。整套管道在处理几十 GB 的超大日志文件时,内存占用依然不超过数兆字节。
三、上下文管理器:资源与环境的确定性管控
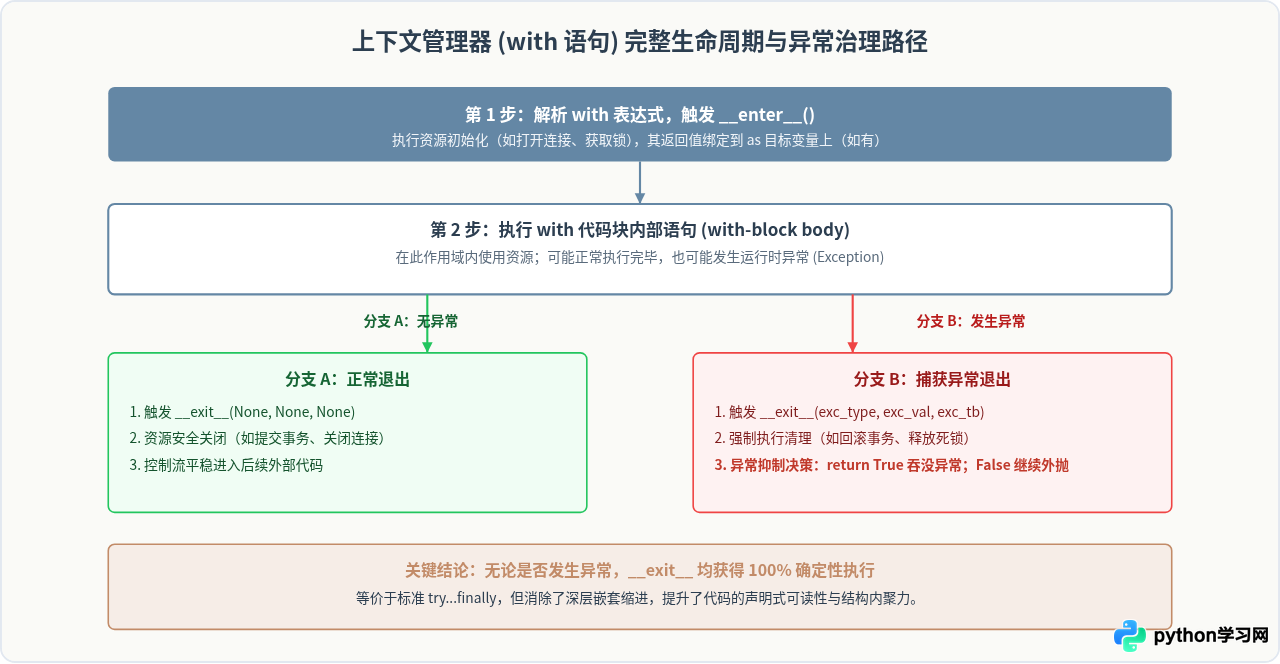
在编写操作系统文件、网络 Socket、多线程互斥锁或数据库事务等代码时,系统资源的“申请”与“释放”必须严格配对成对执行。如果依赖手动编写 close(),一旦中间发生异常、提前 return 或代码分支遗漏,就会造成文件句柄泄露、连接池耗尽或死锁。上下文管理器(Context Manager)通过 with 语句提供了语言级别的作用域保障。
1. 基于类实现上下文管理器:安全数据库事务模拟
要让一个类支持 with 语句,只需在类内部实现 __enter__ 和 __exit__ 两个特殊方法:
class DatabaseTransaction:
    def __init__(self, conn_name: str):
        self.conn_name = conn_name
        self.active = False

    def __enter__(self):
        self.active = True
        print(f"[{self.conn_name}] 开启数据库事务 BEGIN TRANSACTION")
        return self

    def query(self, sql: str):
        if not self.active:
            raise RuntimeError("当前事务未激活,禁止执行 SQL")
        print(f"[{self.conn_name}] 执行 SQL: {sql}")

    def __exit__(self, exc_type, exc_val, exc_tb):
        if exc_type is not None:
            # 捕获到了代码块中抛出的异常
            print(f"[{self.conn_name}] 检测到未处理异常 ({exc_val}) -> 立即执行 ROLLBACK 回滚!")
            self.active = False
            # 返回 False 让异常向外传播;若返回 True 则会吞没此异常
            return False
        else:
            print(f"[{self.conn_name}] 代码块正常执行完毕 -> 立即执行 COMMIT 提交事务!")
            self.active = False
            return True

# 场景 1:正常操作,安全提交
print("=== 场景 1:正常业务流程 ===")
with DatabaseTransaction("Master-DB") as tx:
    tx.query("UPDATE accounts SET balance = balance - 100 WHERE id = 1")
    tx.query("UPDATE accounts SET balance = balance + 100 WHERE id = 2")

# 场景 2:中途出现异常,自动触发回滚
print("\n=== 场景 2:触发异常自动回滚 ===")
try:
    with DatabaseTransaction("Master-DB") as tx:
        tx.query("INSERT INTO orders (id, amount) VALUES (9001, 199.9)")
        # 模拟中间步骤失败
        raise ValueError("库存不足,订单创建受阻")
        tx.query("UPDATE inventory SET stock = stock - 1")
except ValueError as e:
    print(f"外层成功捕获业务异常: {e}")
2. 进阶捷径:利用 contextlib.contextmanager 将生成器转化为上下文管理器
如果每次创建上下文管理器都要手写一个包含 __enter__ 和 __exit__ 的类,显得略微繁琐。标准库 contextlib.contextmanager 装饰器允许我们将一个带有单一 yield 的生成器函数直接转变为上下文管理器,yield 之前为 __enter__ 逻辑,yield 之后置于 finally 块中作为 __exit__ 逻辑:
import time
from contextlib import contextmanager

@contextmanager
def execution_timer(task_name: str):
    """测量任意代码块运行耗时的上下文管理器"""
    start_time = time.perf_counter()
    print(f"[Timer] 开始执行任务: '{task_name}'...")
    try:
        # yield 将控制权交由 with 代码块,其值可通过 as 捕获
        yield task_name
    finally:
        # 无论代码块中正常结束还是异常跳出,finally 必定执行
        duration = (time.perf_counter() - start_time) * 1000
        print(f"[Timer] 任务 '{task_name}' 结束,总耗时: {duration:.2f} ms")

# 使用方式
with execution_timer("快速矩阵乘法模拟"):
    total = sum(i * i for i in range(1_000_000))
四、三项技巧的高阶综合应用:打造安全高效的流式数据处理器
在高质量的开源项目和中大型企业项目中,优秀的代码往往是将装饰器、生成器与上下文管理器无缝协同的产物。下面我们构建一个现实业务场景:开发一个“受控批量数据管道”。我们希望:
- 使用生成器对输入数据流进行分批切片(Chunking),确保低内存占用;
- 使用上下文管理器对批处理临时状态与外部连接进行作用域生命周期管理;
- 使用装饰器为整个数据处理流水线添加自动化审计日志与耗时追踪。
import functools
import time
from contextlib import contextmanager

# 1. 装饰器:流水线执行追踪
def audit_pipeline(pipeline_name: str):
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            print(f"\n================ [AUDIT] 启动流水线: {pipeline_name} ================")
            t0 = time.perf_counter()
            try:
                result = func(*args, **kwargs)
                return result
            finally:
                cost = (time.perf_counter() - t0) * 1000
                print(f"================ [AUDIT] 完成流水线: {pipeline_name} (耗时: {cost:.2f}ms) ================\n")
        return wrapper
    return decorator

# 2. 生成器:将任意流式迭代器切片为指定大小的 Batch(惰性切分)
def stream_batches(data_stream, batch_size=3):
    batch = []
    for item in data_stream:
        batch.append(item)
        if len(batch) >= batch_size:
            yield batch
            batch = []
    if batch:
        yield batch

# 3. 上下文管理器:批次执行环境与异常屏障
@contextmanager
def batch_scope(batch_id: int):
    print(f"[Batch-{batch_id}] --- 批次环境准备中 (分配缓冲区) ---")
    status = {"processed": 0}
    try:
        yield status
        print(f"[Batch-{batch_id}] --- 批次处理顺利完成,写入存储 (共 {status['processed']} 条) ---")
    except Exception as exc:
        print(f"[Batch-{batch_id}] !!! 批次处理异常,触发单批次局部回滚: {exc} !!!")
        raise
    finally:
        print(f"[Batch-{batch_id}] --- 批次环境销毁释放 ---")

# 4. 组合业务执行函数
@audit_pipeline("电商用户活跃积分批量结算")
def process_user_points():
    # 模拟数据源(可以是无限生成器或超大文件)
    raw_user_ids = (f"UID_{1000 + i}" for i in range(8))

    batch_index = 1
    for chunk in stream_batches(raw_user_ids, batch_size=3):
        with batch_scope(batch_index) as scope:
            for uid in chunk:
                # 模拟处理逻辑
                print(f"  - 正在为用户 {uid} 计算当月积分...")
                scope["processed"] += 1
        batch_index += 1

if __name__ == "__main__":
    process_user_points()
五、综合对比与常见易错点总结
为了在实际开发中更加精准地选型,下表对装饰器、生成器与上下文管理器的核心特性进行了全景横向对比:
| 特性维度 | 装饰器 (Decorator) | 生成器 (Generator) | 上下文管理器 (Context Manager) |
|---|---|---|---|
| 核心解决问题 | 逻辑横切、关注点解耦、非侵入式扩展 | 海量数据流式处理、惰性求值、极低内存 | 系统资源确定性释放、异常边界清理 |
| 关键语法标记 | @decorator_func / @functools.wraps |
yield / yield from / 生成器表达式 |
with ... as ... / __enter__, __exit__ |
| 内部控制机理 | 高阶函数闭包,拦截函数调用入口与出口 | 协程状态机,按需挂起与恢复栈帧 | 协议方法封装,无论成功失败均触发 __exit__ |
| 典型工程反模式 | 忘记 @wraps 导致函数名与文档丢失;遗漏 return |
对已被迭代耗尽的生成器重复读取;滥用 list() 强转 |
在 __exit__ 中盲目返回 True 掩盖深层致命 Bug |
- 生成器单次消费特性:生成器对象是一次性的(One-time consumable)。一旦迭代完成触发了
StopIteration,它将永远处于耗尽状态。如果需要多次重复遍历,必须重新调用生成器函数创建新实例,切忌在多个并发下游间共享无锁的生成器指针。 - 装饰器签名保持:编写通用装饰器时,内部
wrapper必须始终接受*args, **kwargs,并且必须return func(*args, **kwargs),避免原函数返回值丢失。同时严格标注@functools.wraps(func)保障反射与调试可用性。 - 上下文管理器的异常吞没:在
__exit__方法中,只有在确认当前异常已被完全且安全地恢复时才return True;绝大多数通用资源清理场景中应返回False(或不显式返回),允许未预期的错误正常向调用栈外层传播。
综上所述,装饰器、生成器与上下文管理器是 Python 从基础脚本语言迈向企业级工业代码的核心基石。深入理解它们的运行原理并在架构设计中恰当运用,能够从根本上提升软件系统的健壮性、可读性与运行性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









