


在 Ubuntu 下处理文件,很多问题并不是“会不会读写文件”,而是代码在异常、跨目录、批量处理和大文件场景里能不能稳定运行。下面按常见任务拆开讲,从安全打开文件、路径管理到性能优化和高级文件操作,帮你判断每种写法适合放在什么场景里。
先把文件打开这一步写稳:优先使用 with
文件操作里最容易被忽略、但收益最高的习惯,就是用 with 打开文件。它的好处很直接:代码块执行完后会自动关闭文件,就算中途抛出异常,也不用担心句柄没释放。
读取文件时,最常见的写法就是下面这样:
with open('file.txt', 'r') as f:
    content = f.read()
相比手动调用 f.close(),这种写法更简洁,也更适合放进函数、脚本和批处理流程中。对于 Ubuntu 上常见的日志读取、配置文件加载、小型文本处理任务,with 基本可以视为默认选项。
文件异常怎么兜底:不要让读写操作直接崩溃
文件不存在、权限不足、目录不可写,这些都属于文件操作中的高频问题。尤其是在 Ubuntu 环境下处理系统目录、挂载盘或共享目录时,这类异常并不少见。
比较稳妥的方式,是用 try-except 把文件操作包起来,再按异常类型分别处理:
try:
    with open('file.txt', 'r') as f:
        content = f.read()
except FileNotFoundError:
    print("文件未找到")
except PermissionError:
    print("没有权限读取文件")
这样做的价值,不只是“防报错”,而是让程序在不同失败场景下走向不同分支。比如:
- 文件不存在时自动创建默认文件;
- 权限不足时给出清晰提示;
- 批处理任务失败时记录日志,继续处理下一项。
如果脚本要跑在生产环境、定时任务或运维流程里,异常处理通常不是可选项,而是基础配置。
路径处理该选 os 还是 pathlib
os:适合兼容旧代码和直接操作系统接口
os 模块一直是 Python 里处理路径和系统交互的基础工具。它的优势在于成熟、稳定,而且很多老项目本来就是围绕 os.path 写的。
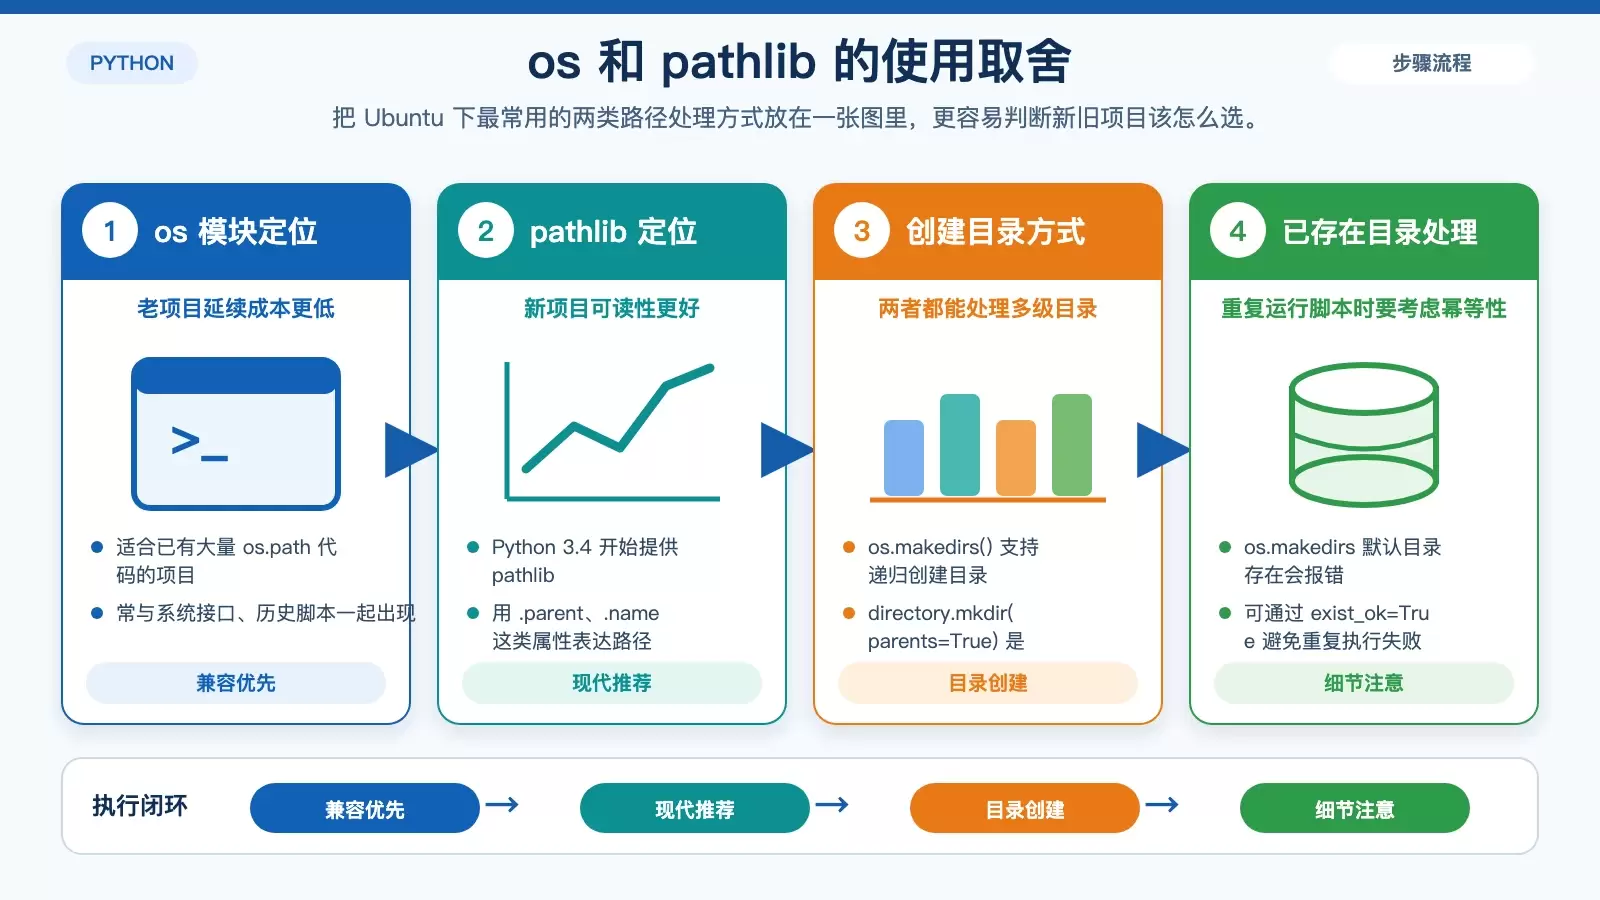
比如跨平台拼接路径、提取目录、递归创建目录,可以这样写:
import os
file_path = os.path.join('/home/user', 'documents', 'file.txt')
directory = os.path.dirname(file_path)
if not os.path.exists(directory):
    os.makedirs(directory)
这里有两个实用点:
os.path.join()会自动处理不同系统的路径分隔符,Linux 用/,Windows 用\;os.makedirs()可以递归创建上层目录,适合导出文件、生成缓存目录等场景。
需要注意的是,os.makedirs 默认在目录已存在时会报错。如果你希望重复执行脚本也不出错,可以加上 exist_ok=True。
pathlib:更现代,也更适合新项目
pathlib 从 Python 3.4 开始提供,它把路径当作对象来处理,代码可读性通常比 os.path 更好。对于没有历史负担的新项目,优先使用它会更顺手。
from pathlib import Path
file_path = Path('/home/user/documents/file.txt')
directory = file_path.parent
if not directory.exists():
    directory.mkdir(parents=True)
它的优势主要体现在两点:
- 路径结构更直观,比如
.parent、.name这样的属性读起来更接近自然语言; - 链式调用更统一,适合持续扩展的业务代码。
如果你现在要在 Ubuntu 上新写一个文件处理脚本,通常可以把判断标准简单理解为:兼容老项目用 os,从头开始的新代码优先用 pathlib。
大文件怎么读更稳:逐行处理避免 OOM
处理几 GB 的日志、导出文件或数据快照时,最该避免的就是直接用 read() 一次性读入内存。这样写在小文件里没问题,放到大文件场景就很容易触发 OOM(内存溢出)。
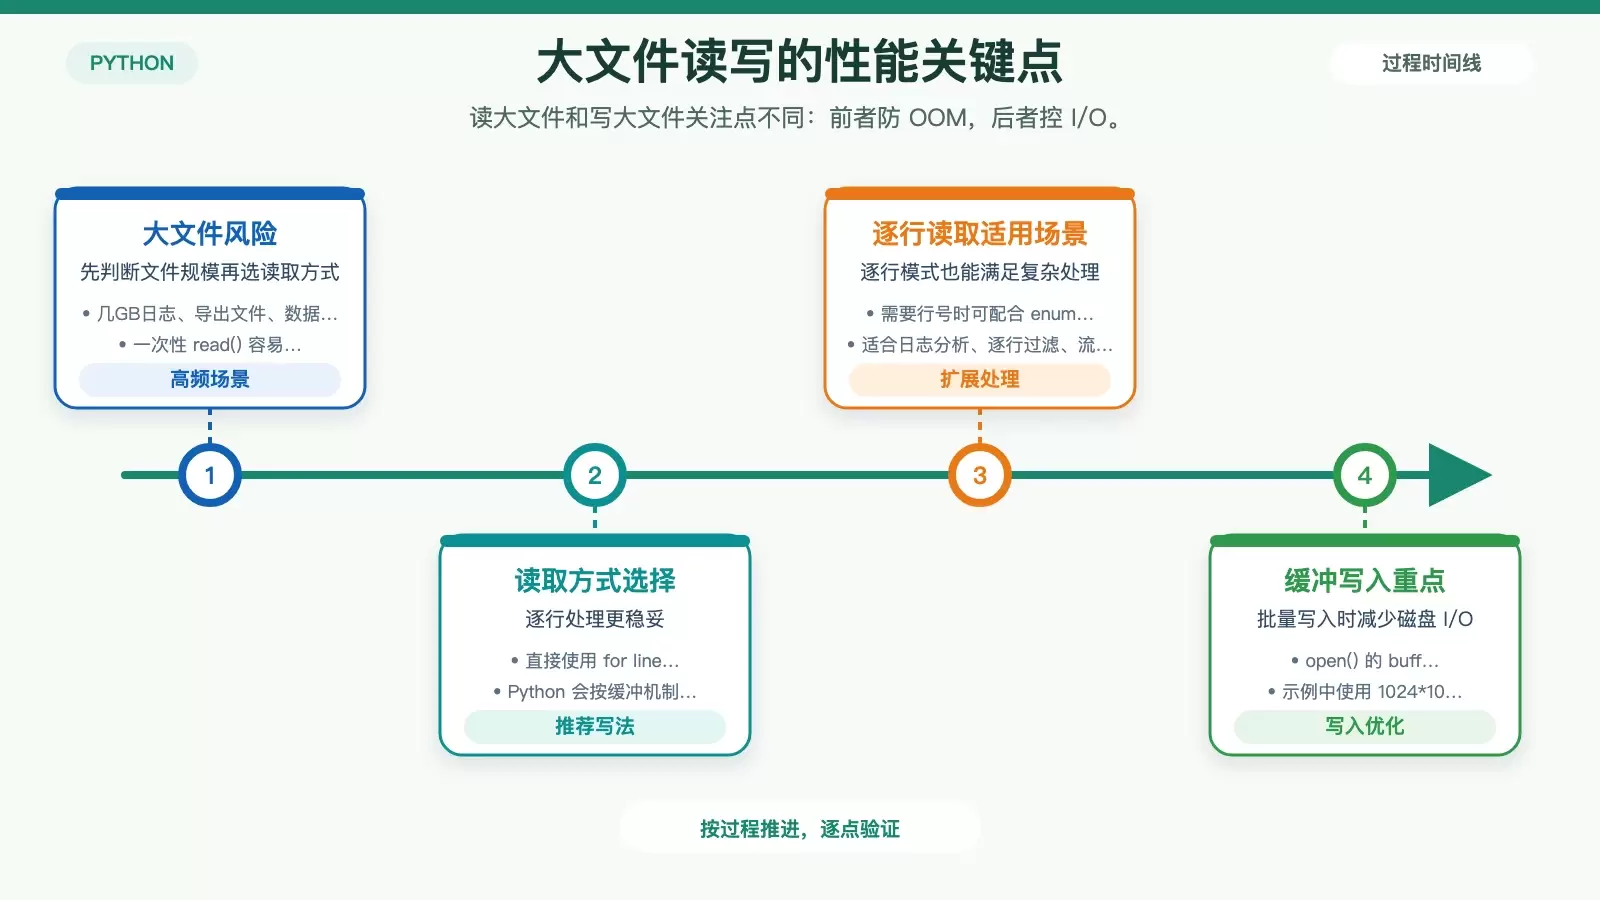
更稳妥的方式,是直接迭代文件对象:
with open('large_file.txt', 'r') as f:
    for line in f:
        # 处理每一行数据
        pass
这种写法的好处是,Python 会按缓冲机制逐步读取内容,内存占用更可控。对于日志分析、逐行过滤、流式清洗这类任务,这是最常见也最实用的模式。
如果你还需要知道当前处理到第几行,可以进一步配合 enumerate 使用。
写大量数据时,别忽略 buffering 参数
读取文件强调内存友好,写入文件则更需要关注磁盘 I/O 次数。大量小块写入会频繁触发落盘,速度往往会明显下降。
在这种场景里,可以通过 open() 的 buffering 参数设置缓冲区大小。例如下面这段代码把缓冲区设为 1MB:
with open('output.txt', 'w', buffering=1024*1024) as f:
    for data in generate_data():
        f.write(data)
这意味着数据不会每写一次就立刻进入磁盘,而是等缓冲区满了,或者文件关闭时再统一写入。对日志写入、批量导出、长时间运行的数据生成任务来说,这通常能带来更好的写入效率。
这里的关键点不是一味把缓冲区设得越大越好,而是根据写入规模和任务特征选择合适的值。文中的 1024*1024 也就是 1MB,是一个比较直观的示例。
复制、移动、删除目录时,用 shutil 更省事
当需求从“打开一个文件”变成“复制一批文件”“移动目录”“清理整个输出目录”时,shutil 往往比手动拼 os 调用更顺手。
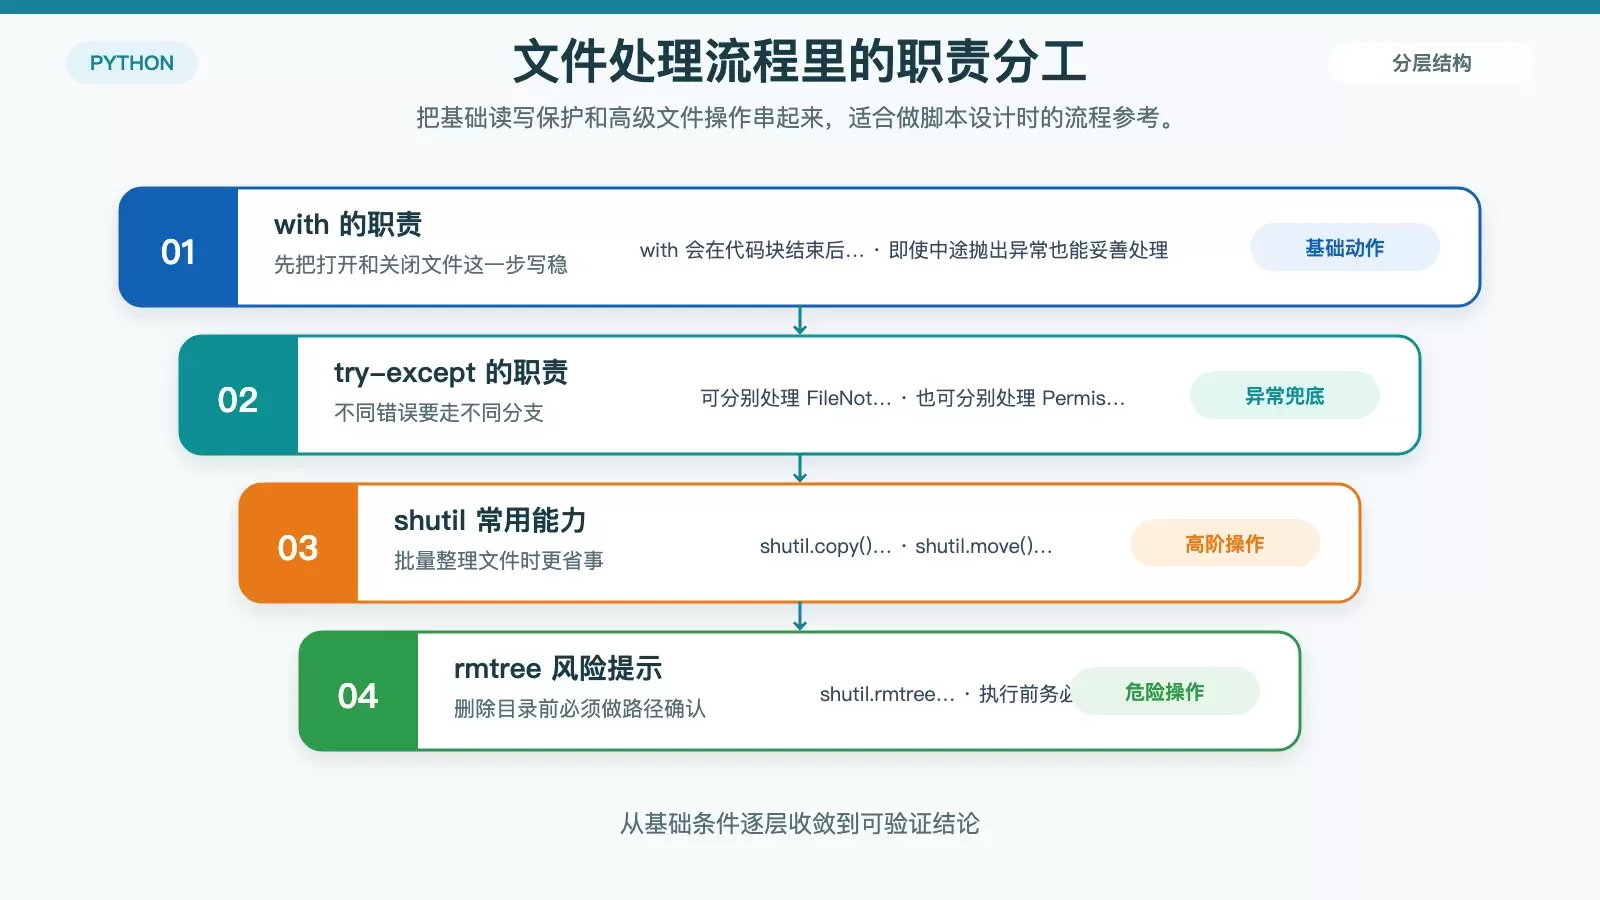
几个最常见的操作如下:
import shutil
# 复制文件
shutil.copy('source.txt', 'destination.txt')
# 移动文件(重命名)
shutil.move('source.txt', 'destination.txt')
# 删除整个目录及其内容
shutil.rmtree('directory_name')
shutil 的价值在于,它已经帮你处理了很多底层细节,比如跨文件系统复制、常见文件元信息处理等。对于备份、归档、批量整理文件这类任务,通常比自己写一堆目录遍历更高效。
不过要特别留意 shutil.rmtree:它会直接删除整个目录及其内容,而且不可恢复。涉及清理目录时,最好先确认路径是否正确,必要时先做白名单校验或打印确认信息。
Ubuntu 下实战怎么组合这些技巧
把这些方法放到一起看,思路其实很清楚:
- 用
with管理文件生命周期,减少资源泄露风险; - 用
try-except处理文件不存在、权限不足等异常; - 路径处理上,老项目沿用
os,新项目优先pathlib; - 大文件读取时坚持逐行处理,避免 OOM;
- 批量写入时合理设置
buffering,降低磁盘 I/O 压力; - 复制、移动、删除目录时交给
shutil完成。
如果你在 Ubuntu 上写的是实际要长期运行的脚本,通常可以把这些技巧组合起来使用。比如用 pathlib 构建路径,用 with 和 try-except 保证读写稳定,再用 shutil 做收尾整理,这样代码的可维护性和健壮性会比“能跑就行”的写法高出不少。









