

Python批量数据输出为冒号分隔格式:print sep与join怎么选
在Python中将批量数据格式化为冒号分隔输出时,print(*items, sep=':') 与 ':'.join(...) 各有明确的适用边界。本文深入解析两者的底层执行机制、类型转换成本、内存占用与性能表现,并提供清晰的场景选型指导。
在日常的配置导出、网络数据包构造、日志格式化以及时间戳序列生成中,冒号(:)是一种极其高频的分隔符。比如组装 MAC 地址 00:1A:2B:3C:4D:5E、输出路由拓扑 node1:node2:node3,或是输出分秒统计 12:30:45。在 Python 中实现这一格式时,开发者往往在两种主流写法之间徘徊:一种是利用内置函数的打印参数 print(*items, sep=':'),另一种则是经典的字符串拼接方法 ':'.join(...)。虽然它们都能把一组数据拼出相同外观的文本,但内部的内存流转、类型要求和执行寿命却截然不同。核心结论很明确:如果目标只是向终端、日志或现成文件流直接喷射输出,且项数在受控范围内,print sep 写法最少、无需手动转换非字符串类型;但只要结果需要赋值给变量供后续处理、需要通过网络返回,或者数据量达到万级以上,str.join 是无可替代的标准解法。
两类典型写法的代码形态与差异切入点
为了直观观察两者的分歧,我们先看一个简单的批处理需求:把一组端口号或数值列表格式化输出为冒号串。
# 原始输入数据(整型数字列表)
ports = [80, 443, 8080, 8443, 9000]

# 方案 A:使用 print 的 sep 参数配合解包
print(*ports, sep=":")
# 控制台输出:80:443:8080:8443:9000

# 方案 B:使用字符串类的 join 方法
output_str = ":".join(str(p) for p in ports)
print(output_str)
# 控制台输出:80:443:8080:8443:9000
从终端结果来看,二者完全一致。然而,方案 A 没有产生任何可以在后续代码中被调用的字符串变量,它在执行完毕后即刻归于标准输出流;同时,方案 A 原生接纳了整型数据,而方案 B 则要求我们必须通过推导式或 map 将整型转成 str。这一表象背后,隐藏着 Python 解释器在参数解包、I/O 缓冲区与连续内存分配上的本质区别。
解剖 print(*data, sep=":"):简便背后的机制与瓶颈
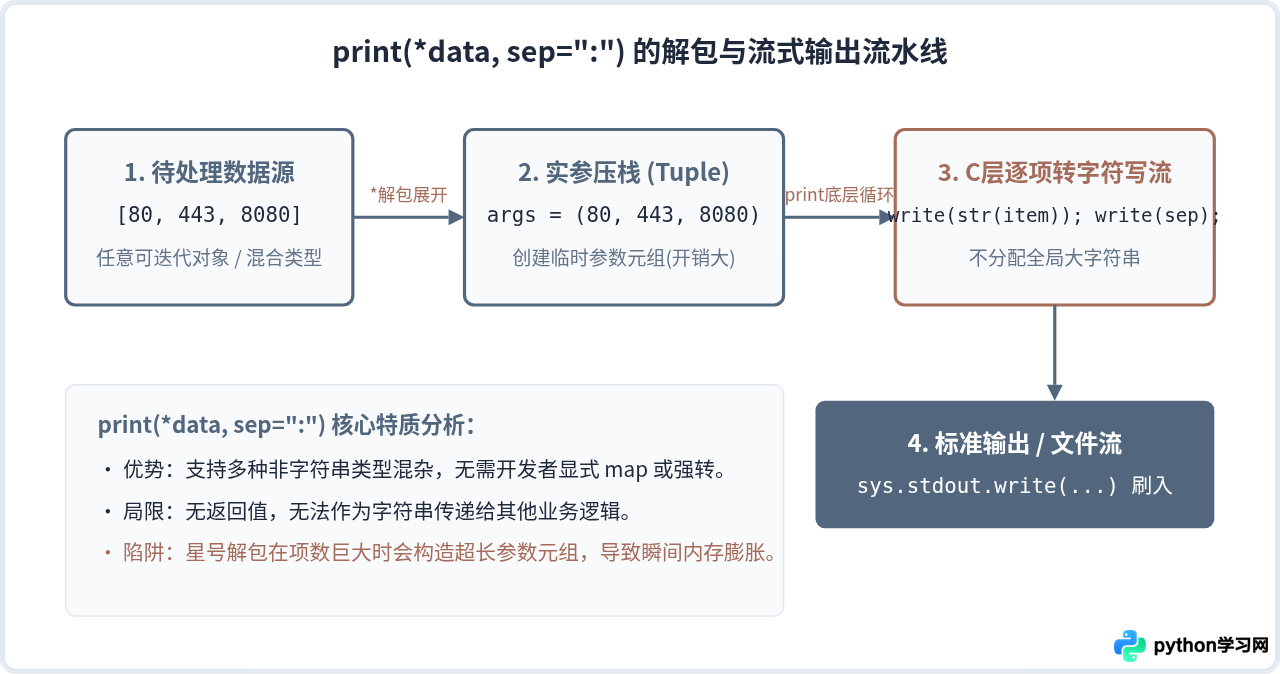
print 函数之所以能够输出冒号分隔格式,得益于它的 sep 关键字参数。默认情况下 sep=' '(空格),当我们将其设定为 sep=':' 时,Python 会在每一个传入的实参之间插入冒号。
但这里有一个关键前提:print 是一个接受变长参数 *objects 的函数。我们如果直接传入一个列表 print(ports, sep=":"),解释器只会认为我们传入了一个参数(即这个列表对象本身),此时 sep 根本不会生效,输出的仅仅是列表的字符串表达形式 [80, 443, 8080]。因此,我们必须在列表前加上星号(*ports)进行参数解包(Argument Unpacking)。
参数解包在此处带来了便利,但也埋下了性能与架构隐患:
- 内存膨胀与实参截断限制:当
ports包含几十万或上百万个元素时,*ports会在函数调用前瞬间将整个生成器或列表膨胀为一个巨大的函数实参元组(args tuple)。在某些栈深或内存受限的环境中,这种解包操作会带来巨大的短暂内存峰值。 - 无返回值(NoneType):
print的返回值永远是None。这意味着如果你要把拼接结果写入数据库、存入 Redis 或作为 HTTP 响应返回,print是无法完成任务的。即使使用file=io.StringIO()重定向输出流,代码复杂度也会迅速超过str.join。 - 类型兼容极度友好:它最大的闪光点在于内置调用 C 层的对象转换逻辑。哪怕列表中混杂着整数、浮点数、UUID 对象甚至是自定义类,
print(*items, sep=":")都能直接工作,不需要任何显式类型预处理。
解剖 str.join:底层内存连续分配的高性能基石
与 print 的流式消费不同,str.join 是 Python 字符串类的核心原生方法。其设计初衷就是在内存中构造一个全新的、连续的不可变字符串对象。
在 CPython 的底层实现中,str.join 的执行效率极高。它并不是简单的 str += item 循环,而是采用了两趟扫描(Two-pass)优化算法:
- 第一趟扫描(计算总字节数):CPython 会快速遍历传入的序列,获取所有子字符串的长度,并加上
(N - 1) * len(sep)的分隔符长度,精确算出最终字符串所需的总字节数。 - 单次分配连续缓冲区:通过一次系统内存调用,向操作系统申请一块精确大小的连续内存空间。
- 第二趟扫描(内存直接拷贝):利用高效的底层 C 函数(如
memcpy),依次将子字符串和分隔符的数据搬运至这块新内存中,最后封包为 Python 字符串对象返回。
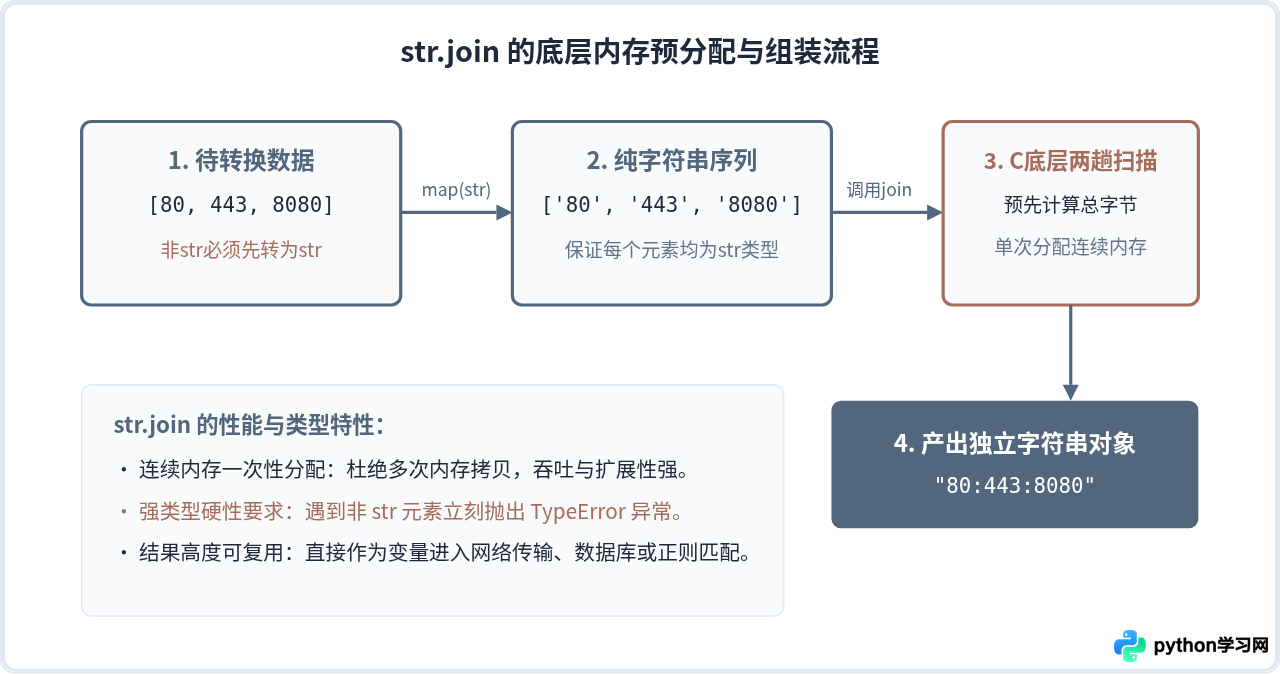
这种机制决定了:在生成最终字符串时,str.join 的效率在所有 Python 拼接手段中是绝对的第一梯队。然而,它也有一个刚性限制:所有被 join 的元素必须是 str 实例。如果列表里哪怕混入一个数字、None 或布尔值,执行时都会毫不留情地报错:
# 典型报错示例
>>> ":".join([1, 2, 3])
TypeError: sequence item 0: expected str instance, int found
这也正是很多初学者觉得 join 不如 print sep 爽快的原因——他们必须显式写出 ":".join(map(str, data)) 或 ":".join([str(x) for x in data])。
进阶小细节:列表推导式还是生成器表达式? 在使用 join 处理批量非字符串数据时,写法 ":".join([str(x) for x in data])(方括号列表推导)通常比 ":".join(str(x) for x in data)(圆括号生成器)更快。原因在于列表推导式会预先具象化列表,让 join 在第一趟扫描时直接获取 len(list),从而一次性算准内存;生成器则无法预知长度,C 层会触发渐进式扩容与多次数据搬运。
决策依据:四个维度的全面抉择
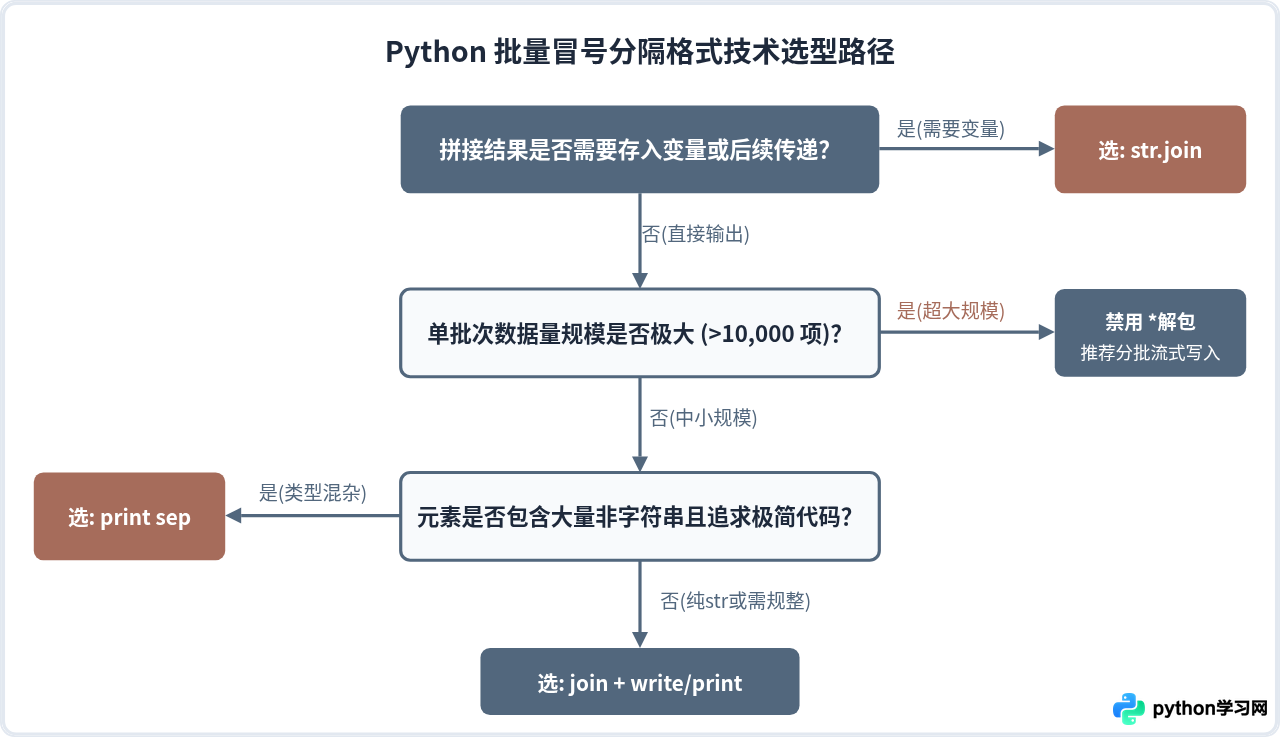
明确了两者的底层逻辑后,在具体业务场景中该如何做出确定性的技术选型?我们可以从以下四个维度进行判断:
1. 目标产物:是瞬时显示还是持久变量?
如果你编写的是一个一次性执行的自动化脚本、Shell 包装脚本或者调试打印代码,终端看到这一串内容后任务即告结束,print(*items, sep=":") 是极佳的选择。它代码量最少,语义直观。但凡只要这个冒号串需要被当成返回值(比如构建一个 Redis Key user:session:1001)、写入结构化 JSON、发送至下游 Kafka 队列,str.join 是唯一选择。
2. 数据类型构成:是否为纯字符串?
如果原始列表本身就是字符串序列(如 ["usr", "local", "bin"] 或读取自文本的 IP 字段),join 的优势全面压倒 print sep,因为无需额外的类型强转步骤;如果原始数据是数字、时间对象或混合实体,且仅仅需要立刻打出日志,print sep 能省去繁琐的包装层。
3. 数据规模:十项、万项还是千万项?
在几十到上百个元素的日常规模下,两者的执行耗时差异均在微秒级,肉眼不可见。然而,一旦数据规模达到数万级别,*items 参数解包就会遭遇性能滑铁卢甚至内存尖刺;而到了千万级别的极端批量输出时,两者都不应该直接整块调用,而应该采用流式迭代写入(后文详述)。但在通常的万级处理中,join 配合分批策略展现出更加稳定的伸缩性。
生产环境避坑指南与极限优化
在了解了基本用法和选型逻辑后,实际工程落地时还有几个必须掌握的避坑实践:
避坑点 1:千万级数据的“解包致死”问题
当处理海量日志数据或传感器打点记录时,开发者有时会误写出 print(*huge_generator, sep=":")。此时,即使 huge_generator 是一个节省内存的生成器,前面的星号解包操作(*)也会强制在瞬间将生成器完全耗尽并全部实例化为堆栈元组,瞬间击穿内存限制。对于超大数据集的冒号分隔输出,最佳实践是直接使用流迭代器:
# 正确的超大数据集冒号分隔流式写入方式
def stream_colon_separated(iterable, out_file):
    it = iter(iterable)
    try:
        first = next(it)
        out_file.write(str(first))
    except StopIteration:
        return

    for item in it:
        out_file.write(":")
        out_file.write(str(item))

# 无需在内存中构造完整字符串,也不会触发解包元组膨胀
with open("massive_output.log", "w", encoding="utf-8") as f:
    stream_colon_separated(huge_dataset, f)
避坑点 2:优雅处理包含非字符串的混合数据
在使用 join 时,如果需要快速兼容整型或其他类型,推荐使用内置的 map(str, ...),它的 C 级函数迭代效率显著优于普通的 Python 生成器:
# 推荐写法(C级别迭代,高效平滑)
formatted = ":".join(map(str, raw_items))

# 替代写法(如果还需要对元素进行格式化,例如两位的16进制MAC地址)
formatted = ":".join(f"{x:02X}" for x in raw_bytes)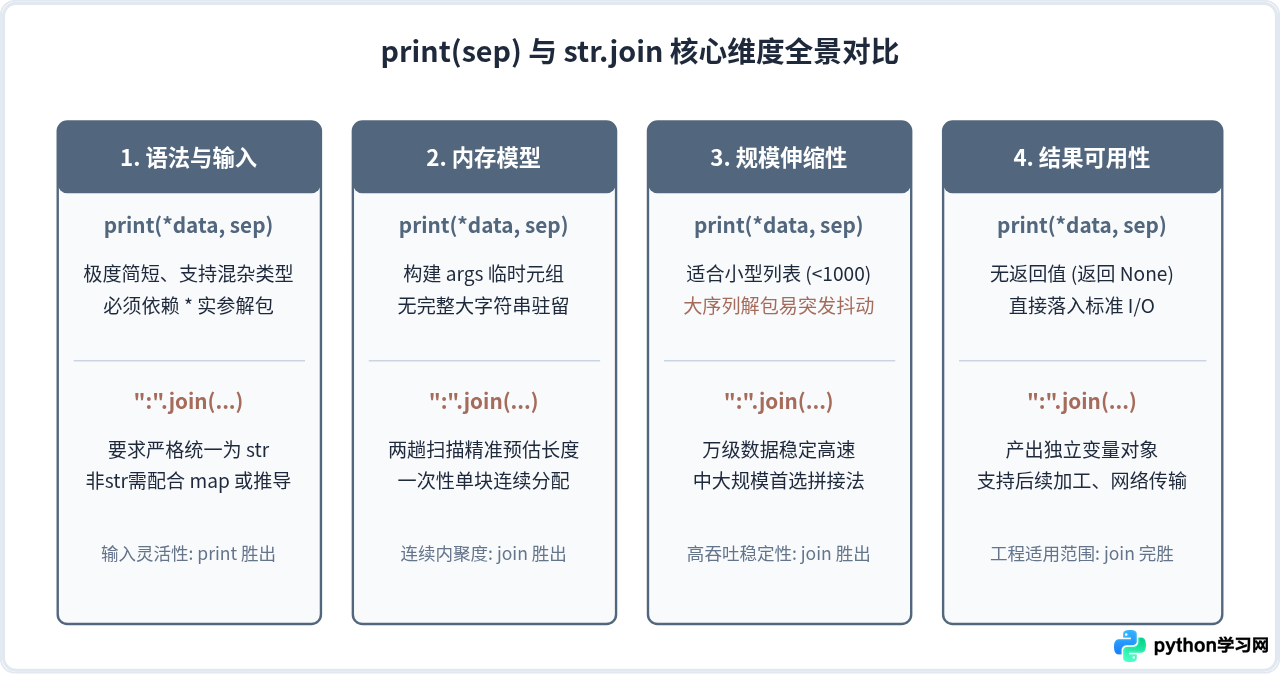
总结与速查口诀
综上所述,print sep 与 str.join 并非二元对立的替代关系,而是服务于不同工程生命周期的两套工具:
- 只看不存,少而杂,用 print sep:当处于快速调试、控制台报告输出、且列表元素数量不大、类型杂乱时,放心写出
print(*data, sep=":"),它能让你以最精简的击键次数获得直观结果。 - 产物流转,大且规整,必用 str.join:当面对正式的业务开发、API 响应组装、持久化存储,或者处理中大规模的纯字符串序列时,统一采用
":".join(data)或":".join(map(str, data)),享受 C 级预分配带来的确定性性能与安全性。 - 海量级流式场景:当数据超出单次内存承受能力,两者均应让步于流式生成器与文件原生的
write迭代机制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









