

Python解释器怎么选:CPython、PyPy与Jython对比

选择Python解释器并不是一个单纯比拼跑分速度的技术游戏,而是由项目所依赖的第三方库生态、运行环境以及维护成本共同决定的工程选型。绝大多数开发者无需纠结,官方标准实现CPython始终是默认且最稳妥的选择;若系统是纯Python编写的长时间运行服务且面临严重的CPU运算瓶颈,PyPy能够借助JIT编译带来数倍性能提升;而如果必须与现有的Java系统深度融合或直接互调JVM类库,Jython曾是经典桥梁,但受限于语言版本停滞,新项目需极其审慎。
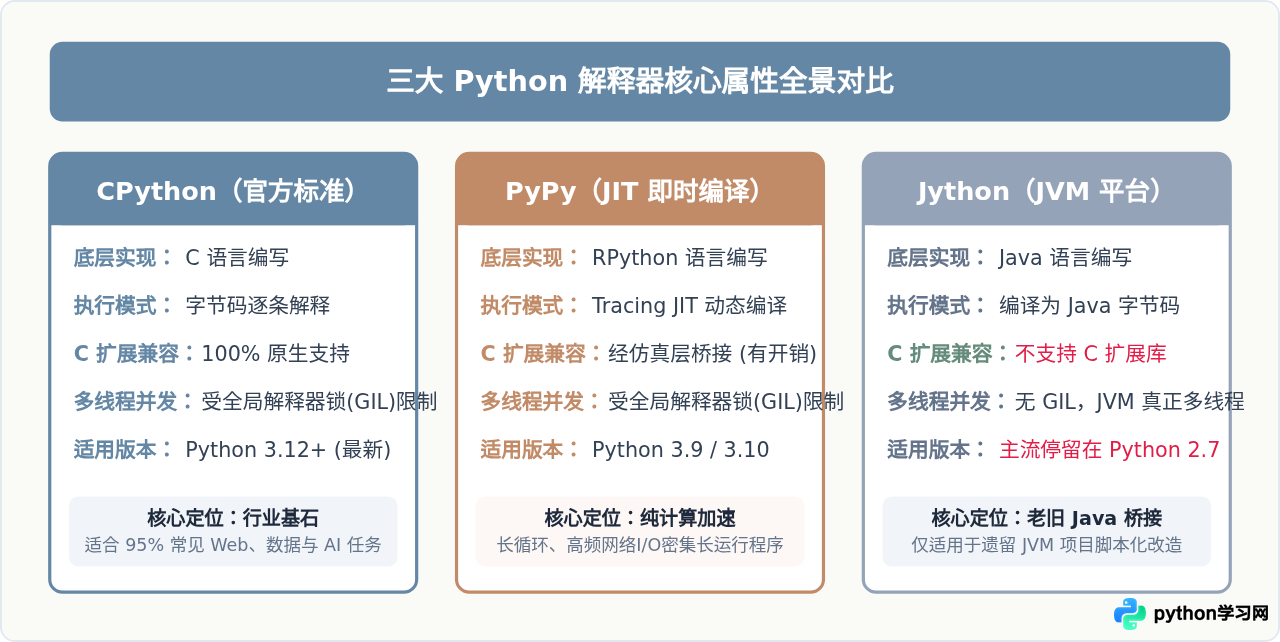
一、三者底层架构与运行机制的本质差异
很多初学者容易将 Python 语法与解释器实现混为一谈。Python 本身是一门具有明确语法标准的语言规范,而 CPython、PyPy 与 Jython 则是遵循这一规范的具体执行引擎。它们在“如何将代码转为硬件指令”的路径上有着根本性的分歧。
1. CPython:参考实现的解释循环与 GIL
CPython 是 Python 官方组织维护的参考实现,使用纯 C 语言开发。当在终端输入 python app.py 时,CPython 会经历语法解析、生成抽象语法树(AST),然后编译为 Python 专有的字节码(通常缓存为 .pyc 文件)。在运行阶段,CPython 的虚拟机通过一个庞大的评估循环(ceval.c 中的巨大 switch-case 或跳转表),按顺序逐行读取并执行字节码指令。
CPython 的内存管理基于引用计数与周期垃圾标记清除,为了保护内部 C 结构和对象状态的线程安全,它引入了全局解释器锁(Global Interpreter Lock,简称 GIL)。这意味着在同一个解释器进程中,无论物理 CPU 有多少核,在同一时刻只能有一个原生线程在执行 Python 字节码。对于计算密集型任务,CPython 多线程无法直接利用多核,通常需要通过多进程(multiprocessing)规避。
2. PyPy:RPython 框架与 Tracing JIT 动态编译器
PyPy 并不是简单地给 CPython 打补丁,它是用受限 Python 子集(RPython)重写的一个独立解释器系统。PyPy 最具革命性的能力在于其内建的追踪即时编译器(Tracing JIT Compiler)。
在程序启动初期,PyPy 同样以字节码解释执行,但它会在后台持续监听哪些代码段被频繁反复调用(即所谓的热点代码 Hotspot)。一旦某段循环或函数达到执行阈值,Tracing JIT 就会记录该循环中真实发生的变量类型和执行路径,随后将其直接编译为高效的底层机器码(x86/ARM),并注入机器指令缓存。后续执行该循环时,CPU 直接执行原生机器码,跳过一切解释和动态属性查找。在纯 Python 编写的循环、递归与矩阵变换中,运行速度往往能达到 CPython 的 3 到 8 倍。
3. Jython:与 JVM 生态无缝缝合的 Java 编译器
Jython(前身为 JPython)是使用纯 Java 语言编写的 Python 解释器。它的核心设计目标不是超越 CPython 的单线程执行速度,而是实现 Python 与 Java 平台的数据零成本互通。
Jython 在读取 Python 代码后,并不是生成 Python 字节码,而是直接将其编译成符合 Java 虚拟机规范的 Java 字节码(.class)。随后,这段代码直接交由宿主 JVM 负责运行、优化与垃圾回收。由于完全托管在 JVM 之上,Jython 具备两个显著特征:
- 彻底没有 Python 的 GIL:Python 线程直接映射为 Java 原生线程,享受 JVM 级别的真正多核多线程调度。
- 双向无缝调用:可以在 Python 中直接
import java.util.ArrayList,实例化 Java 对象并调用方法;Java 也可以将 Python 脚本作为内嵌引擎执行。
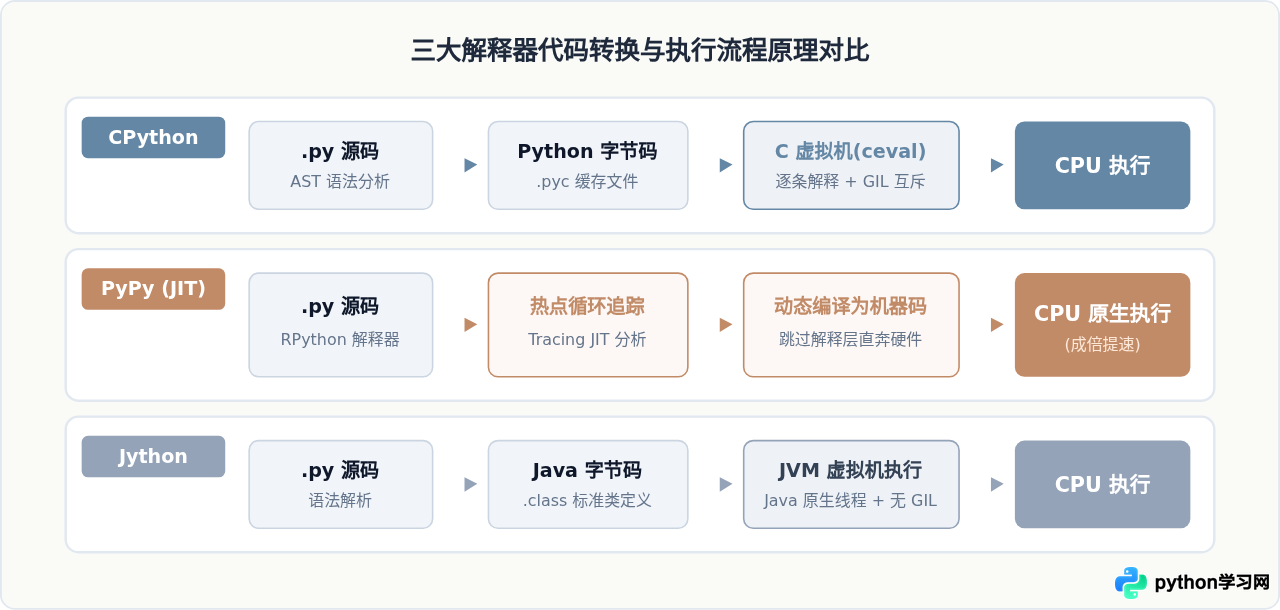
二、核心工程维度的深度横向权衡
脱离实际工程场景谈性能是没有意义的。在现实项目中,代码的执行开销往往只占全局的一小部分,以下四个核心维度往往直接决定选型的成败。
1. C 扩展模块与第三方库生态兼容性
当代 Python 的繁荣极大程度建立在丰富的原生扩展之上(如 NumPy、Pandas、SciPy、PyTorch、Cryptography 等底层大量使用 C/C++ 或 Fortran 编写的库)。
- CPython:原生提供完整的 Python/C API。所有基于 C/C++ 封装的轮子(Wheel 文件)在安装后直接与 CPython 内存交互,零协议转换成本,兼容性为 100%。
- PyPy:为了兼容现有的 C 扩展,PyPy 提供了
cpyext模拟层。然而,模拟层必须在 PyPy 的对象内存模型与 CPython 的静态 C 结构体之间进行频繁的数据拷贝和指针包装。这导致一个经典的工程反差:在 PyPy 上运行大量使用 NumPy 的数值计算,速度往往比 CPython 慢数倍。PyPy 的性能优势只存在于纯 Python 算法或采用cffi调用的轻量接口中。 - Jython:由于架构基于 JVM,它完全无法加载通过 Python/C API 编译的
.so或.pyd二进制动态链接库。这意味着 NumPy、Pandas、OpenCV 以及各类现代机器学习库在 Jython 上统统无法运行。
2. 内存消耗与启动预热延迟
在云原生微服务、命令行工具(CLI)以及 Serverless(冷启动敏感)环境中,解释器的内存占用与初始化时间至关重要:
- CPython 启动轻巧:冷启动时间通常在毫秒级(约 15~30ms),基础空载内存占用极低(约 10~20MB),非常适合编写短生命周期的系统维护脚本或云函数。
- PyPy 存在明显的预热周期:JIT 编译器需要在运行时搜集统计信息并生成机器码,这导致程序刚启动时的速度与 CPython 相当甚至稍慢;且 JIT 运行时会维护庞大的追踪元数据和机器码缓存,其稳定运行期的内存占用通常是 CPython 的 1.5 到 3 倍。
- Jython 启动最为笨重:运行 Jython 本质上是在启动一个完整的 JVM 实例,哪怕只打印一行
print("hello"),启动延迟也常常超过 1 秒,初始堆内存占用通常在 80MB 以上。
3. Python 规范版本支持现状(关键致命项)
语言特性的支持进度是评估开源组件生命力的关键指标:
| 解释器名称 | 对应支持的 Python 规范版本 | 关键现代特性支持度(类型标注、match-case等) | 维护活跃度与前景 |
|---|---|---|---|
| CPython | Python 3.12 / 3.13 (完全领先) | 完整支持全部最新语法及性能改良(如专项自适应解释器) | 官方核心团队直接维护,绝对主导 |
| PyPy | PyPy 3.9 / 3.10 规范兼容版 | 支持绝大多数 Python 3.10 语法及标准库 | 持续更新,紧跟主流 LTS 版本 |
| Jython | 仅稳定支持 Python 2.7 系列 | 不支持 Python 3 语法(如 async/await、f-string) | 社区基本停滞,Python 3 分支长期处于极度滞后状态 |
Python 官方已于 2020 年正式停止支持 Python 2。Jython 官方主线版本(如 Jython 2.7.x)无法解析任何 Python 3 专有语法。如果你的项目是新研发的系统,请绝对不要将 Jython 作为开发基石。若需要让 Python 与 Java 协同工作,现代方案普遍推荐基于网络 RPC(如 gRPC)解耦,或使用 Py4J 在 CPython 进程与 JVM 进程间建立通信。
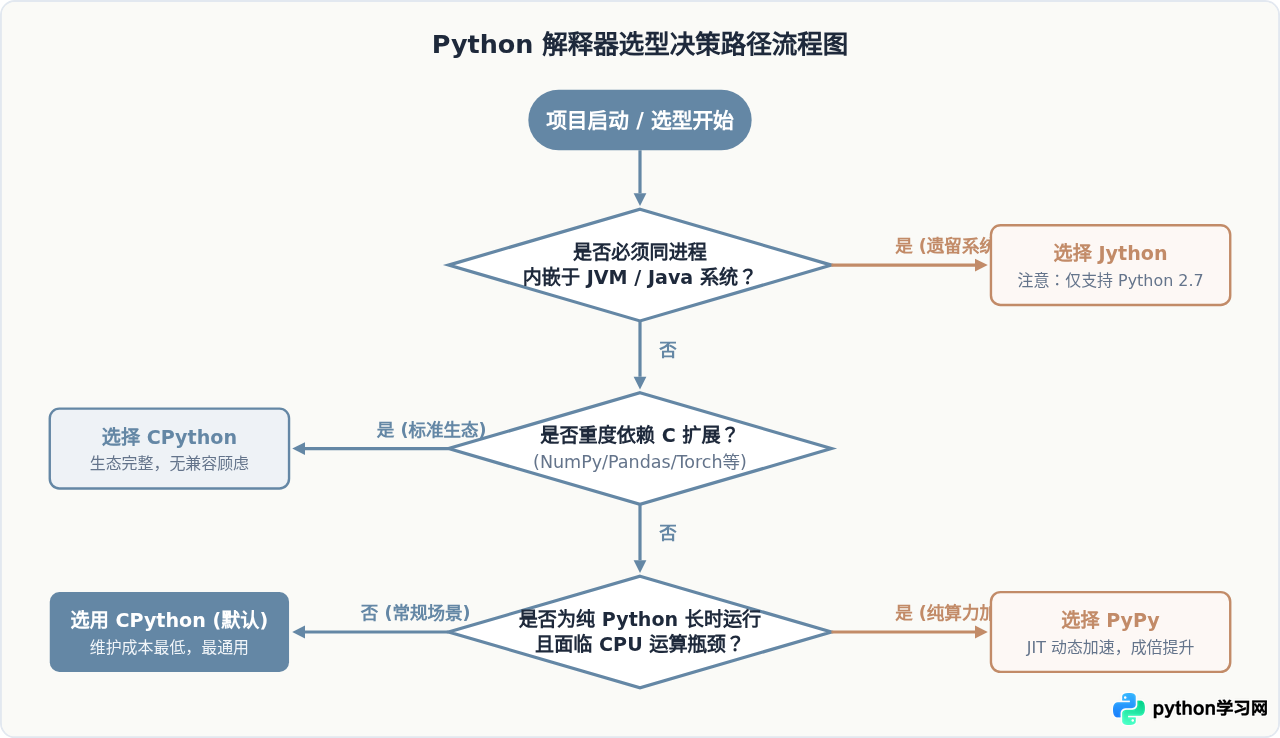
三、系统选型决策树与实践步骤
面对具体项目的技术选型,可以通过一套标准的分步骤决策逻辑,迅速确定最合适的解释器方案。
四、操作验证:如何在程序中确认当前运行环境
在编写跨平台或可移植脚本时,切忌臆测当前的解释器环境。通过 Python 基础库提供的 platform 和 sys 模块,可以精确判断当前脚本所运行的底层解释器实现类型。
import sys
import platform

def check_interpreter_environment():
    # 获取解释器实现的标准名称,例如 'CPython', 'PyPy', 'Jython'
    impl_name = platform.python_implementation()
    py_version = platform.python_version()

    print(f"当前运行的解释器: {impl_name}")
    print(f"对应 Python 规范版本: {py_version}")

    # 针对 PyPy 的专属信息探测
    if impl_name == "PyPy":
        pypy_ver = sys.pypy_version_info
        print(f"PyPy 核心版本: {pypy_ver.major}.{pypy_ver.minor}.{pypy_ver.micro}")

    # 针对 Jython 的平台检查
    elif impl_name == "Jython":
        import java.lang.System as JSystem
        print(f"宿主 Java 版本: {JSystem.getProperty('java.version')}")

    # 针对标准 CPython 的构建编译器信息
    elif impl_name == "CPython":
        print(f"C 语言编译器: {platform.python_compiler()}")

if __name__ == "__main__":
    check_interpreter_environment()
运行结果示例(标准 CPython 环境输出):
当前运行的解释器: CPython
对应 Python 规范版本: 3.11.8
C 语言编译器: GCC 11.4.0
运行结果示例(PyPy3 环境输出):
当前运行的解释器: PyPy
对应 Python 规范版本: 3.10.12
PyPy 核心版本: 7.3.15
五、全景选型决策总结与工程避坑清单
选型归根结底是在“计算性能”、“开发生态”与“维护成本”之间寻求平衡。下表整理了三者在典型业务场景中的推荐度与防坑建议:
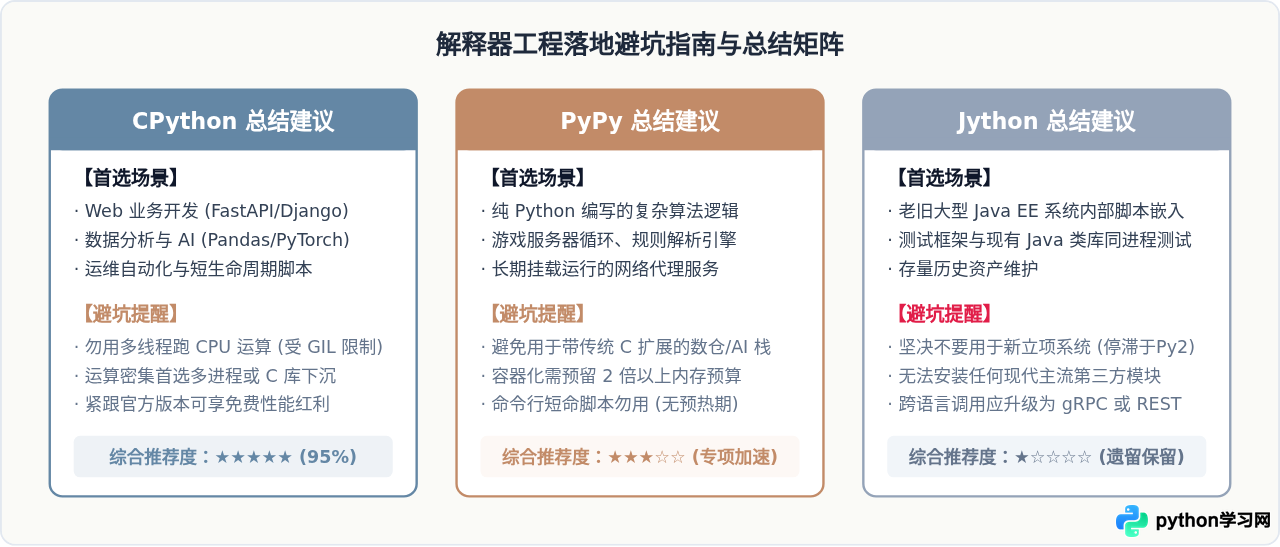
总的来说,评估解释器时应当优先考虑生态与兼容性,其次才是单核运算性能。遵循“先用官方 CPython 快速落地,出现明确的纯计算长时瓶颈再尝试 PyPy,多语言协同优先采用进程间解耦而非直接绑定 Jython”这一工程原则,可以在最大化发挥 Python 高效开发优势的同时,有效规避不必要的维护风险与技术债务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









