

llama.cpp b12430的HIP MoE性能数据应该怎样理解?
llama.cpp b12430为预发布构建,修复HIP后端MoE回归;区分GFX906上的两种性能对比基准、dense对照与多平台附件适用边界。
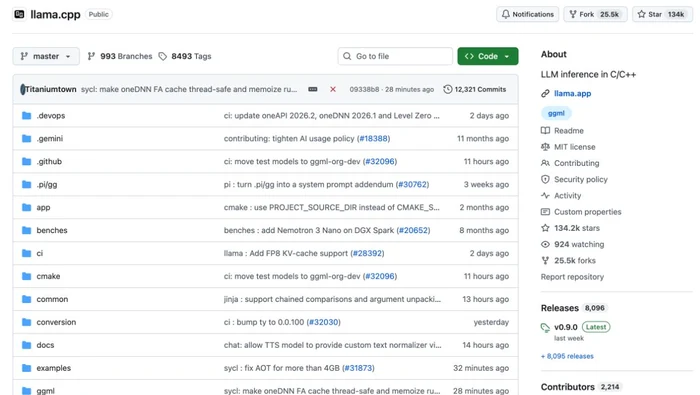
llama.cpp b12430预发布构建针对HIP后端MoE模型的性能回归提供修复,相关性能数据来自特定硬件和模型组合。它不是针对所有CUDA、CPU或所有模型的统一提速声明;判断是否相关,首先要区分推理后端、模型结构和具体构建。
这项修复指向什么运行组合
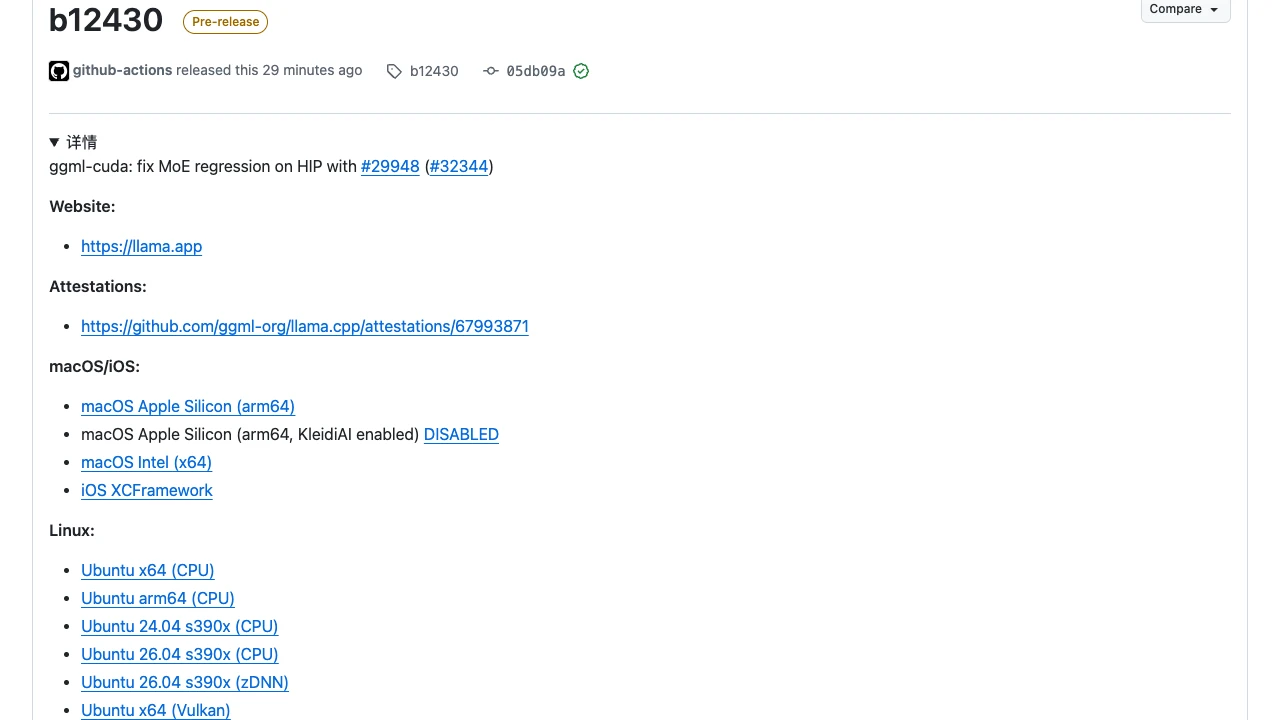
官方b12430说明把修复命名为“ggml-cuda: fix MoE regression on HIP with #29948”,对应合并请求#32344。名称中的ggml-cuda是代码模块标识,具体修复范围在同一句中限定为HIP和MoE,不能仅看到CUDA字样就认定所有NVIDIA环境均受影响。
该合并请求给出的测试环境是GFX906,模型包括gpt-oss-20b MXFP4和Qwen3.5-35B-A3B Q4_K_XL。作者还使用Qwen3-14B Q8_K_XL作为dense对照。MoE测试和dense对照分别报告,说明阅读结果时应把模型结构一起纳入条件。
如何理解官方提交中的性能数字
提交说明对比修复分支与master提交de32b268c,在列出的八组MoE组合中,吞吐改善约为2.34%至6.09%。这些组合包含不同提示长度和ub设置,数值对应特定模型、量化及硬件,不是b12430在所有设备上的性能保证。
说明还单独比较了#29948之前的提交a55c16e4e。这组数据回答的是修复后与更早基准相比如何,不能与“修复分支对master”的百分比混为同一个提升幅度。dense对照相对master的变化约为-0.09%至-0.22%,作者用它观察原有dense优化是否保留,不能由此推断所有dense模型完全没有性能变化。
预发布身份和下载包为何要分开看
b12430的官方记录标记为Pre-release。发布页列有macOS、Linux、Android、Windows等构建附件,但附件存在不意味着每个平台都适用这项HIP MoE修复,也不等于每个附件都经过相同模型测试。发布页同时保留禁用构建的标记,选择运行环境时应以相应附件和后端实际条件为准。
因此,已经使用HIP后端且运行相关MoE组合的用户,可以把b12430作为评估回归修复的明确版本;采用其他后端或dense模型时,应保留自己的基准与适用判断。官方说明没有列出所有受影响版本区间,不能据#29948编号推算一个未经确认的版本范围。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









