

Python异步爬虫框架有哪些:Aiohttp与Scrapy的性能对比
深入对比Python主流异步爬虫方案,系统解析Aiohttp与Scrapy的底层架构、并发机制、吞吐量差异与资源开销,提供详尽的选型指南与高并发实践。
在构建高吞吐量数据采集系统时,选择合适的爬虫方案通常决定了网络吞吐、开发效率与服务器硬件开销的上限。Python 生态中实现异步高并发爬取的核心工具主要分为两类:一类是以 Aiohttp、HTTPX 为代表的轻量级异步 HTTP 客户端,另一类是以 Scrapy 为代表的工业级分布式采集框架。本文将系统梳理当前主流的 Python 异步爬虫工具矩阵,并围绕开发者最为关心的核心维度,深入剖析 Aiohttp 与 Scrapy 在底层架构、请求吞吐量、资源开销及维护成本上的本质差异。
一、主流 Python 异步爬虫工具与框架概览
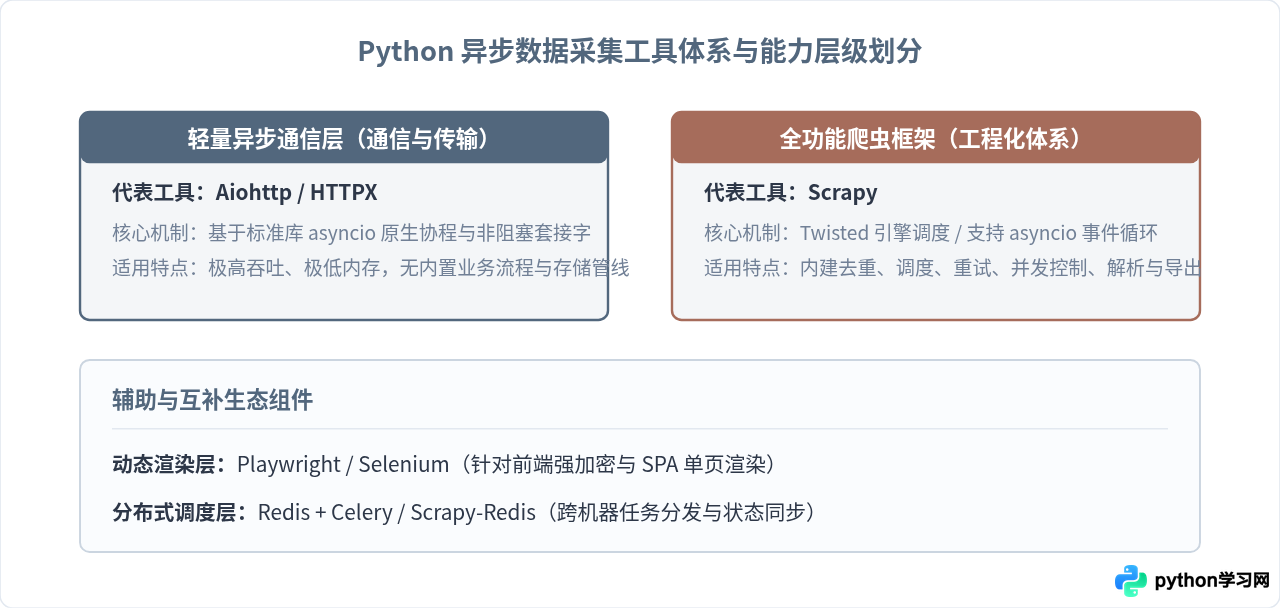
传统基于 requests 结合多线程或多进程的爬虫模型,在高并发场景下受限于线程上下文切换开销与 Python 全局解释器锁(GIL)的争用,单机并发能力往往在数百并发时便遭遇瓶颈。现代异步网络采集通过单线程非阻塞 I/O 和事件循环机制,能够在极低内存消耗下并发维系成千上万个网络连接。当前 Python 生态中活跃的异步采集工具主要具有以下不同定位:
- Aiohttp:基于标准库
asyncio构建的高性能异步 HTTP 客户端/服务端库。它不是一个开箱即用的完整爬虫框架,不提供调度器与管道,但因其轻量灵活、原生支持协程,是定制轻量级微服务爬虫的首选。 - Scrapy:Python 生态中最成熟的工业级抓取框架,底层基于事件驱动引擎 Twisted(现已全面兼容
asyncio事件循环)。内置请求调度、优先级队列、中间件过滤、内容解析及持久化管道,适合中大型规模的全站采集任务。 - HTTPX:现代全功能 HTTP 客户端,同时提供同步与
asyncio/trio异步接口,支持 HTTP/2 协议,API 设计与 requests 保持高度亲和,常用于兼顾易用性与异步特性的中小型场景。 - Playwright / Puppeteer(Python版):针对现代富交互与前端渲染(SPA)站点的无头浏览器自动化库,提供全套异步 API。尽管单实例资源消耗远大于纯网络协议爬虫,但在应对高强度反爬策略与复杂动态加载时不可替代。
二、底层并发架构:Aiohttp 与 Scrapy 是如何运转的
理解 Aiohttp 与 Scrapy 的性能分水岭,核心在于透视二者的并发组织与调度模型。虽然两者都能达成非阻塞 I/O,但内部控制逻辑和抽象层级大相径庭。
1. Aiohttp:极简协程与直接通道
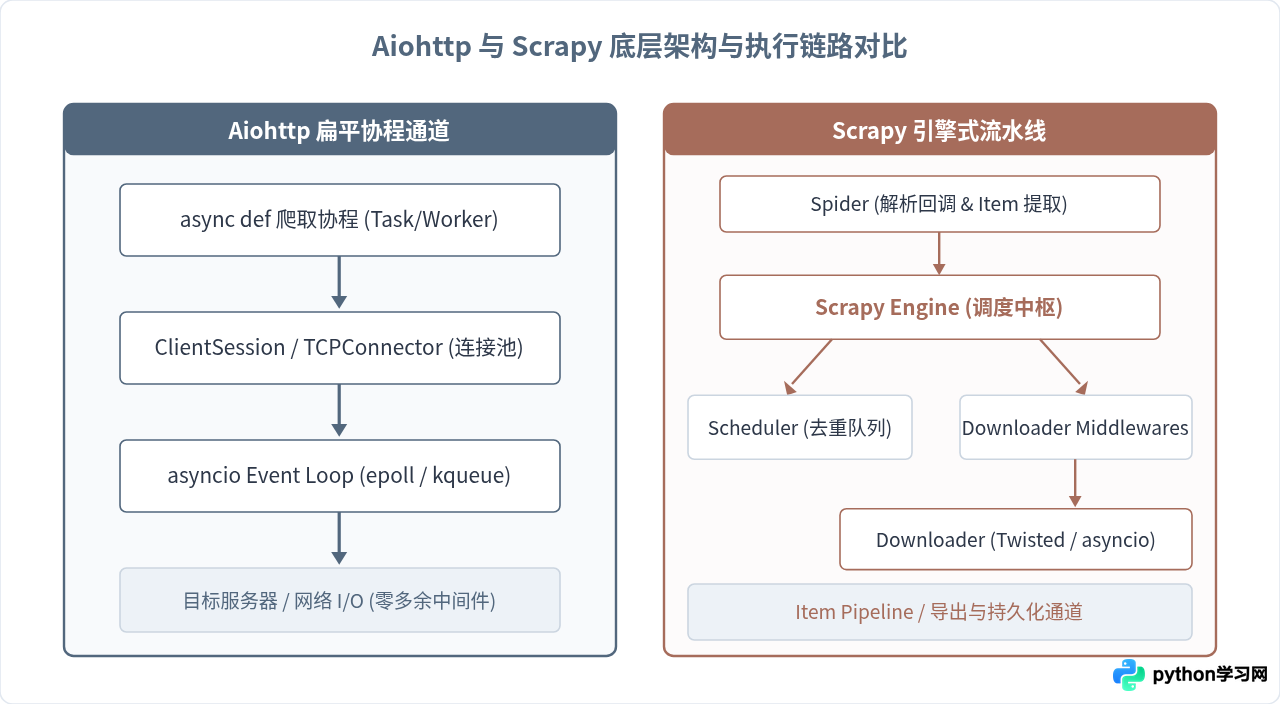
Aiohttp 完全围绕 Python 3 的 asyncio 事件循环运转。当发起网络请求时,底层通过 TCPConnector 复用连接池中的 Keep-Alive 套接字。请求的生命周期高度扁平:协程挂起(await)并向事件循环注册可读/可写事件,操作系统的 epoll/kqueue 在 I/O 就绪后触发唤醒,直接返回响应流。整个调用链路没有中间层过滤逻辑,CPU 开销几乎完全集中在协议解析和数据反序列化上。
2. Scrapy:组件化流水线与引擎驱动
Scrapy 采用经典的“调度器-下载器-爬虫-管道”流水线模型。引擎(Engine)作为核心中枢,负责向调度器(Scheduler)索取请求对象,穿透下载中间件(Downloader Middlewares)交给下载器,下载完成后再次穿透中间件送达 Spider 回调函数进行数据提取,提取出的数据项进入管道(Item Pipeline),产生的新请求则重新入队。即使在启用了 asyncio reactor 的现代 Scrapy 版本中,每一个 Request 对象仍需经历完整的信号派发、过滤器检查与链式回调,这为其带来了卓越的扩展性,但也带来了客观的运行时封装开销。
三、多维度性能深度评测与实测特性
在同等硬件环境(例如 4 核 CPU、8GB 内存环境,面向内网模拟或低延迟测试接口)下,两者的性能表现呈现出清晰的场景分化:
1. 请求吞吐量(RPS / Requests Per Second)
在面对轻量级 API 接口(如 JSON 接口采集)且不涉及重度 HTML 解析的纯 I/O 密集型场景中,Aiohttp 的单机吞吐量通常显著优于 Scrapy:
- Aiohttp 吞吐特性:得益于扁平调用和极致的上下文精简,配合
uvloop替代默认事件循环,Aiohttp 在大并发量(1000~3000 并发连接)下能够打出极其惊人的网络吞吐,甚至能将网络带宽或操作系统套接字文件描述符跑满。 - Scrapy 吞吐特性:Scrapy 在默认配置下并发限制较为保守(如
CONCURRENT_REQUESTS = 16)。即使调大并发并启用异步反应器,由于请求对象从入队、去重哈希计算、穿透中间件到回调分发均伴随大量的 Python 对象创建与销毁,单核每秒处理的请求数通常在几百至一千上下遇到 CPU 计算瓶颈。
2. 内存与 CPU 开销
爬虫在处理海量队列时,内存占用是系统稳定运行的关键:
- Aiohttp:内存开销极为紧凑。任务通常使用
asyncio.Queue或生成器随用随取,在处理百万级任务时,开发者可以精准通过有界队列(Bounded Queue)与信号量(asyncio.Semaphore)约束在内存中的并发对象数量,常驻内存一般可控制在几十到一两百兆字节。 - Scrapy:内置的调度器(默认存储在内存队列中)以及 Request/Response 对象的元数据包装会导致单位任务的内存开销明显偏高。若未合理配置磁盘队列或爬取层级(深度优先 vs 广度优先),内存中堆积海量 Request 对象容易诱发 OOM(内存溢出)。
3. 全维度指标对照表
| 对比维度 | Aiohttp 方案 | Scrapy 框架 |
|---|---|---|
| 吞吐量上限 (I/O密集) | 极高(单机可突破数千 RPS,受限于物理带宽) | 中等偏高(单进程通常在数百至千余 RPS) |
| 单核 CPU 利用率 | 低,开销主要在网络字节传输与协议编解码 | 较高,中枢引擎与中间件流转消耗较多 CPU 周期 |
| 初始内存占用 | 微量(约 30MB ~ 80MB) | 中等(启动即占 120MB ~ 250MB+) |
| 异步事件循环支持 | 原生强依赖 Python asyncio,无缝对接现代协程库 | 基于 Twisted 架构,现可通过配置接入 asyncio reactor |
| 开箱即用度 | 低(需自建调度、去重、限流、重试与存储) | 极高(完整成熟的工程化套件) |
| 反爬与中间件扩展 | 需手写封装连接池或装饰器实现代理池/Cookie管理 | 拥有庞大的开源插件库(如 scrapy-redis、下载中间件等) |
四、代码实现与并发控制模式对比
代码组织结构的差异直接反映了两者的设计理念。编写 Aiohttp 爬虫需要开发者显式控制并发粒度,而 Scrapy 则通过配置文件接管了调度逻辑。
1. Aiohttp 典型模式:带信号量限制的高并发抓取
在 Aiohttp 中,若不进行并发限制,盲目创建数万个任务会导致“Too many open files”系统错误或被目标站点直接封禁。标准的实践是利用 asyncio.Semaphore 约束最大并发窗口:
import asyncio
import aiohttp

# 限制同时进行的最大并发请求数
CONCURRENCY_LIMIT = 50
semaphore = asyncio.Semaphore(CONCURRENCY_LIMIT)

async def fetch(session: aiohttp.ClientSession, url: str) -> str:
    async with semaphore:
        async with session.get(url, timeout=aiohttp.ClientTimeout(total=10)) as response:
            return await response.text()

async def main(urls: list[str]):
    # 使用 TCPConnector 配置连接池与 DNS 缓存
    connector = aiohttp.TCPConnector(limit=100, ttl_dns_cache=300)
    async with aiohttp.ClientSession(connector=connector) as session:
        tasks = [fetch(session, url) for url in urls]
        # 并发汇总结果
        results = await asyncio.gather(*tasks, return_exceptions=True)
        return results

if __name__ == "__main__":
    test_urls = [f"https://api.example.com/items/{i}" for i in range(1000)]
    asyncio.run(main(test_urls))
2. Scrapy 异步 Spider 与全局配置
在 Scrapy 中,开发者仅需专注于目标解析逻辑。通过 settings.py 中的配置参数,底层引擎会自动平衡请求发送频率与并发数量:
# spiders/product_spider.py
import scrapy

class ProductSpider(scrapy.Spider):
    name = "product"
    start_urls = [f"https://api.example.com/items/{i}" for i in range(1000)]

    def parse(self, response):
        yield {
            "id": response.css("span.item-id::text").get(),
            "name": response.css("h1.title::text").get(),
            "price": response.css("span.price::text").get(),
        }

# settings.py 关键性能调优项:
# CONCURRENT_REQUESTS = 64
# CONCURRENT_REQUESTS_PER_DOMAIN = 32
# DOWNLOAD_DELAY = 0.1
# TWISTED_REACTOR = "twisted.internet.asyncioreactor.AsyncioSelectorReactor"
五、异步爬虫构建与压测执行路径
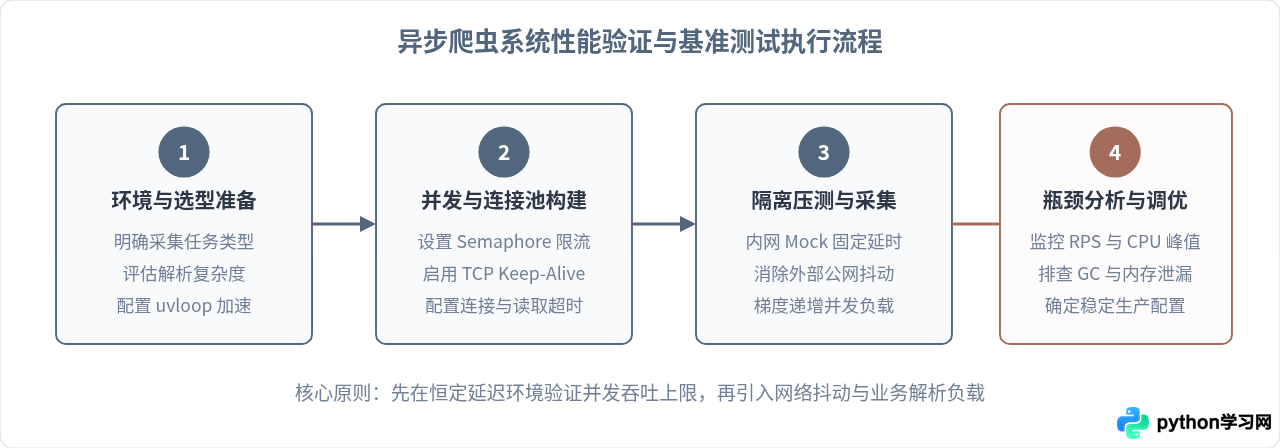
在确定性能指标时,不可脱离具体网络环境盲目推断。构建并验证一个高吞吐异步爬虫的标准流程如下:
六、工程落地决策:何时选用 Aiohttp,何时选用 Scrapy
脱离具体工程约束谈框架性能往往没有意义。在实际工业界项目中,性能通常受制于反爬机制、IP 代理质量以及目标站点的承受能力,而非框架本身理论性能的上限。
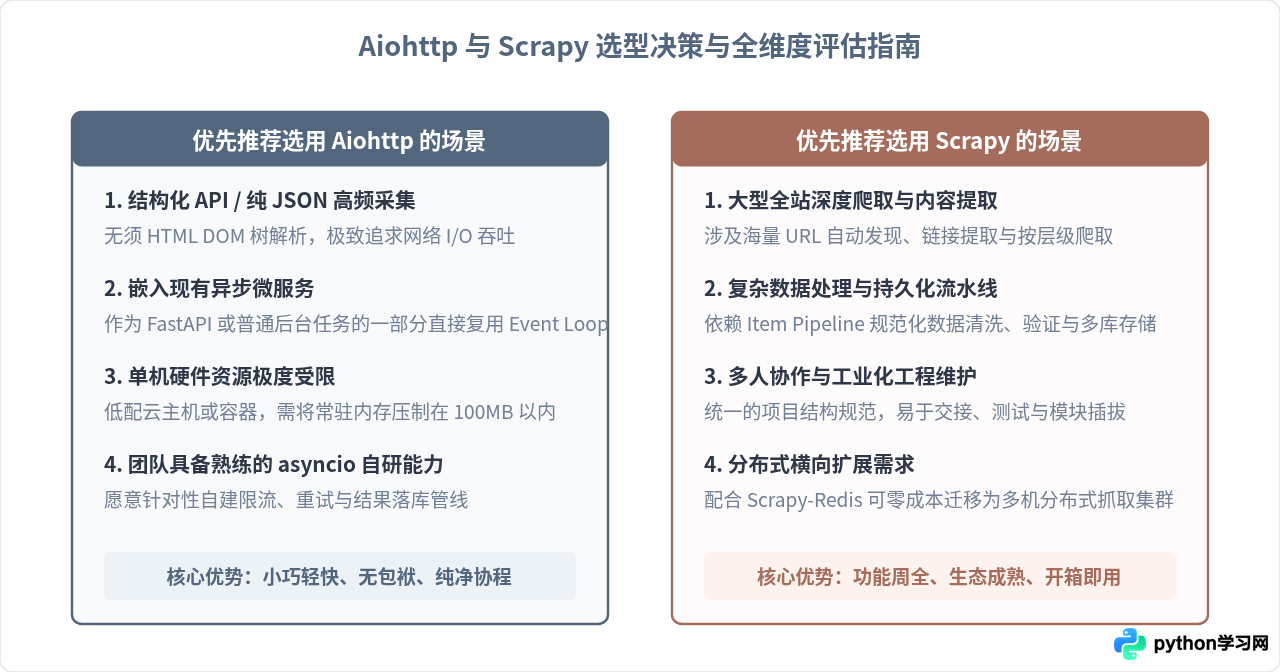
技术选型决策准则:如果任务目标明确、接口规范(如只抓 JSON API)、要求极高性能或需要无缝嵌入已有 FastAPI/Tornado 异步服务中,优先选用 Aiohttp;如果任务属于复杂多页面全站爬取、层级深度大、包含大量链接发现与去重、需要现成的中间件生态支持(如代理切换、自动重试、直接入库),必须优先选用 Scrapy。
七、总结
回到最初的核心问题:Python 异步爬虫框架有其各自明确的生存土壤。Aiohttp 凭借原生 asyncio 的低运行时封装与极高网络吞吐,在纯数据 I/O 吞吐量和资源利用效率上完胜传统流水线,但其不包含爬虫工程的基础设施;Scrapy 凭借经过十年工业级检验的完备组件、强大的中间件插件和分布式扩展能力,依然是复杂采集工程无法替代的旗舰。在现代爬虫开发中,理解两者的机制边界,依据数据源特征与业务团队规模做出权衡,是保证爬取系统稳定高效运行的前提。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









