

从零开始用Python开发一款爬虫软件:架构设计与合规注意
从零开始使用Python构建模块化爬虫软件,系统讲解网络爬虫的核心架构分层设计、限流去重机制、容错处理,以及网络爬虫的法律合规边界与安全实践。
一、为什么爬虫需要完整的软件架构设计?
初学者编写爬虫通常采用单个线性脚本:通过 requests.get() 发起网络请求,接着用正则表达式或解析库过滤标签,最后直接 write() 写入本地文件。这种“一条线跑到底”的模式在面对十几个静态页面时尚可应付,但一旦抓取任务扩展至数万页面,或需要应对断点续爬、网络重试、动态限速及持久化时,脚本就会迅速陷入无法维护的泥潭。
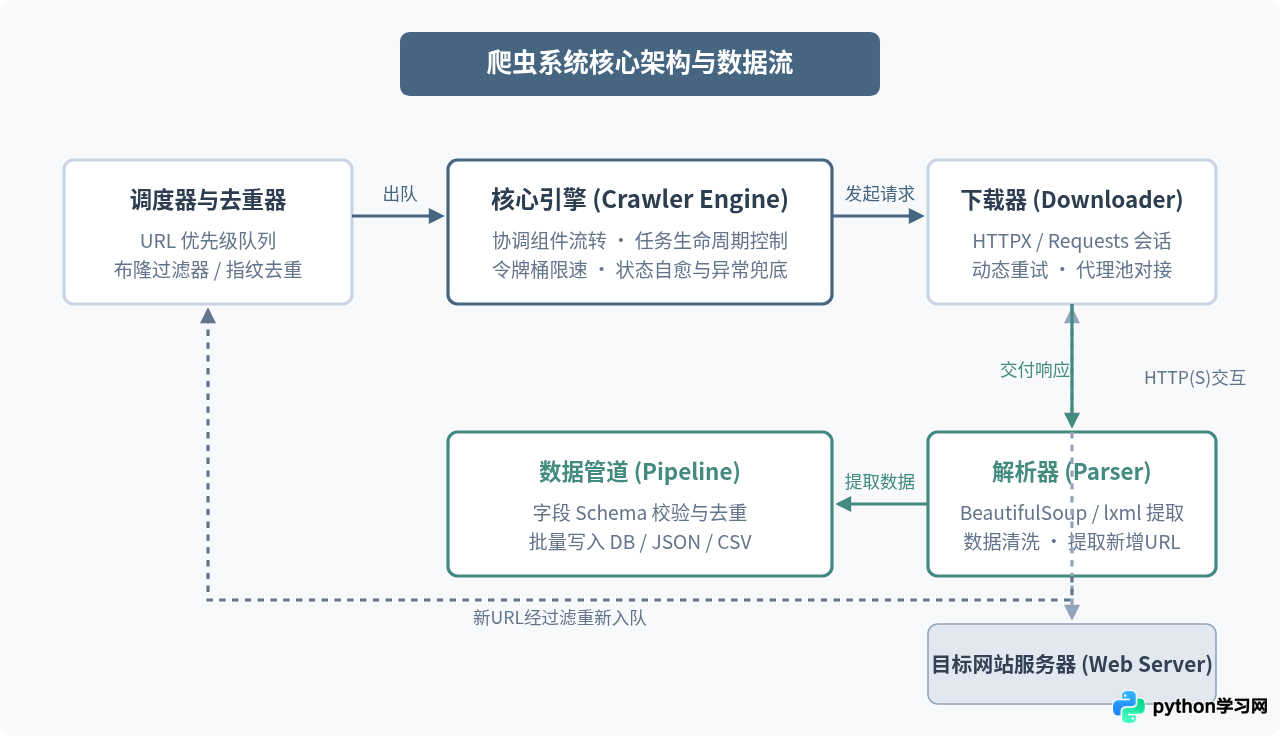
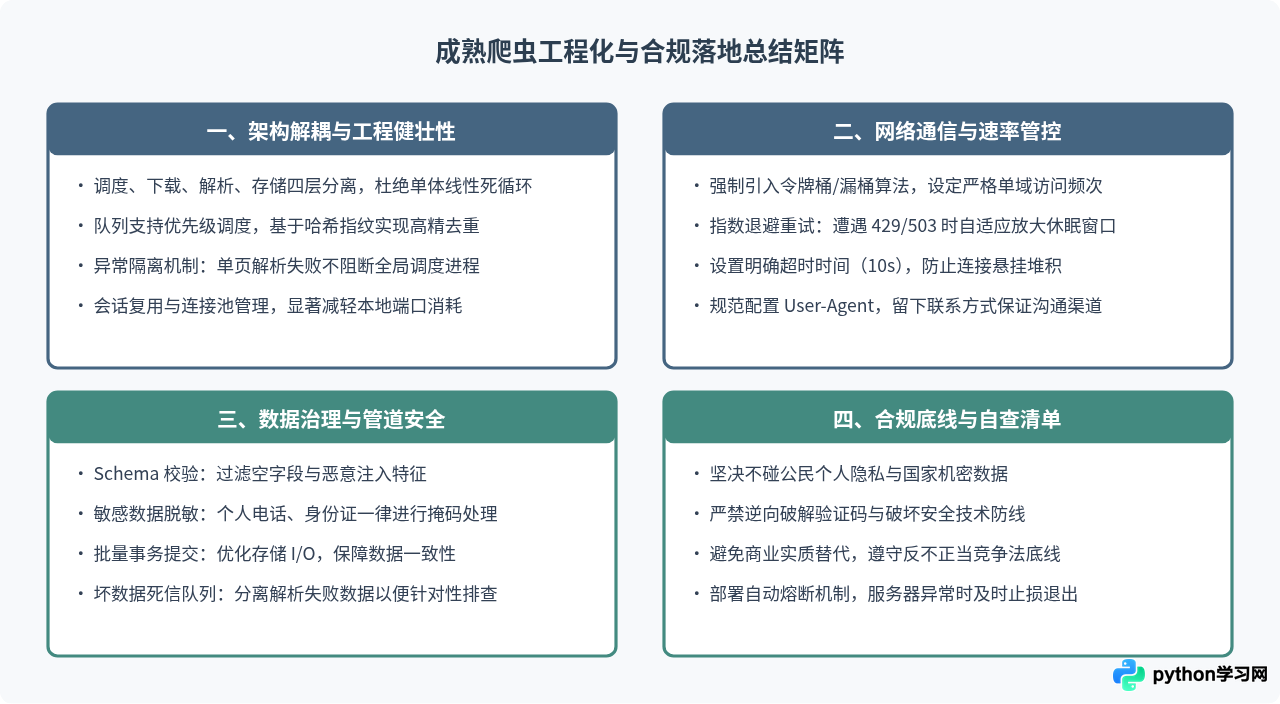
一款合格的爬虫软件应当将各个业务逻辑解耦,使其各司其职:
- 调度器(Scheduler):管理待抓取 URL 队列与已抓取指纹去重,控制任务分发优先级与运行状态。
- 下载器(Downloader):专门处理网络通信、HTTP 请求头封装、Cookies 会话维护、动态代理切换与自动限速。
- 解析器(Parser):负责从下载器交付的原始 HTML/JSON 中提取结构化字段与衍生 URL,确保脏数据过滤。
- 存储管道(Pipeline):将清洗后的数据执行格式校验,批量提交至数据库(如 PostgreSQL、MongoDB)或结构化文件。
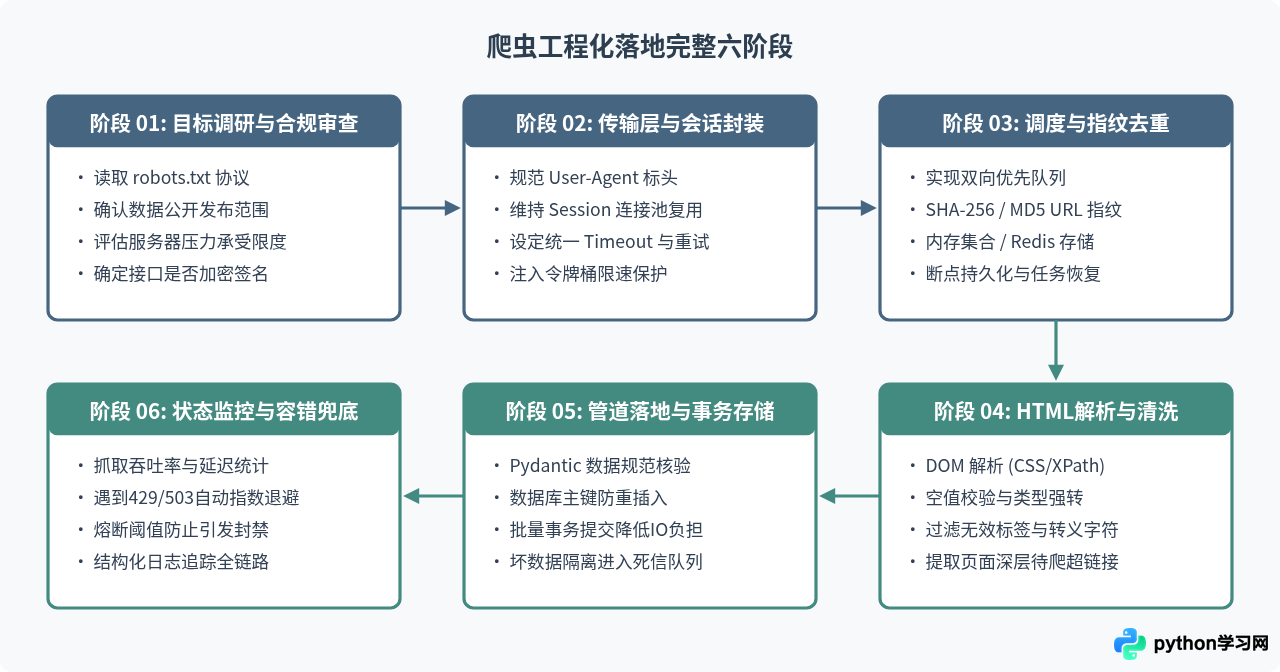
二、从零开发爬虫软件的工程实施步骤
构建一款爬虫软件应按照严谨的工程化步骤逐步推进。跳过前期的协议调研而直接写抓取代码,往往会导致频繁被封禁甚至触犯法律法规。
三、实战:核心软件架构代码实现
以下基于 Python 3.9+ 编写一套内聚度高、无第三方框架黑盒的模块化爬虫软件核心骨架。各组件全部封装成标准类,具备速率限制、指纹去重与结构化落盘能力:
import hashlib
import json
import logging
import time
from dataclasses import dataclass, field
from typing import List, Dict, Any, Optional
import urllib.robotparser
import requests
from bs4 import BeautifulSoup

# 配置标准化日志输出
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

@dataclass
class CrawlRequest:
    """定义抓取请求对象,保留抓取元数据与重试深度"""
    url: str
    priority: int = 0
    retries: int = 0
    max_retries: int = 3
    meta: Dict[str, Any] = field(default_factory=dict)

class RobotsChecker:
    """合规模块:自动解析目标网站的 robots.txt 协议"""
    def __init__(self, user_agent: str = "MyFriendlyCrawler"):
        self.user_agent = user_agent
        self.parsers: Dict[str, urllib.robotparser.RobotFileParser] = {}

    def is_allowed(self, target_url: str) -> bool:
        from urllib.parse import urlparse
        parsed = urlparse(target_url)
        base = f"{parsed.scheme}://{parsed.netloc}"
        if base not in self.parsers:
            rp = urllib.robotparser.RobotFileParser()
            robots_url = f"{base}/robots.txt"
            try:
                rp.set_url(robots_url)
                rp.read()
                self.parsers[base] = rp
                logging.info(f"成功加载协议: {robots_url}")
            except Exception as e:
                logging.warning(f"未能获取 {robots_url},默认保守访问: {e}")
                return True
        return self.parsers[base].can_fetch(self.user_agent, target_url)

class Scheduler:
    """调度器:处理 URL 入队、去重与按优先级出队"""
    def __init__(self):
        self.queue: List[CrawlRequest] = []
        self.seen_fingerprints = set()

    def _fingerprint(self, url: str) -> str:
        # 去除参数扰动后生成 SHA256 哈希
        return hashlib.sha256(url.strip().encode("utf-8")).hexdigest()

    def push(self, req: CrawlRequest) -> bool:
        fp = self._fingerprint(req.url)
        if fp in self.seen_fingerprints:
            return False
        self.seen_fingerprints.add(fp)
        self.queue.append(req)
        # 根据优先级排序,保证高优先级任务优先出队
        self.queue.sort(key=lambda x: x.priority, reverse=True)
        return True

    def pop(self) -> Optional[CrawlRequest]:
        return self.queue.pop(0) if self.queue else None

    def has_next(self) -> bool:
        return len(self.queue) > 0

class Downloader:
    """下载器:具备并发限速与断点重试的网络通信层"""
    def __init__(self, delay_seconds: float = 1.0, user_agent: str = "MyFriendlyCrawler/1.0"):
        self.delay = delay_seconds
        self.last_request_time = 0.0
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": user_agent,
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
        })

    def download(self, req: CrawlRequest) -> Optional[str]:
        # 严格遵守礼貌抓取间隔
        elapsed = time.time() - self.last_request_time
        if elapsed < self.delay:
            time.sleep(self.delay - elapsed)

        try:
            logging.info(f"正在抓取: {req.url} (尝试: {req.retries + 1})")
            resp = self.session.get(req.url, timeout=10)
            self.last_request_time = time.time()
            if resp.status_code == 200:
                return resp.text
            elif resp.status_code in [429, 503]:
                # 遭遇限频或服务器繁忙,指数退避
                backoff = (2 ** req.retries) * 2
                logging.warning(f"触发反爬限制 {resp.status_code},休眠 {backoff} 秒")
                time.sleep(backoff)
            else:
                logging.error(f"HTTP错误 {resp.status_code}: {req.url}")
        except requests.RequestException as e:
            logging.error(f"网络异常: {e},URL: {req.url}")

        req.retries += 1
        return None

class Parser:
    """解析器:抽取目标字段与深层链接"""
    def parse(self, html: str, base_url: str) -> Dict[str, Any]:
        soup = BeautifulSoup(html, "html.parser")
        items = []
        for article in soup.select("article"):
            title_node = article.select_one("h2")
            link_node = article.select_one("a")
            if title_node and link_node:
                items.append({
                    "title": title_node.get_text(strip=True),
                    "url": link_node.get("href", "").strip()
                })
        return {"items": items}

class Pipeline:
    """存储管道:数据持久化与脏数据过滤"""
    def __init__(self, output_path: str = "output_data.jsonl"):
        self.output_path = output_path

    def process(self, item: Dict[str, Any]) -> None:
        if not item.get("title") or not item.get("url"):
            return  # 丢弃字段不全的脏数据
        with open(self.output_path, "a", encoding="utf-8") as f:
            f.write(json.dumps(item, ensure_ascii=False) + "\n")
四、网络爬虫的合规注意与法律红线
技术本身是中立的,但使用爬虫抓取并利用数据的行为受到国家法律的严格规制。在中国法律框架下,爬虫开发与运营主要涉及《中华人民共和国网络安全法》、《中华人民共和国数据安全法》、《中华人民共和国个人信息保护法》以及《中华人民共和国刑法》相关条款。
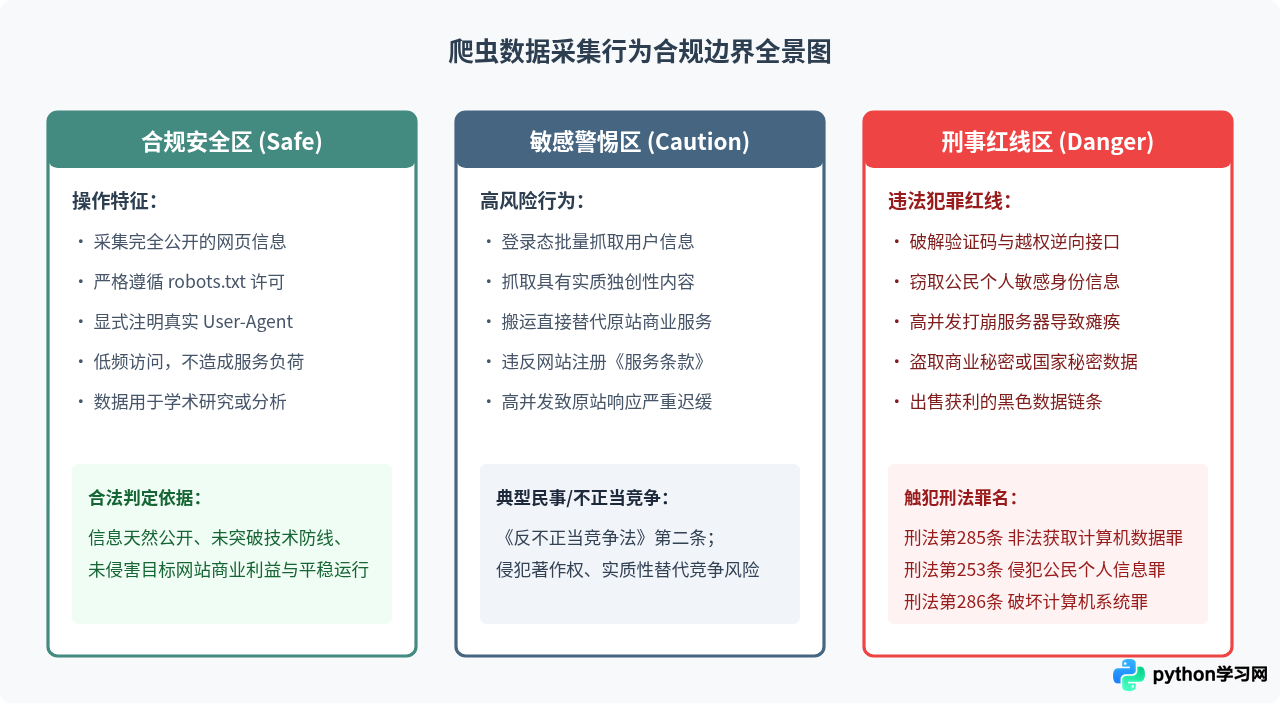
1. 计算机信息系统安全维度(刑法第285条、第286条)
很多开发者误认为“只要能抓到的数据就能抓”。在法律实践中,如果目标网站设置了明确的反爬虫措施(如签名校验、设备指纹、滑动验证码等),而开发者使用逆向工程手段强制绕过、破解验证、模拟登录,就属于“侵入计算机信息系统”或“采用其他技术手段非法获取计算机信息系统数据”,可能直接触犯《刑法》第285条。此外,若爬虫未做限流,突发并发导致目标网站响应变慢甚至崩溃,还可能构成《刑法》第286条“破坏计算机信息系统罪”。
2. 公民个人信息保护维度(刑法第253条之一)
根据《个人信息保护法》与《刑法》第253条之一,公民个人信息(包括姓名、身份证号、电话、行踪轨迹、通信记录、住宿信息等)受到严格保护。即便用户在公开社交平台展示了部分资料,未经特定授权也不得进行全量、批量的爬取与商业化存储;一旦非法获取条数达到司法解释的追诉标准(如行踪轨迹等高度敏感信息50条以上,一般个人信息5000条以上),将直接承担刑事责任。
3. 反不正当竞争与著作权维度(民事与行政责任)
在商业竞争中,即使爬取的是公开数据,如果爬虫软件将抓取到的核心商业数据(如电商商品评论库、点评网站评分、原创文学小说)用于构建同类产品,造成“实质性替代”原站的核心业务,侵害了原站长期投入成本所形成的竞争优势,司法裁判通常依据《反不正当竞争法》第二条原则判定构成不正当竞争,承担巨额经济赔偿。
五、合规友好的爬虫开发黄金实践清单
为了让自研的爬虫软件在法律与工程安全范围内稳定运行,建议在架构设计中强制植入以下规则:
| 防护维度 | 技术实现标准 | 法律合规收益 |
|---|---|---|
| Robots 协议检查 | 内置 urllib.robotparser 模块,调度器分配请求前自动拦截 Disallow 路径 |
表明遵循行业公认准则,主观上无恶意侵入意图 |
| 身份透明化 | 在 User-Agent 显式包含爬虫名称与合法联系邮箱或主页 |
便于目标站运维识别并联系,避免被误判为恶意网络攻击 |
| 强制自适应限流 | 单域名请求间隔不小于 1~3 秒,遇 429 Too Many Requests 自动翻倍休眠 |
绝对避免因流量冲击导致目标服务宕机,防范破坏计算机系统风险 |
| 数据脱敏与去重 | 在存储管道执行身份证、手机号正则脱敏,仅持久化业务必需字段 | 严格遵循《个人信息保护法》最小必要原则,消除侵犯隐私风险 |
| 熔断与异常监控 | 当连续出现 5 次 HTTP 403/500 时立刻自动暂停任务并向管理员发送告警 | 防止爬虫死循环重试加重对方负担,降低双方对抗升级风险 |
六、结语
开发一款优秀的爬虫软件,不仅是对网络通信、队列算法与并发编程的综合考验,更是一场对开发者法律意识与工程道德的检验。通过清晰解耦的调度架构、稳健的重试限速机制以及严格的合规自律,我们才能在充分挖掘网络数据价值的同时,确保软件与系统的长治久安。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









