

为什么Python多线程无法利用多核CPU?GIL机制解析
深入解析CPython全局解释器锁(GIL)的工作原理,解释为什么Python多线程在CPU密集型任务下无法利用多核处理器,对比多线程与多进程、I/O密集型与计算密集型差异,并提供突破GIL限制的实用架构方案与Python 3.13+自由线程新特性。
一、现象剖析:多核时代的“单核执行”假象
当开发者在现代多核计算机上使用 threading 模块创建多个工作线程执行大规模数学运算、图像像素处理或密码学哈希时,往往会观察到一个反常现象:开启 4 个或 8 个工作线程后,程序的总执行耗时不仅没有缩短到原来的四分之一或八分之一,甚至比单个线程按顺序执行还要慢上数成。
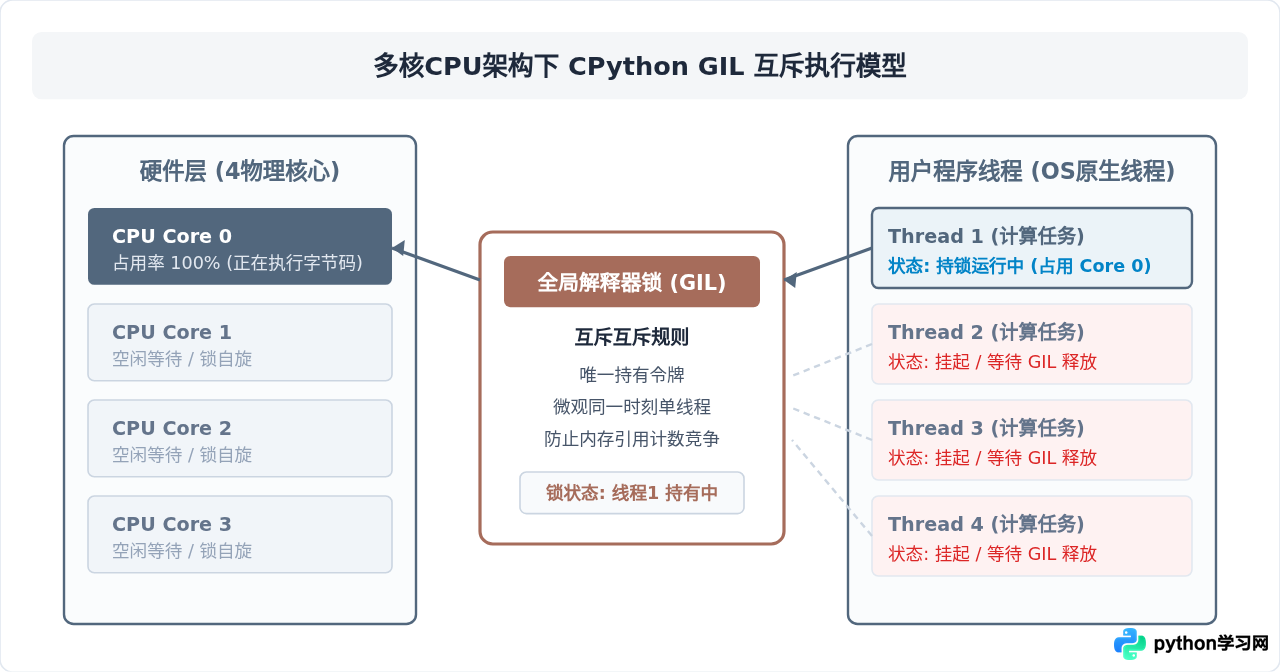
打开操作系统的系统监视器,可以观察到所有 CPU 核心的整体占用率呈现断续震荡,或者各核心在轮流被占用,总 CPU 利用率难以超过单核 100% 的上限。这种现象的根源并非操作系统线程调度机制失效,而是 CPython 解释器内部核心并发约束规则——GIL 的作用所致。
二、GIL 的本质与诞生原因
GIL 全称为 Global Interpreter Lock(全局解释器锁),它是 CPython 解释器实现层面上的一种全局互斥锁(Mutex)。需要特别明确的是,GIL 是 CPython 解释器的实现细节,而非 Python 语言本身的规范要求。诸如 Jython(基于 JVM)或 IronPython(基于 .NET)等其他实现并不存在 GIL。
1. 为什么当初要设计 GIL?
GIL 产生于 1990 年代初期,其主要驱动力源于 CPython 的内存管理模型:
-
保护引用计数(Reference Counting):CPython 依靠每个对象头部的
ob_refcnt字段实现基础垃圾回收。每当对象被赋值、传递给函数时计数加 1,脱离作用域时计数减 1。如果在多线程中不加控制地修改引用计数,哪怕执行一条简单的a = b都会引发脏写或内存泄漏,甚至提前释放有效内存导致解释器崩溃(Crash)。 - 细粒度锁(Fine-grained Locks)的高昂代价:若不对整个解释器加全局锁,就必须为每一个内置对象(如字典、列表、元组、数值)单独配置互斥锁。然而,高密度的加锁和解锁操作会在单线程执行时造成巨大的 CPU 开销,并且容易造成极其复杂的死锁陷阱。
- 简化 C 语言扩展开发:Python 早期之所以能迅速吸引生态,很大程度得益于其能极其方便地调用 C 语言编写的第三方类库。GIL 为 C 扩展提供了天然的线程安全保证,扩展开发者无需繁琐地管理线程并发状态即可安全访问 Python 对象。
三、GIL 的调度切换与时间片机制
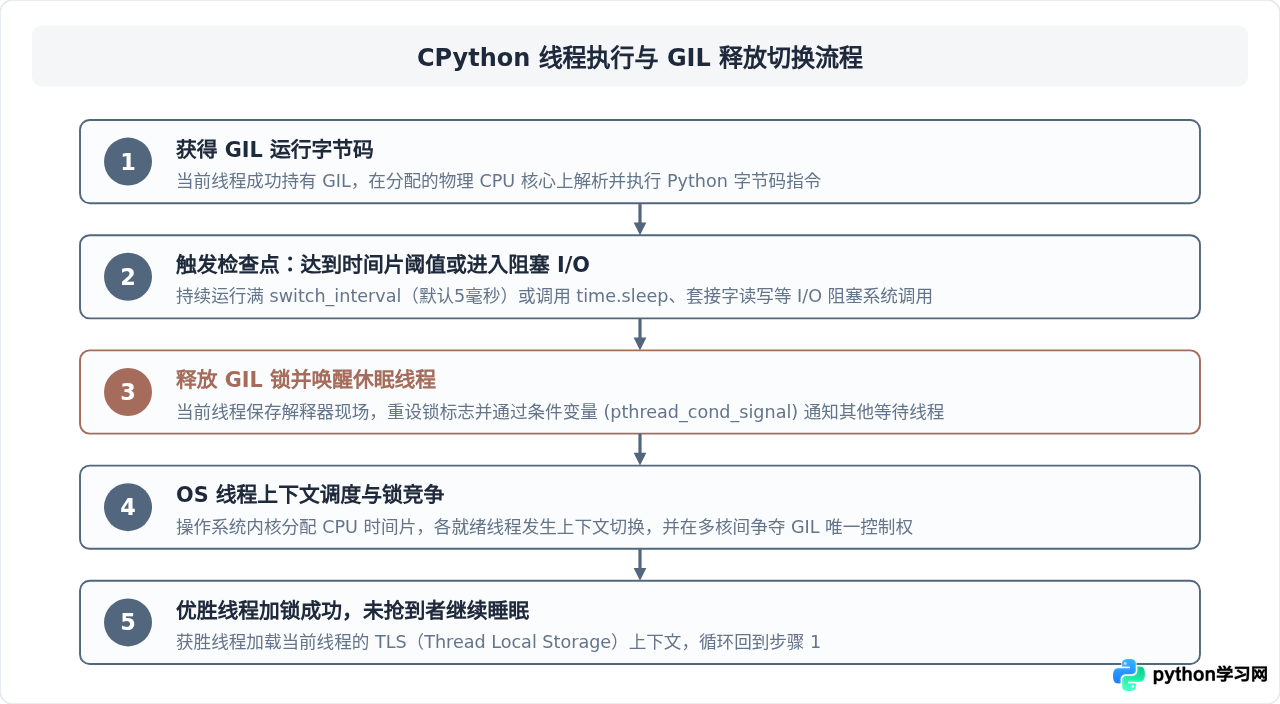
虽然 GIL 限制了同一时刻只能有一个线程执行,但如果一个线程获取了锁就永远不放手,程序就会退化为完全无法并发执行的饥饿状态。因此,CPython 内部实现了一套抢占式调度切换逻辑。
在 Python 3.2 之后,解释器重写了 GIL 的实现机制(由 Antoine Pitrou 重新设计),废弃了旧版“执行 100 条字节码指令即切换”的模式,改用了基于固定时间间隔的时间片调度机制。
可以通过 Python 的标准库 sys 查看与修改该时间间隔:
import sys

# 获取当前切换时间间隔(默认通常为 0.005 秒,即 5 毫秒)
current_interval = sys.getswitchinterval()
print(f"当前 GIL 切换间隔: {current_interval} 秒")

# 如果需要,可以修改切换间隔
sys.setswitchinterval(0.002) # 设置为 2 毫秒在单核 CPU 上,线程在时间片用完后释放 GIL 并等待操作系统调度,流程平稳;而在多核 CPU 上,当线程 A 运行在 Core 0 释放 GIL 的刹那,操作系统可能正调度线程 B 准备在 Core 1 运行。然而由于锁尚未完全完成状态广播,或者线程 A 在释放后又立刻重新发起申请,线程 A 往往比 Core 1 上的线程 B 更快重新抢到 GIL。这导致跨核心的线程频繁陷入“唤醒-抢锁失败-重入睡眠”的高开销无效震荡中,这正是多核多线程在 Python 计算密集型任务中比单核更慢的技术元凶。
四、任务类型对比:CPU 密集型 vs I/O 密集型
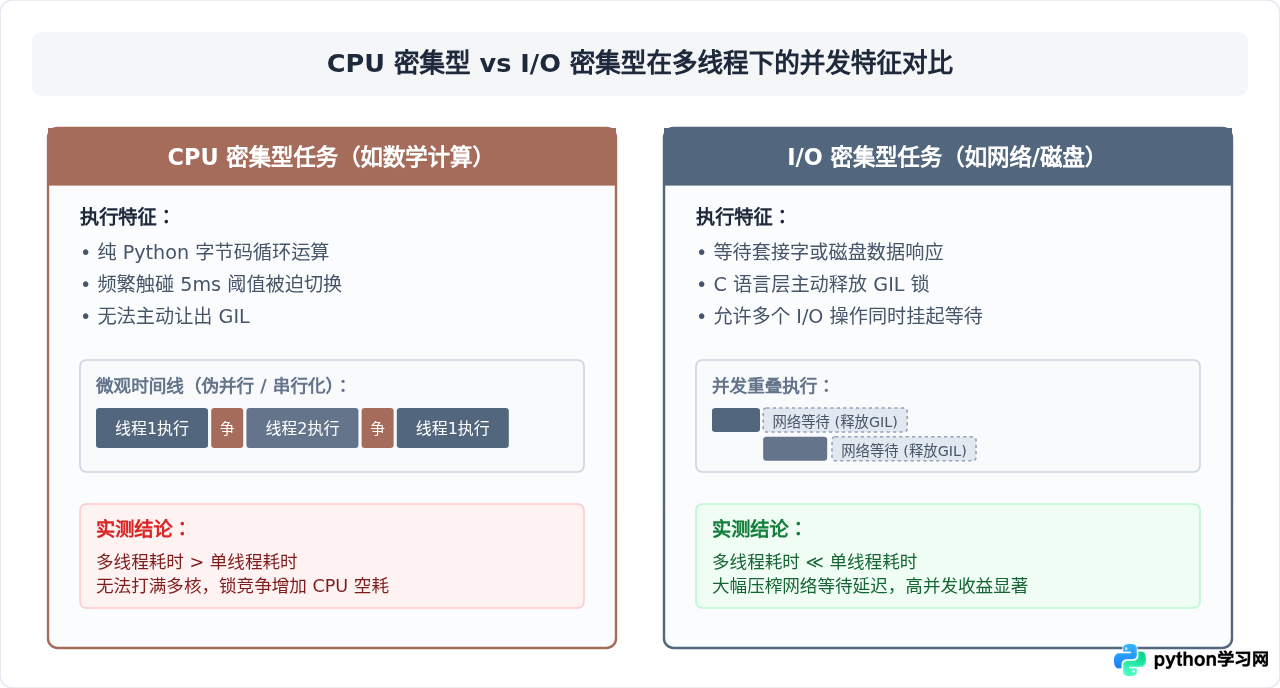
GIL 并不意味着 Python 多线程一无是处。理解 GIL 的影响,必须严格区分两类根本不同的计算负载:
- CPU 密集型(计算密集型):程序需要大量占用 CPU 进行数值运算、加解密、序列化或复杂对象推导。在此类任务中,线程永远在拼命争取 CPU 执行权,因此受到 GIL 的严密限制,多线程不仅无法提升速度,反受上下文切换损耗。
-
I/O 密集型:程序耗时主要集中在等待外部响应,如 HTTP 接口请求、数据库读写、文件落盘或系统
sleep。在执行底层系统级 I/O 操作时,CPython 会主动调用Py_BEGIN_ALLOW_THREADS宏释放 GIL,等待返回时再通过Py_END_ALLOW_THREADS重新获取锁。在此期间,其他线程可以畅通无阻地持有 GIL 执行运算。因此,Python 多线程在 I/O 密集型任务中表现优异且切实有效。
实测验证代码:计算密集型多线程对比单线程
下面是一段标准的基准测试脚本,直观展现多线程在计算密集型任务中受 GIL 制约的真实性能:
import time
from threading import Thread

# 模拟纯 CPU 密集型任务:大循环数值递减
def countdown(n: int):
    while n > 0:
        n -= 1

COUNT = 50_000_000

# 1. 单线程顺序执行两次 COUNT
start_time = time.perf_counter()
countdown(COUNT)
countdown(COUNT)
single_duration = time.perf_counter() - start_time
print(f"单线程串行执行 2 次耗时: {single_duration:.3f} 秒")

# 2. 两个线程并发执行两次 COUNT
t1 = Thread(target=countdown, args=(COUNT,))
t2 = Thread(target=countdown, args=(COUNT,))

start_time = time.perf_counter()
t1.start()
t2.start()
t1.join()
t2.join()
multi_duration = time.perf_counter() - start_time
print(f"双线程并发执行 2 次耗时: {multi_duration:.3f} 秒")
典型终端示例输出(测试于 8 核 x86_64 CPU 环境):
单线程串行执行 2 次耗时: 2.842 秒
双线程并发执行 2 次耗时: 3.105 秒
从示例结果可见,双线程非但没有提速,反而因频繁的 GIL 争抢与上下文开销,多耗费了近 10% 的时间。
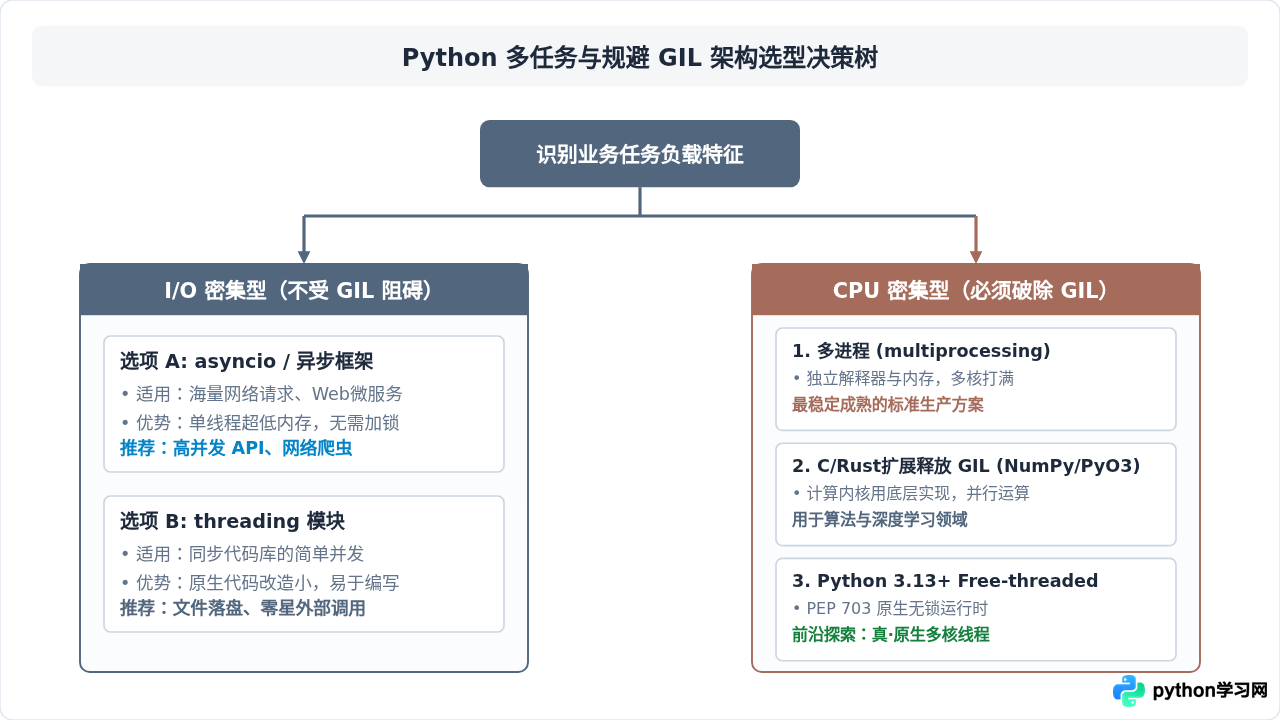
五、突破 GIL 限制的四大工程解决方案
在实际生产环境中,当需要处理高吞吐、高算力的业务逻辑时,工程师通常采取以下方案突破或规避 GIL 的性能壁垒:
方案 1:采用多进程架构(multiprocessing)
这是 Python 标准库最直接、最推荐的解法。由于每个操作系统进程都拥有独立内存空间和独立的 CPython 解释器实例,因此每个进程都有一个属于自己的 GIL,互不干扰,从而能够毫无保留地打满所有物理 CPU 核心。
from concurrent.futures import ProcessPoolExecutor
import time

def compute_heavy_task(n: int) -> int:
    total = 0
    for i in range(n):
        total += i * i
    return total

if __name__ == "__main__":
    tasks = [20_000_000] * 4
    start_time = time.perf_counter()

    # 启用多进程池,打满 4 个 CPU 核心
    with ProcessPoolExecutor(max_workers=4) as executor:
        results = list(executor.map(compute_heavy_task, tasks))

    print(f"多进程并发执行总耗时: {time.perf_counter() - start_time:.3f} 秒")
方案 2:将计算密集环节下沉至 C/C++ 或 Rust 扩展
NumPy、SciPy、TensorFlow、PyTorch 等高性能科学计算库虽然提供 Python 接口,但底层矩阵运算全部在 C/C++ 或 Fortran 中完成。在调用底层高效运算循环时,这些库会在 C 语言层面主动释放 GIL,从而实现利用 OpenMP 或原生线程池的多核并行加速。使用 Rust 的 PyO3 或 Cython 编写自定义模块时,同样可以显式释放 GIL:
# Cython 语法示例:利用 nogil 关键字解除 GIL 限制
def parallel_calc(double[:] array):
    cdef int i, n = array.shape[0]
    with nogil:
        # 在此代码块内,GIL 被完全释放,允许被多线程同时进入并行执行
        for i in range(n):
            array[i] = array[i] * 2.0
方案 3:I/O 密集型采用 asyncio 异步单线程
对于大量网络爬虫、Web 接口调度、微服务请求转发等 I/O 密集型场景,不需要多线程的锁复杂度和上下文开销,通过 asyncio 事件循环机制,单线程单进程即可维持数万并发连接。
方案 4:CPython 3.13+ 的 Free-threaded(自由线程/无锁化)新时代
Python 社区历经数十年的努力,在 Python 3.13 正式引入了 PEP 703(Making the Global Interpreter Lock Optional in CPython)。用户可以安装并编译开启了自由线程模式(Free-threaded)的 Python 解释器。该版本通过 Mimalloc 分配器、偏向引用计数(Biased Reference Counting)和延迟引用计数(Deferred Reference Counting)技术,彻底移除了全局 GIL,实现了 Python 原生线程直接在多核 CPU 上真并行运行。
六、总结与关键实践指南
| 并发方式 | 能否突破 GIL 限制 | 适用业务场景 | 内存与通信开销 |
|---|---|---|---|
| threading 多线程 | 否(同一瞬间仅单核) | I/O 密集型、网络爬虫、文件读取 | 内存共享极快,开销小 |
| multiprocessing 多进程 | 是(独立解释器多核打满) | CPU 密集型、离线批量计算、图像处理 | 进程独立,需跨进程序列化(IPC) |
| asyncio 异步协程 | 否(单线程单核) | 超高并发网络 I/O、微服务网关 | 内存消耗极低,无上下文切换成本 |
| C/Rust 扩展(nogil) | 是(释放 GIL 由原生层分发) | 数值矩阵运算、密码学哈希、音视频编解码 | 运行极快,开发调试成本较高 |
| Python 3.13+ Free-threaded | 是(解释器内部移除 GIL) | 未来原生多核并行标准 | 依赖三方库 C 扩展适配无锁模式 |
归纳而言,Python 多线程之所以无法直接利用多核 CPU,本质是 CPython 解释器在历史演进中为了保障引用计数内存安全和 C 扩展易用性而采取的全局互斥策略。在开发过程中,不要盲目使用多线程提升纯计算性能;遇到多核算力瓶颈时,优先使用 multiprocessing 或底层经过 GIL 优化的高性能科学计算库,方能最大限度释放现代多核处理器的澎湃算力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









