

Python操作数据库选ORM还是原生SQL?SQLAlchemy与PyMySQL对比
深入对比Python数据库访问的两种核心方式:ORM代表SQLAlchemy与原生SQL驱动PyMySQL。从架构原理、开发效率、执行性能、复杂查询及安全性等多维度全面剖析,并提供选型决策依据。
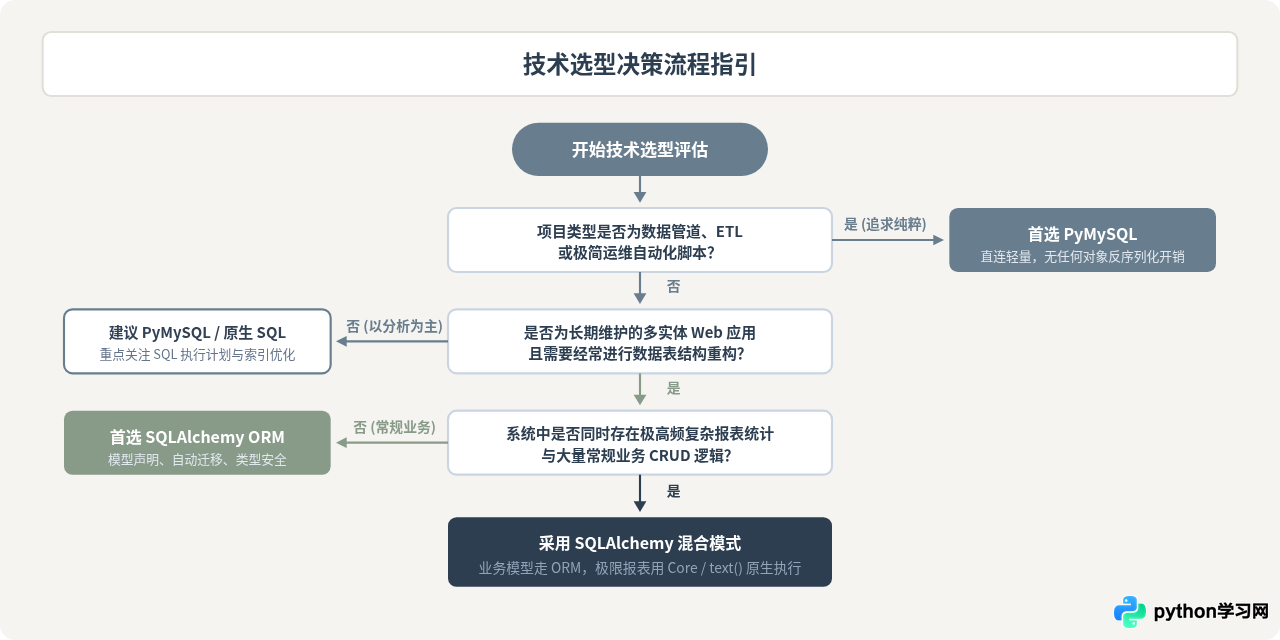
在 Python 开发中,数据库操作技术选型的核心并非在“先进”与“原始”之间二选一,而是在“工程维护效率”与“底层透明控制力”之间权衡。如果你的系统业务模型复杂、以业务逻辑 CRUD 为主,且团队需要强类型提示和敏捷重构,以 SQLAlchemy 为代表的 ORM 是更优解;若项目属于数据管道、离线批处理、对极致响应延迟敏感,或者依赖 DBA 严格审核调优的复杂原生 SQL,基于 PyMySQL 的轻量级原生执行则更具优势。
一、两种数据库交互范式的本质差异
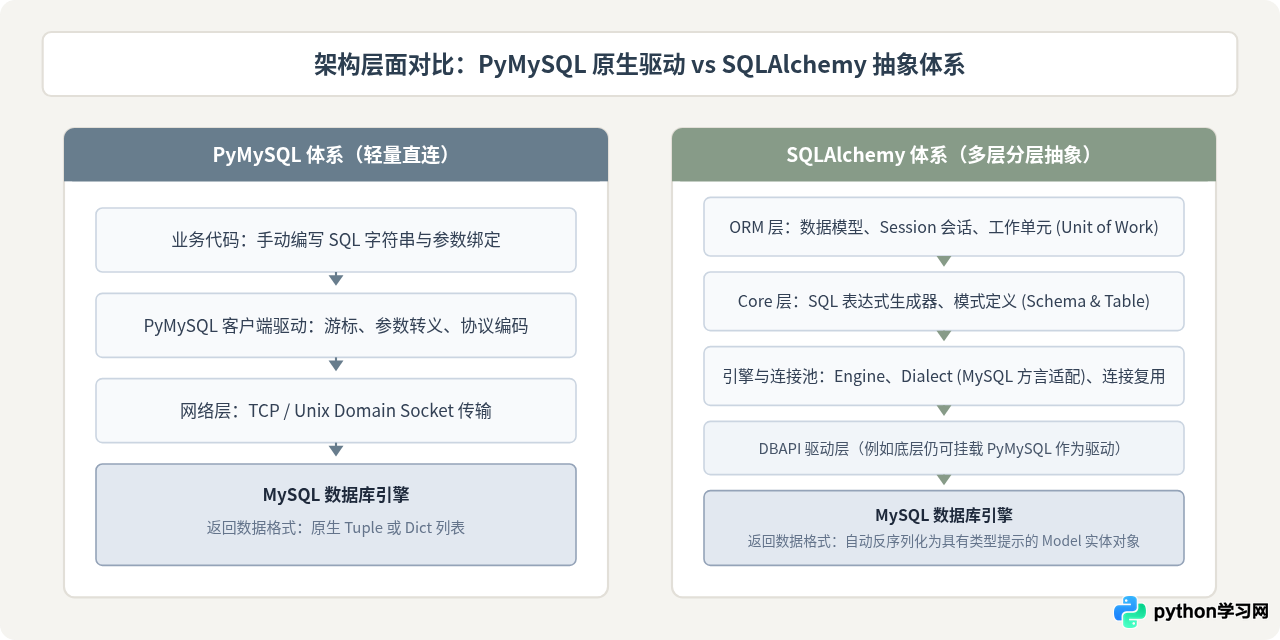
要做出合理的选型,首先需要看清两者在软件架构中所处的层级与设计初衷。PyMySQL 是一个纯 Python 实现的 MySQL 客户端驱动,它忠实于 MySQL 的通信协议与 DBAPI(PEP 249)标准;而 SQLAlchemy 则是一套分层的数据库工具集,包含底层的 SQL 表达式语言(Core)与上层的对象关系映射(ORM)。
使用 PyMySQL 时,开发者的视角聚焦于数据表结构与 SQL 文本:编写 SQL 字符串、将参数交由驱动转义、通过游标向数据库发送请求,最后获取原生元组或字典结构的行记录。开发者对每一次发送到底层的 SQL 语句拥有完全控制权,但同时也必须承担手动管理字段拼写、数据类型转换以及对象装配的繁琐工作。
SQLAlchemy ORM 则引入了面向对象的抽象概念。在 ORM 范式下,数据表被映射为 Python 数据模型类,数据行被映射为类的实例,外键关联被映射为对象引用。开发者通过操作对象属性来表达数据变更,SQLAlchemy 负责将这些对象行为编译成针对目标数据库方言(Dialect)的合法 SQL,并处理复杂的数据映射与事务生命周期。
二、关键维度深度对比
1. 开发效率与长期维护性
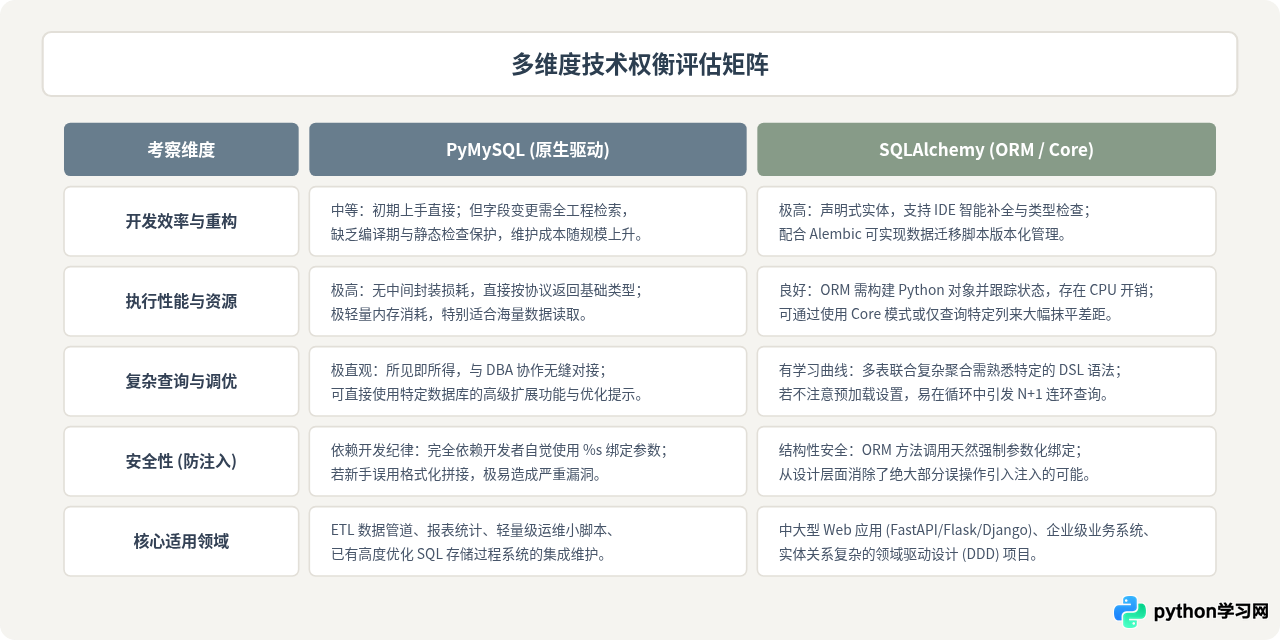
在业务不断迭代的开发过程中,数据库表结构变动是家常便饭。如果使用 PyMySQL,开发者需要在各个业务函数中手动维护散落各处的 SQL 字符串。一旦某个数据表字段重命名,IDE 无法进行自动化重构,开发者必须全局文本搜索并逐个核对 SQL 语句,稍有不慎就会在运行时引发异常。
SQLAlchemy 通过 Python 类的形式统一定义模型,结合现代 IDE 的类型推导与静态检查工具(如 Mypy、Pylance),能够为字段访问、类型匹配提供直接的代码补全。配合 Alembic 等迁移工具,表结构的变更可以自动生成迁移脚本并纳入版本控制,显著提升了团队协作和复杂项目维护的安全性。
2. 执行性能与计算开销
在执行基准测试时,PyMySQL 在吞吐量和内存占用上通常优于 SQLAlchemy ORM。这是因为 ORM 层在接收到数据库返回的原生数据后,需要将数据字典实例化为 Python 类对象,并建立对象状态追踪(Dirty Tracking 与 Identity Map)。
这种对象反序列化和状态机维护会消耗额外的 CPU 时间和内存。对于单次返回成千上万行记录的场景,ORM 的对象构建耗时可能会占到整个请求处理周期的相当比例。但在常见的单行主键查询、小批量写入等 Web API 典型场景中,瓶颈通常在于网络 I/O 与数据库索引效率,ORM 带来的几毫秒级 CPU 损耗往往处于可接受范围。
3. 复杂 SQL 与底层调优控制力
当业务进入需要精细化性能调优的阶段时,原生 SQL 展现出极高的透明度。在 PyMySQL 中,开发者直接通过 EXPLAIN 分析执行计划,随时增加强制索引提示(Index Hint)、编写高度定制的 CTE(通用表表达式)或窗口函数,调试与优化过程非常直接。
在 ORM 中编写复杂的子查询、跨多表多条件的联合聚合时,开发者必须学习 ORM 的特定 DSL 语法。有时为了让 ORM 生成一条预期的 SQL,需要绕过大量默认行为,甚至可能因为使用不当导致臭名昭著的“N+1 查询问题”(即查询主表后为每条记录单独发起子表查询)。虽然 SQLAlchemy 提供了 joinedload 和 selectinload 等贪婪加载策略来解决此问题,但前提是开发者必须深入理解其底层原理。
三、代码实操对照:同等场景下的两套实现
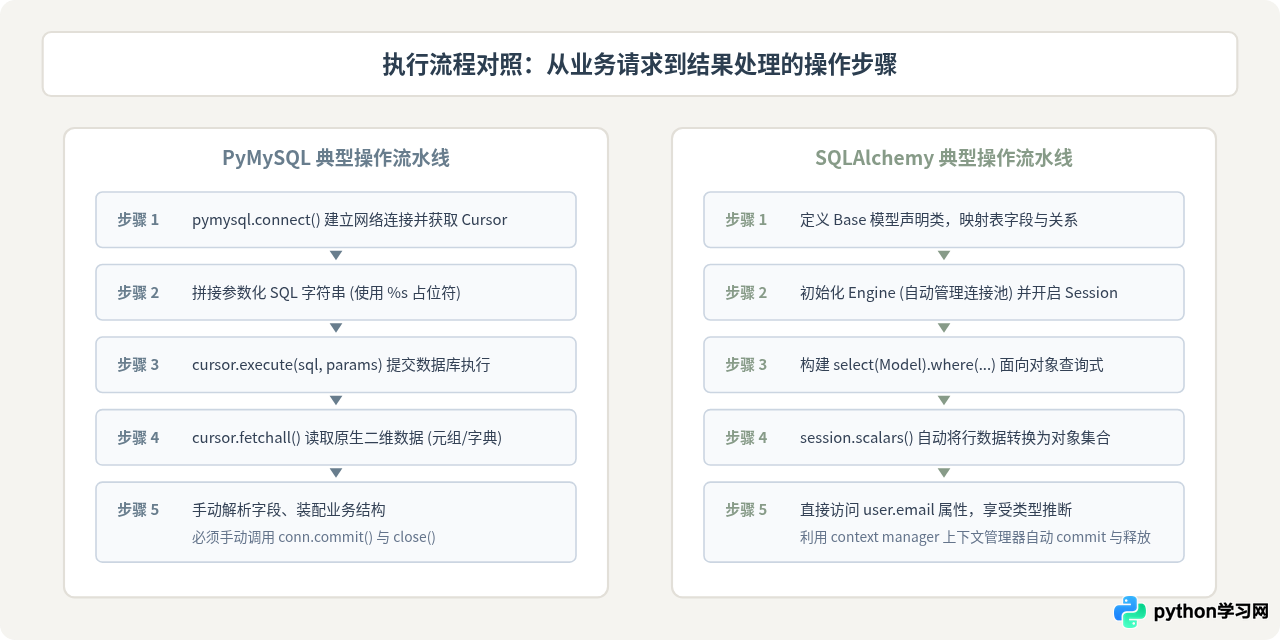
为了直观对比两者的使用体验,我们以一个具体的场景为例:向 users 表插入一条新用户记录,随后根据邮箱查询用户并打印其昵称。数据库表包含字段 id、username、email 与 created_at。
1. PyMySQL 实现方式
在 PyMySQL 中,我们使用连接上下文管理器,通过参数化方式执行 SQL:
import pymysql
from pymysql.cursors import DictCursor

# 1. 建立数据库连接
connection = pymysql.connect(
    host="127.0.0.1",
    user="db_user",
    password="db_password",
    database="test_db",
    charset="utf8mb4",
    cursorclass=DictCursor,
    autocommit=False
)

try:
    with connection.cursor() as cursor:
        # 2. 插入新记录(注意:使用 %s 占位符传参,杜绝字符串拼接)
        insert_sql = "INSERT INTO users (username, email) VALUES (%s, %s)"
        cursor.execute(insert_sql, ("zhangsan", "zhangsan@example.com"))

    # 提交事务
    connection.commit()

    with connection.cursor() as cursor:
        # 3. 根据邮箱条件查询
        query_sql = "SELECT id, username, email FROM users WHERE email = %s"
        cursor.execute(query_sql, ("zhangsan@example.com",))
        user_row = cursor.fetchone()

        # 4. 手动从字典提取字段
        if user_row:
            print(f"用户ID: {user_row['id']}, 昵称: {user_row['username']}")
finally:
    connection.close()
注意事项:在 PyMySQL 中必须严格使用 %s 占位符配合参数元组传递外部变量,切勿使用 Python 的 f-string 或 % 进行字符串拼接,否则会直接引入严重的 SQL 注入风险。
2. SQLAlchemy (2.0+) 现代实现方式
在现代 SQLAlchemy 2.0 中,推荐使用类型注解与 Mapped 语法,配合上下文管理器与 Session 执行查询:
from datetime import datetime
from sqlalchemy import create_engine, select, String, DateTime
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

# 1. 定义声明式基类与数据模型
class Base(DeclarativeBase):
    pass

class User(Base):
    __tablename__ = "users"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(String(50), nullable=False)
    email: Mapped[str] = mapped_column(String(100), unique=True, nullable=False)
    created_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.utcnow)

# 2. 创建 Engine(内置连接池管理)
engine = create_engine("mysql+pymysql://db_user:db_password@127.0.0.1/test_db?charset=utf8mb4", echo=False)

# 3. 通过 Session 进行业务写入与查询
with Session(engine) as session:
    # 创建对象实例
    new_user = User(username="lisi", email="lisi@example.com")
    session.add(new_user)
    session.commit()

    # 构建强类型查询
    stmt = select(User).where(User.email == "lisi@example.com")
    user = session.scalars(stmt).first()

    # 直接访问属性,拥有完全的类型提示
    if user:
        print(f"用户ID: {user.id}, 昵称: {user.username}")
四、具体业务场景下的选型决策依据
在实际团队的技术选型中,不能孤立地比较两者的跑分数据,而应根据项目的生命周期、团队结构以及核心性能瓶颈来决定:
1. 优先选择 SQLAlchemy 的场景
- 业务逻辑复杂的 Web 应用:例如电商、CRM 或内容管理后台。在这类系统中,实体之间的关系错综复杂(一对多、多对多),频繁需要按对象导航关联数据。SQLAlchemy 的声明式关系和工作单元能大幅减少样板代码。
- 需要统一数据库版本演进的团队项目:团队成员较多、需求频繁变更时,配合 Alembic 进行数据表迁移,可以杜绝因缺少某个字段导致的上线事故。
- 潜在的多数据库支持需求:如果软件未来可能需要在 PostgreSQL、MySQL、SQLite 或 SQL Server 之间切换,SQLAlchemy 的方言隔离层能够确保核心代码无需重写。
2. 优先选择 PyMySQL 的场景
- 大数据量提取与离线分析脚本:例如定时任务从数据库导出数百万行数据写入 Parquet 或 CSV。此时无需实例化庞大的 Python 模型对象,PyMySQL 原生返回的字典或元组能让内存消耗降低数倍。
- 独立轻量化脚本或微小运维工具:不需要引入复杂的第三方大库,只希望依赖尽可能精炼的组件完成简单的一两句数据查询。
- SQL 调优由专职 DBA 强力主导的环境:有些团队要求所有线上生产 SQL 必须经过专门的审核平台和 DBA 手动优化,直接使用原生 SQL 字符串能让开发与调优人员使用完全相同的语言沟通。
3. 架构折中方案:混合双模使用
事实上,选型并非必须非黑即白。SQLAlchemy 本身是一个高度分层的框架。在实际生产架构中,完全可以采用“ORM 处理日常业务实体 + Core/原生 SQL 处理高频重载查询”的混合模式:
from sqlalchemy import text

# 在同一个 SQLAlchemy 会话或连接中直接执行原生优化后的 SQL
with engine.connect() as conn:
    sql = text("SELECT dept_id, AVG(salary) as avg_sal FROM employees GROUP BY dept_id HAVING avg_sal > :threshold")
    result = conn.execute(sql, {"threshold": 10000})
    for row in result:
        print(row.dept_id, row.avg_sal)
这种做法既保留了 SQLAlchemy 自带的高性能连接池和事务管理能力,又在需要执行极其复杂的聚合报表时享有原生 SQL 的灵活与直观。
五、总结
在 Python 数据库选型的实践中,SQLAlchemy 与 PyMySQL 并不是彼此替代的对立关系。PyMySQL 提供了扎实、透明、零冗余的底层通信通道;而 SQLAlchemy 则在数据库协议之上构建了现代工程化开发所需的基础设施——从连接池、事务抽象,到类型提示与数据迁移。
理解两者的分工边界后,技术选型便水到渠成:以长期维护、模型演进为核心诉求的团队项目应优先拥抱 SQLAlchemy;而以数据吞吐、简单直接或极限定制为诉求的脚本与任务,则可果断采用 PyMySQL。合理结合两者的长处,才能在开发效率与系统性能之间找到最佳平衡点。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









