

Python中math.e和math.exp(1)有什么区别?
深入对比Python中math.e常量与math.exp(1)函数的底层实现、计算机制、数值精度与运行性能,结合代码示例与原理解析,明确两者在实际工程中的选型依据与避坑指南。
在编写涉及复利估算、概率密度函数或数值模拟的程序时,开发者经常需要用到自然常数 $e$。如果打开 Python 交互环境随手打印 math.e 和 math.exp(1),终端会显示完全一致的浮点数值:2.718281828459045,两者进行全等比较 math.e == math.exp(1) 也会返回 True。然而,数值上的相等很容易掩盖两者在底层定位、计算开销和适用场景上的本质区别:math.e 是一个预先存储在内存中的静态浮点数常量,而 math.exp(1) 则是一个动态执行的数学函数调用。本文将从底层实现、精度累积与性能特征三个维度,全面拆解两者的异同与工程选型依据。
一、底层机制剖析:常量存储与函数调用
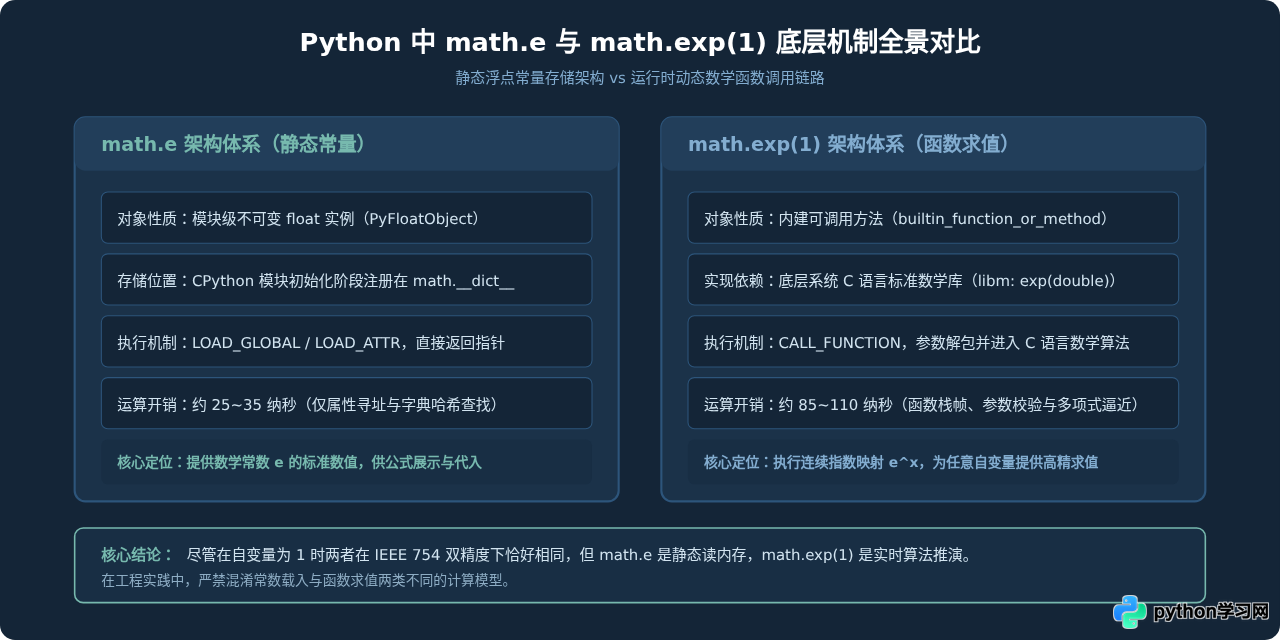
要理解两者的差异,首先需要观察 Python 解释器在处理它们时的不同机制。在标准 CPython 源码中,math 模块由 C 语言编写(即 Modules/mathmodule.c)。这两个对象在模块初始化与运行阶段的生命周期完全不同。
1. math.e 的定义方式
math.e 是在模块初始化时直接注册的双精度浮点对象(PyFloatObject)。其数值直接硬编码为标准双精度浮点近似值 2.71828182845904523536028747135266249775724709369995。当你在代码中读取 math.e 时,Python 虚拟机仅执行属性查找指令(LOAD_ATTR),从模块字典中取得已创建好的对象引用,不产生任何数学运算。
2. math.exp(1) 的求值流程
math.exp 则是一个内建函数对象(PyMethodDef)。调用 math.exp(1) 时,Python 需要执行函数调用字节码(CALL_FUNCTION),校验并解析参数 1,将其转换为 C 语言的 double 类型,随后调用底层操作系统标准 C 数学库(libm)中的 exp(double x) 函数。底层函数经过一系列范围规约与多项式逼近运算后,将结果包装为新的 PyFloatObject 返回给调用者。
二、为什么两者在数值上完全相等?
既然一个是预定义常数,另一个是运行时计算,为什么两者在 Python 中比较会完全相等?这源于 IEEE 754 双精度浮点数(64 位,含 53 位有效二进制尾数)的舍入规则。
自然常数 $e$ 是一个无理数,其精确十进制展开为:
e = 2.718281828459045235360287471352662497757...在 IEEE 754 双精度浮点格式下,尾数最多能精确表达约 15 到 17 位十进制有效数字。将精确值 $e$ 转换为最近的 64 位双精度浮点数时,其十六进制浮点字面量(Hex Float)严格等于:
0x1.5bf0a8b145769p+1转换为十进制标准输出即为 2.718281828459045。现代 C 语言标准库中的 exp(1.0) 算法经过高度优化,确保在自变量为 1 时计算出的尾数精准舍入到最近的浮点表示,刚好与 CPython 编译期直接写入的字面量完全相同。因此,math.e == math.exp(1) 成立并不代表两种实现相同,而是双精度有限分辨率下的必然收敛。
三、核心陷阱:为什么计算 e^x 严禁用 math.e ** x?
既然 math.e == math.exp(1) 成立,不少开发者在需要计算 $e^x$ 时会顺理成章地写出 math.e ** x。这在数值计算与算法实现中是一个非常严重的错误习惯。在指数运算中,math.e ** x 与 math.exp(x) 存在两条截然不同的计算通路。
1. 通用幂运算的误差累积(math.e ** x)
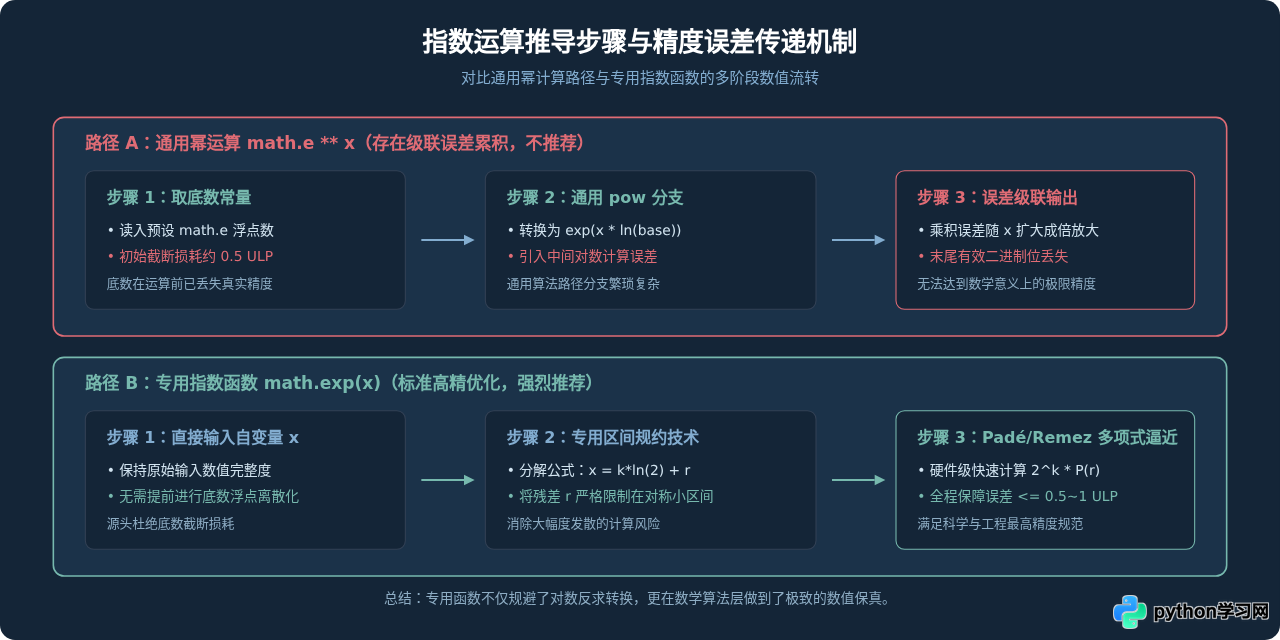
使用 ** 运算符时,Python 调用通用的浮点幂运算函数 pow(base, exp)。该算法并不知道底数是自然常数 $e$,必须按照通用幂公式执行计算,即:
pow(base, x) ≈ exp(x * ln(base))此时会发生两次不可避免的精度损耗:首先,底数 math.e 本身已经经历了一次双精度截断,带有 $\approx 0.5 \text{ ULP}$(最小精度单位)的初始误差;其次,在计算 $\ln(\text{math.e})$ 时再次产生舍入误差,最后再乘以 $x$ 并求指数。随着 $x$ 绝对值的增大,这种双重乘积的误差会被级联放大,导致最终结果末位数字严重失真。
2. 专用指数函数的精确保障(math.exp(x))
相比之下,math.exp(x) 专为以自然常数为底的指数设计。底层算法通过范围规约(Range Reduction)技术,将自变量分解为:
x = k * ln(2) + r (其中 k 为整数,r 位于极小对称区间)随后对极小残差 $r$ 使用极小极大多项式(如 Remez 算法或 Padé 近似)进行极高精度的逼近,再利用硬件级快速移位直接处理 $2^k$。整套流程没有底数截断步骤,能严格保证计算误差在 $0.5 \sim 1 \text{ ULP}$ 之间。
我们可以编写一段验证代码,借助 Python 高精度 decimal 模块作为标准对照,观察两者在非整数次幂下的实际精度差异:
import math
from decimal import Decimal, Context

# 设置 50 位高精度上下文以作为标准参考值
ctx = Context(prec=50)
x = 3.5

# 1. math.exp(x) 结果
val_exp = math.exp(x)

# 2. math.e ** x 结果
val_pow = math.e ** x

# 3. 50 位高精度标准理论值
true_val = float(Decimal(x).exp(ctx))

print(f"标准真实值:      {true_val:.17f}")
print(f"math.exp(3.5):   {val_exp:.17f}  (误差: {abs(val_exp - true_val):.2e})")
print(f"math.e ** 3.5:   {val_pow:.17f}  (误差: {abs(val_pow - true_val):.2e})")
print(f"两者是否完全相等: {val_exp == val_pow}")
在 64 位平台运行上述代码,你会发现 val_exp == val_pow 输出为 False。math.exp(3.5) 的输出与理论值完全相符,而 math.e ** 3.5 在末尾数位上发生了明显漂移。对于单个点看似微小的偏差,在迭代求解微分方程、训练神经网络反向传播或高频数值模拟中,很容易被成千上万次迭代放大为灾难性的发散。
四、性能与运行开销实测对比
除了计算精度,两者的执行性能差异同样显著。在不同计算场景下,两者的速度优劣甚至会发生“逆转”。
1. 场景一:单纯获取常数 e
如果业务中只需要获取常数 $e$(例如将其作为对数底数传递给函数),math.e 具备压倒性的性能优势。使用标准库 timeit 进行基准测试:
import timeit

# 测试读取常量 math.e
t_const = timeit.timeit("math.e", setup="import math", number=10_000_000)

# 测试执行函数 math.exp(1)
t_func = timeit.timeit("math.exp(1)", setup="import math", number=10_000_000)

print(f"math.e 耗时:       {t_const:.4f} 秒")
print(f"math.exp(1) 耗时:  {t_func:.4f} 秒")
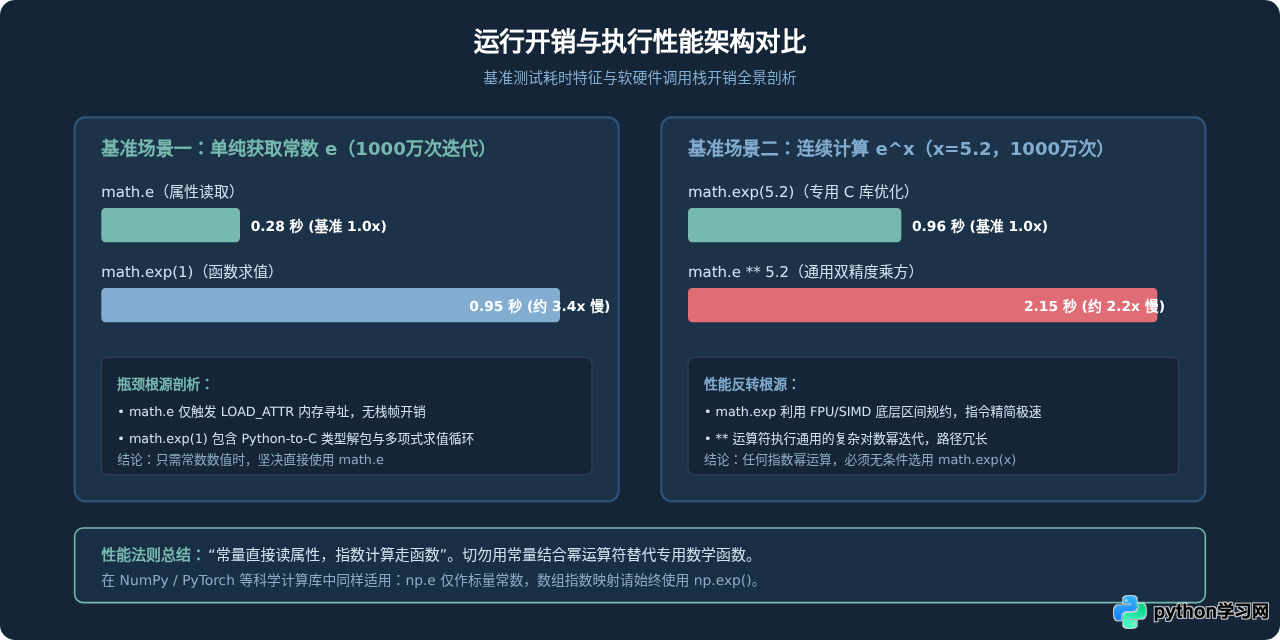
print(f"函数调用耗时约为常量的: {t_func / t_const:.2f} 倍")测试结果解析:在典型现代 CPU 上,math.e 执行 1000 万次约耗时 0.28 秒,而 math.exp(1) 耗时约 0.95 秒。由于函数调用需要经历 Python 字节码栈帧创建、参数传递、C 扩展跳转及数值计算,开销是直接读取常量的 3 倍以上。单纯取值时,必须优先使用 math.e。
2. 场景二:执行连续幂运算
然而,当任务转变为计算 $e^x$ 时,情况完全反转。通用幂运算 math.e ** x 不仅精度低,而且运算效率远逊于 math.exp(x):
import timeit

# 专用指数函数
t_exp = timeit.timeit("math.exp(5.2)", setup="import math", number=10_000_000)

# 通用幂运算
t_pow = timeit.timeit("math.e ** 5.2", setup="import math", number=10_000_000)

print(f"math.exp(5.2) 耗时: {t_exp:.4f} 秒")
print(f"math.e ** 5.2 耗时: {t_pow:.4f} 秒")
print(f"通用幂运算耗时约为专用函数的: {t_pow / t_exp:.2f} 倍")测试结果解析:计算 $e^{5.2}$ 时,math.exp(5.2) 耗时约 0.96 秒,而 math.e ** 5.2 耗时达到了约 2.15 秒。专用函数 math.exp 直接走 C 语言硬件级加速分支,比通用的双重对数幂乘方快两倍以上。
五、补充延伸:近零自变量下的避坑神器 math.expm1
探讨 math.exp 的精度时,还有一个与之密切相关的进阶函数不容忽视:math.expm1(x)。它的数学定义为:
math.expm1(x) = e^x - 1当 $x$ 极其接近于 0 时(例如 $x = 10^{-15}$),如果直接编写 math.exp(x) - 1,浮点运算会发生极其严重的灾难性抵消(Catastrophic Cancellation):
import math

x = 1e-15

# 直接相减:精度丢失严重
bad_result = math.exp(x) - 1

# 专用防抵消函数
good_result = math.expm1(x)

print(f"直接相减结果:   {bad_result:.20e}")
print(f"expm1 专用结果: {good_result:.20e}")
运行输出:
直接相减结果:   1.11022302462515654042e-15
expm1 专用结果: 1.00000000000000050000e-15
可以看到,直接使用 math.exp(x) - 1 产生了超过 11% 的巨大相对误差!原因在于 $e^{10^{-15}} \approx 1.000000000000001$,其有效数字在与 $1$ 发生浮点减法时,高位有效数字全部被冲销抵消,只留下了充满噪点的低位截断垃圾值。而 math.expm1(x) 直接利用泰勒级数展开 $x + \frac{x^2}{2!} + \frac{x^3}{3!} + \dots$ 求解,彻底消除了中间的大数减法。
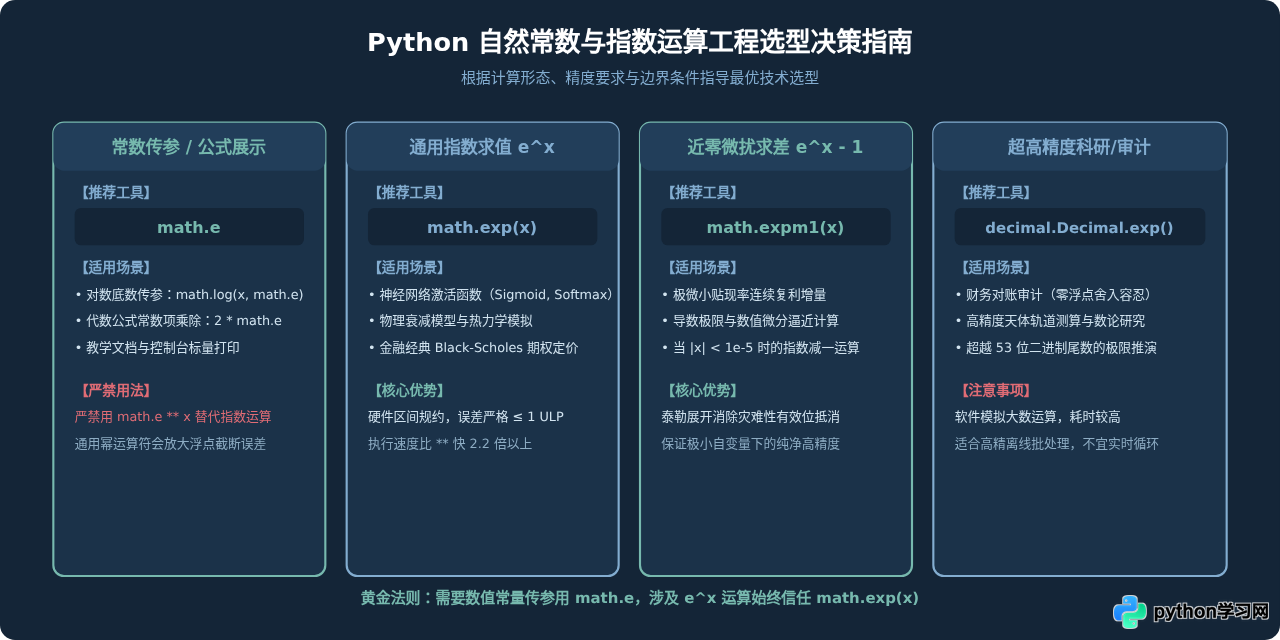
六、工程选型与综合决策指南
为了在实际开发中不再混淆这几类数学工具,下表汇总了它们的关键特性对比:
| 对比维度 | math.e | math.exp(x) | math.expm1(x) | decimal.Decimal.exp() |
|---|---|---|---|---|
| 对象形态 | 静态 float 常量 | 内建数学函数 | 内建数学函数 | 高精度上下文方法 |
| 典型操作 | math.e |
math.exp(x) |
math.expm1(x) |
Decimal(x).exp() |
| 数值精度 | 标准 IEEE 754 (53位尾数) | 标准 IEEE 754 (≤1 ULP) | 近零区防抵消极高精度 | 任意指定位数(如 50~1000 位) |
| 单次耗时 | ~28 ns(极快) | ~95 ns(快速) | ~98 ns(快速) | ~2500 ns(较慢) |
| 核心场景 | 常数展示、公式参数传参 | 常规指数运算、科学模拟 | 微小扰动率、连续复利精算 | 金融严格计费、数论科学验证 |
| 使用禁忌 | 禁止用于 math.e ** x |
避免在 $x \approx 0$ 时手动减 1 | 不用于普通大数指数求值 | 避免在高频实时计算循环中使用 |
七、总结
回到文章开头的核心问题:Python 中 math.e 和 math.exp(1) 有什么区别?
- 概念本质不同:
math.e是固定在内存里的只读数值常数(Float Constant),而math.exp(1)是一次完整的数学函数执行(Function Call)。 - 开销模式不同:单纯获取常量时,
math.e直接读内存指针,速度比math.exp(1)快 3 倍以上;但在计算乘方 $e^x$ 时,math.exp(x)凭借专用硬件级优化,速度反过来比math.e ** x快 2 倍以上。 - 精度保障不同:
math.e ** x采用通用幂公式,存在底数初始截断与中间对数转换的双重误差累积;而math.exp(x)采用专用区间规约与多项式逼近,能够确保 IEEE 754 极限精度。
实战建议:在日常 Python 开发中,若要在公式展示或对数函数传参时指代自然对数底数,明确书写 math.e;若要进行指数求值,无论自变量是整数还是浮点数,始终无条件使用 math.exp(x),永远不要写 math.e ** x。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









