

为什么Python集合查找比列表快?底层哈希表与数组机制解析
深入解析Python中集合查找效率远高于列表的底层实现,对比连续指针数组与开放寻址哈希表的存储结构、查找时间复杂度以及内存权衡。
在 Python 开发中,使用 item in container 判断元素是否存在是最基础也是最频繁的操作之一。当数据规模从几十条增长到几十万条时,测试会展现出一个巨大的性能鸿沟:在包含 100,000 个元素的列表中查找一个末尾元素通常需要数毫秒,而在相同规模的集合(set)中查找仅需数十纳秒,性能差距可达数万倍。这种差距并不是编译器偶然的微优化,而是由底层数据结构决定的本质差异——列表基于连续内存的动态数组,查找依赖逐项遍历比较;而集合基于开放寻址的哈希表,查找直接通过哈希计算实现常数时间寻址。
一、内存组织方式的根本差异
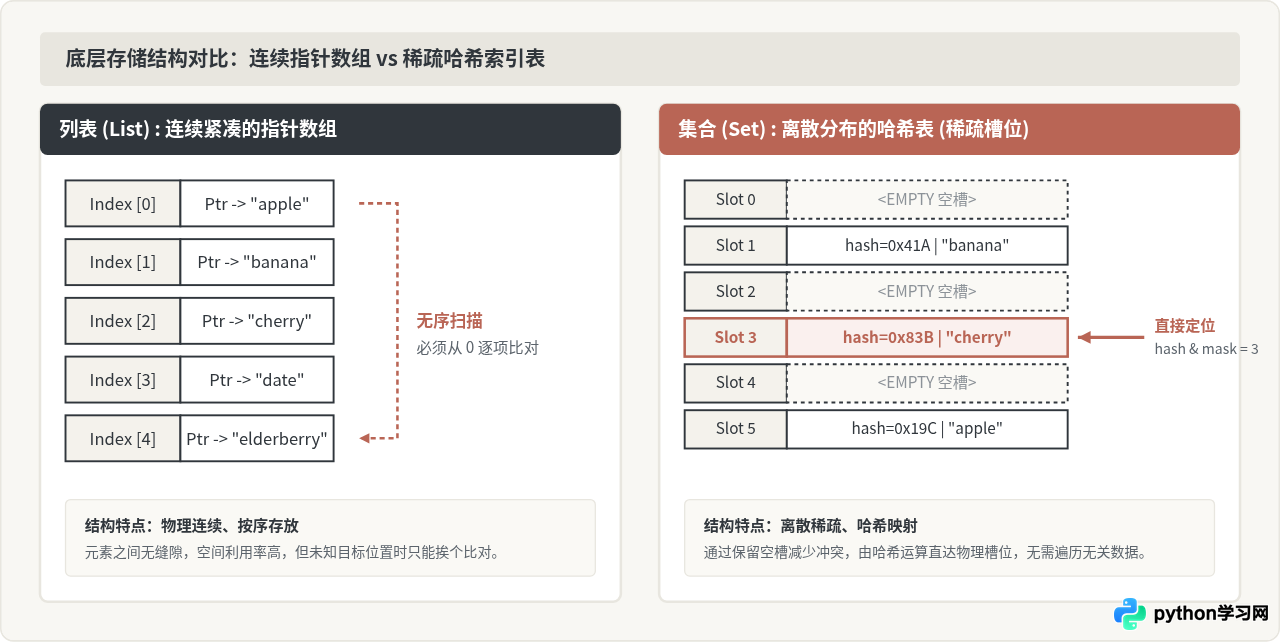
要理解查找效率的高低,首先要看数据在物理内存中是如何排列的。在 CPython 解释器实现中,列表与集合代表了两种截然不同的内存设计哲学:紧凑型线性排列与稀疏型哈希映射。
Python 中的列表对应底层结构体 PyListObject。它维护着一个指向连续内存块的双重指针 PyObject** ob_item。这意味着列表内部紧密排列着每一个元素的内存地址。当列表存储了 n 个元素时,底层的指针数组就精确保存这 n 个连续指针,中间没有空隙。这种结构对内存利用非常紧凑,但由于元素在列表中的存储位置完全取决于插入顺序或索引位置,值与存放地址之间没有任何逻辑映射关系。
相比之下,Python 中的集合对应 PySetObject,其底层是一张哈希表。哈希表本质上是一个按“槽位(bucket/entry)”分配的离散数组。为了避免冲突,集合申请的槽位数量始终明显大于实际存储的元素数量,时刻维持着相当比例的空槽(Empty Slots)。元素在集合中放置在哪个槽位,完全由该元素自身的哈希值决定,而不是由添加顺序决定。
二、列表查找机制:从头到尾的线性扫描
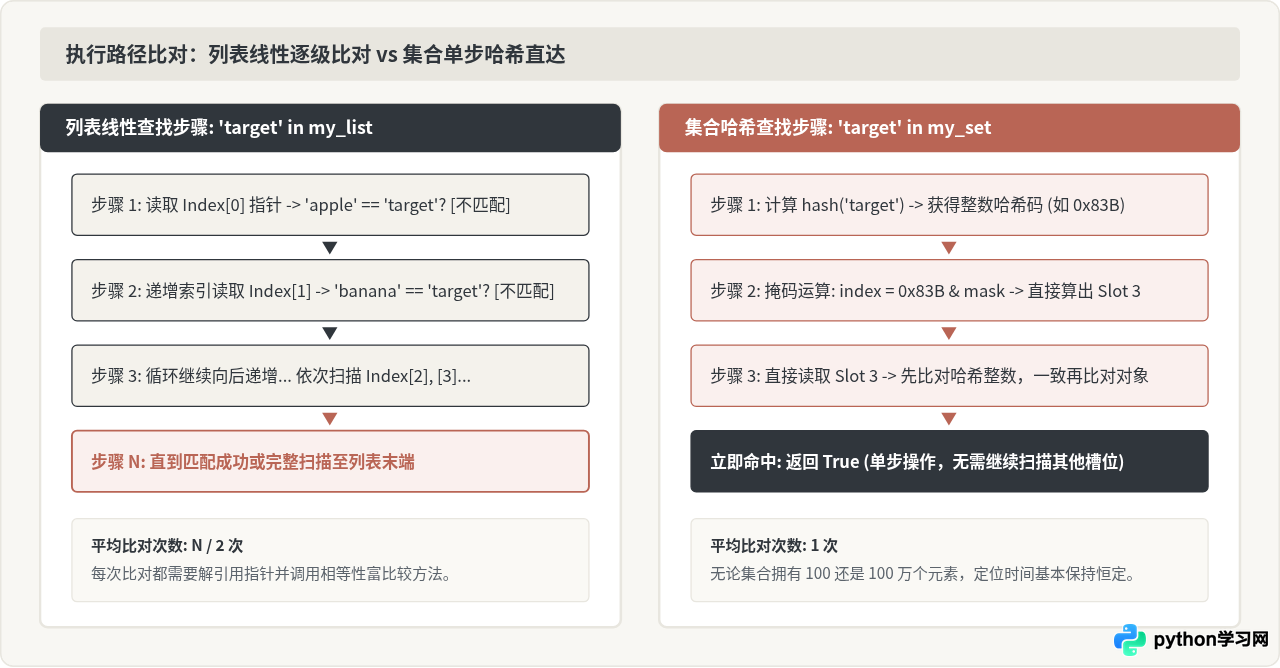
在 Python 中对列表执行 target in my_list 时,CPython 内部会调用 list_contains 函数。该函数的核心逻辑非常直观:它持有一个从索引 0 开始的循环计数器,依次读取指针数组中每个索引对应的对象,然后调用富比较函数(PyObject_RichCompareBool)判断当前对象是否与 target 相等。
这个匹配过程具有以下明确的机制特性:
- 逐项比对:如果目标元素碰巧在索引
0,循环在第 1 次判断后即可提前终止,此时耗时最小;但如果目标元素位于列表末尾,或者列表中根本不存在该元素,解释器必须完整检查所有n个元素。 - 双重开销:每一次比较不仅需要一次指针解引用寻址,还需要调用目标类型的相等性判断逻辑(即执行
__eq__方法)。如果元素是复杂对象,多次调用方法还会产生额外的函数调用开销。 - 时间复杂度:列表查找的最佳时间复杂度是 $O(1)$,最坏时间复杂度是 $O(n)$,平均时间复杂度同样是 $O(n)$。在包含 $n$ 个元素的列表中,平均需要进行约 $n / 2$ 次比较。
通过以下极简代码可以清晰观察到列表查找随数据量线性增长的现象:
import timeit

# 分别准备 1 万与 100 万元素的列表
small_list = list(range(10_000))
large_list = list(range(1,000,000))

# 查找不存在的元素(触发最坏情况下的全量线性扫描)
t_small = timeit.timeit(lambda: -1 in small_list, number=1000)
t_large = timeit.timeit(lambda: -1 in large_list, number=1000)

print(f"1万元素耗时: {t_small:.4f}s")    # 例如: 0.12s
print(f"100万元素耗时: {t_large:.4f}s")  # 例如: 12.15s (约增长100倍)
数据量扩大 100 倍,查找耗时就精确扩大约 100 倍,这正是典型 $O(n)$ 线性增长的外部表现。
三、集合查找机制:基于哈希函数的常数级定位
集合能够跳过漫长的逐个遍历过程,核心在于它引入了哈希函数与模数掩码映射。当我们在集合中执行 target in my_set 时,CPython 执行的是 set_contains,其查找流程被高度固化为三个明确的步骤:
- 计算哈希值:解释器首先调用目标对象的
__hash__()函数,将其转化为一个固定长度的整数(64位系统上为64位有符号整数)。对于基础不可变类型(如整数、浮点数、字符串、元组),哈希计算速度极快。 - 掩码定位槽位:哈希表当前的槽位总容量始终保持为 2 的幂次方(例如 8, 16, 64, 1024...)。解释器通过按位与运算
slot_index = hash_value & mask(其中mask = capacity - 1),在数个 CPU 周期内直接计算出该元素理论上应该存放的槽位索引。 - 槽位验证与命中:直接读取该槽位。若槽位标记为
EMPTY,说明集合中绝不可能包含该元素,立即返回False;若槽位有数据,解释器首先比对槽位记录的hash整数值(整数比对仅需单条机器指令),若整数相同再进一步调用对象的__eq__进行最终确认。确认一致后直接返回True。
四、哈希冲突与开放寻址探测机制
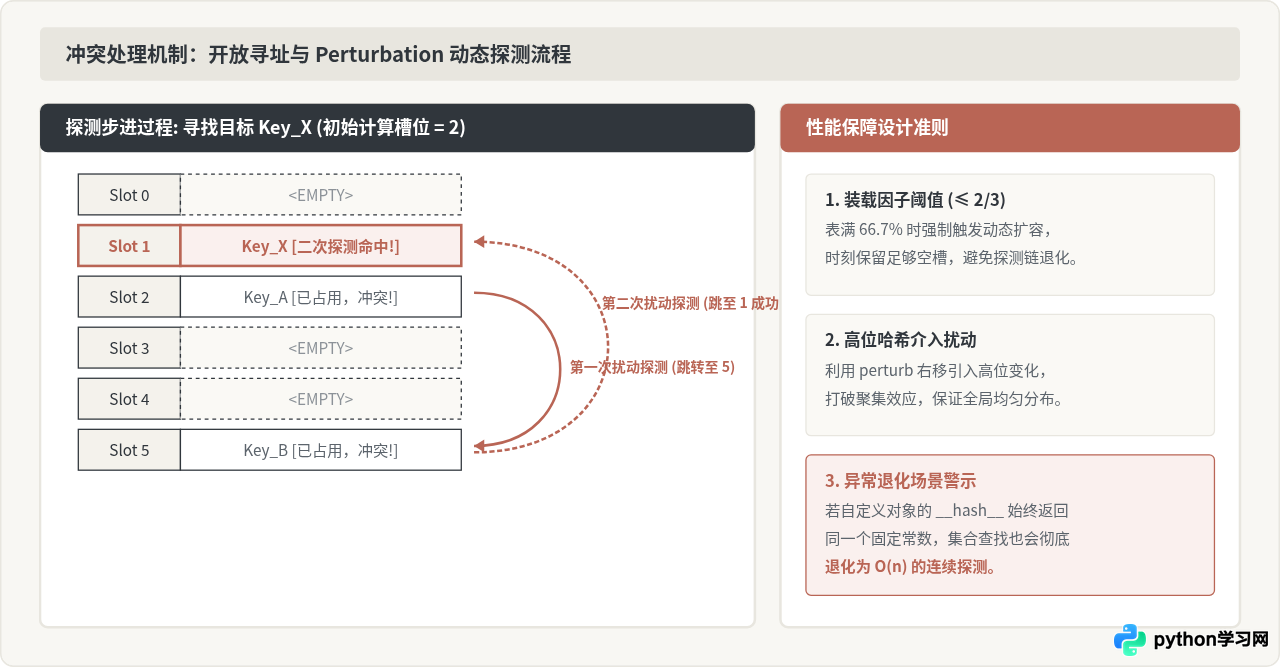
在讨论集合的高性能时,一个无法回避的底层问题是:哈希冲突(Hash Collision)。对象的哈希值理论上分布在广阔的整数空间内,但集合底层数组的槽位数量是有限的(例如 8 个或 16 个槽位)。当两个不同对象的哈希码经由 hash & mask 映射到同一个槽位索引时,冲突就发生了。
许多编程语言(如 Java 的 HashMap 早期实现)采用拉链法(Separate Chaining)处理冲突,即槽位本身挂载一个链表。但 CPython 团队出于内存利用与缓存友好的考虑,为集合与字典选择了开放寻址法(Open Addressing)。拉链法需要在堆上频繁为链表节点分配零散内存,这会破坏 CPU 缓存行(Cache Line)局部性;开放寻址法让所有数据都集中在一个连续的数组缓冲区内,对现代 CPU 缓存预取极其友好。
1. 探测序列与扰动算法(Perturbation)
当目标槽位已被其他不同键值占用时,CPython 不会采用简单的线性步长探测(如 i+1, i+2),因为简单的线性探测极易产生“初级聚集”(Primary Clustering),导致大量元素堆积在某几个连续区域。CPython 设计了一套精巧的伪随机探测算法:
// CPython setobject.c 中的冲突探测核心思想
perturb = hash;
i = (hash & mask);

while (entry[i] 不为空 且 键值不匹配) {
    i = (5 * i + 1 + perturb) & mask;
    perturb >>= 5;
}
这套公式有两个极为精妙的数学特性:
- 完全覆盖性:线性同余公式
5*i + 1保证了当表容量为 2 的幂时,探测链能够不重复地完整遍历表中的每一个槽位,绝对不会陷入死循环。 - 高位扰动介入:初始时掩码
mask只截取了哈希值的低几位,高位信息被丢弃了;而变量perturb >>= 5在每次冲突后把高位哈希逐步移入探测计算中,使得即便低位相同的两个对象,其后续探测轨迹也会迅速分道扬镳,彻底打破局部聚集。
2. 装载因子与动态扩容控制
如果哈希表被填得太满,空槽稀少,探测链必然变长,集合查找就会从 $O(1)$ 退化为线性探测。为了彻底杜绝这一问题,CPython 严格控制集合的装载因子(Load Factor)不超过 2/3(约 66.7%)。
一旦已占用的槽位达到总容量的 2/3,集合就会在添加元素时触发扩容:在规模较小时扩容至原容量的 4 倍,规模较大时扩容至 2 倍。扩容后会申请一块全新的、更大的内存区域,并将原有元素全部重新映射到新表中。通过严格维持至少 1/3 的空槽缓冲,CPython 保证了绝大多数查找在 1 到 2 次内存访问内必然结束。
五、为什么集合不能完全取代列表?代价与适用边界
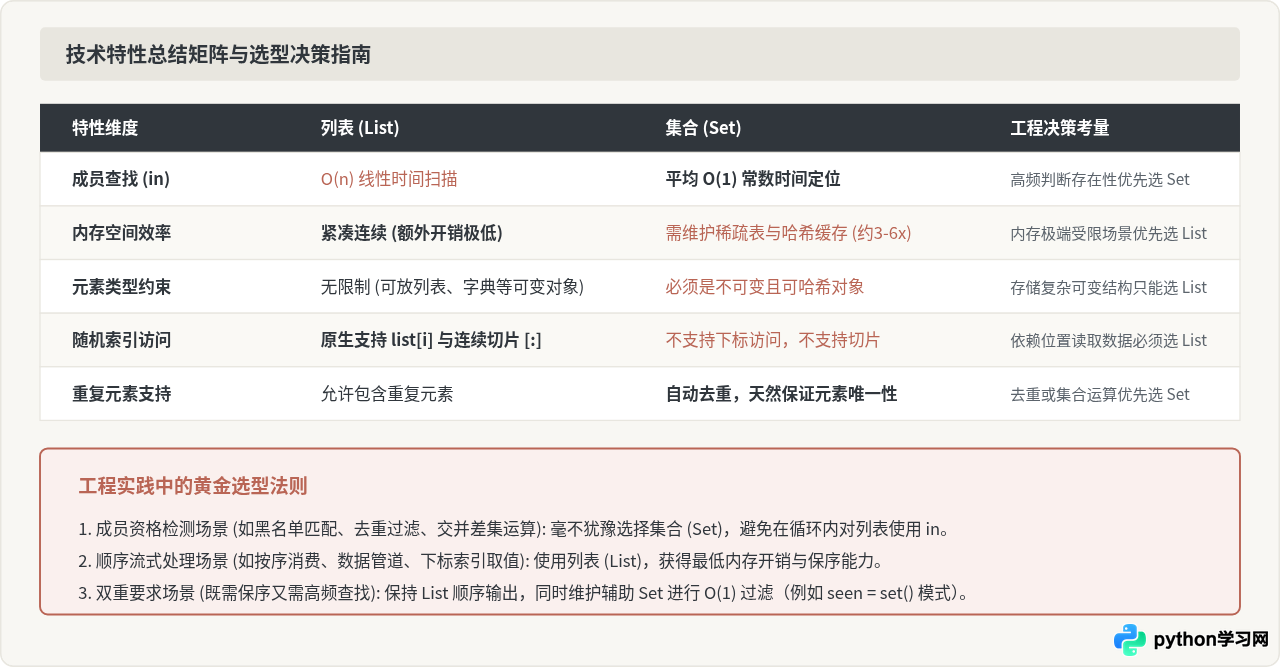
既然集合在查找上具备压倒性的常数级效率,为什么 Python 中使用最广泛的基础容器仍然是列表?计算机体系结构中始终贯穿着“时空权衡”(Time-Memory Tradeoff)原则,集合的超高查找性能是以特定的功能限制与资源代价换来的。
1. 显著的内存空间开销
列表的数据结构高度致密,除了少量的对象头与几个预留指针槽位外,内存消耗几乎全部用于存放有效元素的指针。而集合为了维持低于 2/3 的装载因子并减少探测冲突,必须时刻维持大量空槽;同时,每个集合槽位(Entry)不仅要存储键对象的指针,还要完整记录一份 64 位的哈希整数缓存。在相同元素数量下,集合占用的物理内存通常是列表的 3 到 6 倍。
2. 元素的可哈希(Hashable)限制
放入集合的所有元素都必须是可哈希的。在 Python 规范中,一个对象可哈希需要满足两点:其一是在其生命周期内拥有一个恒定不变的哈希值(实现 __hash__());其二是支持与其他对象比较相等性(实现 __eq__())。
因此,常见的可变对象(如 list、dict、set 本身)都无法作为集合的元素放入。如果在工程中需要维护嵌套结构或动态修改子对象,集合便无法直接满足需求,而列表可以容纳任何类型的 Python 对象。
3. 顺序保证与随机索引访问
列表是典型序列(Sequence),天生保留元素的插入次序,并支持通过下标直接进行 $O(1)$ 的随机访问(如 my_list[0]、my_list[-1])以及便捷的切片语法。虽然在现代 Python(Python 3.7+ 字典以及近版集合内部实现)中,哈希结构也具备了一定程度的插入顺序保留特性,但集合在概念设计上依然属于数学集合范畴,不支持通过下标提取元素,更无法进行切片操作。
六、总结
Python 集合查找之所以远快于列表,本质在于算法复杂度的降维打击。列表作为连续内存指针数组,无法在数据值与物理存放位置之间建立直接联系,在执行包含性检查时只能付出 $O(n)$ 的代价进行顺序扫描;而集合通过在底层实现基于开放寻址法的紧凑哈希表,利用哈希函数与位掩码直接将待查找元素映射到具体的内存槽位,再配合精巧的 Perturbation 探测与严格的装载因子控制,把绝大多数查询收敛在常数级 $O(1)$ 的单步操作内。
在实际编码中,建立对两者底层物理结构的认知,能够帮助我们在“时间效率”与“空间约束”之间做出理性权衡。当需要频繁进行包含性检查或去重时,将列表转换为集合是消除性能瓶颈最廉价也最有效的手段;而在强调顺序排列、需要随机索引或容纳可变对象的场景下,紧凑轻巧的列表依然是不可替代的基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









