

Python中.py源文件与.pyc字节码文件的区别
深入解析Python中.py源文件与.pyc字节码文件的区别。详细讲解二者的生成机制、执行流程、加载性能差异、__pycache__目录管理、版本校验原理以及日常开发与部署中的常见误区。
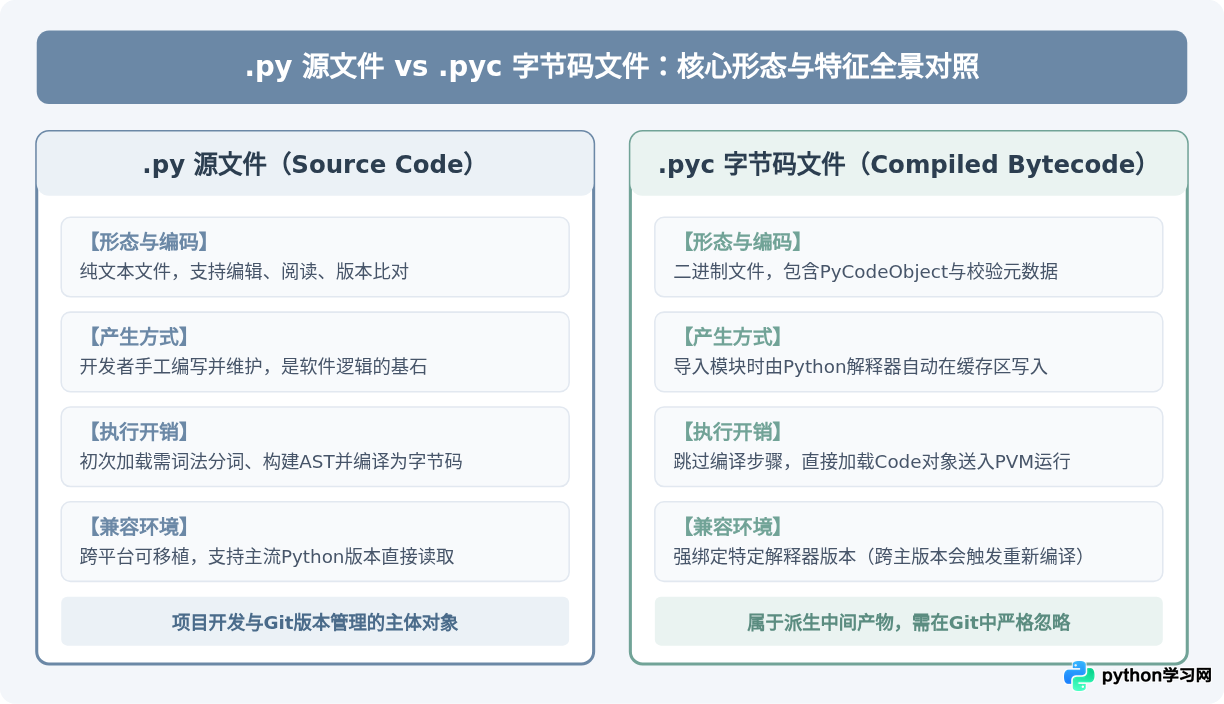
.py与.pyc代表了同一套程序代码在生命周期中的两种不同形态:.py是开发者编写的人类可读文本源码文件,而.pyc是Python解释器在导入模块时自动编译生成的平台无关二进制字节码(Bytecode)缓存文件。引入.pyc的核心目的是跳过后续运行时的词法与语法分析,从而大幅缩短模块加载和程序启动耗时,但在实际逻辑运算阶段两者性能完全一致。
一、核心维度对比:.py 与 .pyc 的关键差异
很多初学者容易将.pyc误解为类似C/C++编译生成的原生机器码(如.exe或.so),或者认为运行.pyc会让程序的实际计算速度翻倍。通过梳理二者在物理格式、生成时机、存储位置及执行性能上的表现,可以清晰界定它们的本质区别:
| 对比维度 | .py 源文件 | .pyc 字节码文件 |
|---|---|---|
| 文件本质 | UTF-8或自定义编码的人类可读纯文本文件 | Python内部虚拟机(PVM)可直接读取的二进制序列化数据 |
| 核心内容 | Python源码语法结构、注释与格式排版 | Magic Number(魔数)、时间戳/哈希值、Code Object(操作码指令集) |
| 产生时机 | 开发者手动编写或模板生成 | 模块被import导入时自动生成,或通过编译工具手动构建 |
| 存储路径 | 项目根目录或业务包目录下,与工程代码平铺 | 所在目录的__pycache__/子目录下,文件名带有解释器版本标识 |
| 启动性能 | 每次读取均需完整经历词法分析、语法解析与编译 | 直接读取反序列化,极大缩短模块导入加载耗时 |
| 运行性能 | 最终均转化为字节码由PVM执行,计算速度完全一致 | 与.py在进入虚拟机后的指令执行耗时完全相同,无二次加速 |
| 版本移植性 | 跨操作系统与Python主版本通用(语法兼容前提下) | 严格绑定生成该文件的特定Python大版本与实现(如CPython 3.11) |
二、运作机制:Python代码从文本到执行的生命周期
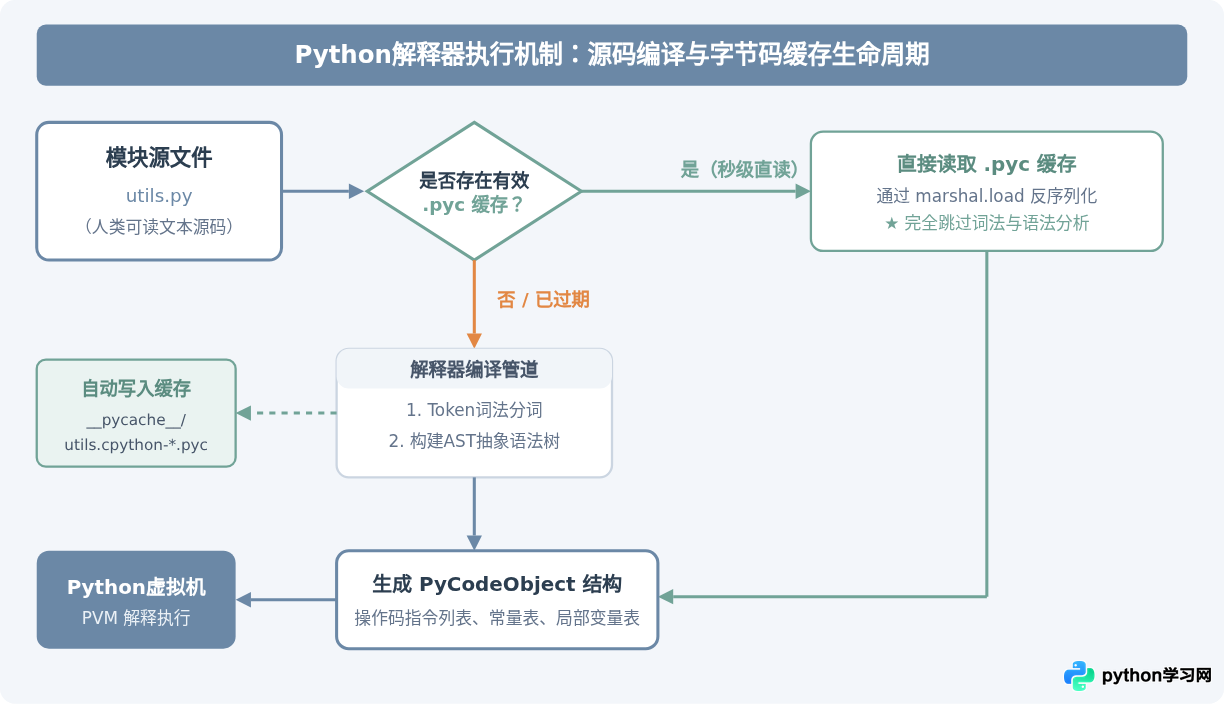
为了理解为什么会有.pyc的存在,我们需要看清CPython解释器运行代码时的完整流程。Python在执行程序时并不是逐行直接翻译纯文本,而是分为编译(Compilation)与虚拟机执行(Execution)两个阶段:
- 词法分析与语法树构建(Lexing & Parsing):解释器读取
.py文本,将源码字符流拆解为Token标记流,再根据Python语法规则生成抽象语法树(AST,Abstract Syntax Tree)。 - 生成字节码与Code对象(Code Object Generation):编译器将AST树转化为线性的操作码指令序列(Bytecode Instructions),并将函数、常量表、变量名等打包封装为一个
PyCodeObject结构体。 - 缓存与落盘策略(Caching):当该文件是被其他脚本通过
import导入时,Python会将生成的Code对象序列化(通过marshal模块),并连同当前时间戳或哈希值一起写入到__pycache__目录下的.pyc文件中。 - 虚拟机求值(PVM Execution):Python虚拟机(Python Virtual Machine)载入Code对象,自顶向下调度调用栈,循环读取操作码并执行对应的底层C函数。
当你直接在终端运行
python main.py 时,默认情况下当前目录下并不会产生 main.cpython-*.pyc。这是因为Python设计者认为顶层主脚本通常经常被开发者直接修改并立即执行,且顶层脚本只会加载一次;而通过 import 引入的第三方库或项目公共模块往往包含大量类和函数定义,且重复调用频繁,因此只为被导入的模块自动建立 .pyc 缓存。
三、操作实证:观察、主动生成与反编译 .pyc
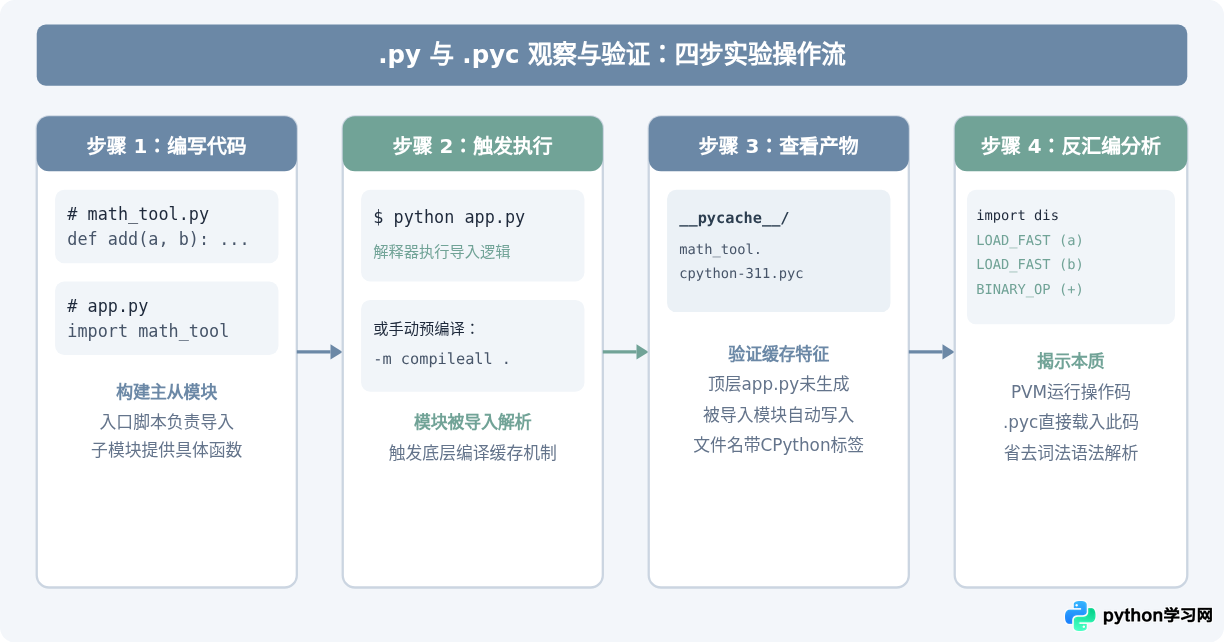
为了直观观察上述理论过程,我们可以通过以下具体步骤进行实验:
步骤 1:创建测试文件并观察自动生成的缓存
在任意测试目录下创建两个文件:被导入的运算模块 math_tool.py,以及调用该模块的入口文件 app.py。
# math_tool.py
def add(a, b):
    """返回两数之和"""
    return a + b
# app.py
import math_tool
result = math_tool.add(10, 20)
print(f"计算结果: {result}")在终端执行 python app.py,控制台将输出 计算结果: 30。此时列出当前目录的文件结构,你会发现自动多出了一个目录:
$ ls -R
.:
app.py  math_tool.py  __pycache__

./__pycache__:
math_tool.cpython-311.pyc观察可以发现:app.py 没有生成 .pyc,而被 import 引入的 math_tool.py 自动生成了 math_tool.cpython-311.pyc(其中 cpython-311 代表由 CPython 3.11 解释器编译)。
步骤 2:主动编译单个文件或整个工程
如果你需要在部署前显式预编译所有文件,无需手动运行代码触发导入,Python标准库提供了内置工具:
# 显式编译单个文件(包括顶层脚本)
python -m py_compile app.py

# 递归预编译当前目录下的所有 .py 文件
python -m compileall .
步骤 3:反汇编观察 Code Object 内部指令
.pyc 文件中存储的究竟是什么?使用标准库内置的 dis 模块可以直接反汇编该对象,查看虚拟机即将执行的操作码:
# 查看 math_tool.add 函数对应的字节码指令
import dis
import math_tool

dis.dis(math_tool.add)
终端示例输出如下:
  3           0 RESUME                   0
              2 LOAD_FAST                0 (a)
              4 LOAD_FAST                1 (b)
              6 BINARY_OP                0 (+)
             10 RETURN_VALUE
从输出中可以看到,无论最初是读取 .py 文本编译而来的字节码,还是直接从 .pyc 反序列化还原的字节码,交给虚拟机的都是 LOAD_FAST、BINARY_OP、RETURN_VALUE 这一串完全相同的操作指令。
四、进阶细节:.pyc 的版本校验与更新检测原理
既然 .pyc 是编译结果的缓存,如果开发者修改了 .py 源码,Python 如何感知并自动重新编译?如果直接把 Python 3.10 下生成的 .pyc 拷到 Python 3.12 机器上运行,会发生什么?
1. .pyc 的头部结构
每个 .pyc 文件的开头都包含一段定长的元数据头部(Header),以 CPython 3.7+ 为例,头部占据 16 个字节:
- 4字节 Magic Number(魔数):前 2 字节由 Python 核心团队分配,每当操作码(Opcode)发生调整或语法规则改变时递增;后 2 字节通常为
\r\n。如果当前解释器的魔数与文件魔数不匹配,解释器会直接认定该.pyc失效。 - 4字节 Bit Field(位字段):标识当前的校验模式(例如采用时间戳校验还是哈希校验)。
- 8字节 校验数据:
- 基于时间戳(默认模式):4 字节源文件修改时间戳(mtime)+ 4 字节源文件文件大小(size)。
- 基于哈希(Hash-based,PEP 552):存储源文件完整内容的 8 字节(截断)SHA-256 哈希值。
2. 更新校验机制
当 Python 准备载入 math_tool.pyc 时,会比对对应 math_tool.py 文件的修改时间与大小。一旦检测到源文件被编辑过(时间戳更新),解释器会果断舍弃过期的 .pyc,重新执行词法编译,并以原子写入的方式更新 .pyc 缓存。这保证了日常开发中即使开启缓存,也不会读到陈旧过时的代码。
五、工程实践与四大常见误区
在日常开发、Git协作与线上容器化部署中,围绕 .py 和 .pyc 经常出现以下认知误区:
误区 1:只要运行 .pyc,代码整体执行性能就会大幅提升?
事实:.pyc 唯一加速的是导入与启动时间(Import & Startup Time)。当程序是一个持续运行的 Web 服务(如 FastAPI、Django)或长周期数据分析脚本时,模块一旦加载进内存,无论最初是从 .py 还是 .pyc 加载,后续业务循环、算法计算和I/O操作耗费的时间毫无区别。
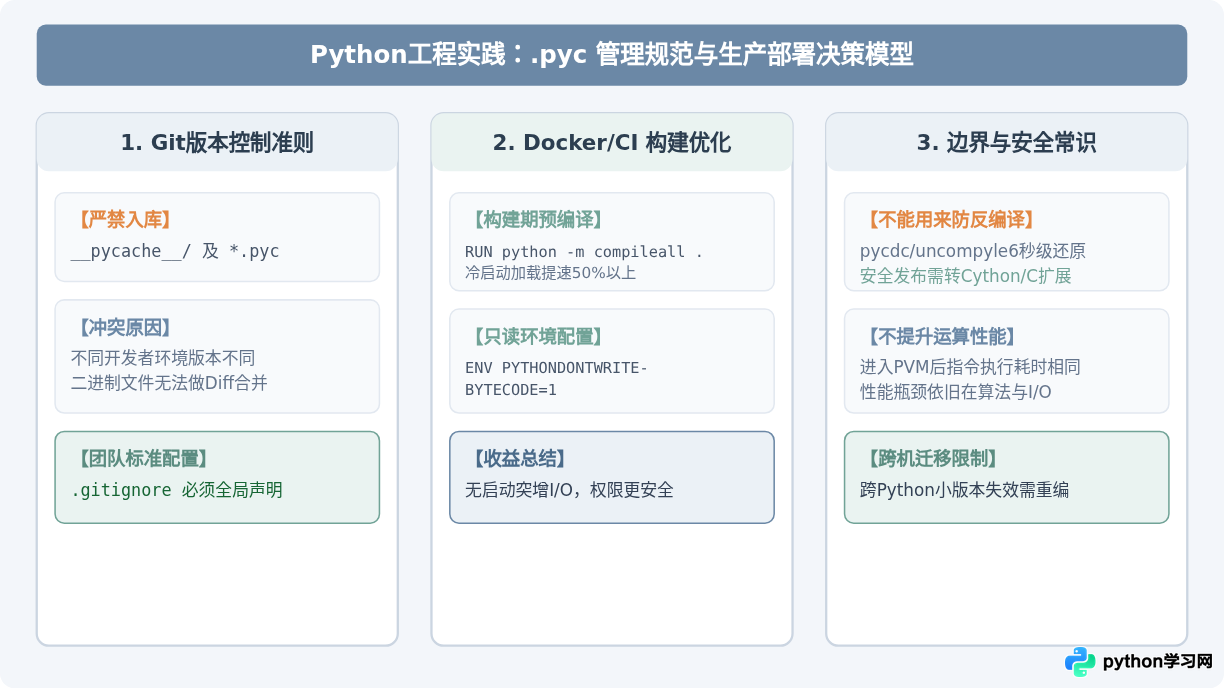
误区 2:只发布 .pyc 文件可以防止源码泄露?
事实:.pyc 绝对不能用作商业代码的安全保护方案。因为 .pyc 完整保留了所有变量名、函数名、结构逻辑甚至行号信息,借助开源反编译工具(如 uncompyle6、pycdc、decompyle++),攻击者可以在几秒钟内将 .pyc 几乎100%无损还原为可读的 .py 源码。若需商业混淆,应使用 Cython 编译为 C 扩展动态链接库(.so / .pyd)或专门的加壳混淆工具。
误区 3:应该把 .pyc 或 __pycache__ 提交到 Git 代码仓库中?
事实:严禁提交!因为 .pyc 强绑定特定 Python 大版本与平台架构,且属于随时可重新生成的中间缓存。不同团队成员的 Python 小版本差异很容易导致冲突。每个 Python 项目的 .gitignore 文件中必须包含:
# 忽略所有生成的字节码与缓存目录
__pycache__/
*.py[cod]
*$py.class
误区 4:Docker 容器镜像中如何合理利用 .pyc?
最佳实践:在制作生产环境 Docker 镜像时,可以在 Dockerfile 的构建步骤末尾加入预编译命令,并配合环境变量禁止运行时写入:
# Dockerfile 生产优化片段
RUN python -m compileall -b .

# 线上容器以只读文件系统运行时,避免无写入权限告警
ENV PYTHONDONTWRITEBYTECODE=1
这样既利用预编译提升了容器冷启动加载性能,又避免了运行容器在只读挂载环境下尝试写入 __pycache__ 产生的权限错误。
六、总结速查备忘
回顾 .py 与 .pyc 的区别,可以用以下四条核心要点进行快速概括:
- 分工明确:
.py是供人类编写与阅读的源代码,.pyc是供 Python 虚拟机(PVM)快速反序列化载入的字节码缓存。 - 只省加载,不省计算:
.pyc的唯一优势在于省去了代码运行前的分词、语法解析与 AST 编译时间,不会对函数本身的执行速度产生加速。 - 自动失效重编:借助魔数和修改时间戳(或哈希),解释器能自动识别过期
.pyc并静默重新编译,无需开发者手动干预刷新。 - 规范隔离:开发阶段务必将其排斥在 Git 版本管理之外;生产镜像构建时可借助
compileall提前烘焙以获得最佳冷启动体验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









