

Python使用SQLAlchemy ORM查询MySQL数据指南

在 Python 应用程序开发中,直接拼接 SQL 字符串进行 MySQL 查询容易引发语法错误与安全注入风险,同时查询结果往往以非结构化的元组形式返回,增加了业务解析的复杂度。使用 SQLAlchemy ORM(Object Relational Mapping,对象关系映射),开发者可以将 MySQL 数据表结构映射为标准的 Python 类,将数据库记录映射为类对象,并通过类型安全、可链式调用的 Python 语法完成增删改查。本文系统介绍基于 SQLAlchemy 2.0 规范查询 MySQL 数据的完整路径,涵盖驱动配置、模型映射、单表与多表查询、关联预加载以及高频避坑实践。
一、环境准备与数据库连接配置
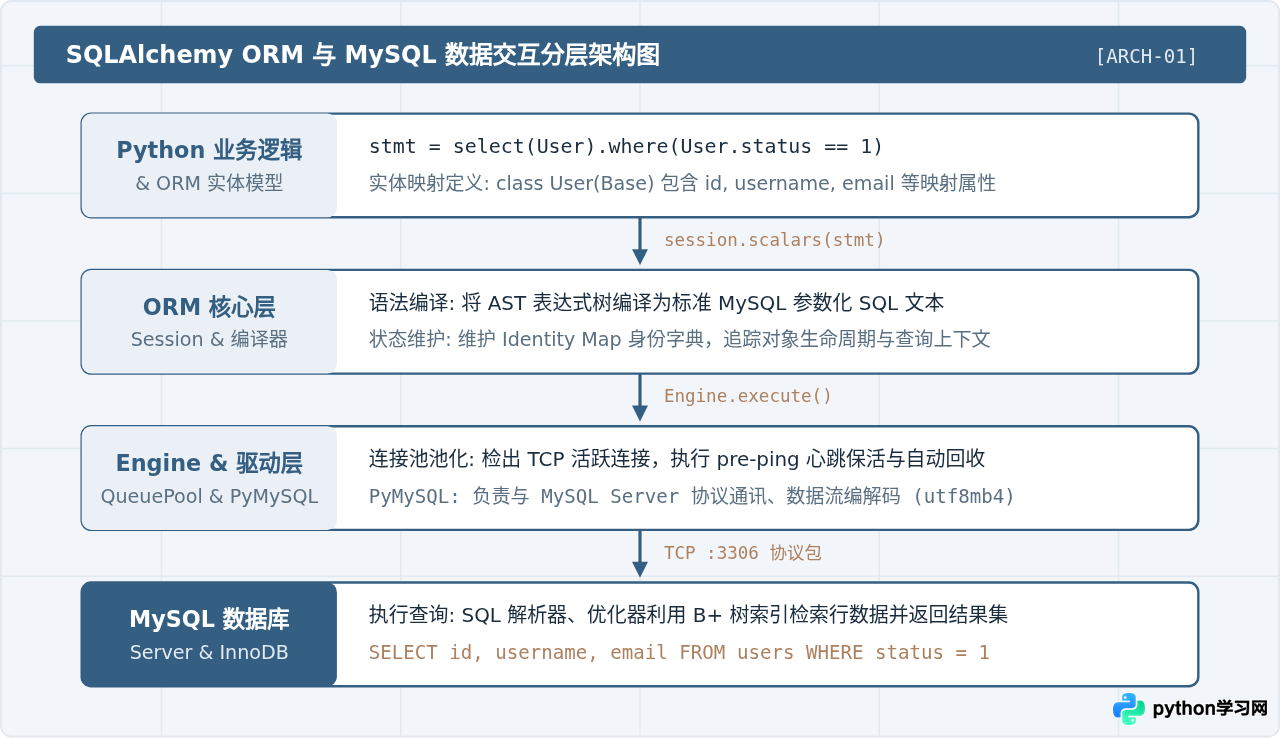
SQLAlchemy 自身作为 ORM 与核心 SQL 构建工具,并不直接与 MySQL 建立 TCP 网络通讯,而是依赖底层具体的 DBAPI 驱动。在 Python 环境中,最通用且无需额外 C 依赖的 MySQL 驱动是 PyMySQL。开始编写代码前,需确保在运行环境中完成必要依赖包的安装。
pip install sqlalchemy pymysql安装完成后,使用 create_engine 函数创建数据库引擎。连接字符串(Database URL)统一遵循 RFC-1738 格式,指定方言驱动、认证信息、目标地址与编码字符集:
from sqlalchemy import create_engine

# 格式: mysql+pymysql://用户名:密码@主机地址:端口/数据库名称?charset=utf8mb4
DB_URL = "mysql+pymysql://app_user:SecurePass123@127.0.0.1:3306/shop_db?charset=utf8mb4"

engine = create_engine(
    DB_URL,
    echo=False,              # 设为 True 时控制台输出生成的原始 SQL 日志,便于调试
    pool_size=5,             # 基础连接池大小
    max_overflow=10,         # 连接池繁忙时允许动态扩展的最大连接数
    pool_recycle=3600,       # 1小时自动回收连接,避免 MySQL 8小时 wait_timeout 断连
    pool_pre_ping=True       # 检出连接前发送心跳包检测有效性,自动剔除断开的死连接
)上述参数中,pool_pre_ping=True 是生产环境极为关键的配置。MySQL 默认在连接空闲 8 小时(wait_timeout)后单方面切断连接。如果缺少连接存活检测,Python 进程在清晨或低峰期后发起的首次查询将直接抛出 OperationalError: (2006, 'MySQL server has gone away')。
二、声明式模型定义(ORM 数据映射)
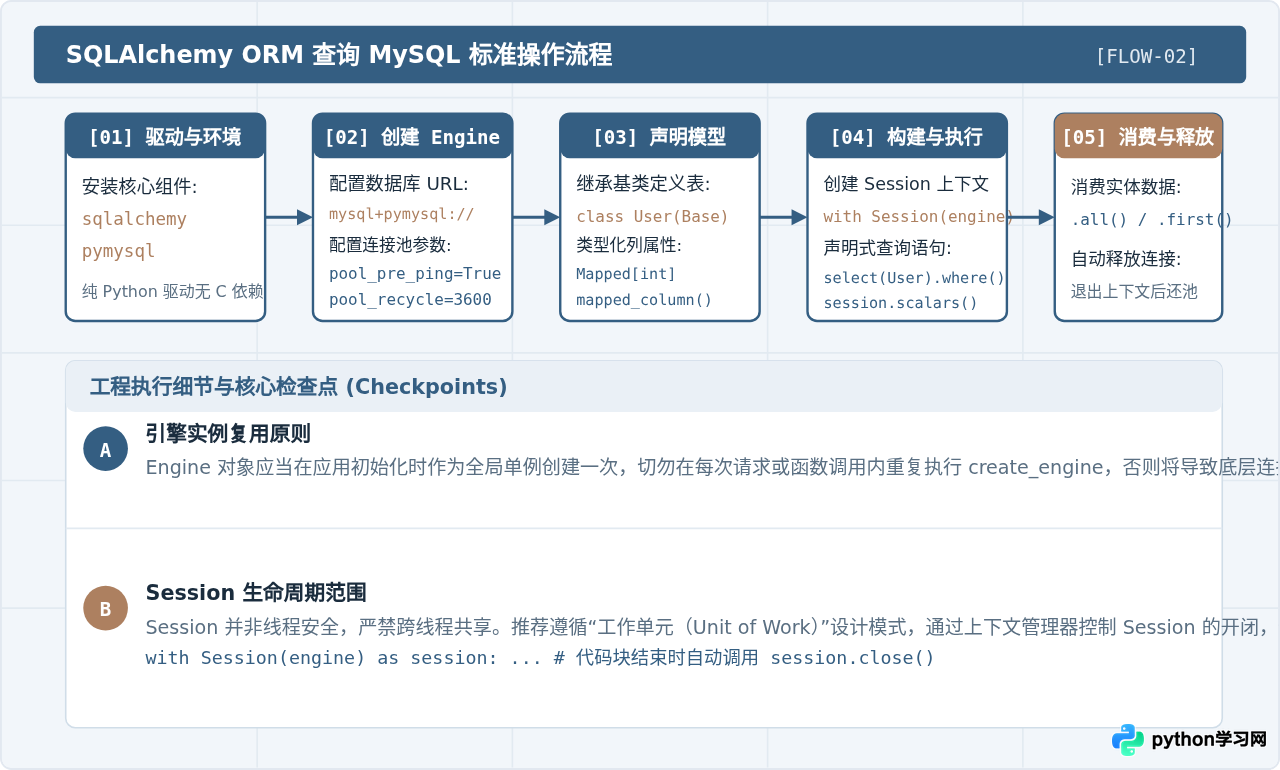
SQLAlchemy 2.0 推荐采用基于 Python 类型注解的 DeclarativeBase 来定义数据模型,这种写法契合现代 IDE 的自动补全与静态类型检查器(如 Mypy、Pyright)。
假设 MySQL 数据库中已存在一张名为 users 的表,其对应的 ORM 映射模型声明如下:
from datetime import datetime
from typing import Optional
from sqlalchemy import String, Integer, DateTime
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column

# 1. 继承 DeclarativeBase 创建应用基类
class Base(DeclarativeBase):
    pass

# 2. 映射具体的 MySQL 表
class User(Base):
    __tablename__ = "users"

    # Mapped[类型] 配合 mapped_column 指定列属性与约束
    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(String(50), nullable=False, unique=True)
    email: Mapped[str] = mapped_column(String(100), nullable=False)
    age: Mapped[Optional[int]] = mapped_column(Integer, default=None)
    status: Mapped[int] = mapped_column(Integer, default=1)
    created_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.now)

    def __repr__(self) -> str:
        return f"<User(id={self.id}, username='{self.username}', status={self.status})>"
在映射类中,类属性直接对应 MySQL 表中的物理字段。当通过 ORM 查询记录时,SQLAlchemy 会自动根据字段类型完成 Python 对象与 MySQL 底层数据格式(如 DATETIME 转换为 datetime.datetime 对象)的双向转换。
三、核心查询操作:从基础到复杂条件
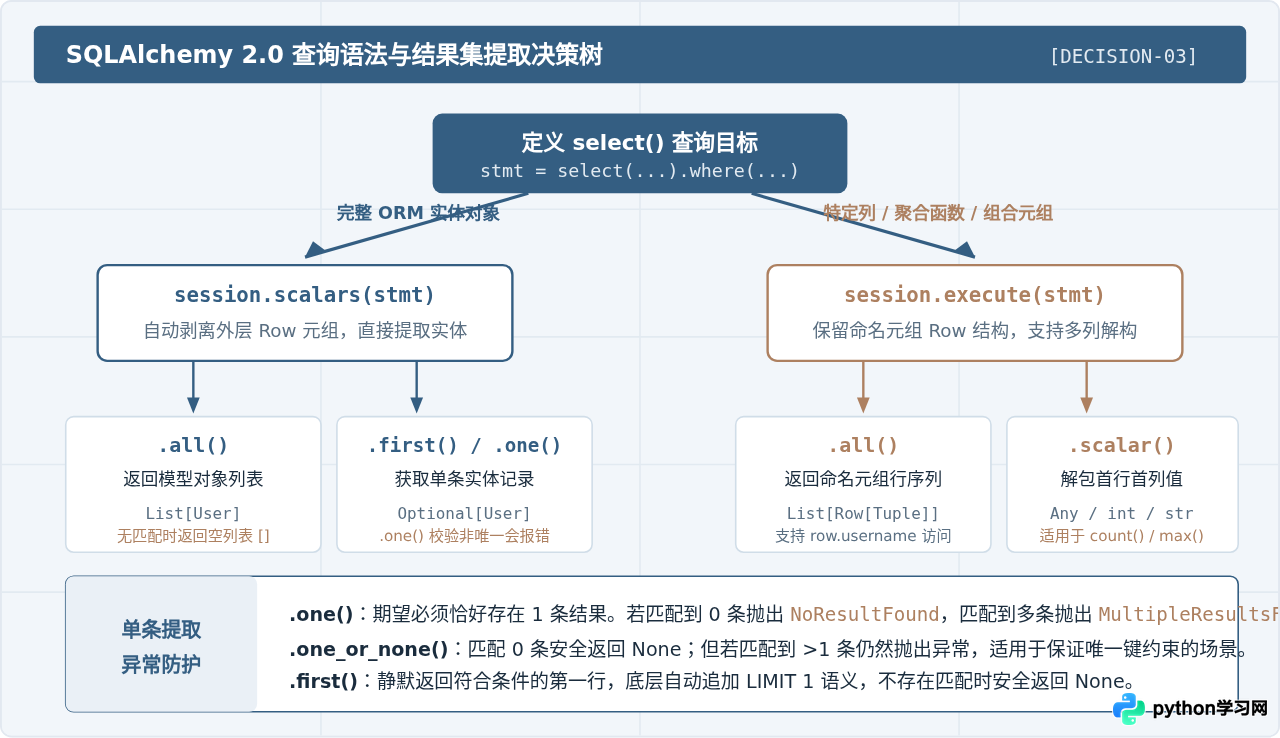
SQLAlchemy 2.0 统一采用 select() 结构化语句配合 session.scalars() 或 session.execute() 执行查询。这种设计彻底统一了 ORM 与 Core 的查询 API,消除了旧版 session.query(User) 的双轨设计。
1. 基础单表查询与单行记录提取
查询数据时,首先通过 select(User) 构建抽象查询对象,通过 where() 增加过滤条件,最后交由 session 执行并消费:
from sqlalchemy import select
from sqlalchemy.orm import Session

with Session(engine) as session:
    # 场景一: 获取单条特定记录 (依据主键或唯一索引)
    stmt = select(User).where(User.username == "alice")
    user = session.scalars(stmt).first()
    if user:
        print(f"找到用户: {user.username}, 邮箱: {user.email}")
    else:
        print("用户不存在")

    # 场景二: 获取符合条件的全量列表
    stmt_all = select(User).where(User.status == 1)
    active_users = session.scalars(stmt_all).all()
print(f"当前处于活跃状态的用户总数: {len(active_users)}")session.execute(stmt) 返回的是底层 ChunkedIteratorResult,其中的每个元素是一个封装了列值的 Row 元组;而 session.scalars(stmt) 会自动提取每个元组的第一列(即 ORM 实体对象自身)。当查询完整实体时,始终优先使用 session.scalars()。
2. 多条件组合(AND / OR)与范围操作
在实际业务中,查询往往涉及多维度的组合过滤。SQLAlchemy 提供了直观的操作符支持:
from sqlalchemy import select, and_, or_

with Session(engine) as session:
    # 1. 逻辑 AND: 可直接在 where() 中传入多个由逗号分隔的表达式,或显式使用 and_()
    stmt_and = select(User).where(
        User.status == 1,
        User.age >= 18
    )

    # 2. 逻辑 OR: 必须显式使用 or_() 包装条件
    stmt_or = select(User).where(
        or_(
            User.username == "admin",
            User.email.like("%@company.com")
        )
    )

    # 3. 常见匹配操作: in_() 与 between()
    stmt_range = select(User).where(
        User.status.in_([1, 2]),
        User.age.between(20, 35)
    )

    results = session.scalars(stmt_range).all()
3. 排序、分页截断与数量统计
MySQL 中的 ORDER BY、LIMIT 和 OFFSET 映射为 ORM 中的同名链式调用方法:
from sqlalchemy import select, func

with Session(engine) as session:
    # 场景: 按照注册时间倒序分页提取,每页 10 条,获取第 2 页 (offset = 10)
    page_size = 10
    page_num = 2
    offset_val = (page_num - 1) * page_size

    stmt_page = (
        select(User)
        .where(User.status == 1)
        .order_by(User.created_at.desc(), User.id.asc())
        .limit(page_size)
        .offset(offset_val)
    )
    paged_users = session.scalars(stmt_page).all()

    # 聚合查询: 统计符合条件的总行数
    count_stmt = select(func.count(User.id)).where(User.status == 1)
    total_count = session.execute(count_stmt).scalar()
    print(f"总计满足条件记录: {total_count} 条")
注意统计总条数时,由于返回的是标量数值(整数)而非 ORM 实体,使用 session.execute(count_stmt).scalar() 可以直接解包提取对应的数值结果。
四、多表关联查询与预加载(避免 N+1 查询)
在关系型数据库中,多表关联不可避免。SQLAlchemy ORM 提供了 relationship 机制来管理表间关联。定义关联关系时,如果处理不当,遍历子表对象时极易触发著名的“N+1 查询”性能陷阱——即主查询执行 1 次,随后遍历 N 条主表记录时又向 MySQL 发送了 N 次子查询,导致数据库 QPS 陡增。
1. 声明一对多关系模型
from sqlalchemy import ForeignKey
from sqlalchemy.orm import relationship

class Order(Base):
    __tablename__ = "orders"

    id: Mapped[int] = mapped_column(Integer, primary_key=True)
    order_no: Mapped[str] = mapped_column(String(64), nullable=False, unique=True)
    amount: Mapped[float] = mapped_column(Integer, nullable=False) # 金额(分)
    user_id: Mapped[int] = mapped_column(ForeignKey("users.id"), nullable=False)

    # 反向关联回 User
    user: Mapped["User"] = relationship("User", back_populates="orders")

# 在 User 类中补充反向一对多列表
User.orders = relationship("Order", back_populates="user", order_by=Order.id.desc())
2. 显式 JOIN 与聚合关联查询
如果只需要联合查询两张表的某些列(例如统计每个用户的订单总金额),可以直接使用 join():
from sqlalchemy import func

with Session(engine) as session:
    # SQL 等效: SELECT users.username, sum(orders.amount) FROM users JOIN orders ON users.id = orders.user_id GROUP BY users.id
    stmt = (
        select(User.username, func.sum(Order.amount).label("total_spent"))
        .join(Order, User.id == Order.user_id)
        .group_by(User.id)
        .having(func.sum(Order.amount) > 10000) # 仅查看消费超过 100 元的用户
    )

    rows = session.execute(stmt).all()
    for row in rows:
        print(f"用户: {row.username}, 累计消费: {row.total_spent / 100:.2f} 元")
3. 预加载策略优化:selectinload 与 joinedload
当需要查询用户对象并直接在业务中访问其下的所有订单(user.orders)时,应当通过 options() 显式指定预加载策略:
from sqlalchemy.orm import selectinload, joinedload

with Session(engine) as session:
    # 推荐用于 1对多 (1:N) 场景: selectinload
    # 执行 2 条高效 SQL: 1 条主表查询,1 条 WHERE user_id IN (...) 子表批量查询
    stmt = (
        select(User)
        .where(User.status == 1)
        .options(selectinload(User.orders))
        .limit(20)
    )
    users = session.scalars(stmt).all()

    for u in users:
        # 此处访问 u.orders 不会再触发额外的 SQL 网络请求
        print(f"用户 {u.username} 包含 {len(u.orders)} 笔订单")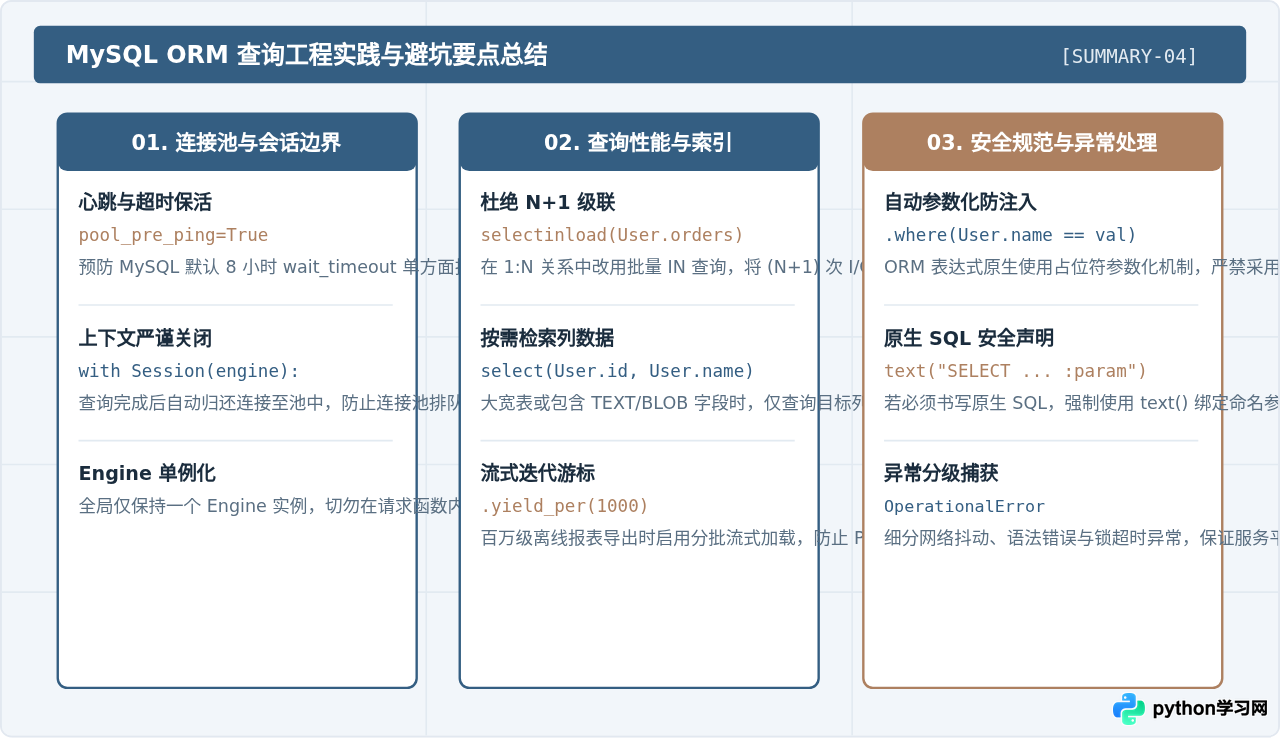
五、常见问题排查与解决清单
| 常见现象 / 报错 | 根因解析 | 标准解决措施 |
|---|---|---|
OperationalError: (2006, 'MySQL server has gone away') |
MySQL 服务端的 wait_timeout 计时器超时关闭空闲连接,而 Python 连接池保留了失效的文件描述符。 |
在 create_engine 中配置 pool_pre_ping=True 开启探活,并根据网络环境调小 pool_recycle(如 3600 秒)。 |
中文存取出现问号 ??? 或 Incorrect string value |
连接字符串未强制指定 4 字节 UTF-8 编码,或 MySQL 数据库/数据表默认字符集为 latin1。 |
连接 URL 后缀增加 ?charset=utf8mb4,并确保 MySQL 表及字段采用 utf8mb4_unicode_ci 排序规则。 |
NoResultFound 或 MultipleResultsFound |
对查询结果使用了严格单条断言方法 .one(),但数据行数不为 1。 |
对于可能不存在的记录,改用 .one_or_none() 或 .first();只有在断言数据完整性绝对唯一时才使用 .one()。 |
| 数据库已在外部修改,但查出来仍是旧数据 | Session 处于同一个事务块中,MySQL 默认的 REPEATABLE READ(可重复读)隔离级别确保在同一事务内看到一致的快照。 |
在重新查询前显式调用 session.commit() 或 session.rollback() 结束旧事务,或使用只读会话退出上下文重新检出。 |
综上所述,在 Python 借助 SQLAlchemy ORM 操纵 MySQL 数据的过程中,遵循“单例 Engine、严格 Context 管理 Session、2.0 select 语法声明、按需配置预加载”的工程规范,能够在享受对象映射便利性的同时,确保数据库访问层具备高吞吐、低延迟与高健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









